先看智能体被允许做什么
第 13 讲以缺陷分诊 Agent 为例:读取报告、尝试复现、标注严重性并建立工单,但不能修改产品代码。任务听起来简单,配置却决定了它能访问哪些数据、调用哪些工具,以及会产生什么副作用。
Harness 把模型连接到环境
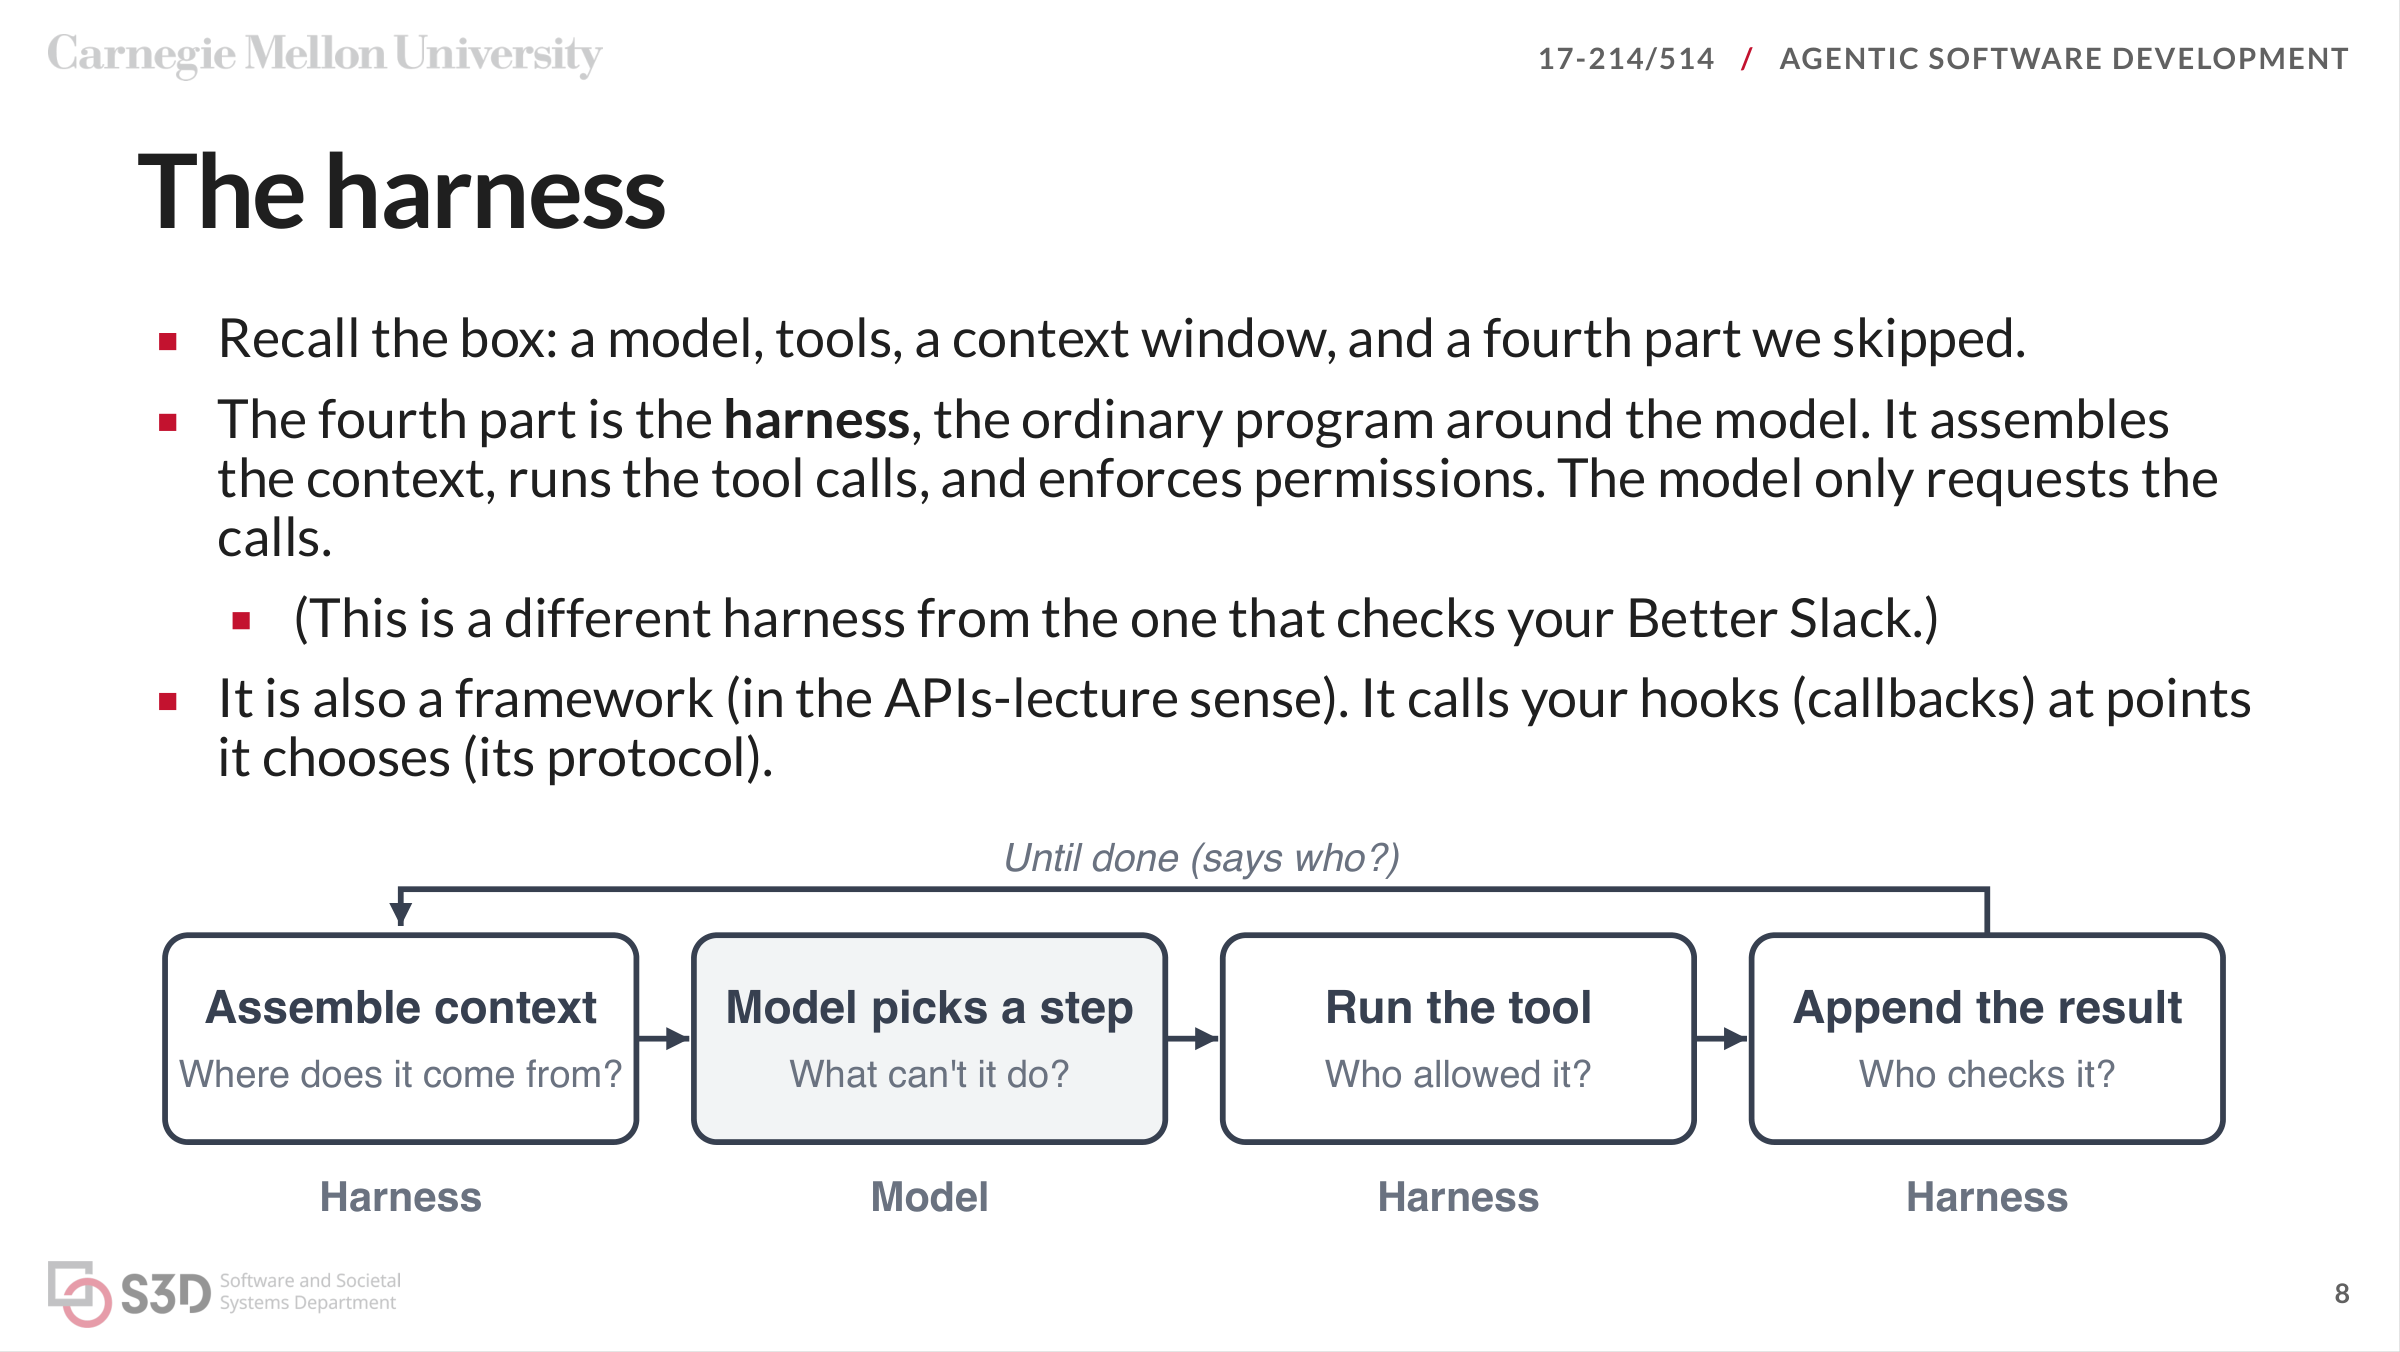
模型提出下一步动作,Harness 负责组装上下文、执行工具、检查权限并追加结果。这里的 Harness 指智能体运行程序,与作业中的系统验收工具不是同一概念。
模型有知识截止、有限上下文和非确定性。这些限制需要像延迟与内存一样纳入系统设计,不能只用更长提示掩盖。
上下文可能来自系统规则、项目文件、对话、工具输出和检索文档。检索遗漏关键文件时,即使模型沿输入正确推理,也会建立在错误前提上。排查时应检查当前读到了什么,而不是仅观察最终回答是否自信。
课件展示了具体会话的 token 分布,用于说明工具描述和常驻材料在任务开始前已占用空间;这些数值属于当时配置,不代表其他模型或会话的固定开销。
对于分诊 Agent,所有报告都需要的材料可能是严重性准则,而不一定是某个固定模块。模块代码、相关 ADR 与相似工单可以按报告检索;上一个报告的完整对话容易混入旧判断,用户历史则要先说明是否真的必要。
原课用 /context 展示窗口中系统、工具、指令、消息与检索材料的占比,也通过会话导出核对相关文件是否真的读过。这些命令与 token 数字属于课程当时的工具配置。分析方法可以复用:先查看实际输入,再区分模型判断错误与检索遗漏。
检索可以来自文本搜索、索引或向量匹配。更多材料并不总更好,过期决策与当前规则冲突时,还可能降低判断质量。我们可以像给新同事交接一样,只交付任务需要的约束、位置与已确认理由。
工具定义也是 API 设计
工具名称、描述、参数、返回值和副作用共同构成契约。分诊工具可以把严重性限制成枚举,并要求复现步骤,让部分错误在边界被拒绝。
工具集合定义行动空间。只读仓库与同时拥有写入、部署和数据库凭证的环境,错误影响完全不同。评审需要同时检查工具、权限与凭证范围,不能只看提示中是否写了“不要修改”。
限制编辑工具却保留不受约束的 Shell,仍然可能写文件。类似地,命令字符串匹配不一定覆盖等价调用。应从最终能力出发,按最小权限配置任务,而不是把某个工具名称当成隔离保证。
分诊工具可以按三个层级配置:读取与搜索自由运行,在隔离环境执行复现测试;建立真实工单前设置审查关卡;编辑产品代码、推送和关闭工单等超出任务的能力不授予。这里是课件案例中的配置思路,实际是否需要人工审批,还取决于任务已有授权。
还要区分“没有工具”与“工具调用时需要确认”。自动批准模式可能减少逐次询问,却不会自动缩小已经授予的能力。仅隐藏 Edit、Write 而保留通用 Shell,仍可能通过命令改文件;按命令文字匹配的规则,也不等同于操作系统隔离。课件展示的具体工具选项应按当时版本理解。
工具定义本身则要表达约束:file_ticket 要求标题、严重性枚举与复现步骤,可以拒绝字段缺失或未知严重性。但正确的字段结构还不代表判断正确,这一点在后面的评测中仍需单独验证。
MCP、CLI 与 Skill 各自提供什么
MCP 为 Agent 与工具服务器提供标准连接方式,减少每一对系统之间的专用集成。服务器也成为新的依赖,会在获得的权限下访问真实系统,因此连接时需要检查来源、工具列表和授权范围。
已有合适 CLI 的环境,可以通过 Shell 调用;MCP 则提供结构化工具边界,并适用于没有 Shell 的场景。两者都需要限制身份权限,不能因为接口方便就授予组织管理员能力。
Skill 提供按需加载的步骤,工具提供实际能力。缺少工具意味着无法完成动作,缺少技能意味着可能不知道正确流程,两类问题需要分别解决。
MCP 的价值可以用连接数理解:三种 Agent 分别连接三种系统,专用集成最多需要九组适配;采用同一协议后,各端只实现自己的协议连接。它统一的是连接方式,服务器仍可能增加许多具有写入或删除能力的工具。
本地 stdio 服务器可能直接启动一个依赖包,远端 HTTP 服务器则使用授予的身份访问服务。检查时要同时看服务器来源、固定版本、暴露工具和令牌范围。CLI 可以复用已有认证,MCP 可以提供独立结构化参数,二者都没有自动消除供应链与授权问题。
编排把接口换成了交接
多个 Agent 可以进行独立检索、专项分析或新上下文验证,收益来自并行、隔离和专业分工;代价是协调、信息损失和错误累积。
课件展示了计划已更新、早先启动的子任务却仍按旧方案删表的情境。统一计划文件与边界检查,可以减少分歧,但交接仍需要验证。工作独立、交接清晰时更容易获得收益。
结构化输出也只能保证一部分正确性。重复预约违反系统不变量,分诊结果却标为低严重性时,JSON 即使通过 schema,业务判断仍然错误。
模型选择也是一项取舍。简单检索子任务可以由较小模型执行,再由可靠检查确认;复杂计划和微妙评审可能需要更强模型。扩大模型之前,先缩小任务与工具范围,可能更节省时间和费用。若外部循环反复启动任务,还要区分单次预算与总预算。
每种机制都有特定故障:检索可能漏文件,工具描述可能含糊,Skill 可能过期,交接可能丢失计划变化,结构化输出可能内容错误。我们应该沿着机制寻找原因,而不是把所有问题都归结为模型不够强。
用评测检查整套配置
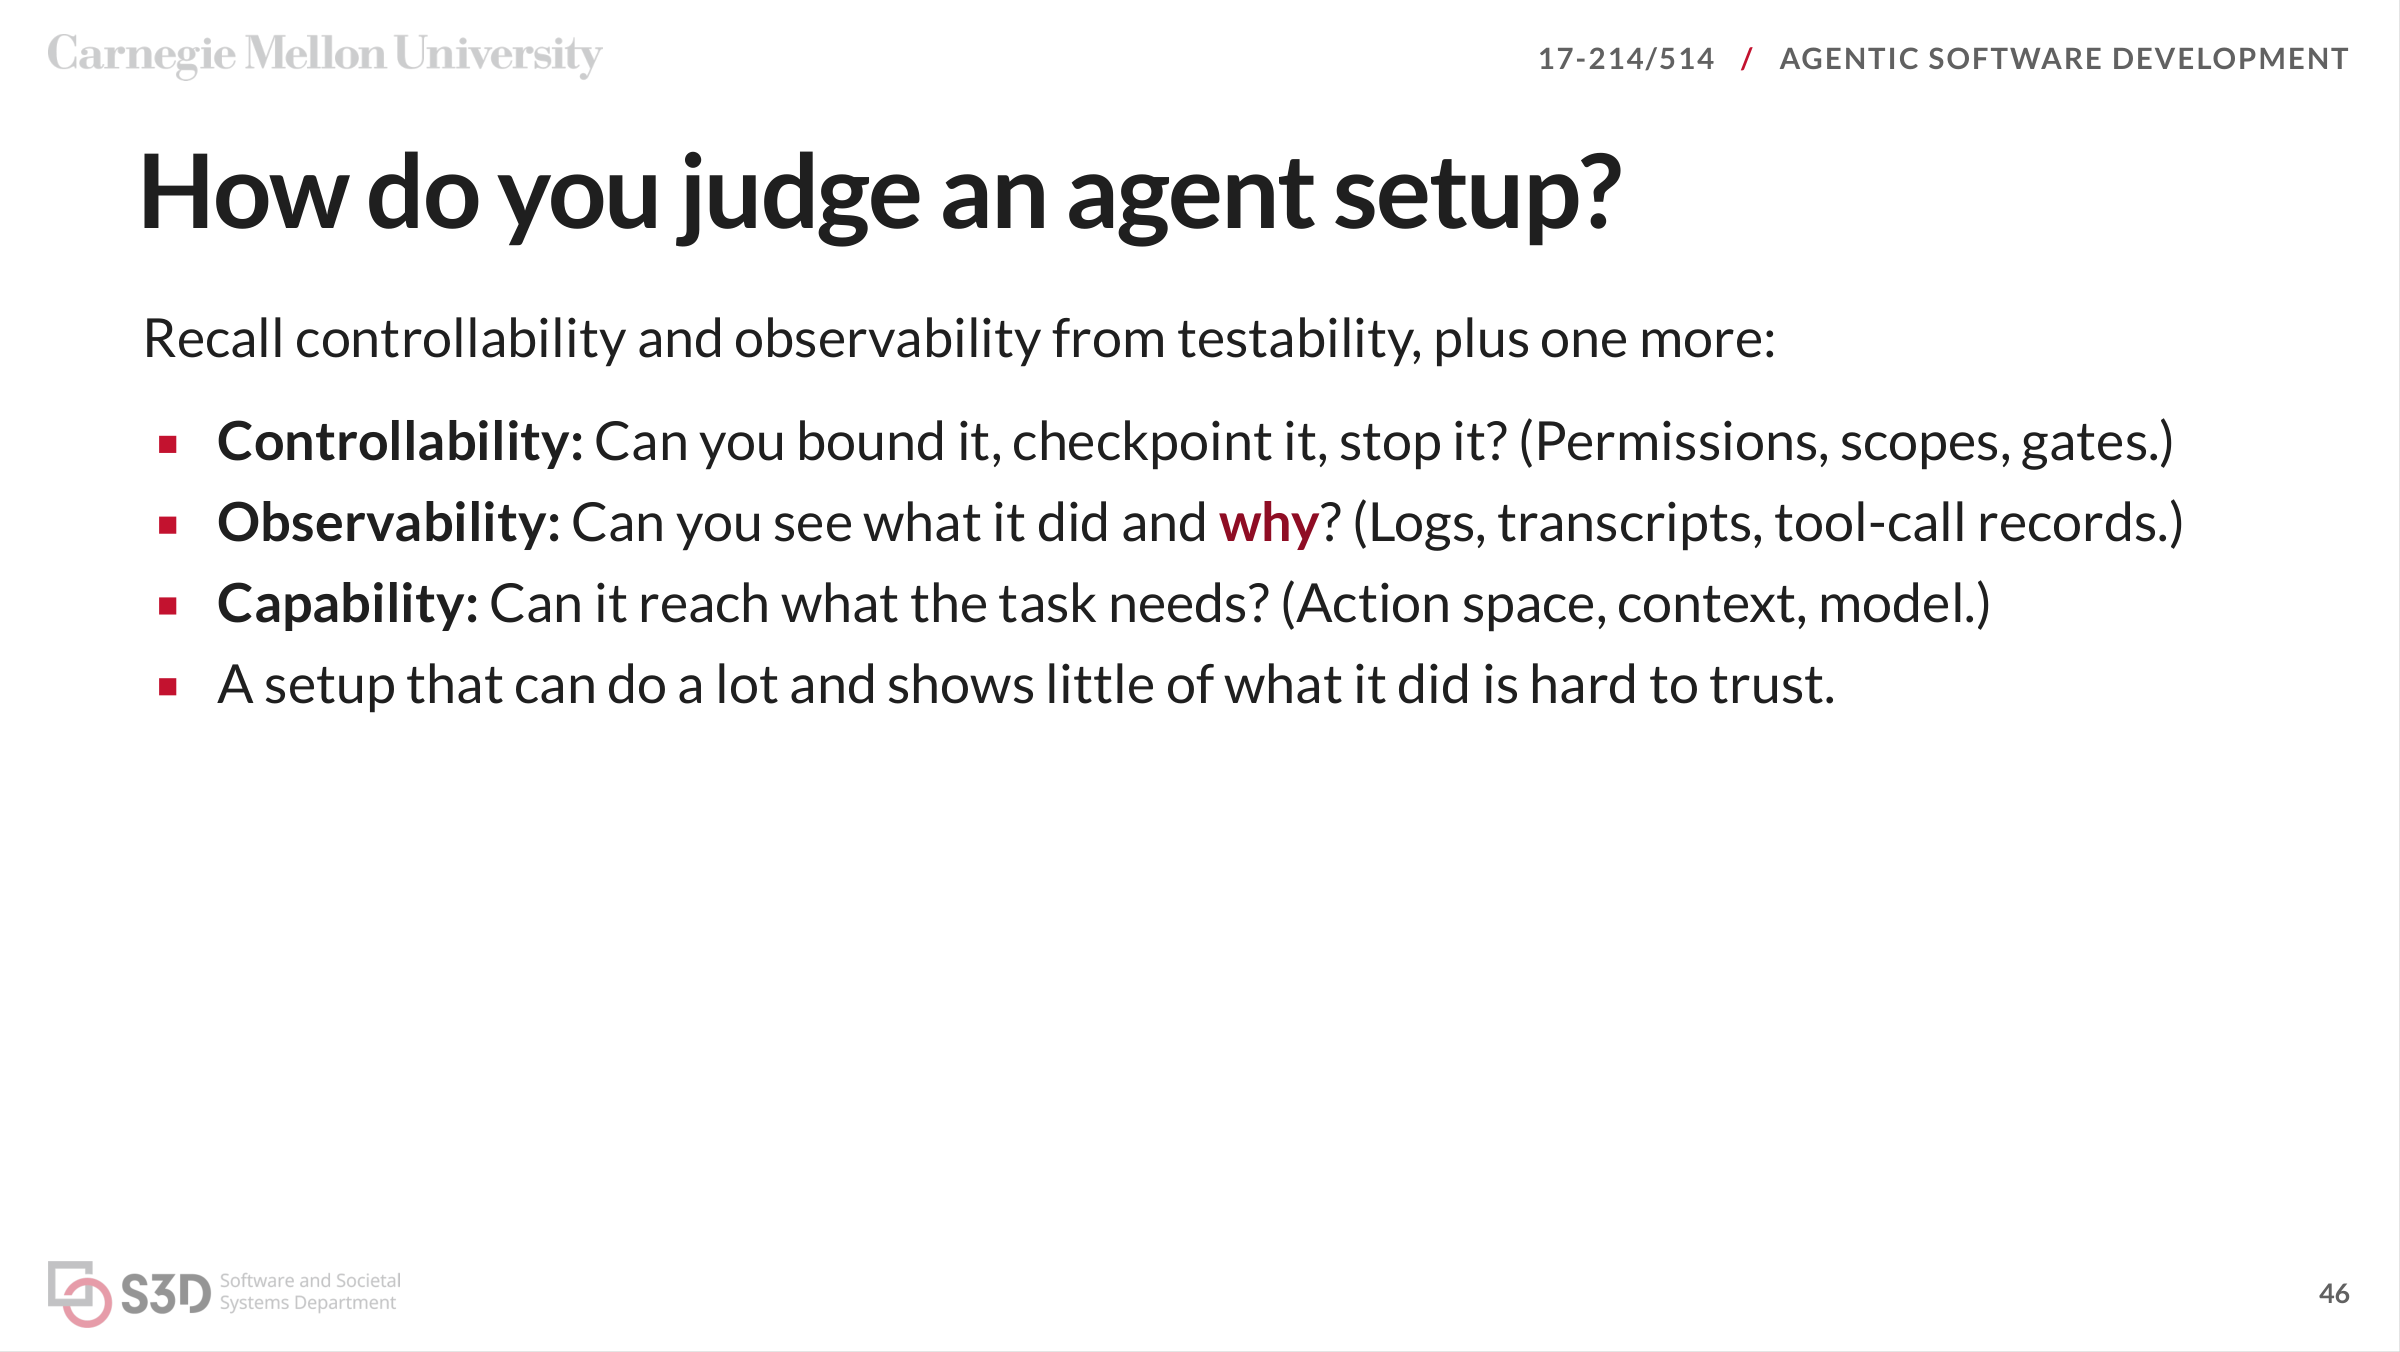
能力检查是否拥有任务所需信息与工具;可控性检查能否限制、停止和建立检查点;可观察性检查能否看到工具调用和执行结果。
Eval 需要代表性任务、可检查结果和多次运行。分诊系统可以使用已有人工标签的报告,分别检查标签、复现记录和副作用。模型、提示或工具变化后重新运行,才能把配置演进变成可验证的过程。
课件用 SWE-bench 说明评测如何落到真实任务:其最初基准包含来自 12 个 Python 仓库的 2,294 个 GitHub issue,模型根据问题与代码生成补丁,再由测试判断。这个例子同样提醒我们,评测也继承了测试的覆盖边界。
回到分诊系统,可以准备已有人工标签、不同模块与失败类型的报告,重复运行并分别统计标签正确、复现有效、工单完整与越权动作。课堂练习中的配置已有只读工具和隔离测试,却未明确保留严重性准则与完整执行记录;应据实际配置找出薄弱项,再设计会在这些条件下失败的评测,不能只展示一次成功分诊。