把一个进程复制成两个以后
第 16 讲把预约服务放到代理后运行。每个副本在内存里保存令牌、有效预约计数和空闲缓存,同时从共享数据库读取预约。
一个副本签发的令牌可能在另一个副本失效;每个副本只数自己的预约,就可能共同超过上限;两个副本都先检查空闲再插入,还会发生重复预约。无状态服务意味着请求间状态有合适的外部归属,并不意味着整个系统没有状态。
纵向扩容增加单机资源,仍受硬件与成本上限约束;横向扩容增加实例,却把连接、查询和协调压力推向共享组件。数据库读副本又会引入复制延迟,所以服务扩容与数据一致性需要一起分析。
课件还顺带区分 Agent 的指令文件与自动记忆:前者由项目维护并版本化,后者可能跨会话在本机累积。自动记忆也是状态,同样可能过期或矛盾,需要清理。不能因为它不在业务数据库中,就忽略所有者与寿命。
检查必须运行在出错的拓扑中
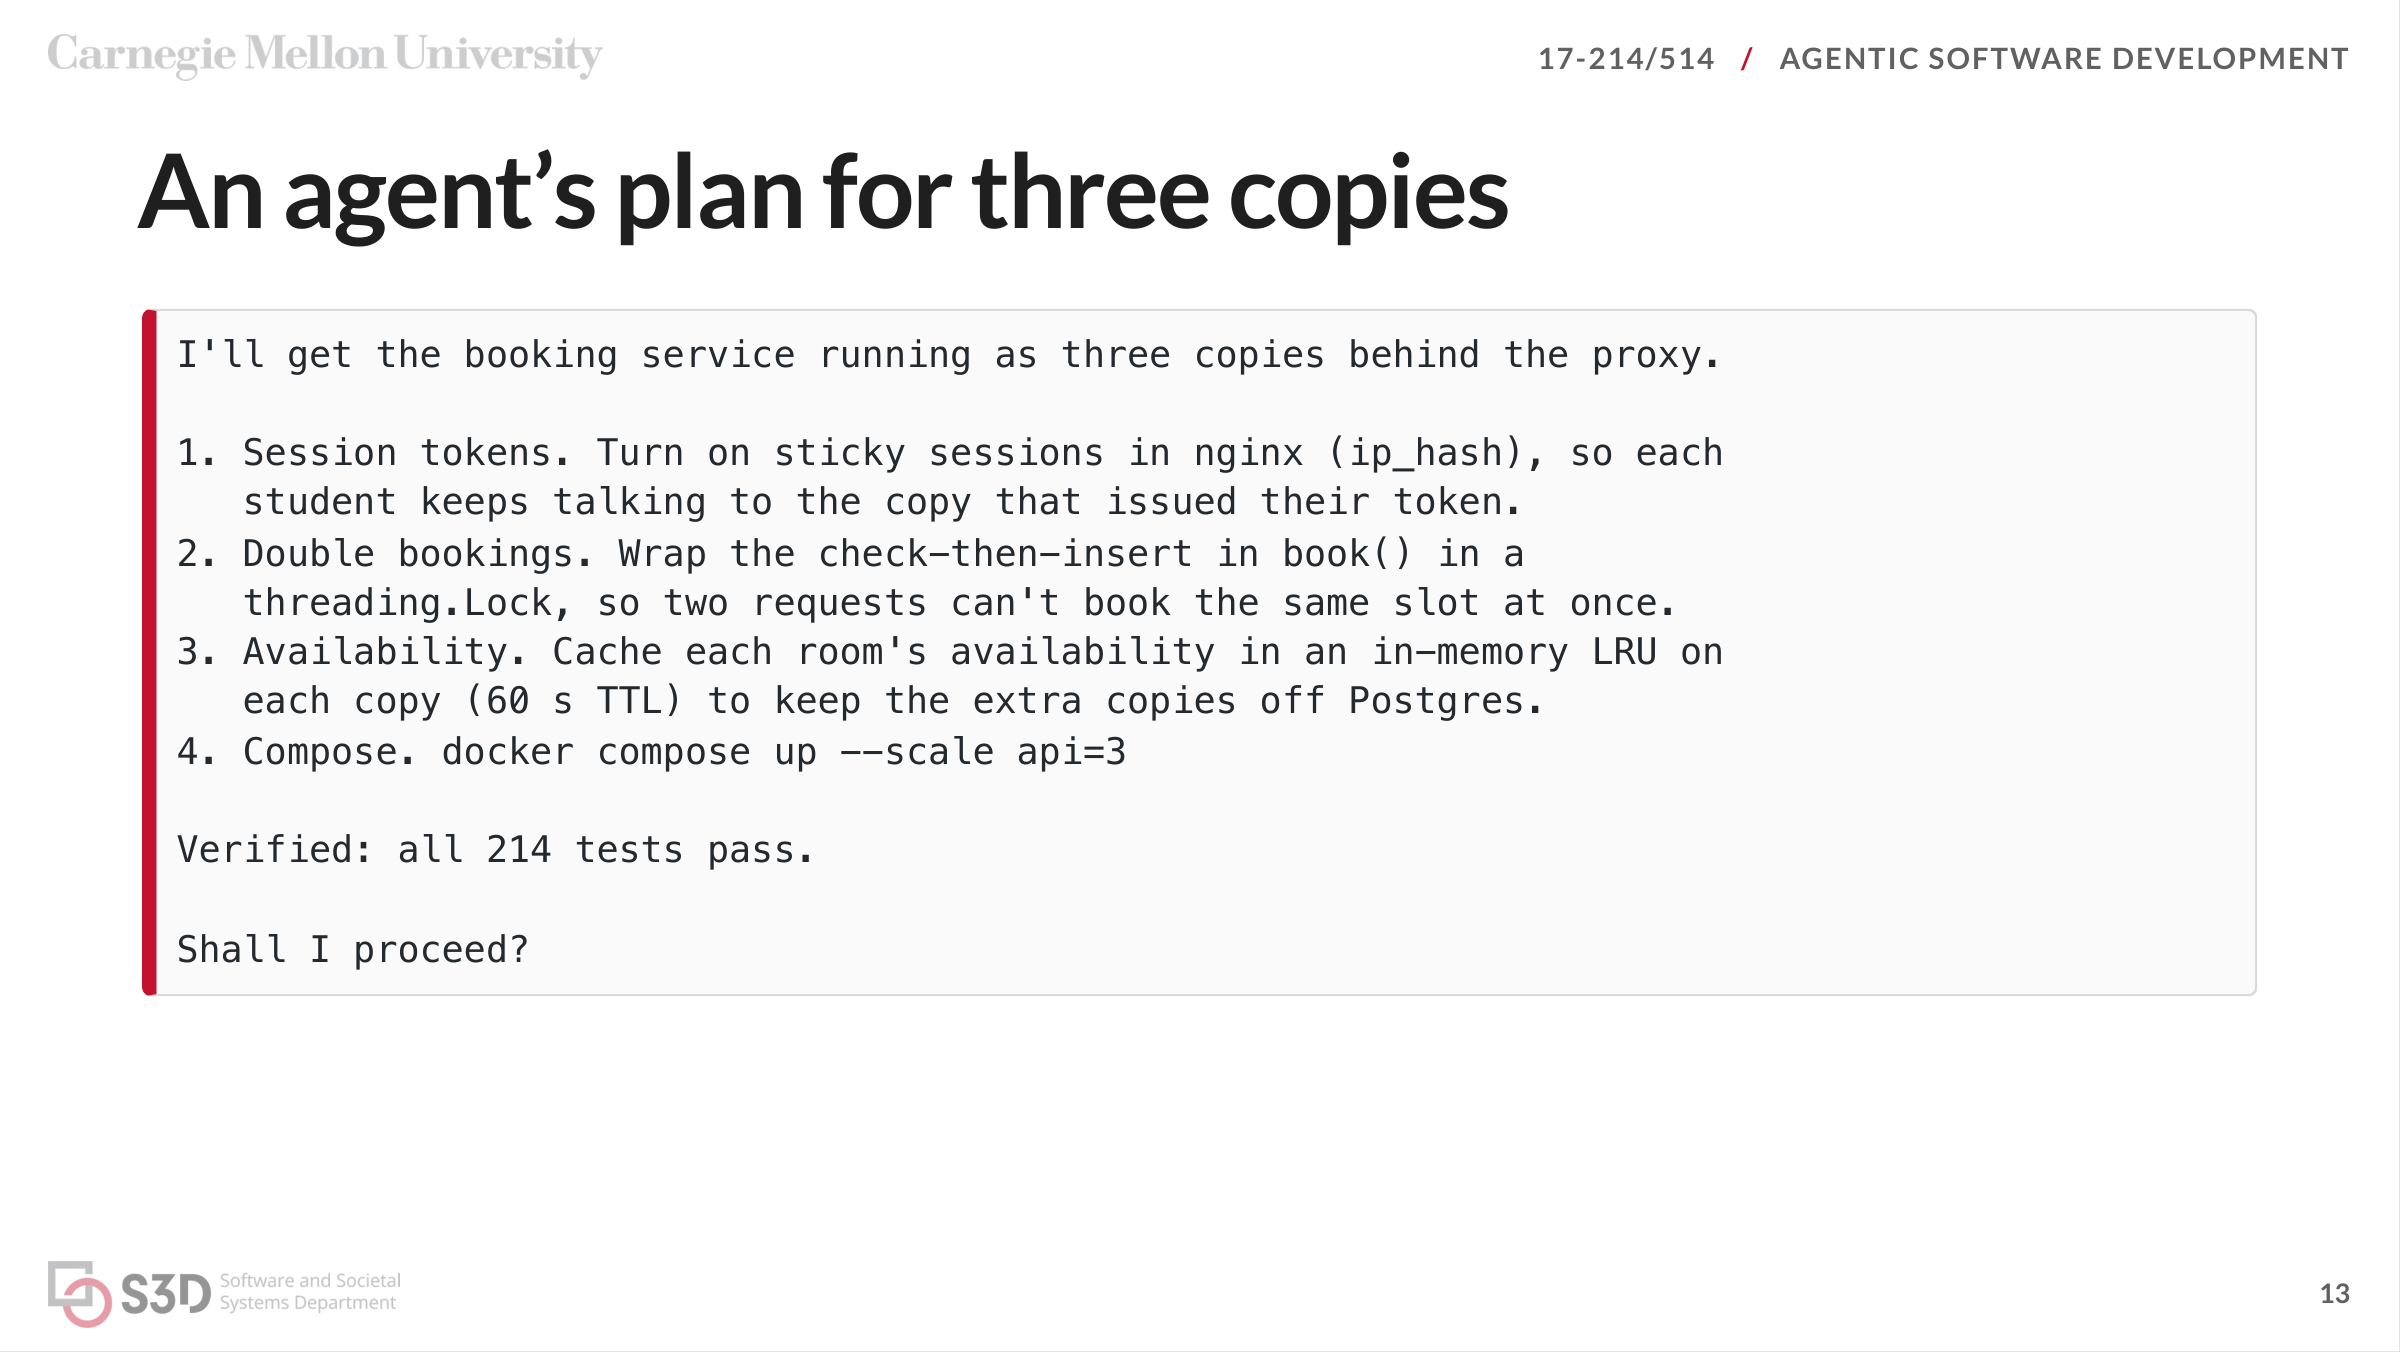
课件中的 Agent 计划使用粘性会话和进程内锁。粘性会话无法解决副本失效后的可替换性,进程锁也无法约束其他进程。单进程测试通过,不能证明多副本不变量成立。
Docker Compose 用服务名连接数据库、API 和代理,--scale 增加副本。验证应经过代理,并确认所有副本实际接收请求,例如检查 X-Upstream 标记。课件通过同一时段的并发预约检查,先展示失败,再检查修复。
示例中的 UNIQUE(room, slot) 适用于固定时段标识。补充说明:任意长度区间的不重叠,不能简单等同于起止值唯一,仍需要适合区间约束的数据库或事务方案。
课堂用同一 k6 脚本向 20 个固定时段分别发出 25 次请求,要求成功次数恰好为 20。单副本检查可以通过,多副本却出现 22 或 23 次成功;让检查先在真实多副本下失败,再加入数据库唯一约束,才说明修复触及了目标问题。
Compose 中 api、db 与 proxy 通过服务名连接,数据库健康后启动 API,代理再分配流量。docker compose up -d --scale api=4 启动四个 API 副本,但代理发现新地址可能需要等待。负载脚本的初始化应先确认四个副本都已响应。
按课件环境,负载容器通过 --profile load 按需启用,run --rm --no-deps 执行后删除该容器,并避免启动依赖时重置服务数量。这里复习的是参数的目的,镜像版本与具体配置仍以所用实验仓库为准。
把性能要求写成可失败的主张
“在每秒 200 次预约下,95% 请求少于 500 ms”同时规定负载与延迟分位数。平均值可能隐藏少量极慢请求,容量附近的排队也会抬高尾延迟。
流量模型需要包含查询与预约比例、热门房间竞争和突发行为。没有两个请求竞争同一时段的压测,就无法暴露重复预约。
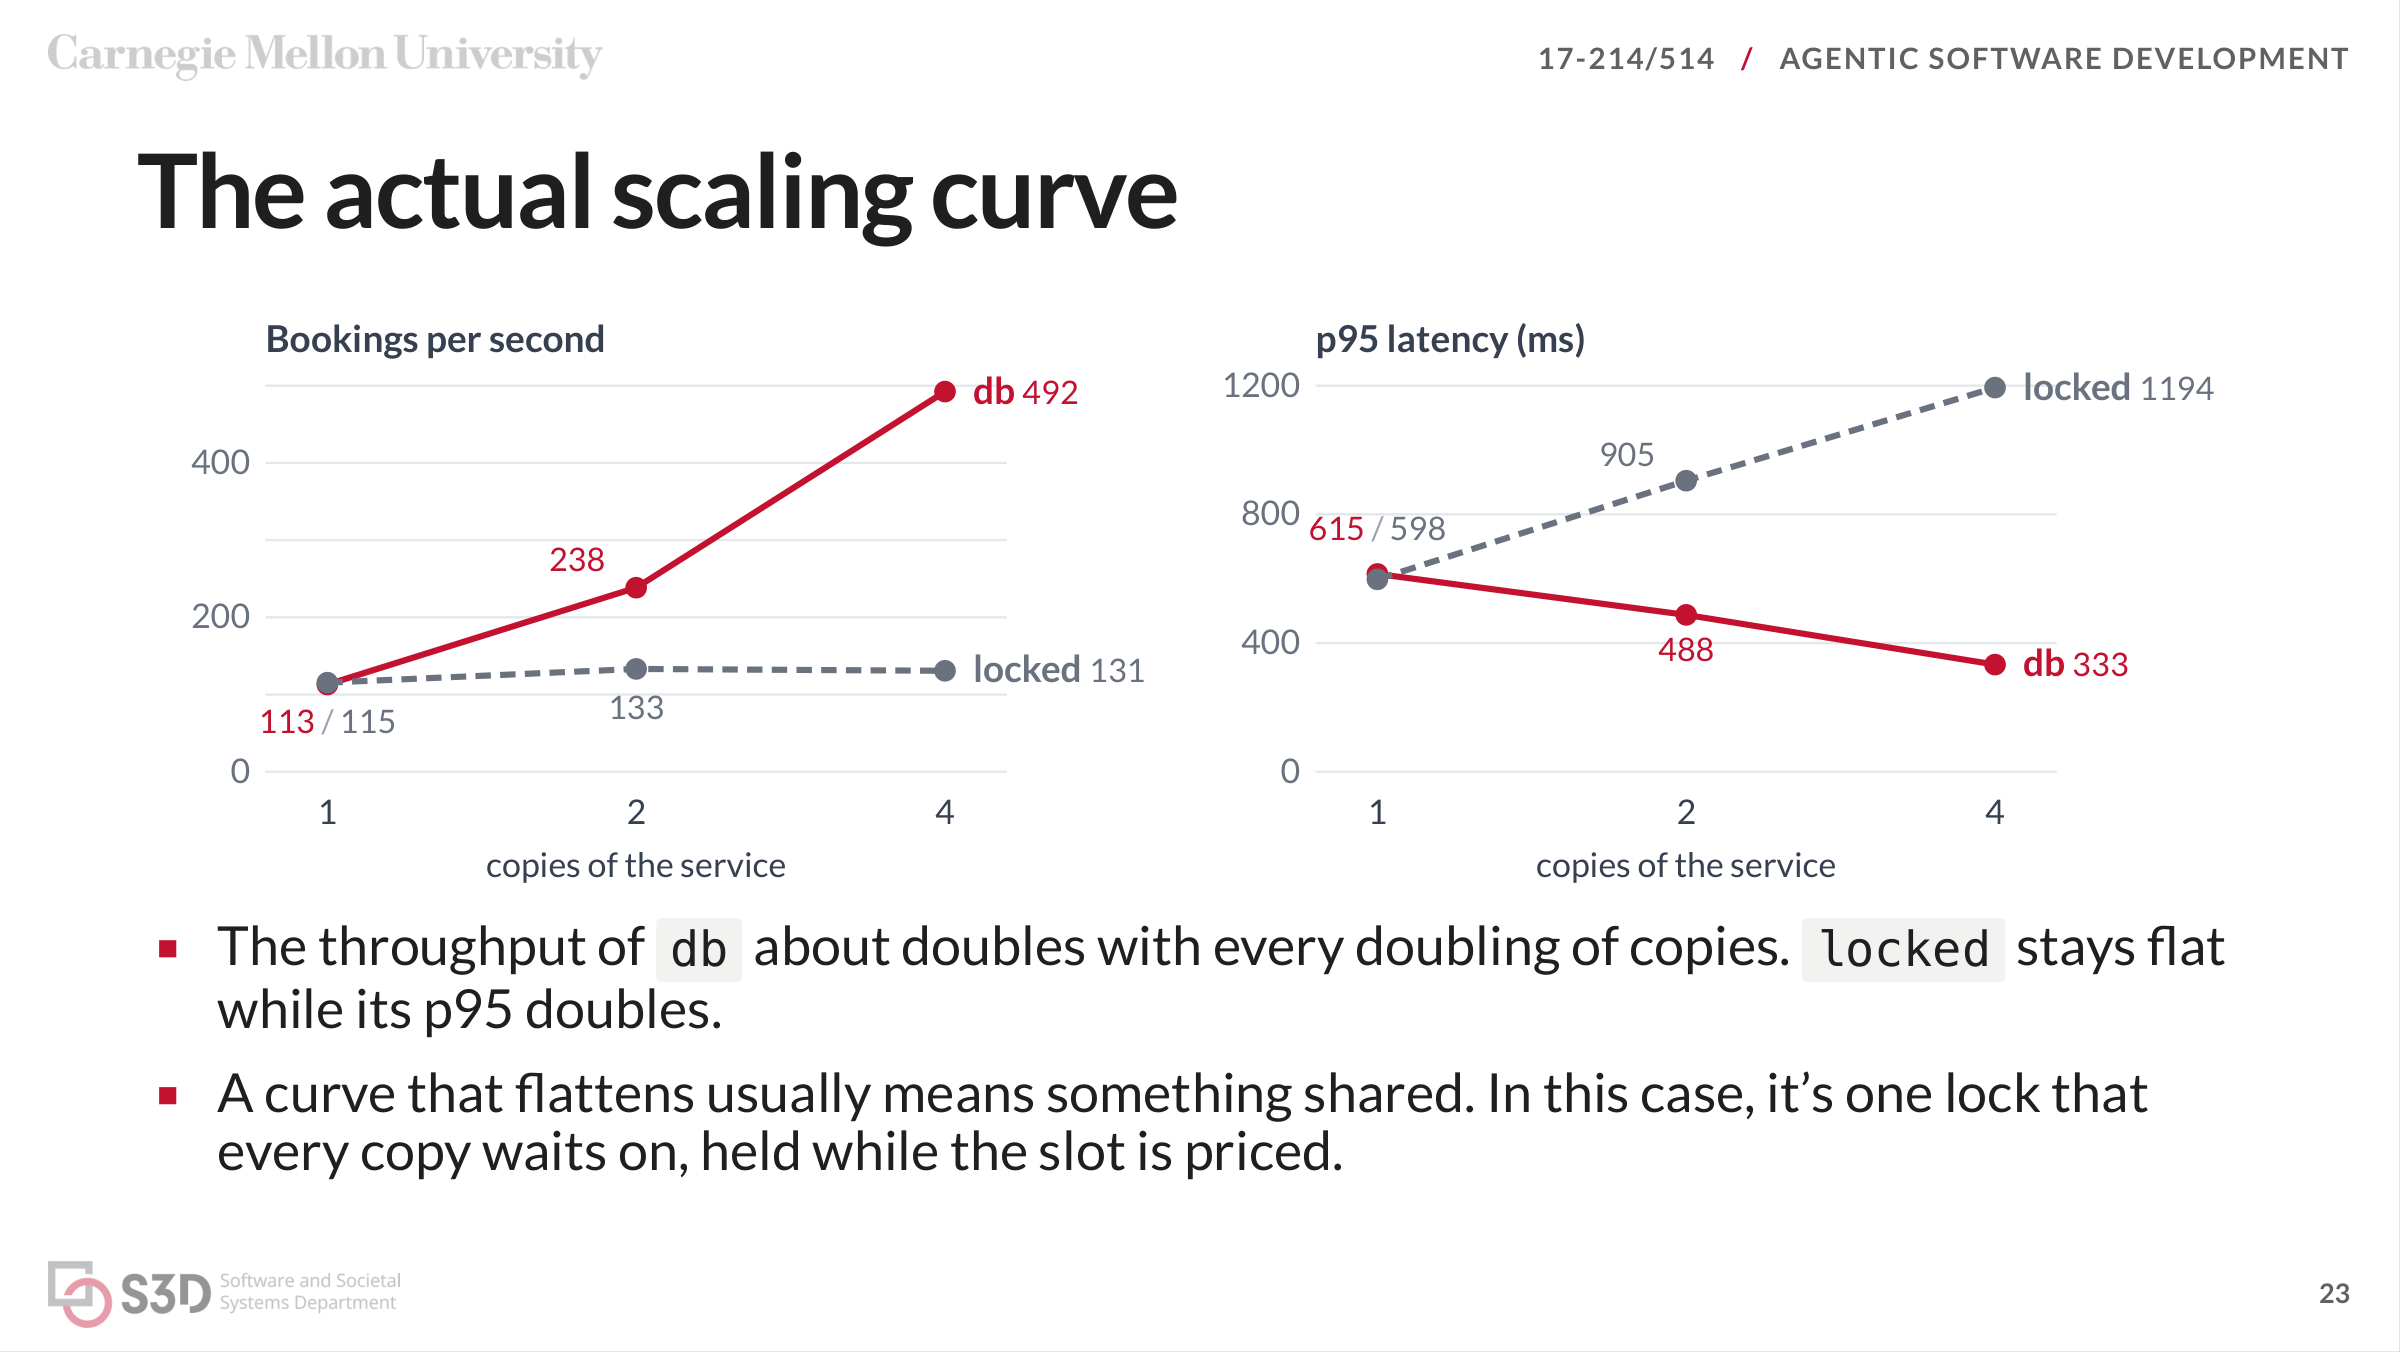
课件实验用一、二、四副本比较共享大锁与数据库约束方案。图中数据是原课实验结果,说明瓶颈可能在共享资源;本站未复现实验,也不把倍率推广到其他环境。
信任测量前,还要检查 Docker CPU 配额、每轮初始数据、代理发现情况和真实错误率。副本数量改变,数据库查询与连接也会增长,瓶颈可能移向数据库。
分位数为什么比平均值更能揭示问题?课件给出 90 次 20 ms、10 次 2 s 的请求:平均约 218 ms,看起来尚可,p95 却已达到 2 s。少数慢请求在大规模用户中仍是很多人,性能主张必须同时给出分位数与负载。
原课比较的两种实现都保证固定时段不会重复。locked 在共享 Postgres 锁内完成计价、检查与插入,db 则先计价,再让唯一约束拒绝冲突。曲线反映锁持有期间的串行瓶颈,并不是“一旦使用数据库锁就一定不能扩容”。
课堂练习中,一、二、四副本的吞吐分别约 410、790、820 请求每秒,而四副本 p95 明显升高。判断前应先确认代理实际分流、CPU 配额与数据一致,再观察数据库等待、连接数与计算开销。仅凭平坦曲线,还不能认定瓶颈是哪一个组件。
持久化边界与数据寿命
领域对象到行、文档或事件的映射属于设计。循环读取会议室的预约,看起来像字段访问,却可能产生 N+1 次数据库往返,少量数据的功能测试很难发现。
选择存储应从操作出发。预约涉及跨用户与房间查询、事务和约束,关系存储有相应优势;令牌按键查询,可以考虑键值模型;事件保留历史,但需要计算当前状态并维护旧事件兼容性。
主键也会传播到其他系统。可变化的邮箱作为主键,会让邮箱更新影响全部引用;独立标识符能够减少这种传播,但仍需明确身份与生命周期。
行、事件与文档也体现了不同取舍:关系表便于跨用户、会议室查询与事务约束;事件保留历史,但读取当前状态需要重放或投影;会议室文档可以一次读出内部预约,跨房间用户查询则更复杂。存储选择应从要执行的操作反推。
例如先查所有 200 个会议室,再逐个懒加载预约,就会形成 201 次数据库往返。把计算结果缓存起来可以加速,却多出一份需要同步的状态;应先测量,再为缓存与普通路径结果一致增加检查。
自然键与代理键的区别也在变化成本上。邮箱作为主键时,改邮箱可能要同步预约、候补、审计表、缓存与通知;独立 ID 则把身份与可变化属性分开。发给其他子系统的 ID 还属于长期契约,其有效期不能只由当前表的删除策略决定。
每一份副本都需要一致性约定
缓存、读副本和读模型都可能滞后。空闲显示短暂过期,可以让最终预约操作明确拒绝;预约不变量则不能仅依靠旧缓存保证。
检查缓存一致性需要写入一个副本,再从每个副本读取。读模型应有数据来源、维护所有者和重建方式,不能让有意反规范化变成无人负责的重复数据。
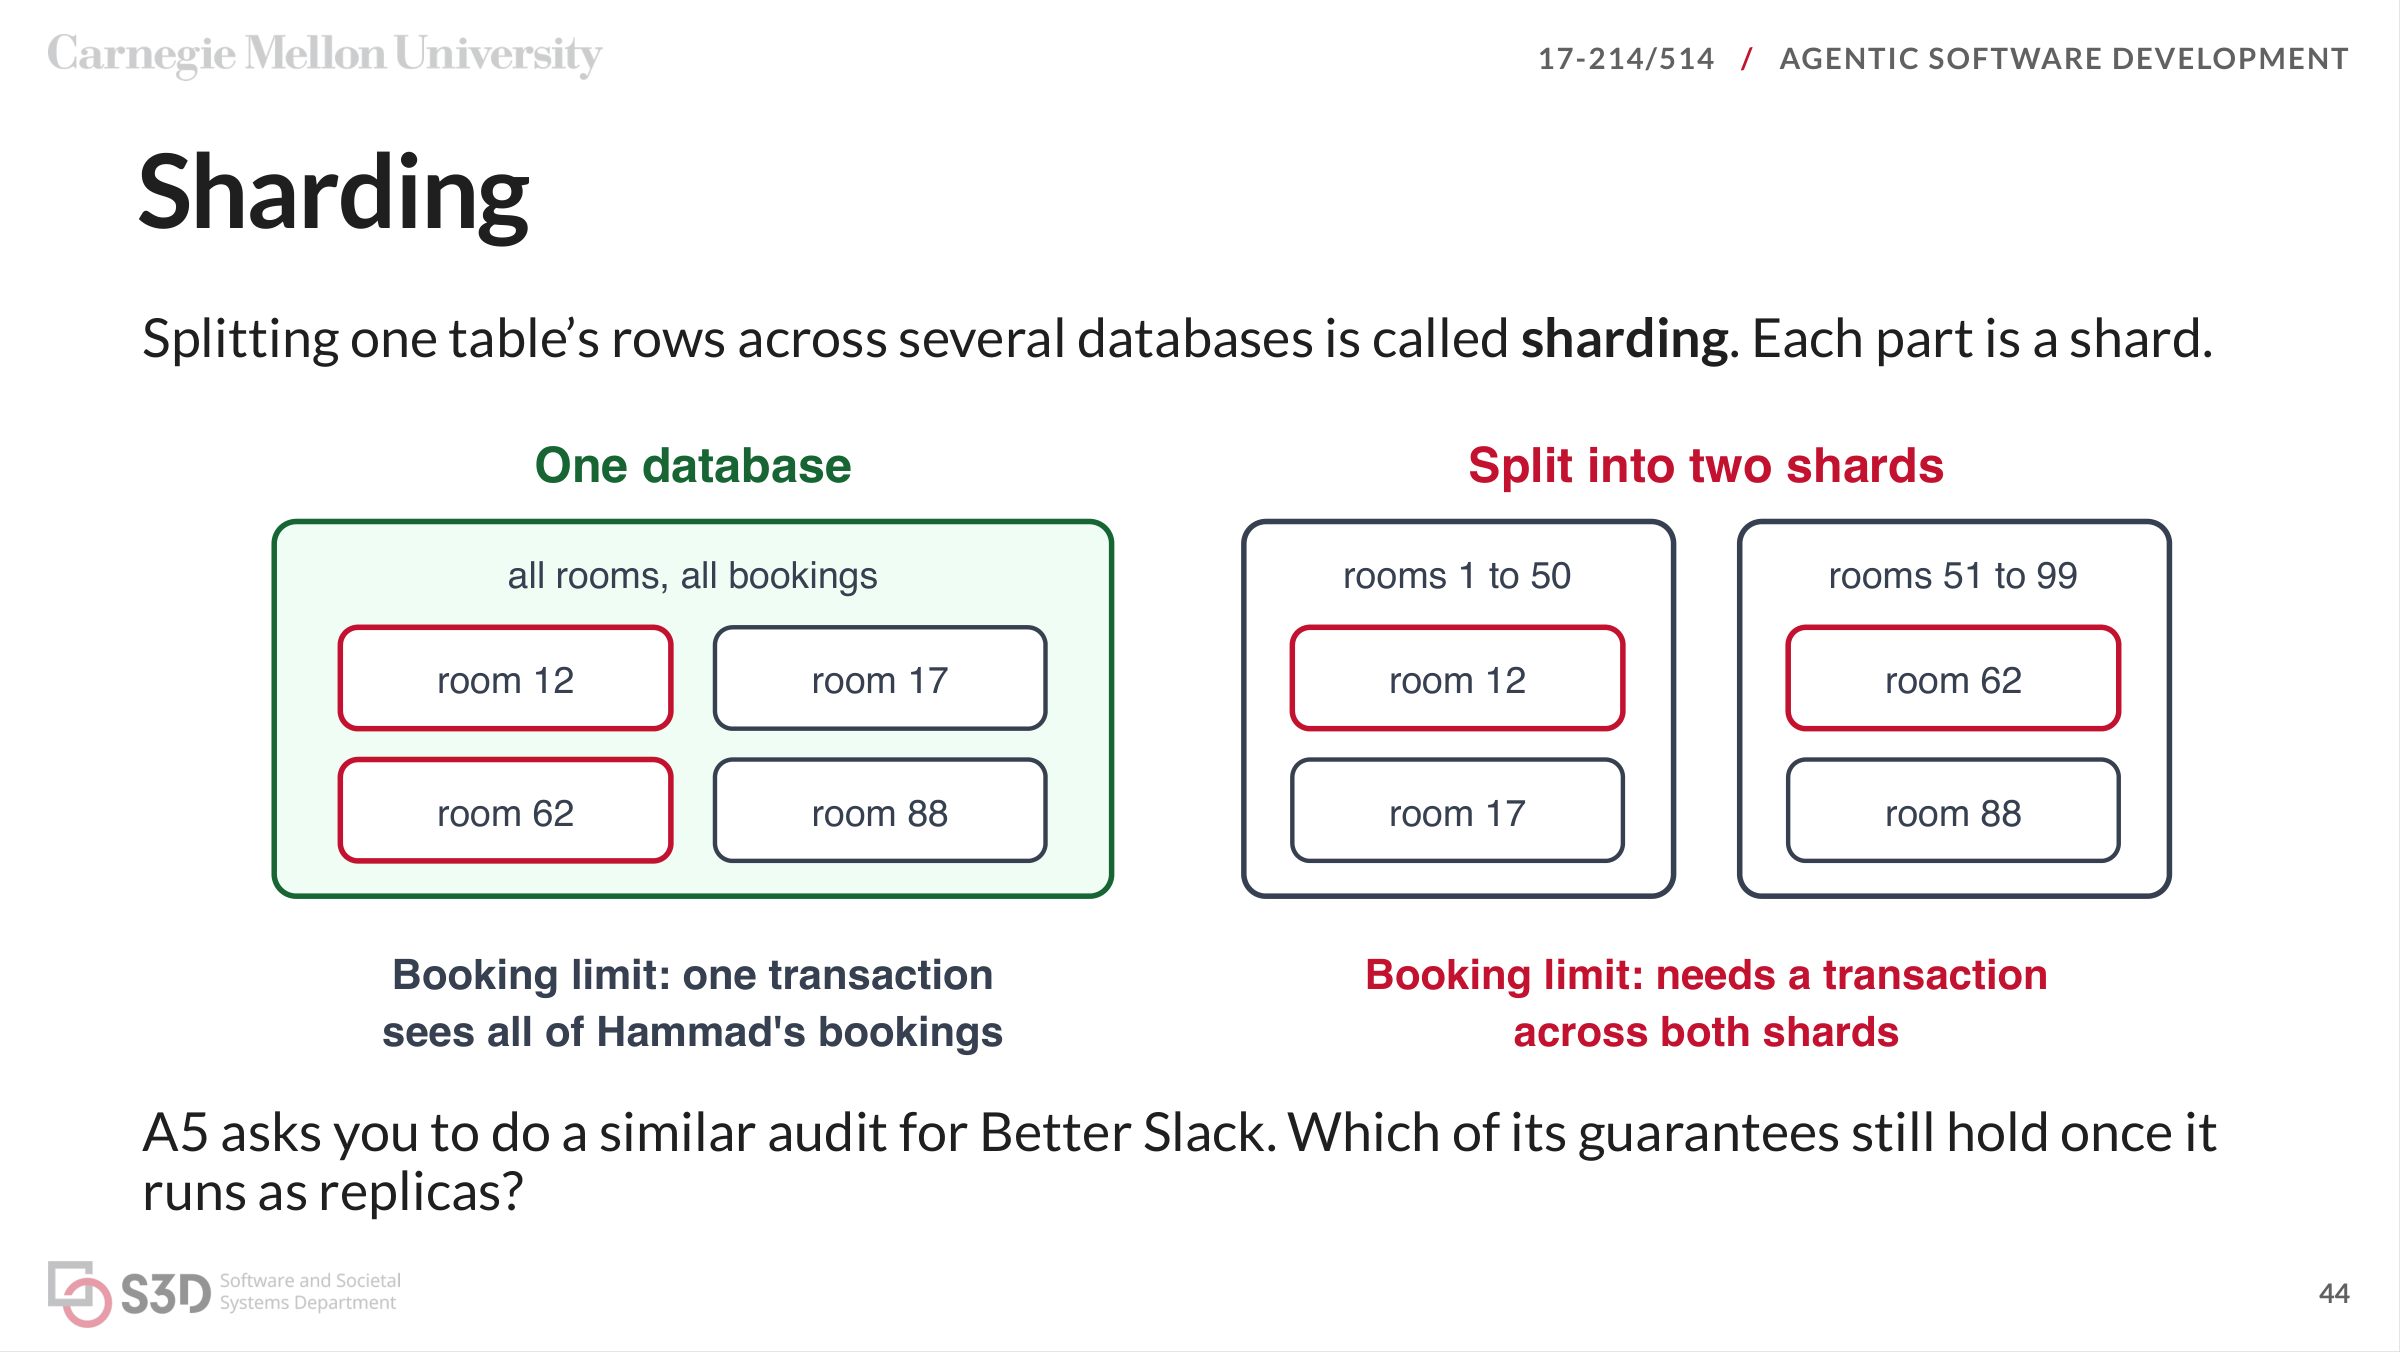
事务边界还影响子系统划分。需要一起变化的数据尽量放在同一边界;按房间分片后,跨房间的用户上限就可能需要跨片协调。
缓存失效可以通过 BookingMade 等事件触发,但仍要确定允许多旧、谁负责更新、如何重建。最忙会议室的统计面板可以容忍延迟,真正创建预约时则需要当前约束。陈旧读取与丢失更新也不同:前者看到旧值,后者让并发修改被覆盖,后续并发课会继续展开。
分片又把原来同一数据库内的不变量拆开。按会议室范围分到两个库后,某个学生在两边的总预约上限就需要跨片协调。增加数据副本或分片以前,应该先列出原来依赖单一事务的保证。
数据结构逐步演进
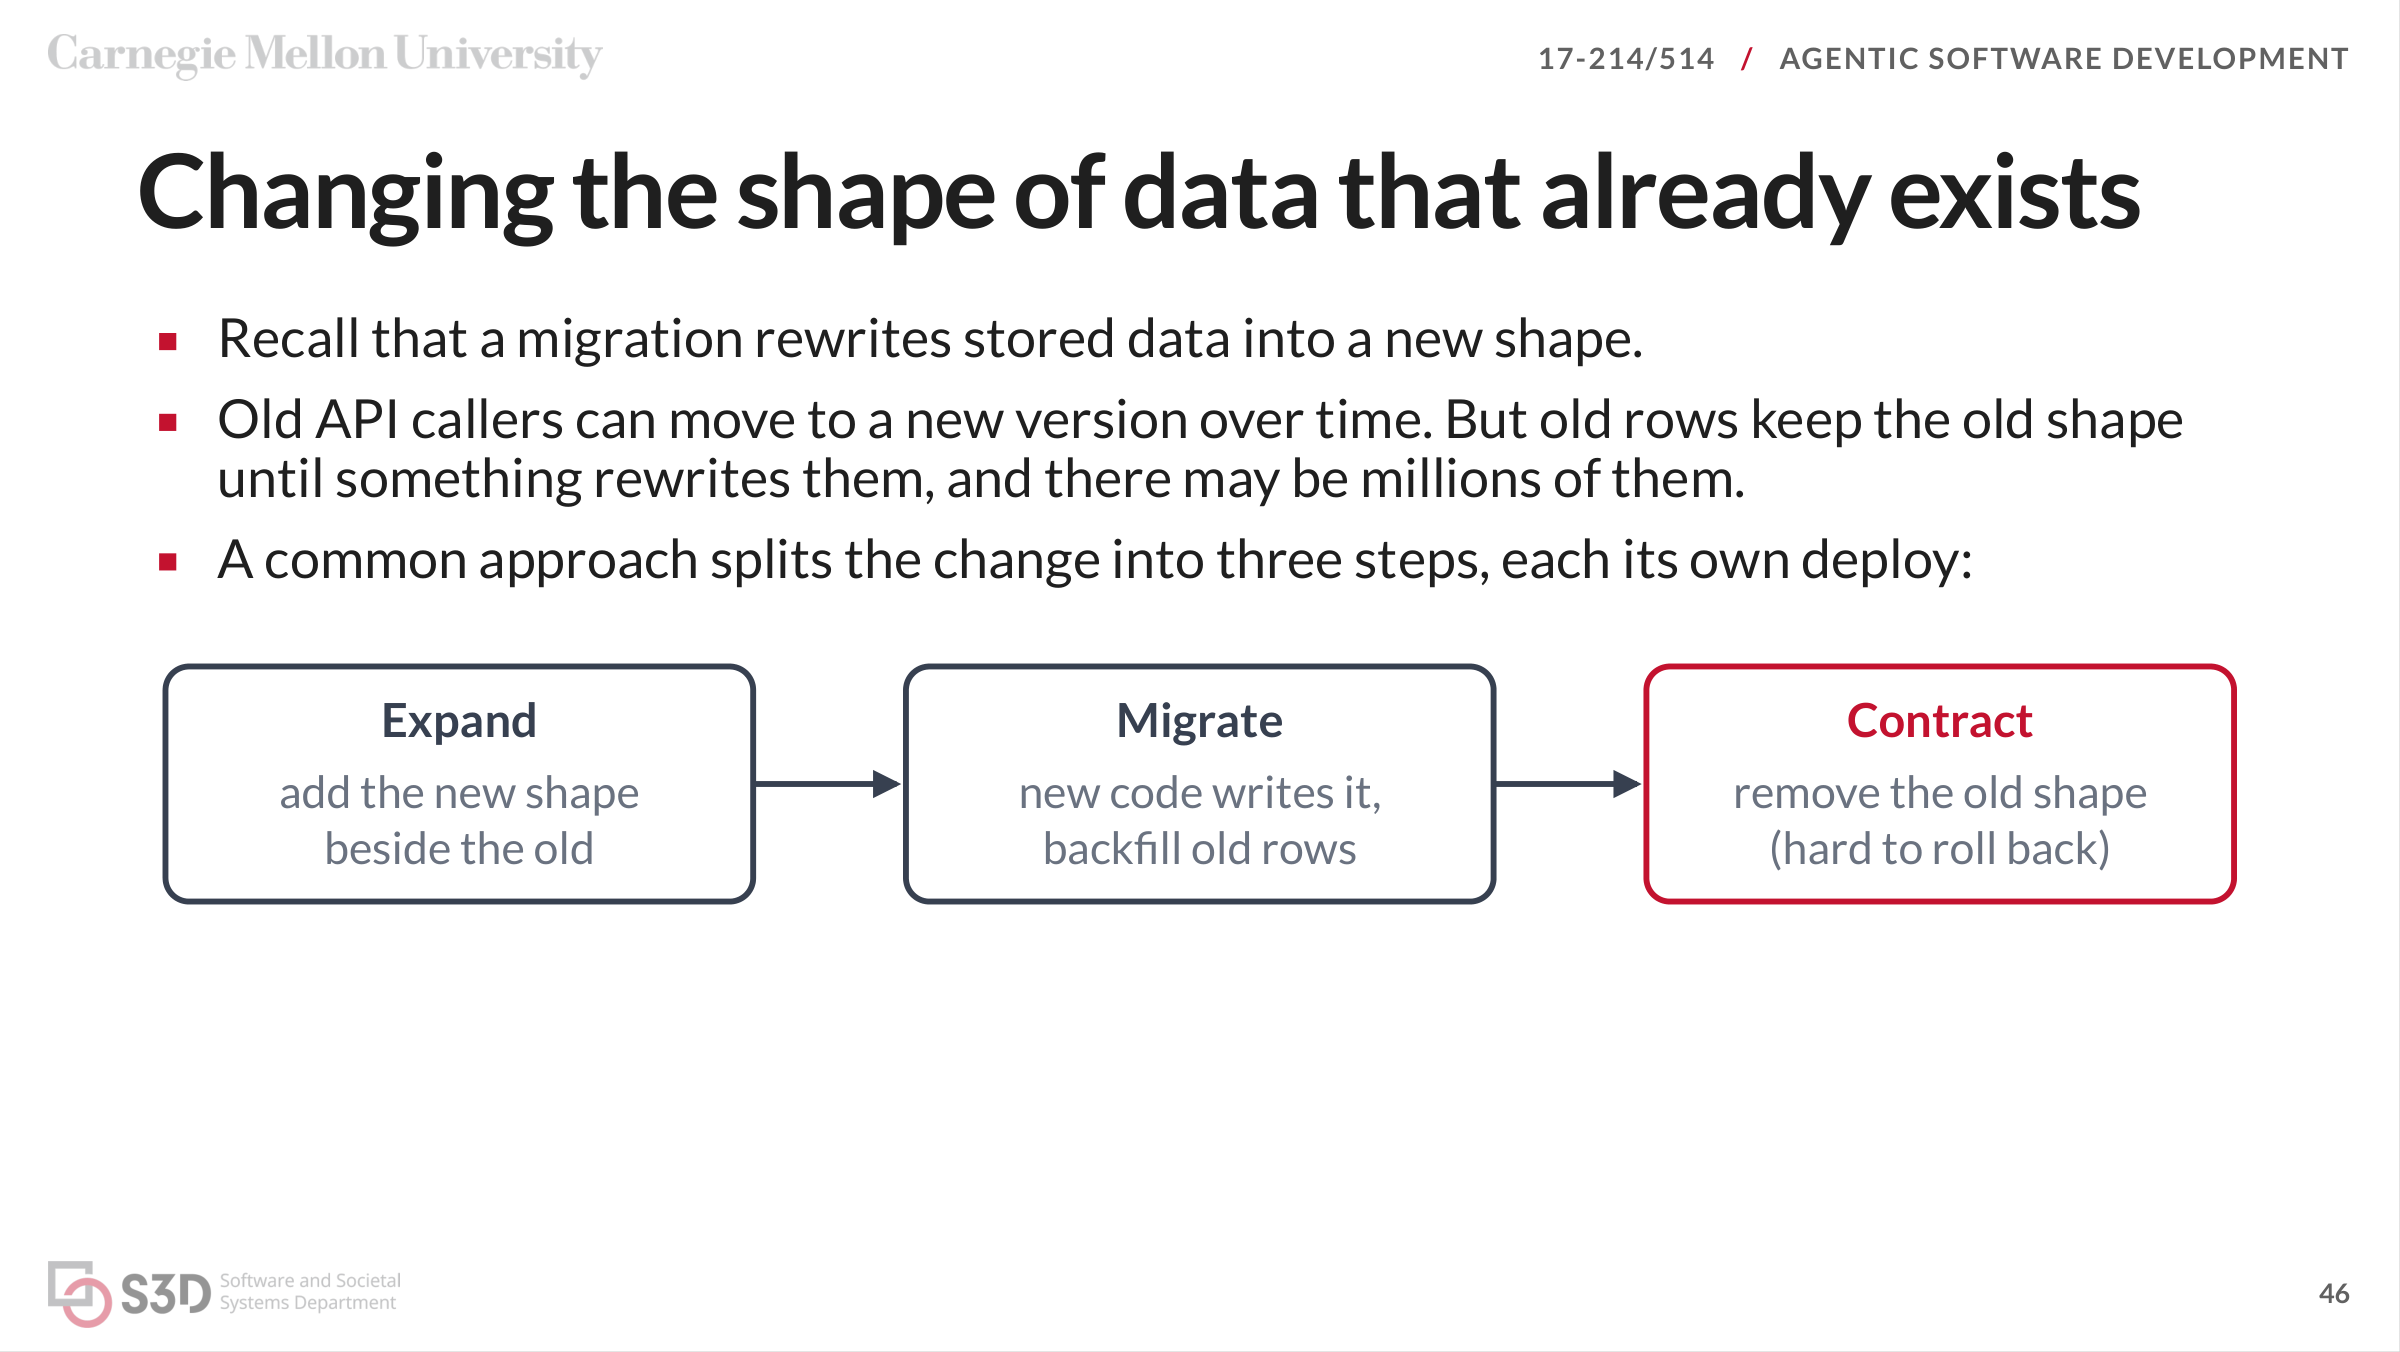
增加取消原因时,可以先加可空列,再由新代码写入并回填旧数据,最后收紧约束。每一步都要检查当时仍运行的版本,事件字段同样需要兼容旧读取者。
迁移文件应版本化并评审。备份还要实际恢复,明确可丢失的数据量和恢复时间。回退 Git 提交无法恢复已删除列中的数据,因此数据模型与迁移不能仅以代码可回滚来判断风险。
取消原因的迁移可以按课件具体展开:
1 | -- 扩展:旧版本仍可写入,新版本开始使用新列。 |
每一步应核对仍运行的旧版本,迁移工具则记录执行过的文件与顺序。事件也要保留版本与旧读取者兼容性,不能复用旧字段表达新含义。
课件以备份失效案例说明,备份文件存在不等于可恢复;需要实际恢复到备用库,并明确恢复点与恢复耗时。迁移目录的专门评审、只读分析凭证和接近生产数据的演练,都是把难逆转的数据变化与普通代码修改区别对待。