课程视频
AI4DB 与 DB4AI
高级数据库最后一个专题从两个方向讨论 AI。AI4DB 用学习方法改进数据库内部决策和运维,DB4AI 则让数据库更好地管理训练数据、特征、模型与推理任务。两者服务的对象不同,也可以在同一系统中结合。
搜索与配置优化
查询重写、连接顺序、索引选择、视图选择和配置调优都具有较大的候选空间。学习模型可以预测候选质量,或者辅助决定下一步探索方向,但仍要保留合法性检查与执行约束。
课程以强化学习调参说明状态、动作和回报:状态来自资源与内核指标,动作改变参数,回报反映性能变化。真实负载会变化,试验动作也可能影响服务,因此离线训练、在线评估、约束与回退都影响方案能否使用。
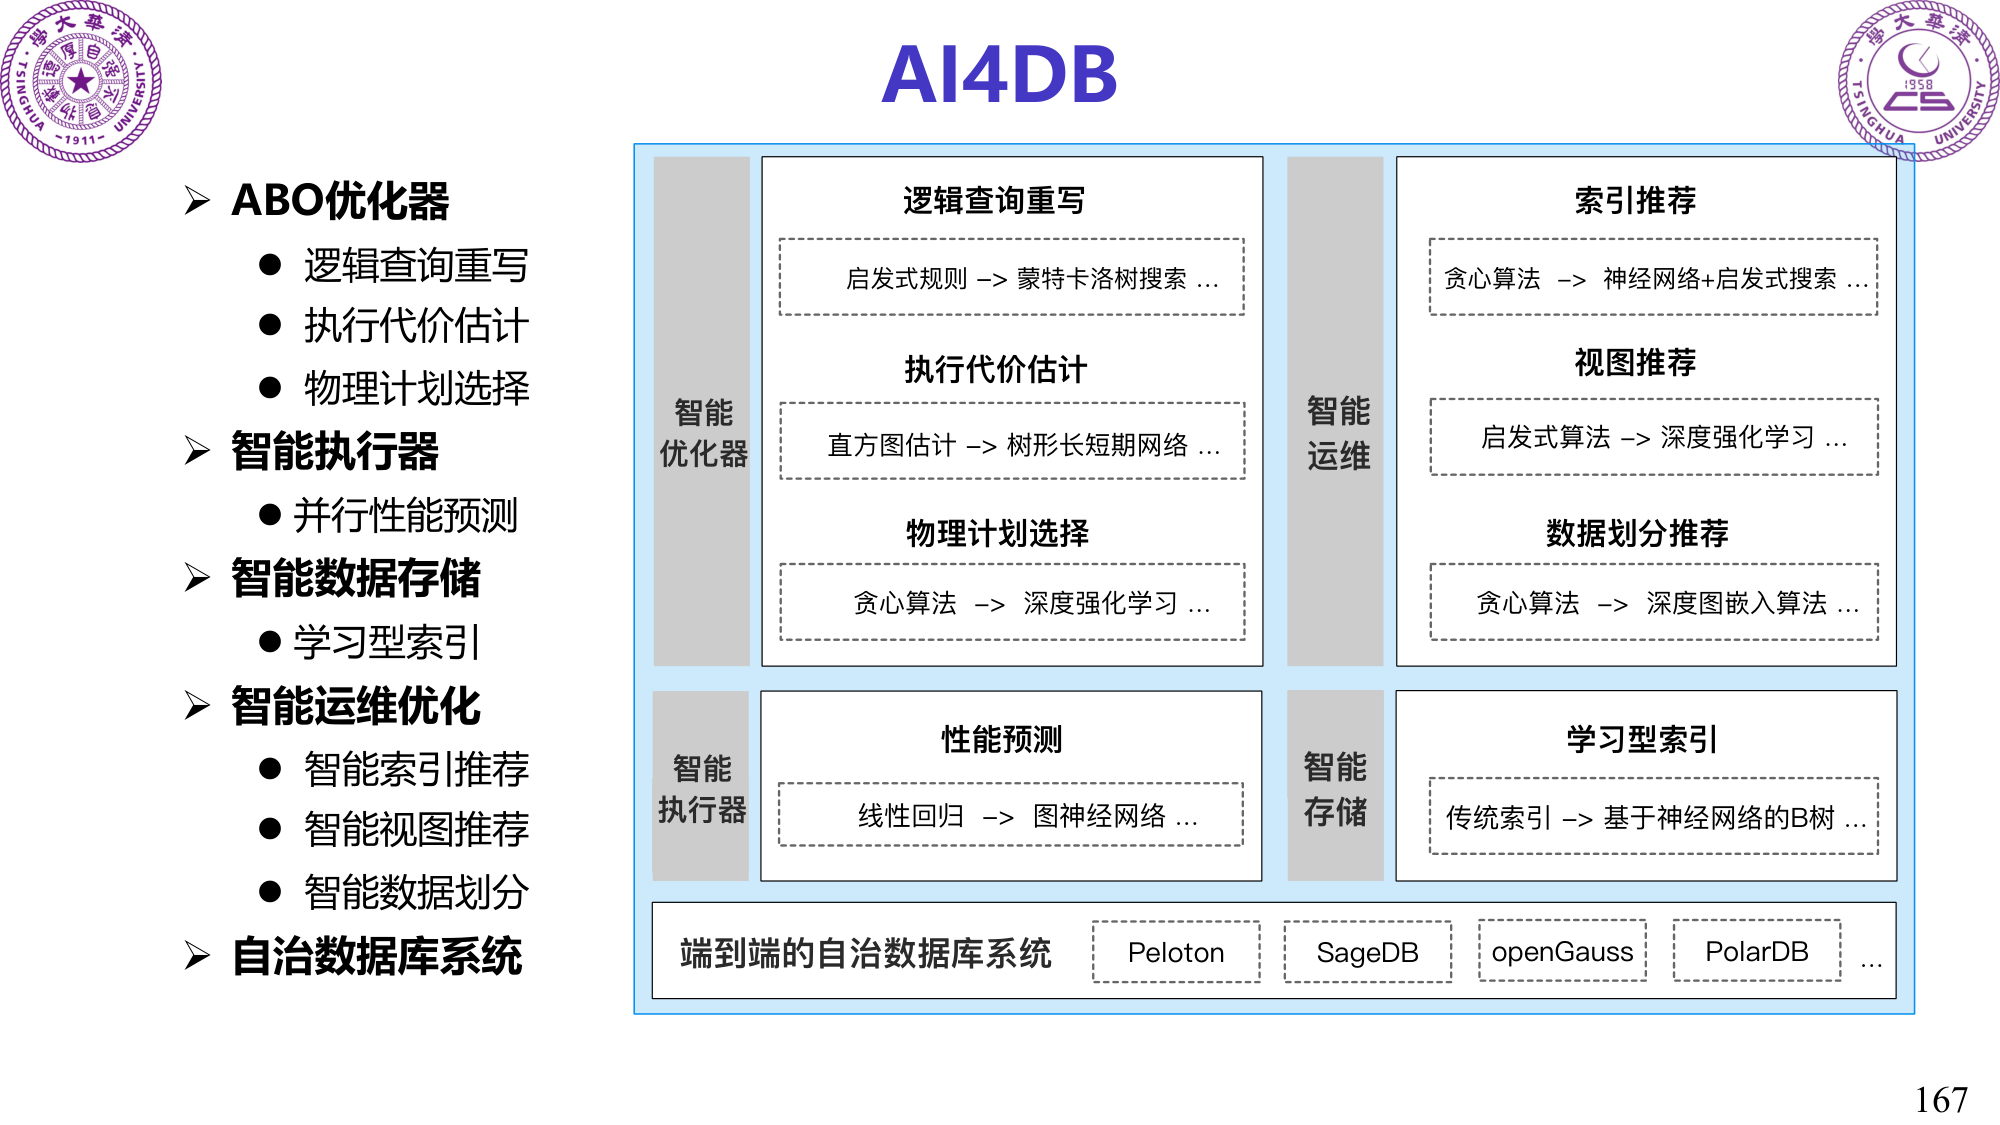
索引和视图的收益不仅是读取加速,还要扣除构建、空间和更新维护成本。一个在固定查询上有效的建议,换到写密集负载后可能不再划算。
回归与时序预测
基数估计预测算子输出数量,代价估计预测工作量或耗时,收益模型估计配置变化后的效果。它们的标签、特征和误差传播方式不同,不能只用同一个平均误差描述全部任务。
模型可以使用查询结构、谓词、数据分布、索引与硬件信息。多列联合分布建模有助于处理传统独立假设失效,但数据更新与未见查询也可能带来分布变化。
工作负载预测先识别查询模板与到达率,再将相似趋势分组,预测未来资源需求。它可以辅助预热、调度和扩容,预测误差仍需被执行系统容纳,而不能让一次错误预测直接破坏正确性。
数据库为 AI 提供什么
DB4AI 的基础是数据治理:发现、清洗、标注、血缘和元数据,使训练与推理使用的数据能够追踪。库内特征计算和模型推理可以减少搬运,并复用权限、事务与执行资源。
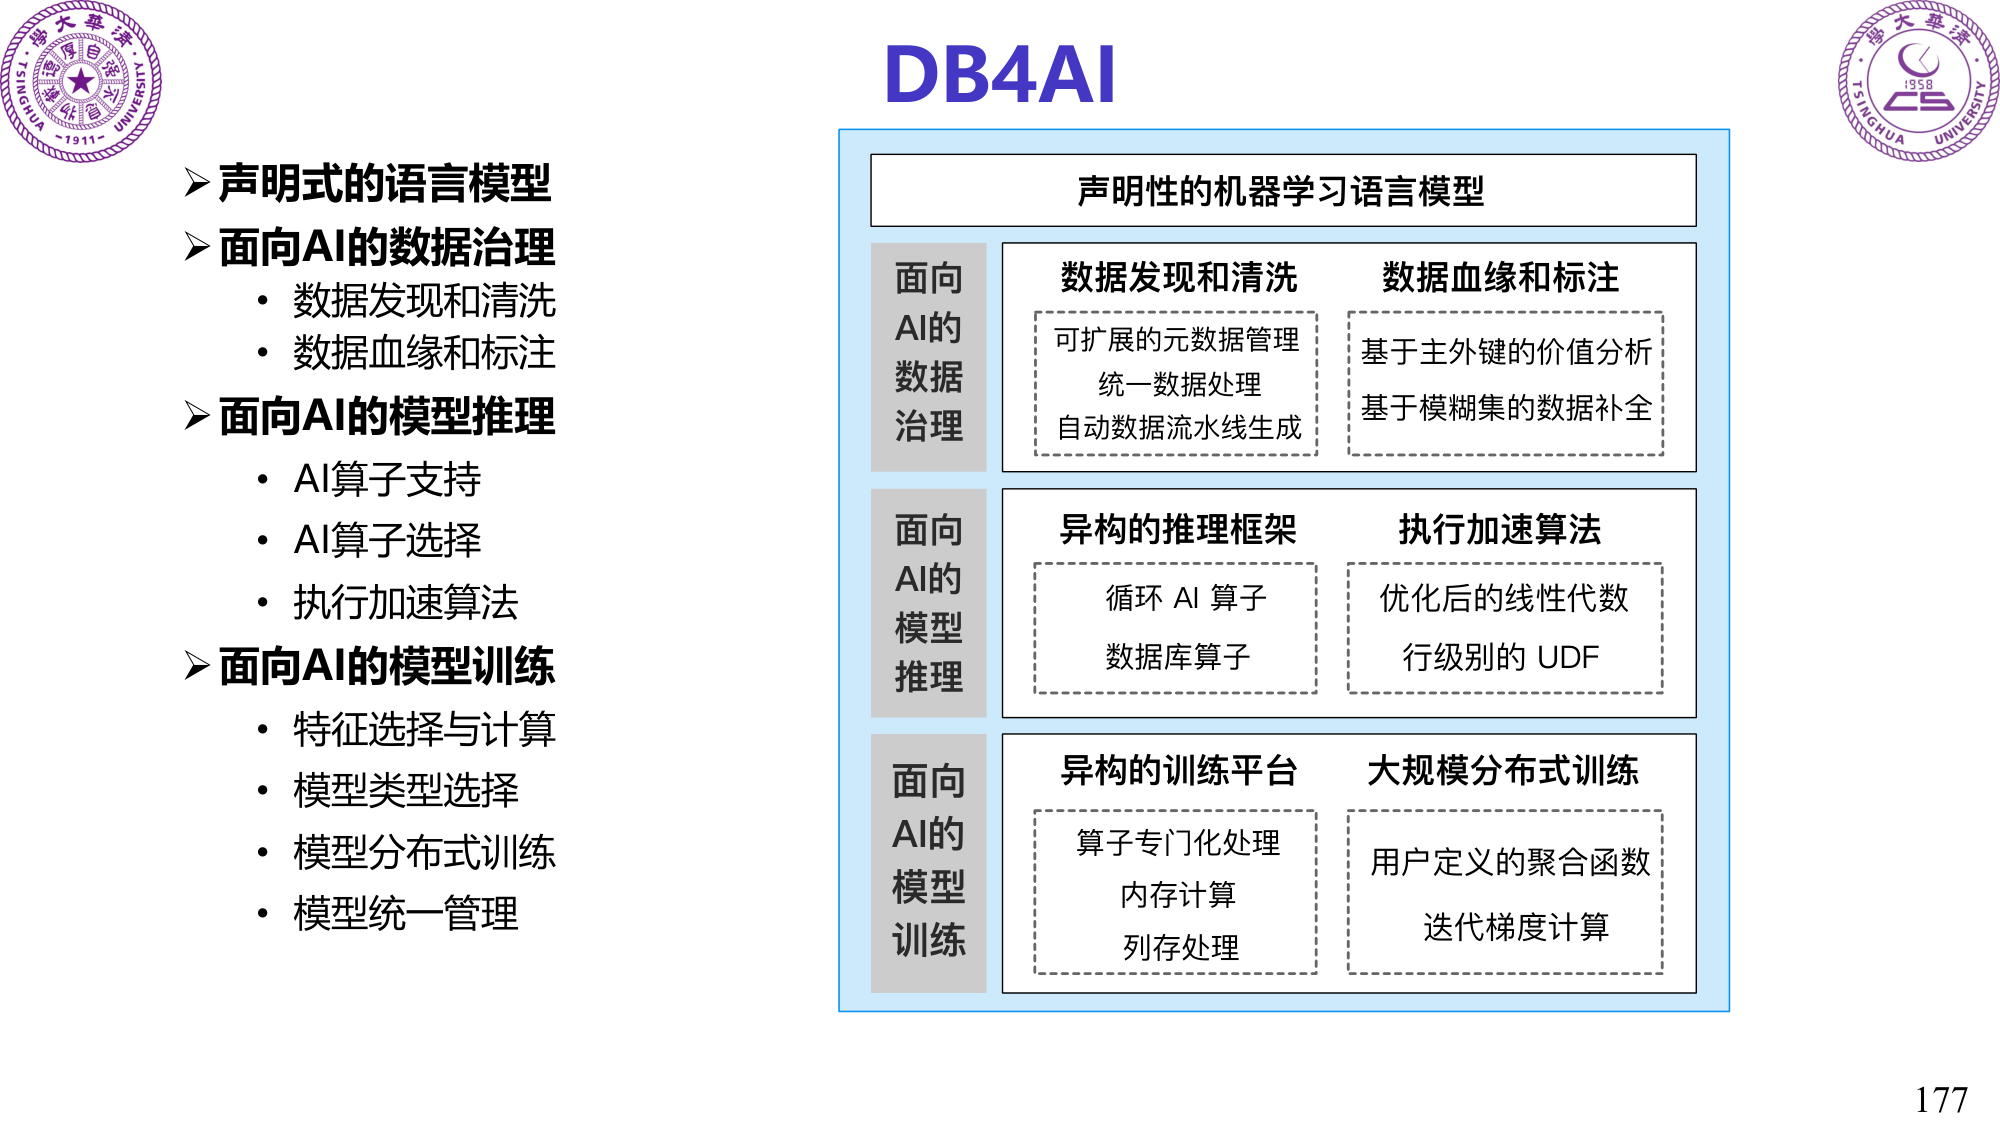
模型训练还涉及特征选择、算法、迭代计算、分布式执行与版本管理。声明式接口降低调用门槛,底层仍需明确模型如何训练、何时更新和如何验证质量。
向量检索与大模型
课件将向量检索用于领域知识、历史会话和相似请求缓存。检索把候选上下文提供给模型,可以改善数据可达性,但不能保证输出一定正确;相似请求缓存也要考虑权限、时效和参数是否一致。
LLM as Optimizer、LLM as DBA 是课程提出的探索方向。生成的 SQL、计划和运维建议需要经过规则、代价与实际执行验证。模型承担建议或预测时,数据库原有的语义、隔离和恢复保证仍必须由可靠机制维护。