课程视频
硬件变化如何影响数据库
本专题依次讨论多核与 NUMA、GPU、FPGA、NVM 和 RDMA。硬件参数与性能图放在课件对应实验背景下理解,重点是每种能力减少了哪类开销,又增加了哪些约束。
多核与 NUMA
多个核心可以并行扫描、分桶和连接,也可能竞争同一个计数器、哈希桶或缓存行。原子操作保证单次更新不可分割,并不消除所有共享访问成本。
NUMA 中本地与远端内存访问代价不同,数据分配、线程绑定和任务调度需要一起考虑。Work Stealing 可以缓解某个队列工作过多,但偷取远端数据任务可能失去局部性,需要在负载平衡和数据距离间选择。
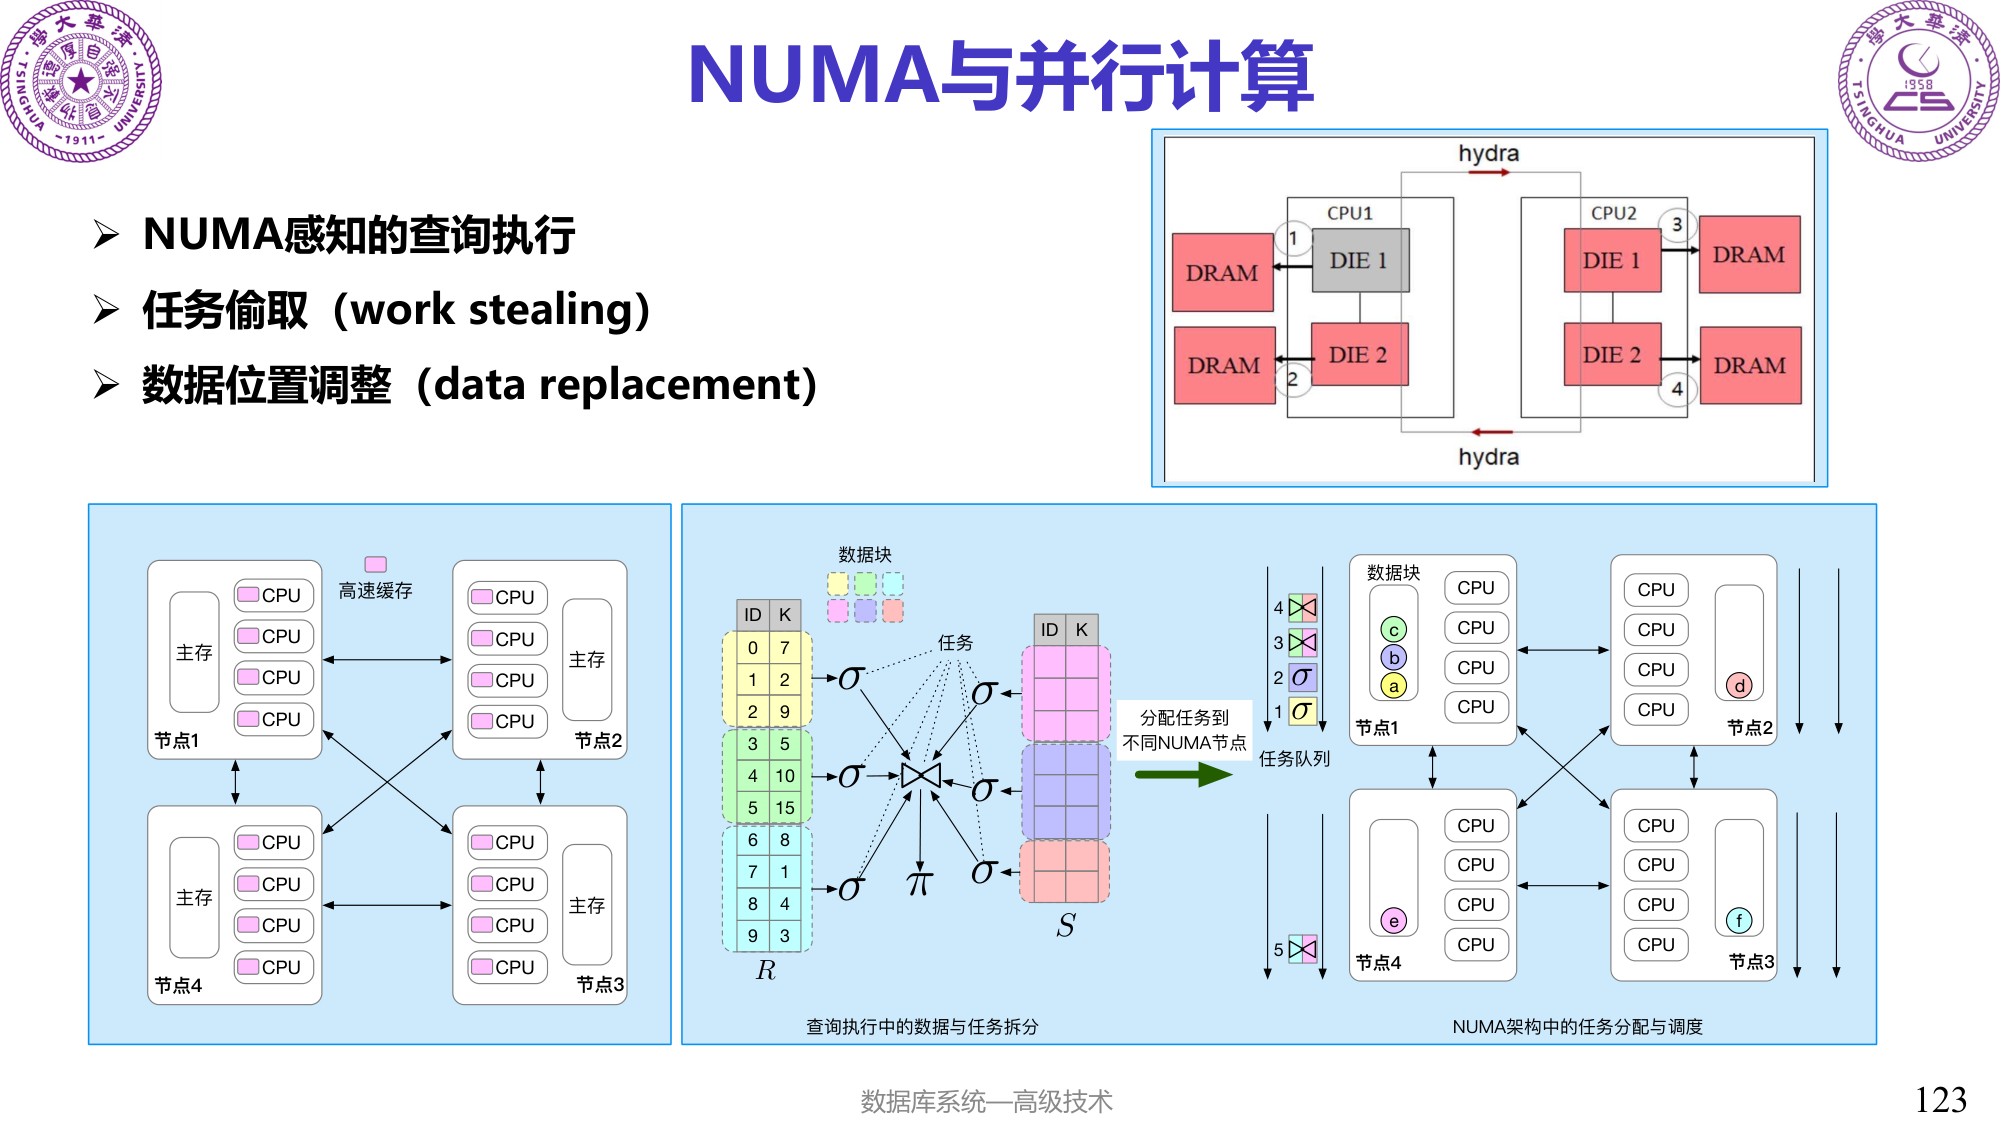
事务系统还可以将数据与负责它的 CPU 关联,减少跨分区访问;事务涉及多个分区时,又必须恢复相应协调。
GPU 的批量并行
GPU 适合大量相似运算。课件的选择算子先让线程判断各记录是否匹配,生成标记和局部计数,再通过前缀和安排输出位置,减少所有线程同时争用一个全局计数器。
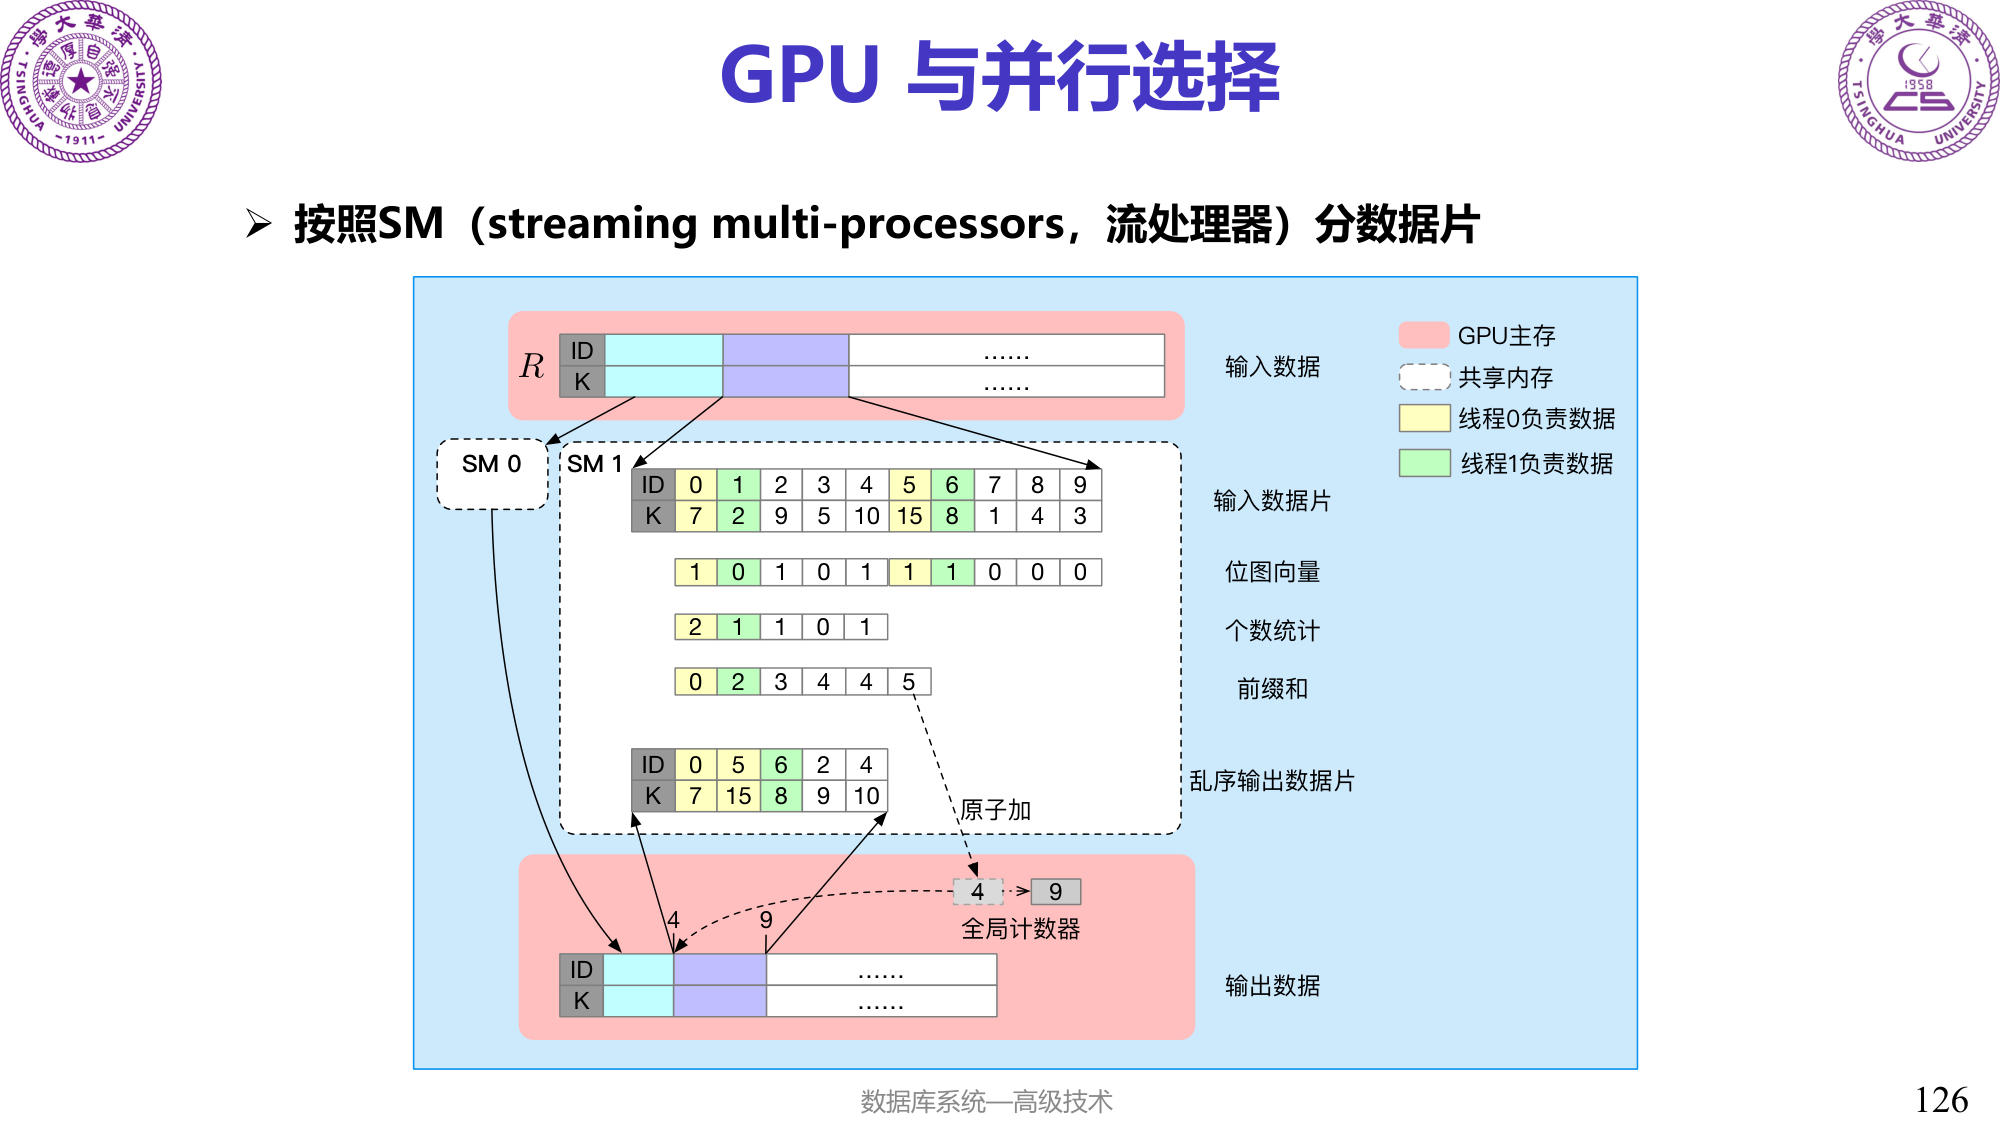
哈希连接也需要把桶连续组织,减少碎片访问并控制显存占用。实际收益必须包含 CPU 与 GPU 之间的数据搬运、核函数启动和中间结果,不能只比较 GPU 内部计算速度。
FPGA 下推
FPGA 可以实现专门的流水逻辑,将部分过滤、投影或压缩解压放到靠近存储的位置。先减少数据,再穿过较慢链路,可能比把全部原始数据送回 CPU 更划算。
代价是开发、配置和算子适用范围。一个固定逻辑很快,不代表任意 SQL 都能直接获得同样加速,系统还要安排不支持操作的回退路径。
NVM 与持久化顺序
课件讨论的 NVM 兼具非易失和较细粒度访问特性,可以改变数据、日志和索引布局。它仍有读写不对称、写入成本以及持久化顺序问题,普通 CPU 写入完成也不等于相关缓存行已按正确次序持久化。
课程用 Undo 与状态位、版本号及原子发布展示恢复设计,并介绍减少节点内条目移动的写优化 B+Tree。具体能否省略某类日志,取决于协议、原子写粒度和持久化保证,不能由“介质不丢数据”单独推出。
RDMA 与远端内存
RDMA 允许网卡直接访问已注册的内存,减少内核路径和部分数据复制。单边操作不要求远端应用为每次访问主动收发,但本地与远端仍需管理注册、权限、缓冲生命周期和并发状态。
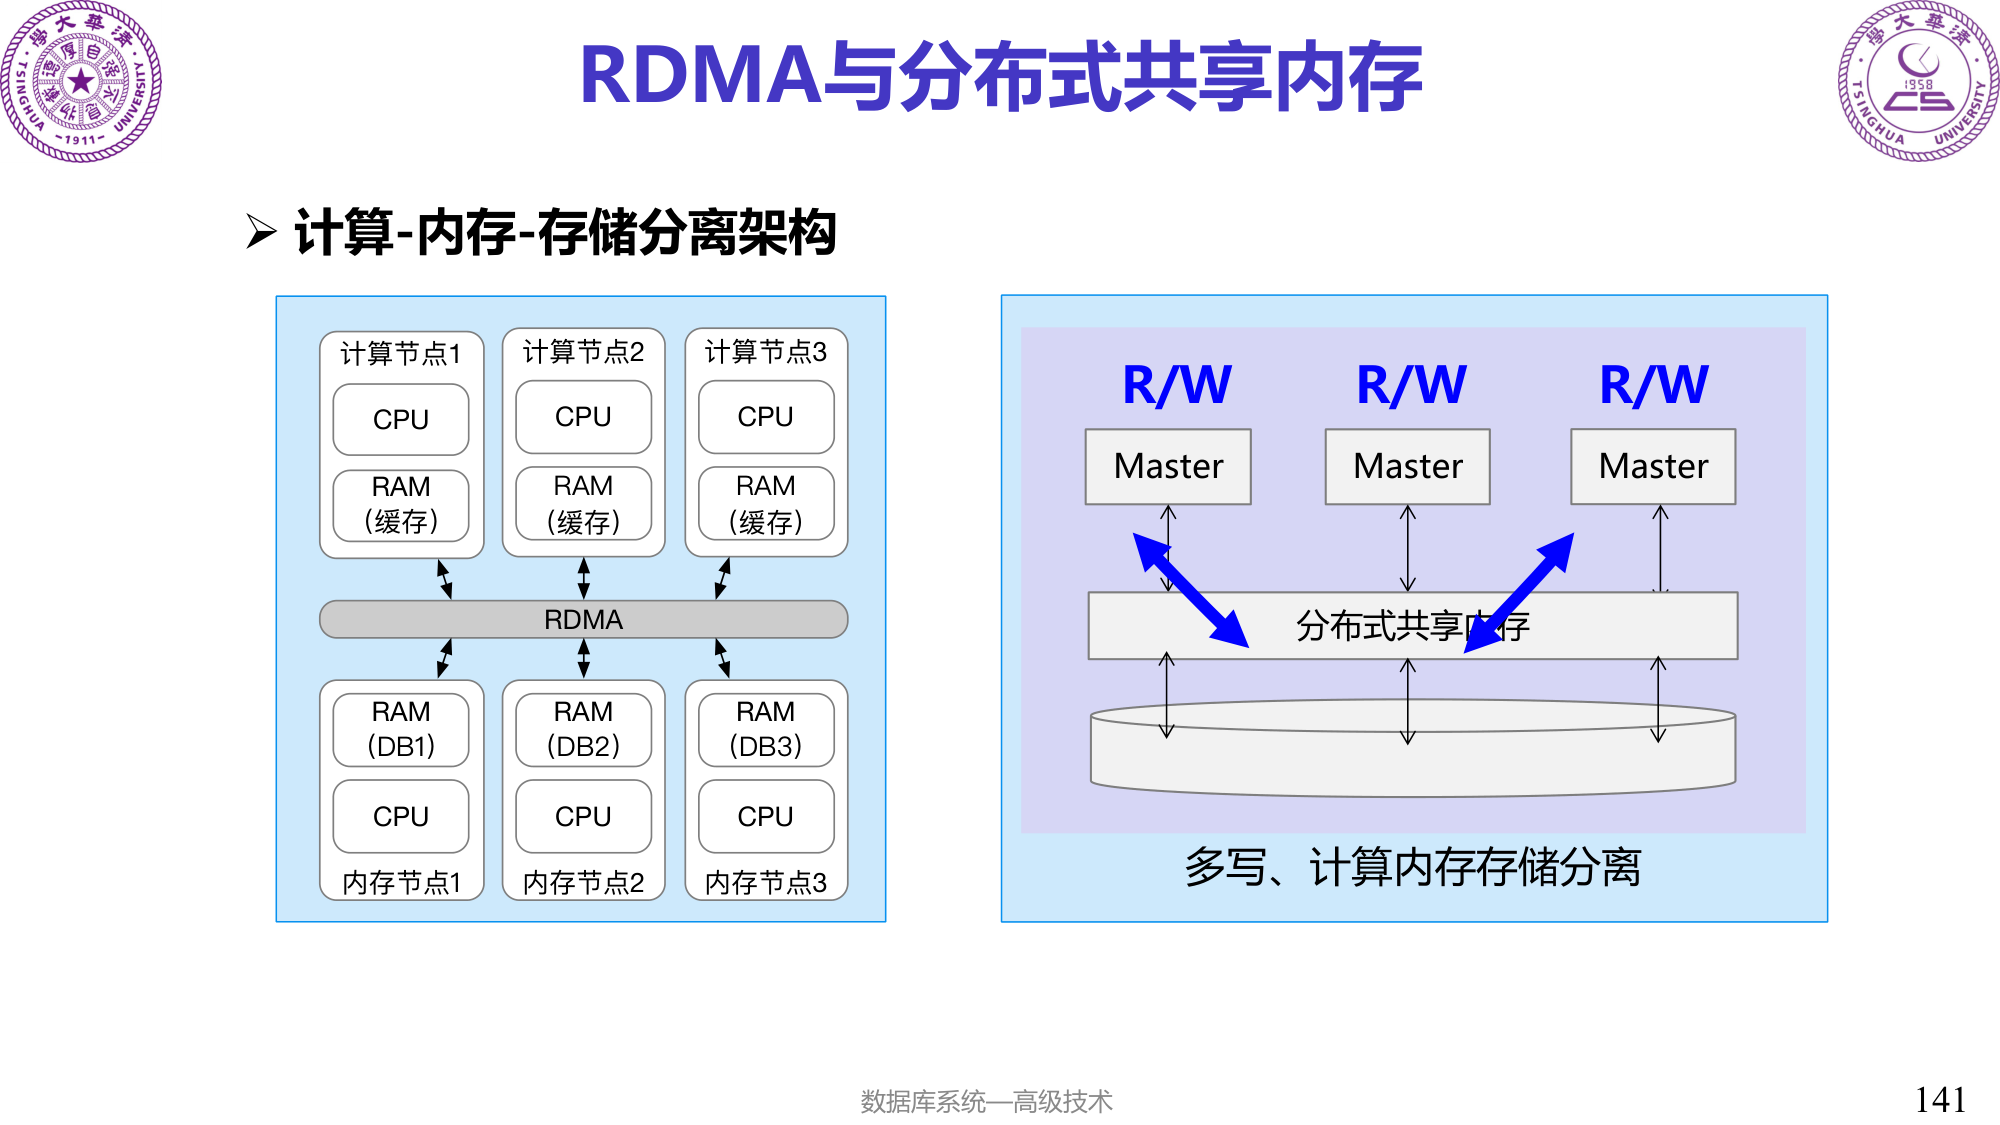
课程将其用于共享内存池、分布式索引和主备日志或数据传播。远端写到内存不自动等于远端持久提交,也不能替代事务协议;故障时仍要知道哪些状态已经发布、复制和确认。