课程视频
索引提供怎样的入口
索引将搜索键映射到数据位置,减少查询需要检查的页面。课程先按聚簇与非聚簇、稠密与稀疏、单层与多层、唯一性及列数量分类,再讨论具体结构。分类描述不同维度,例如组合索引同时也可以是唯一索引或非唯一索引。
索引组织表将记录放在索引结构内,辅助索引则通常保存指向记录的标识。增加索引会占用空间,并使插入、删除和更新需要维护更多结构。
B+Tree 的基本操作
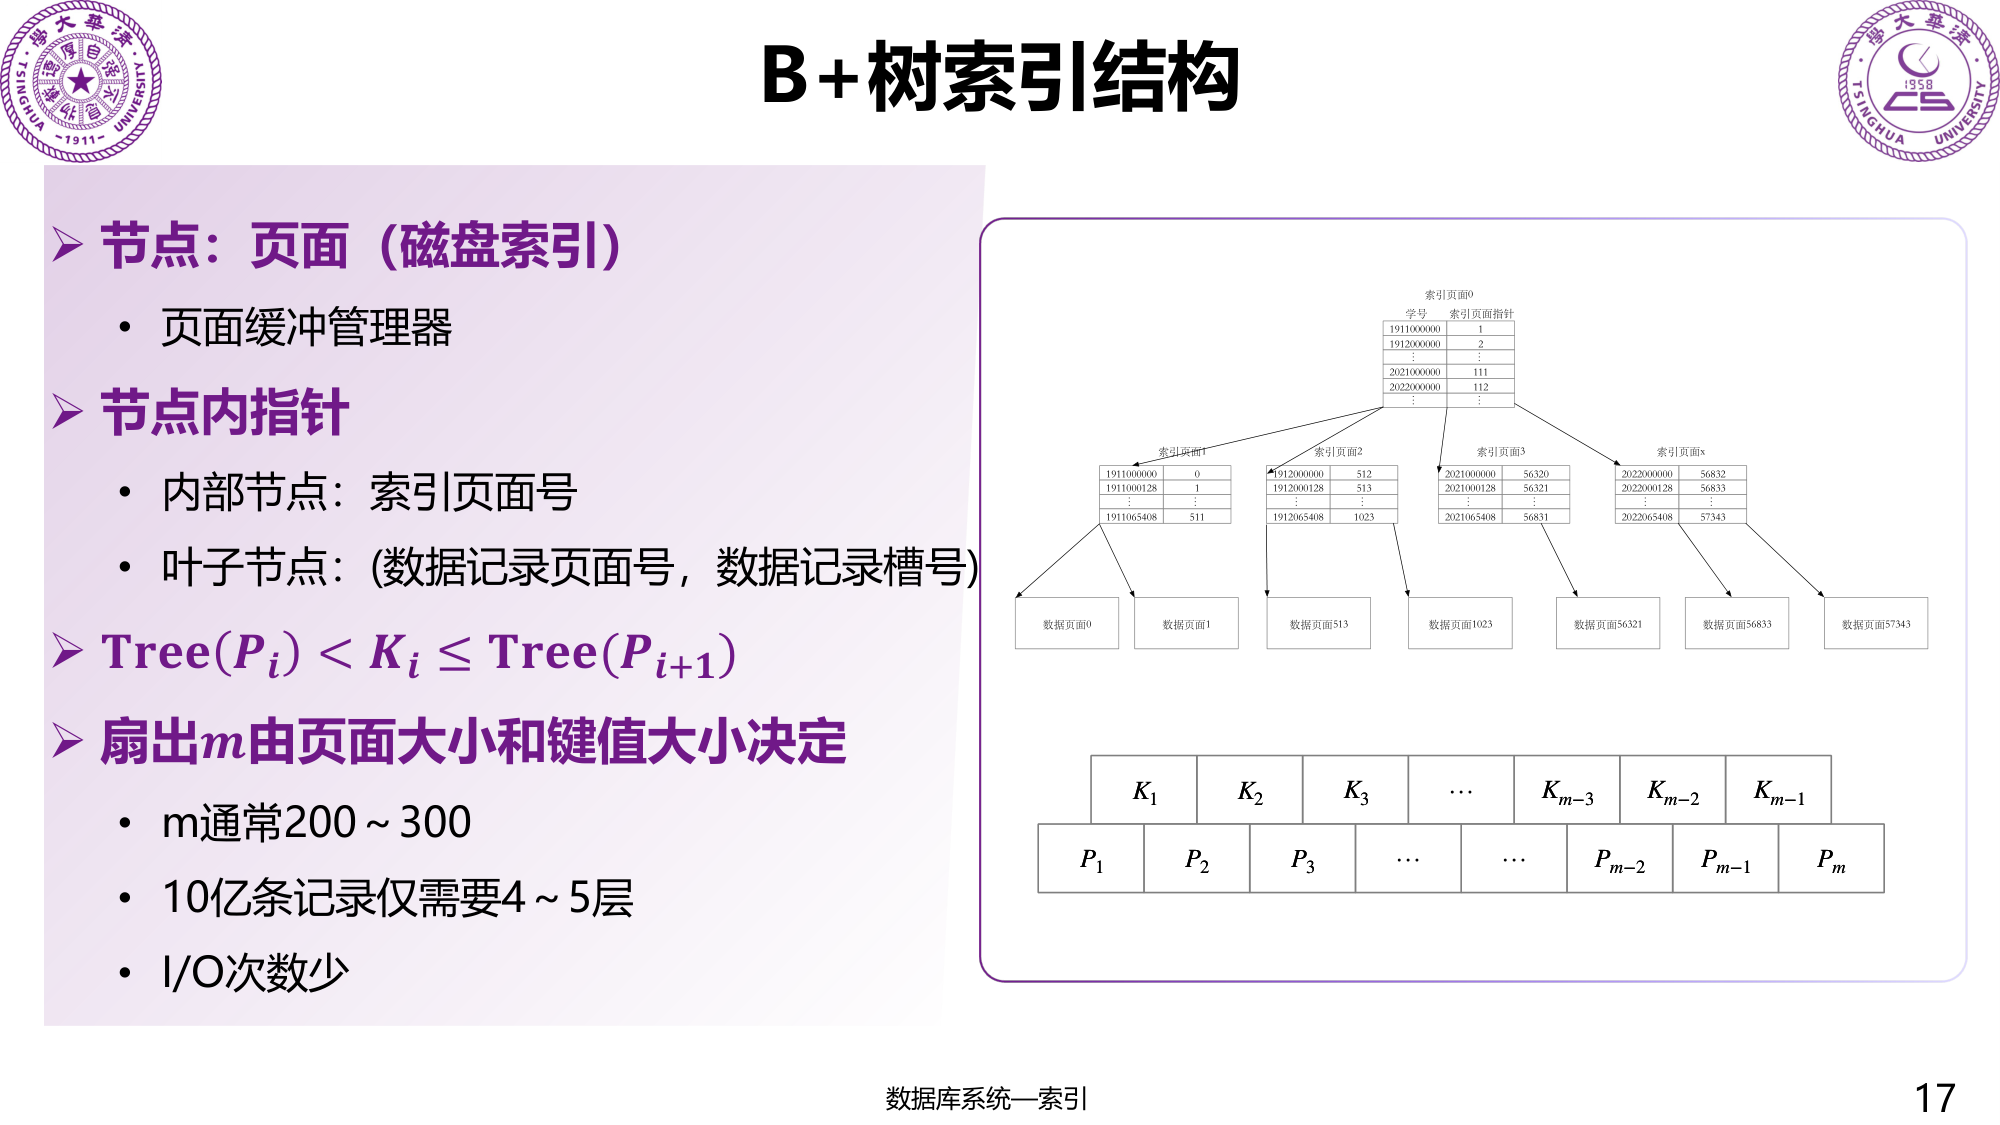
B+Tree 使用较大扇出减少层数,所有叶子到根的距离相同。内部节点通过分隔键选择子树,叶子保存记录或记录位置,并保持可扫描的顺序。
查找逐层选择区间;插入先修改叶子,满时分裂并向父节点增加入口,必要时继续向上传播;删除造成节点过稀时,可以借用兄弟条目或合并,再调整父节点。根的特殊情况需要单独处理。
并发访问采用 Latch Coupling,先取得孩子的保护,再在孩子安全时释放祖先。这里的安全取决于操作是否会继续影响上层,查找、插入和删除的判断不同。乐观路径先按较轻方式下降,真正需要结构调整时再重试更强的路径。
B-link Tree 与 Bw-Tree
B-link Tree 为内部节点也增加右侧链接和 High Key。节点分裂后,即使父节点尚未更新,搜索仍可以根据键上界沿右侧链接找到正确位置,使部分分裂中间状态可以被其他访问者安全处理。
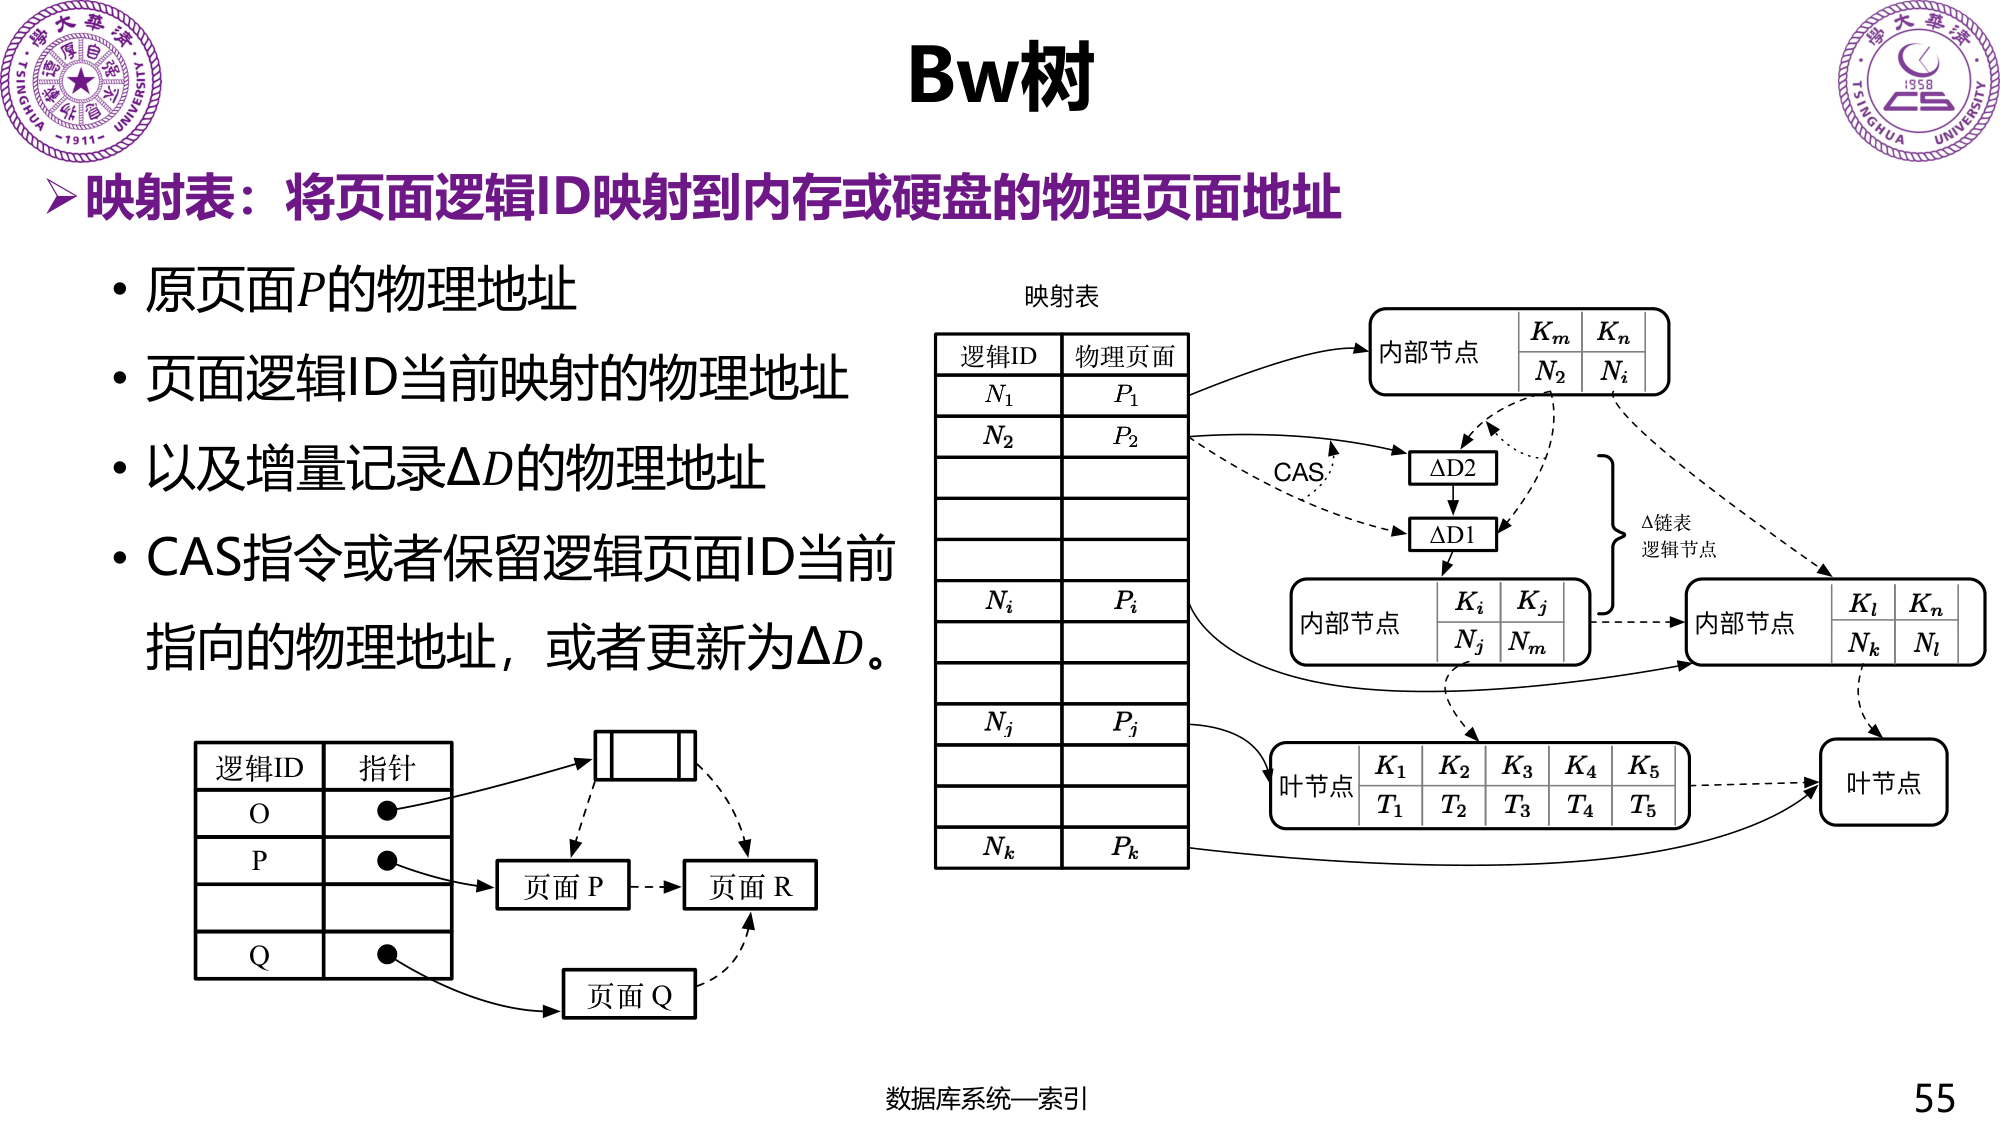
Bw-Tree 使用逻辑页号到物理地址的映射表,在原节点前追加 Delta Record,通过 CAS 发布新链头。它减少原地更新与 Latch 竞争,但查询要解释增量链,链过长时需要 Consolidation,并在没有读者再引用旧节点后回收。
哈希与跳表
静态哈希表需要处理碰撞与容量限制。可扩展哈希通过目录、全局深度和桶的局部深度拆分数据;线性哈希按分裂指针逐步扩容,避免一次重建全部目录。一致性哈希则用于节点变化时减少键的重新映射,关注的问题与单机槽位碰撞不同。
Skip List 在有序链表上增加随机层级的跳转指针,查询从高层向右、再向下,插入和删除修改相应层的前驱链接。它提供期望对数访问,但指针布局与内存管理仍影响实际开销。
LSM 与过滤器
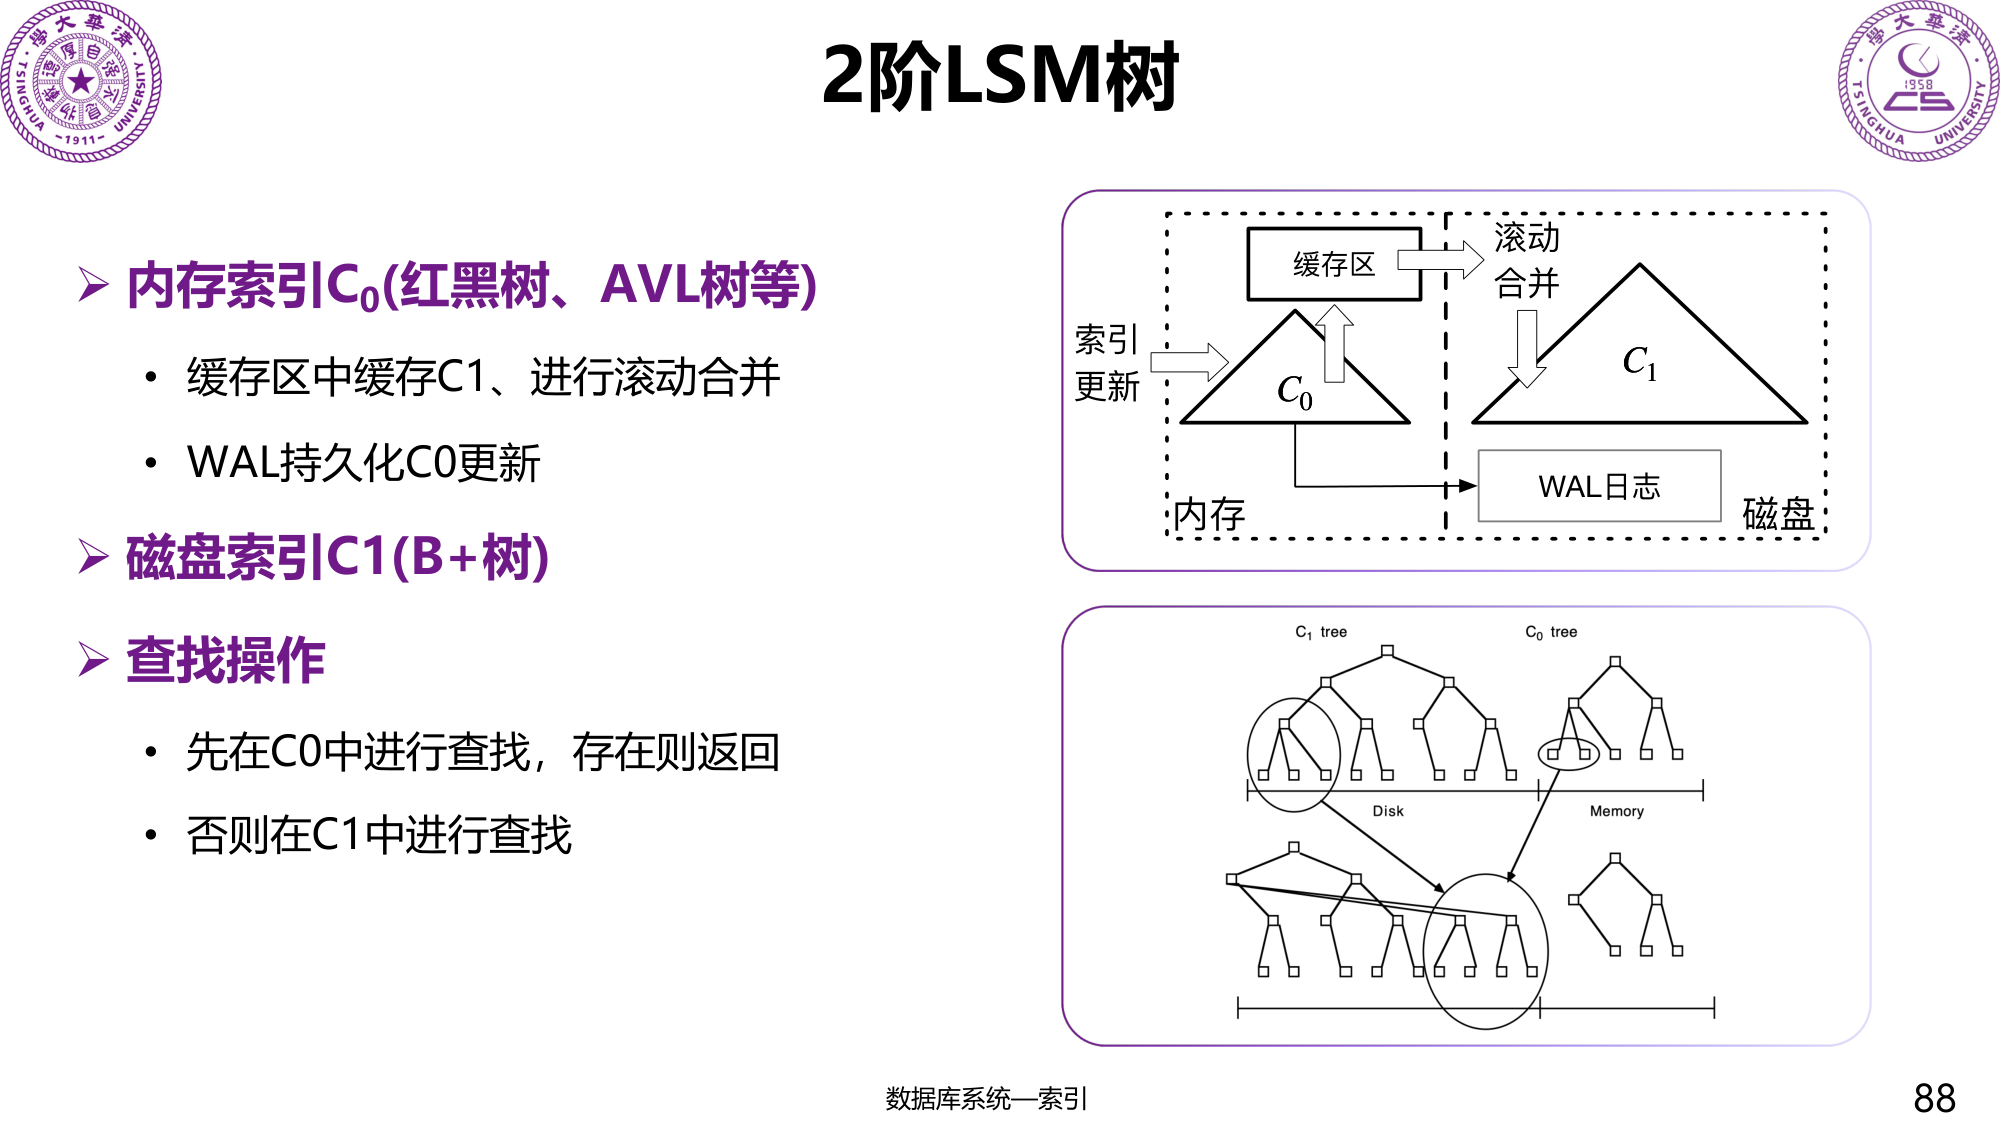
LSM 将更新先写入内存结构,再合并到磁盘层。WAL 保护尚未进入持久数据文件的更新,删除使用标记,查询需要按照版本或层级次序找到有效结果。
随着层级与文件增长,读取可能检查多个位置,合并又产生额外写入,旧版本还会占用空间。课件分别以读放大、写放大和空间放大解释这些成本,并介绍分区合并与 Bloom Filter。
Bloom Filter 用多个哈希函数设置位数组。查询遇到零位即可排除,不全为零时仍需检查数据;普通过滤器允许假阳性,正确维护时不会漏掉已插入键,不能直接清零共享位来删除。
位图、多维与学习型索引
位图索引为属性值保存匹配位置,通过 AND、OR 等位运算组合多个条件,适合某些低基数分析列。高更新成本和位图大小需要一起考虑。
网格文件划分空间,四叉树递归划分区域,KD-Tree 沿不同维度二分,R-Tree 使用最小包围矩形组织空间对象。范围和近邻查询都需要根据空间边界剪枝,R-Tree 的区域重叠可能导致访问多条路径。
Z-order 将多维位置映射到一维顺序,但一个多维矩形可能转换成多个一维区间。高维搜索还包括 LSH、HNSW 等方法,通常需要权衡近似质量与检索成本。学习型索引预测键的位置,再通过局部搜索或校正得到正确结果,预测误差处理仍是索引协议的一部分。