课程视频
控制方向与数据粒度
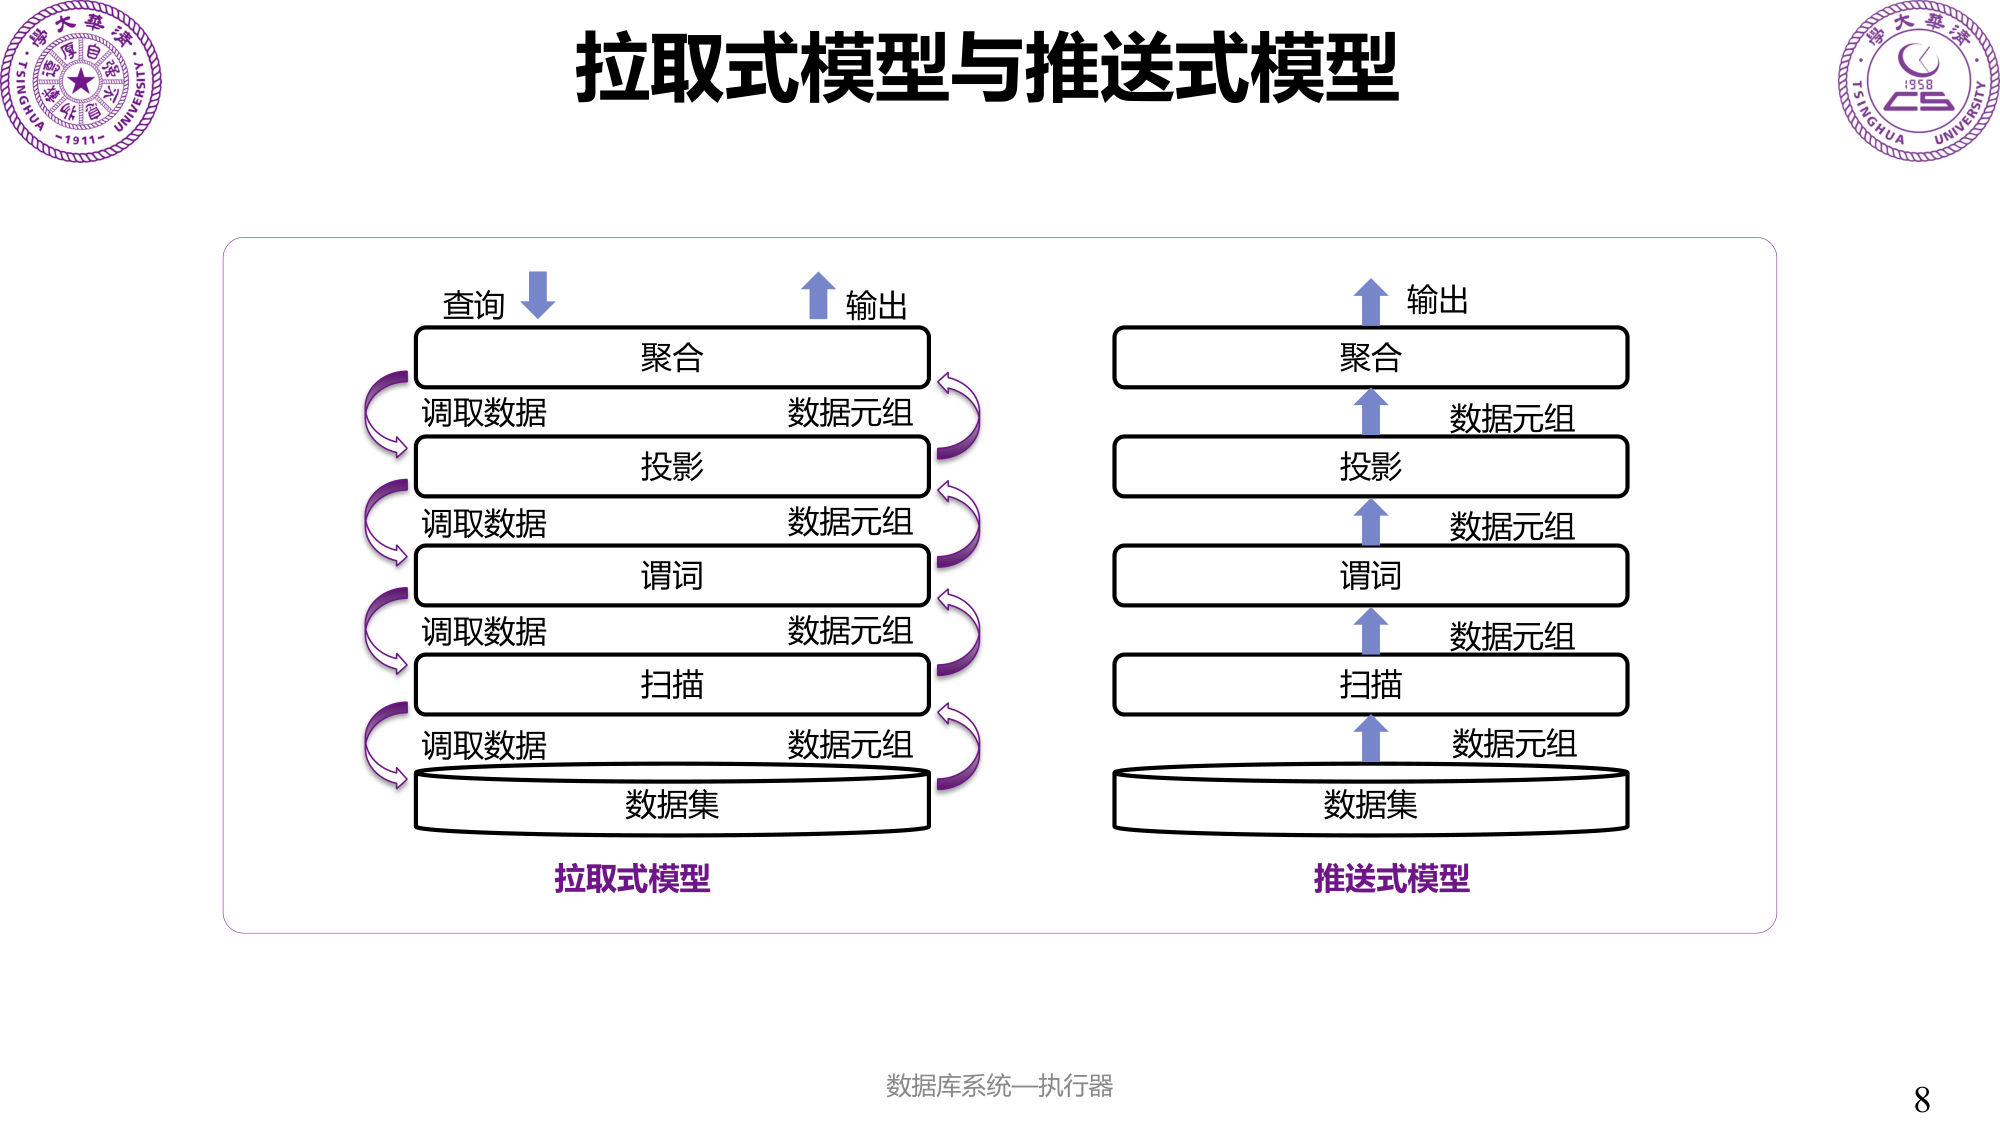
执行器既需要规定算子如何调用,也需要规定一次传递多少数据。Pull-Based 从根节点向下请求,结果向上返回;Push-Based 从扫描端产生数据,调用上层消费逻辑。数据流都是从输入走向结果,控制方向则不同。
火山模型提供 Open()、GetNext()、Close(),每次获取一条元组。接口易于组合,LIMIT 可以停止继续请求,但逐行虚函数调用、表达式解释和分支会产生开销。
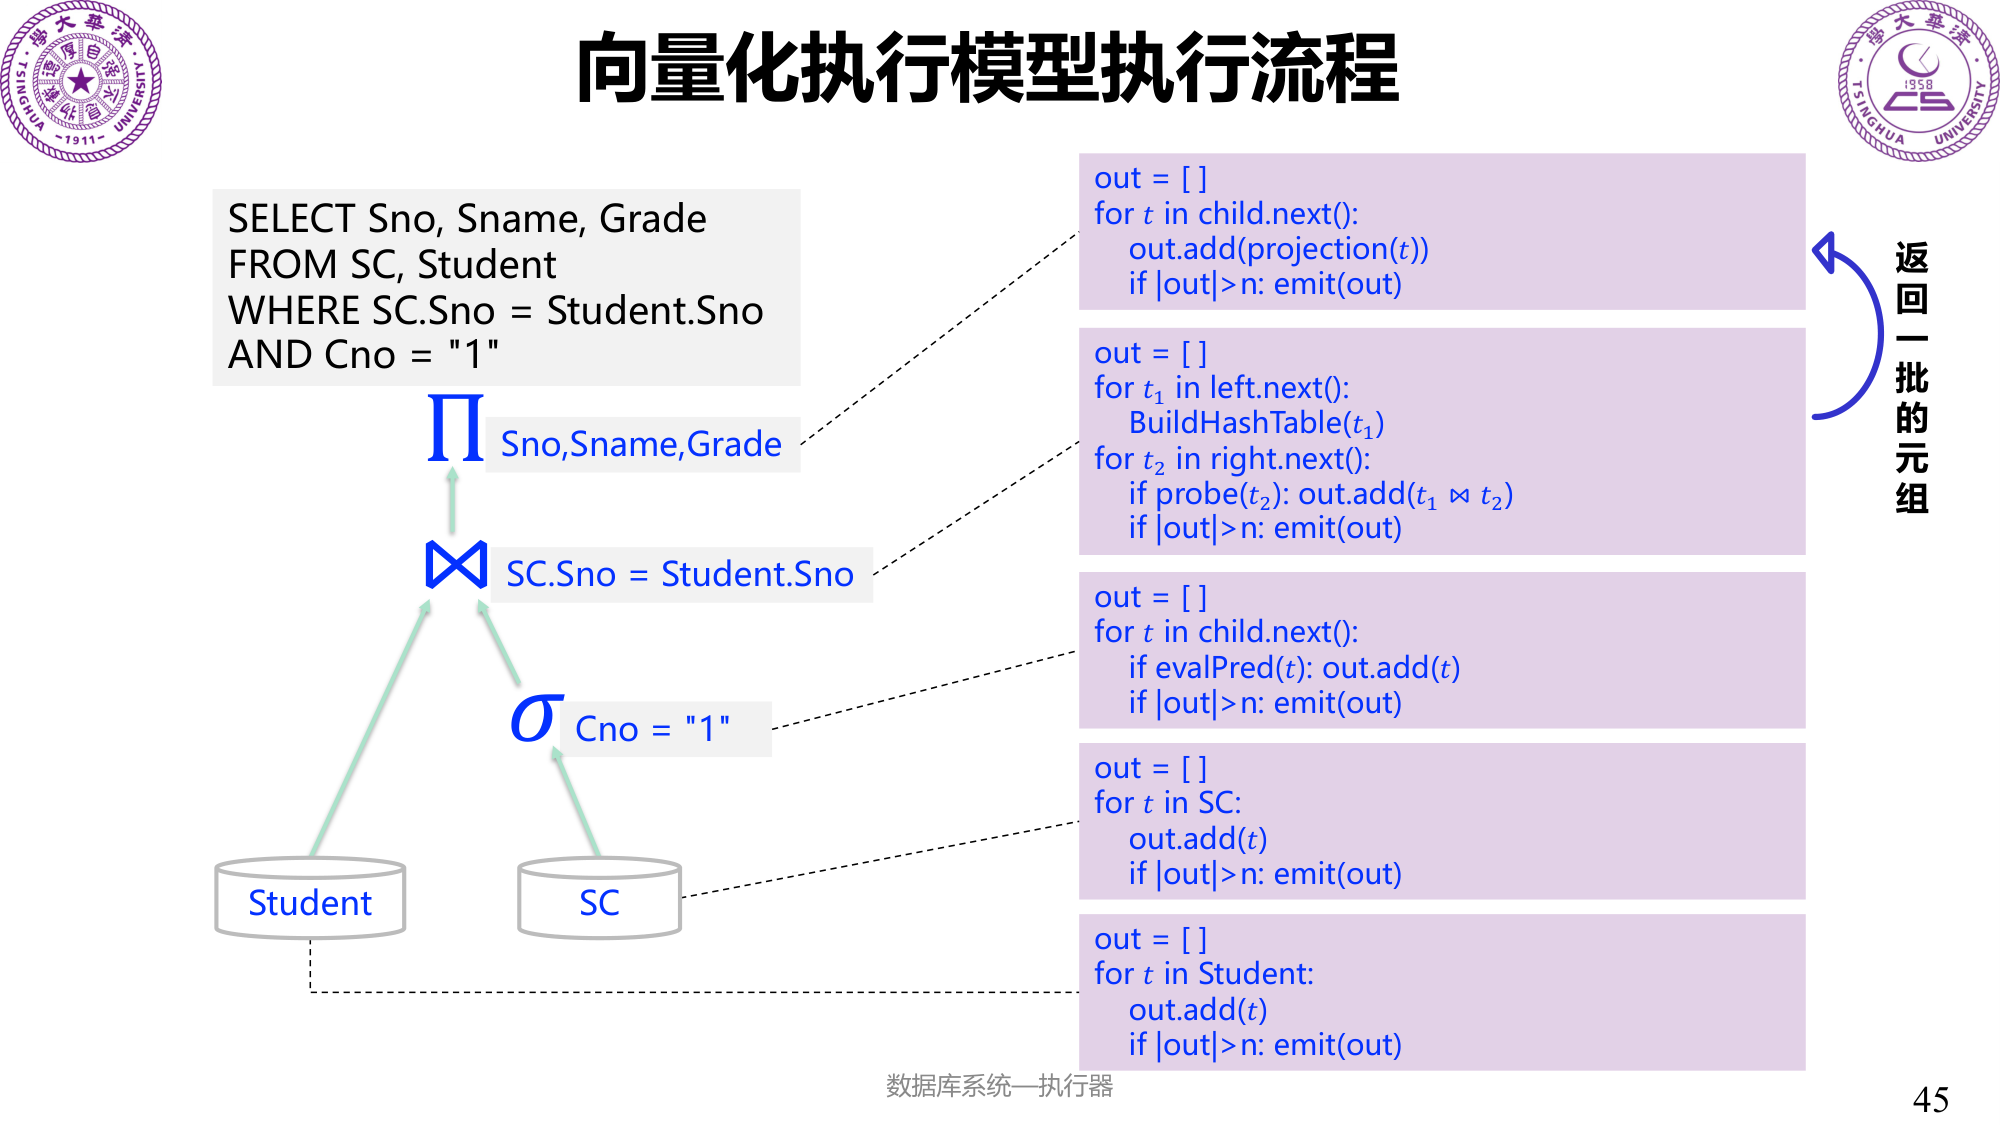
物化模型一次处理完整输入、返回完整结果,减少调用次数,却可能形成庞大中间结果。向量化模型一次返回一批数据,在调用成本、流水线与批量处理之间折中。课程通过同一个学生选课查询逐步对比了这三种执行过程。
Pipeline 与任务调度
推送式执行以数据为中心,使记录尽可能连续经过多个操作。遇到需要积累状态的 Sink 阶段时,划分 Pipeline 并建立依赖。例如哈希连接需要先完成 Build,才能让 Probe 使用已建立的表;不是所有 Join 的全部阶段都必须完全阻塞。
调度器把 Pipeline 拆为任务,维护任务队列和事件依赖。算子可以处于需要更多输入、还有更多输出、已经结束或暂时阻塞等状态。上游结束并不代表整条查询立刻结束,还要完成依赖它的后续任务和输出处理。
多层并行
MPP 使用多个节点,SMP 使用节点内多个线程,SIMD 则用一条指令处理多个数据元素。它们可以组合,也有不同瓶颈:MPP 受通信和分布影响,SMP 受共享结构及内存带宽影响,SIMD 则依赖布局、类型和操作是否适合批量执行。
向量化为紧凑数组循环创造条件,但不能据此断言每一段代码都能自动使用 SIMD。数据倾斜与 Pipeline 依赖也可能让部分资源空闲。
编译执行
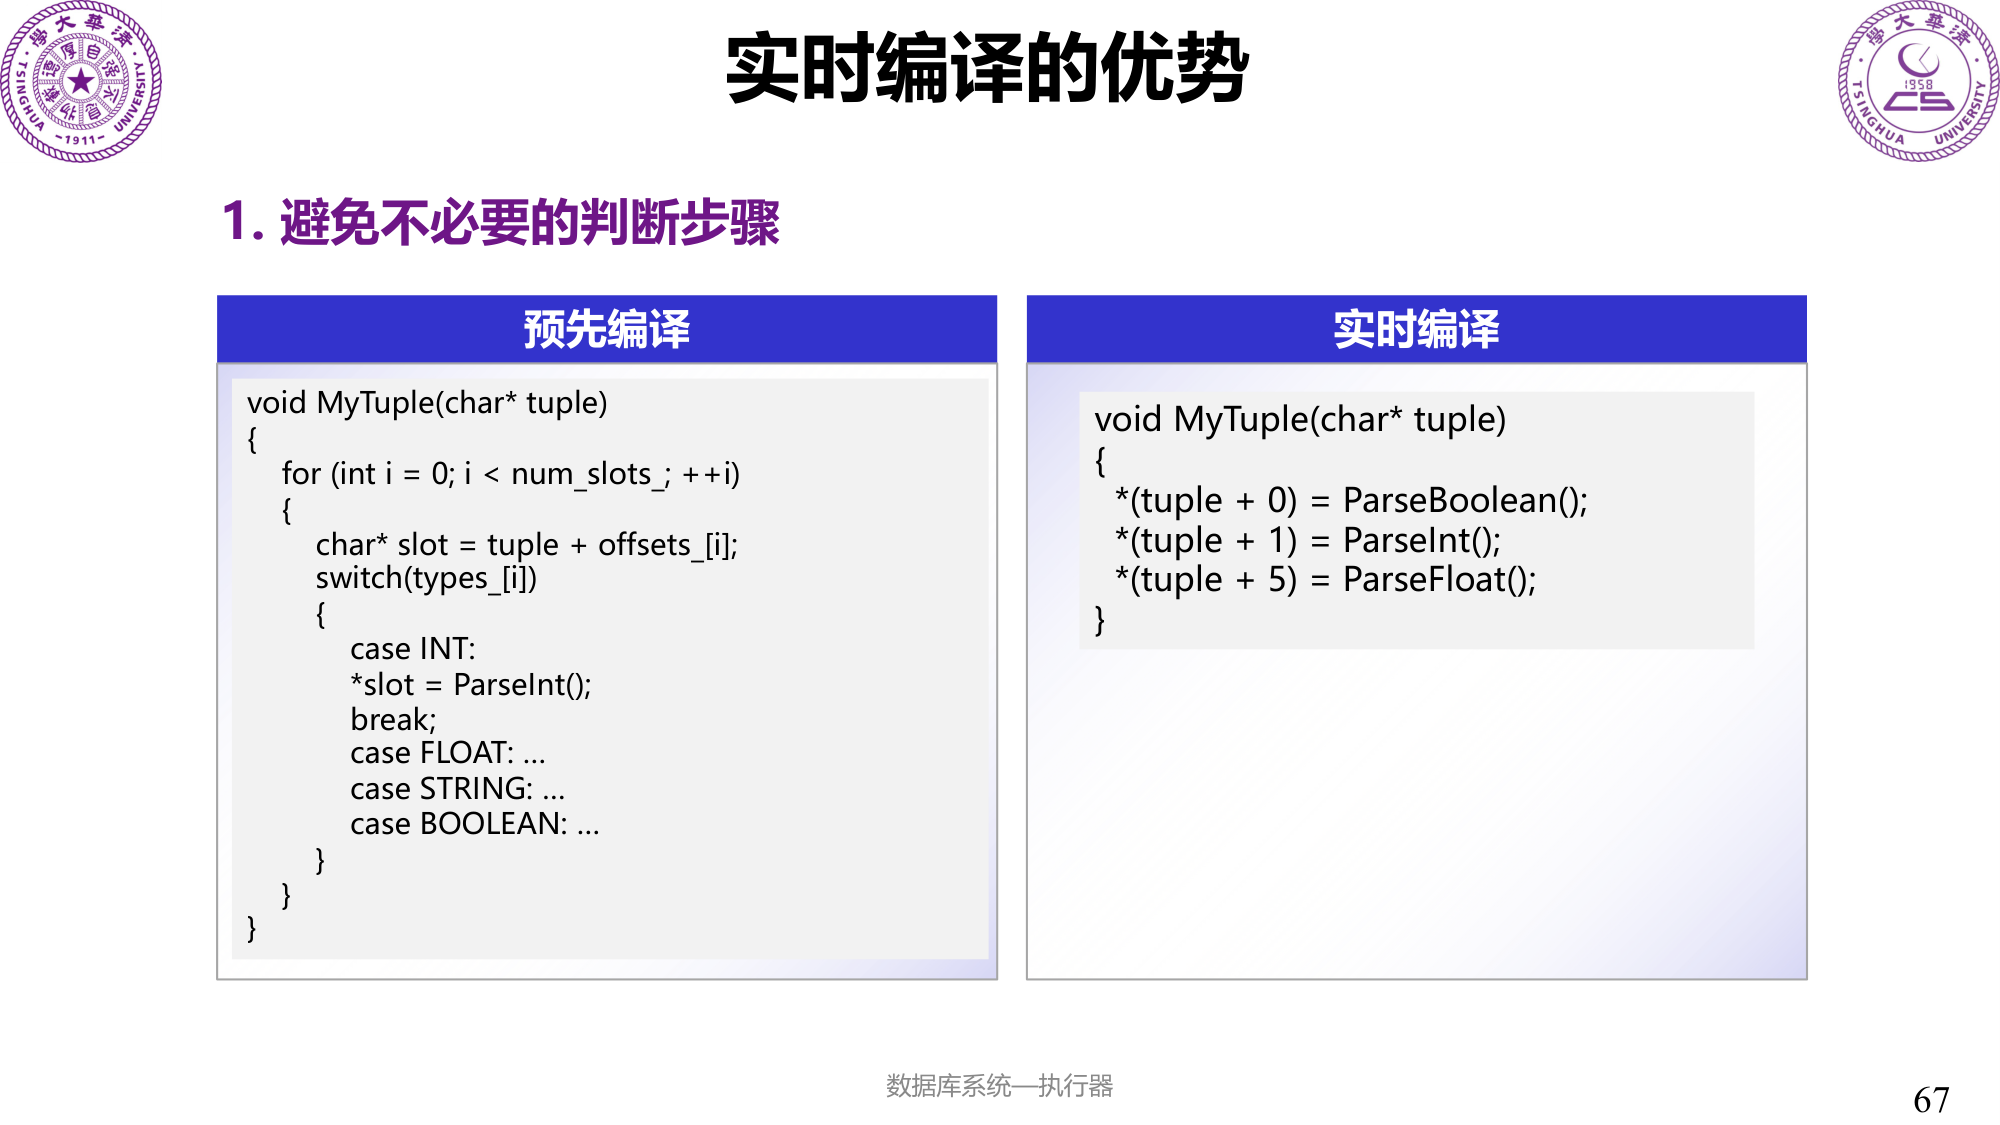
通用执行代码需要反复判断列类型、取值位置和表达式节点;查询编译可以将这些已知信息嵌入专门代码,减少解释与间接调用。
课件以解析元组为例:通用版本循环检查每个槽位的类型,专门化版本则直接按已知偏移读取布尔、整数和浮点值。LLVM 提供 IR、优化和不同架构的代码生成能力,但优化仍受规则和预算限制,并不保证找到绝对最优代码。
HIQUE 将计划转成 C/C++ 源码,再编译和加载;HyPer 采用面向数据的流水线代码生成,让部分中间值尽可能留在寄存器中。预编译原语减少运行时编译成本,JIT 则利用具体查询信息进一步专门化。
编译本身也有成本,短查询未必能收回准备开销。异步编译、编译服务和结果缓存可以降低影响,但需要处理首次执行、缓存失效以及运行时代码切换的状态。