课程视频
查询处理的整体流程
本讲先介绍查询解析、优化与执行,再分析各物理算子的实现。词法分析识别关键字、标识符和常量,语法分析构造语法树,语义分析检查表列是否存在、类型是否匹配以及引用是否明确。
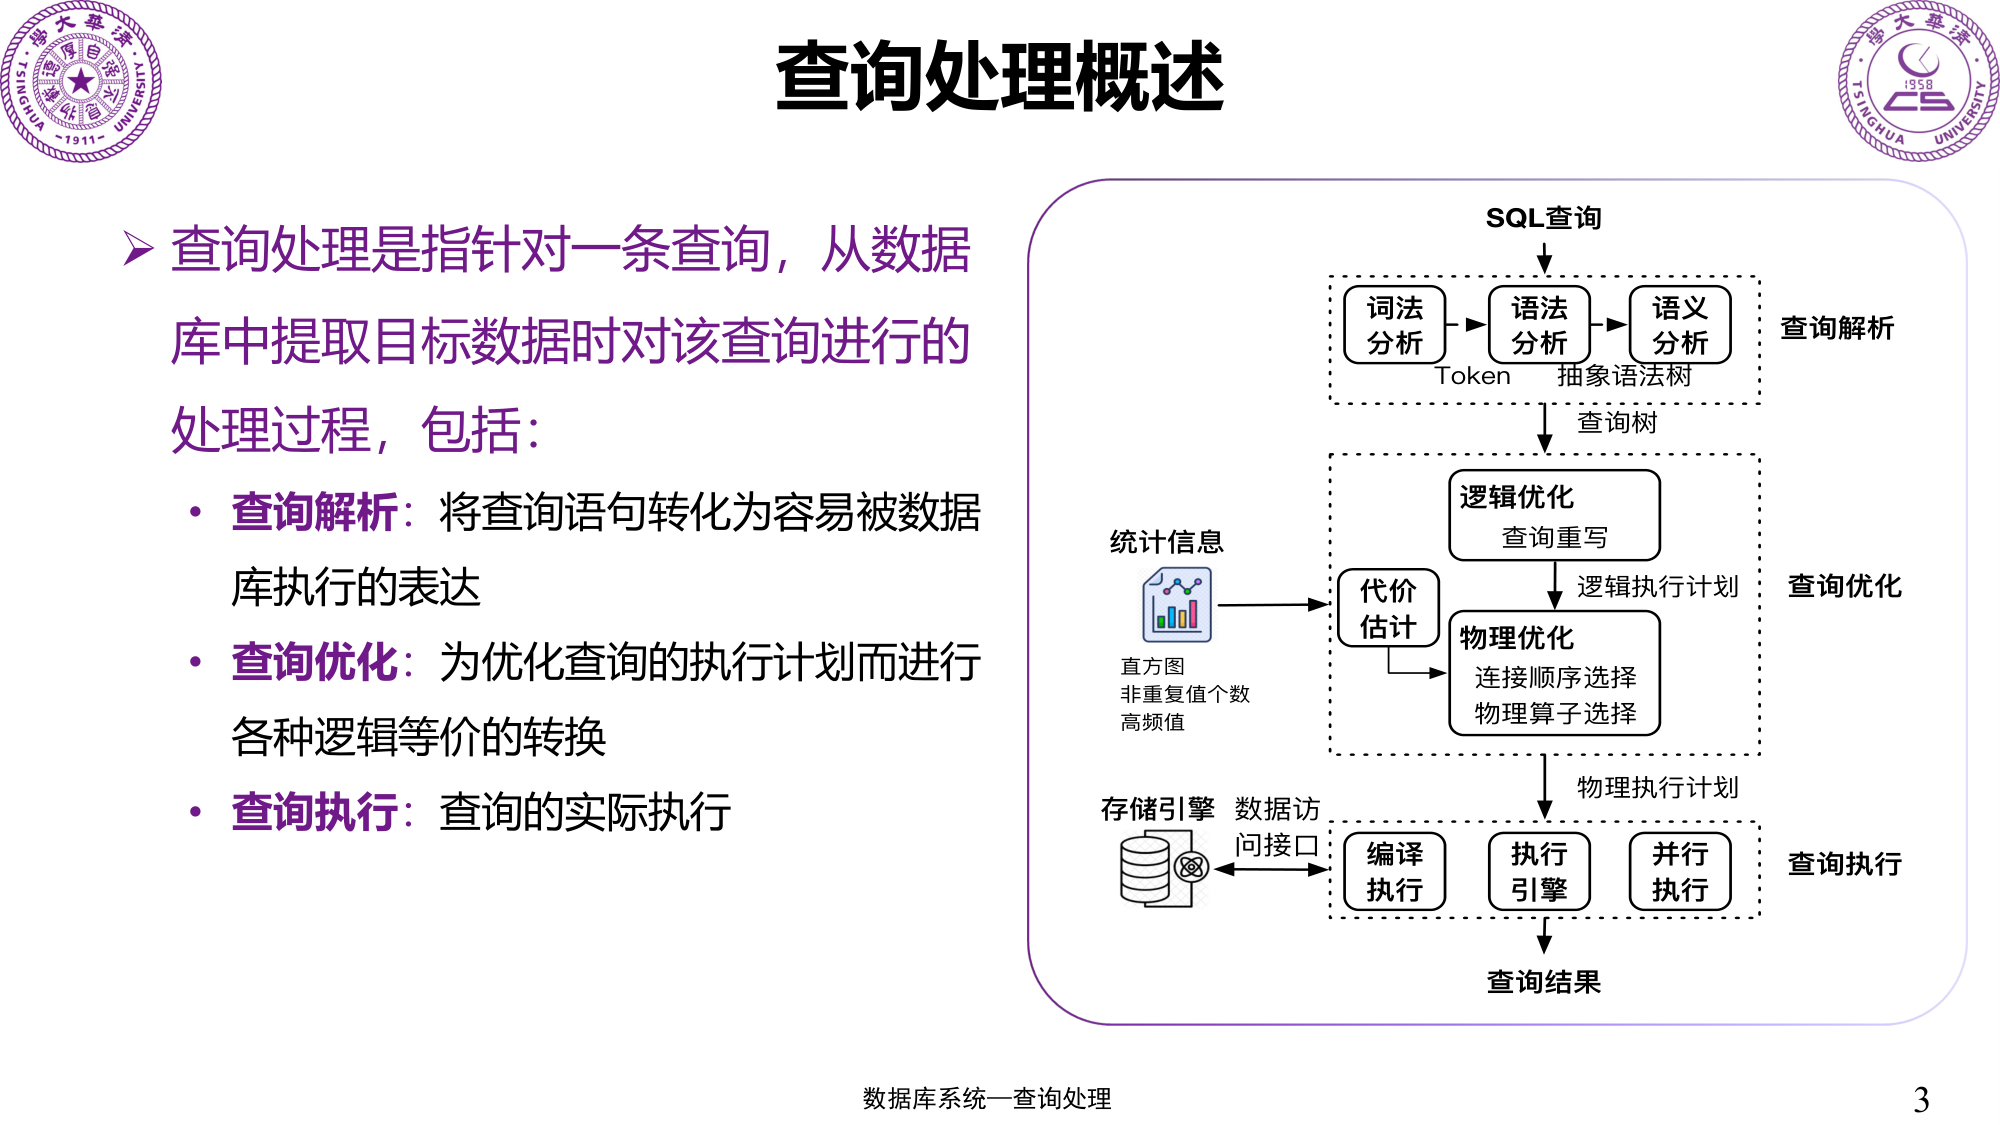
逻辑优化在保持语义的前提下重写关系表达式,物理优化选择访问方法与算法。最终计划中的扫描、排序、连接和聚集,才是执行器实际完成查询的步骤。
代价的单位
课程用 B® 表示关系 R 占用的磁盘块数,T® 表示元组数,M 表示可用缓冲块数,主要比较 I/O。CPU、网络与缓存命中仍影响真实耗时,教学模型的 I/O 次数不能直接等同于某产品执行时间。
外部归并排序
先将每批可放入内存的数据排序,写为有序段,再使用多路归并合并这些段。若为输出保留一个缓冲块,每轮最多使用其余 M−1 个缓冲块读取不同输入段。
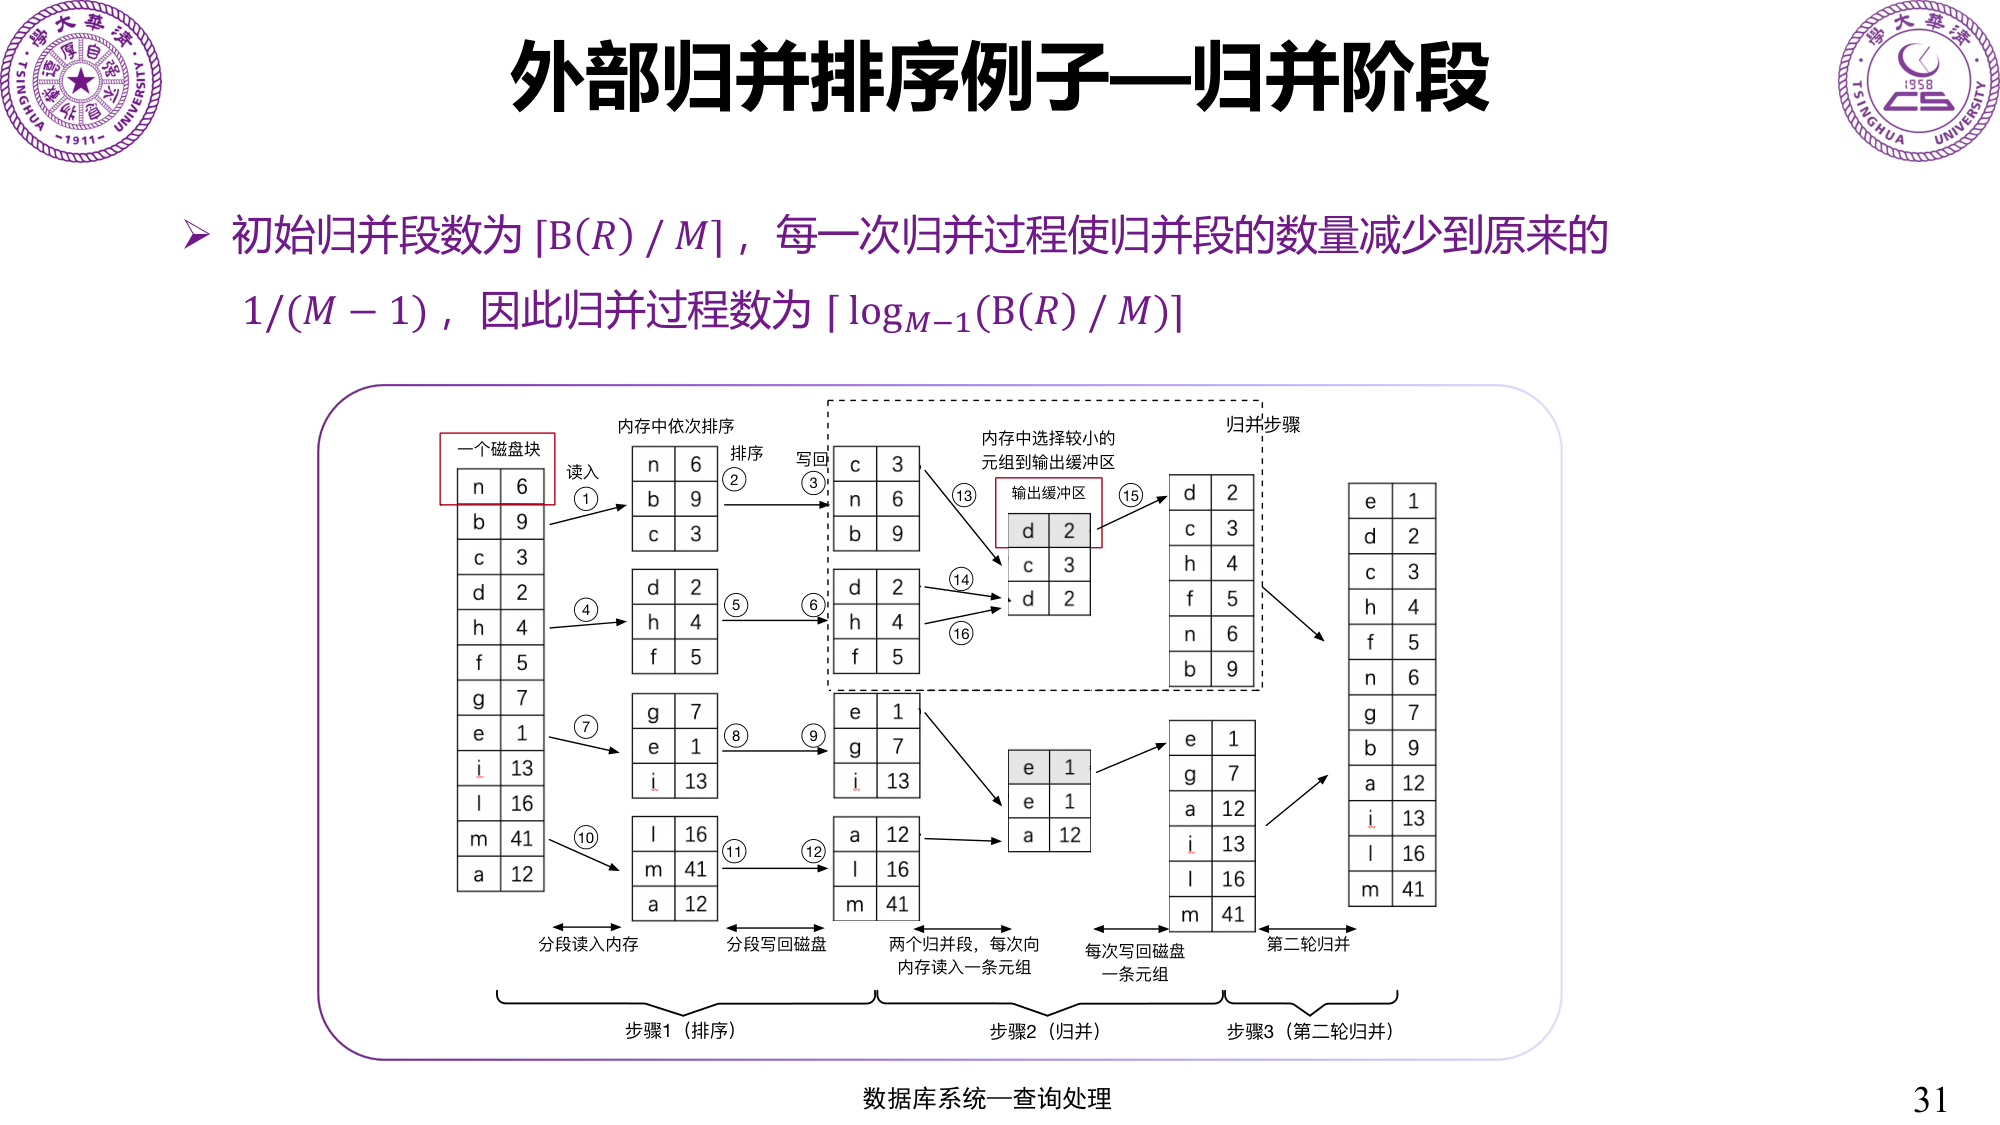
每次完整读取并写回数据约为 2B® 次 I/O,增加内存可能通过减少归并轮数显著降低成本。最终结果如果可以直接流水化交给上层,或者输入已有合适顺序,还可以避免部分写回或排序。
选择算子
线性扫描检查全部数据块,索引扫描先定位键,再读取匹配记录。聚簇索引的范围结果通常集中在较少连续页面中;非聚簇索引即使返回相同行数,也可能访问更多分散页面。
等值唯一查找、非唯一查找和范围查询的匹配规模不同。多个 AND 条件可以选择最有利的访问路径后计算剩余条件,也可以组合多个索引的候选集合;OR 条件则必须保证每个分支的匹配记录都能被覆盖,不能只取其中一个分支的索引结果。
嵌套循环连接
简单 Nested Loop Join 对 R 中每条记录扫描 S,输入 I/O 模型为 。块嵌套循环一次保留一批 R 的页面,减少重复扫描 S 的次数。
本讲的简化模型将 M−1 页用于外表,一页用于内表;若还为输出另留一页,外表容量相应为 M−2。比较不同课程公式时,需要先看缓冲预算,而不是只比较分母。
Index Nested Loop Join 利用 S 的连接键索引探测候选,适合外表较小、内表访问具有较高选择性的情况,一次探测成本还包含匹配记录回表。
排序归并与哈希连接
Sort-Merge Join 先得到两侧的连接键顺序,再用游标同步推进。重复键必须输出两组之间全部匹配组合,不能只匹配一条就跳过。总成本包含前置排序,输入已排序或上层需要顺序时更有吸引力。
Hash Join 对两侧使用相同分区函数,使可能匹配的记录进入对应桶,再逐桶连接。一次分区足以使 Build 分区装入内存时,分区读写加后续读取约为 ,暂不计结果输出。
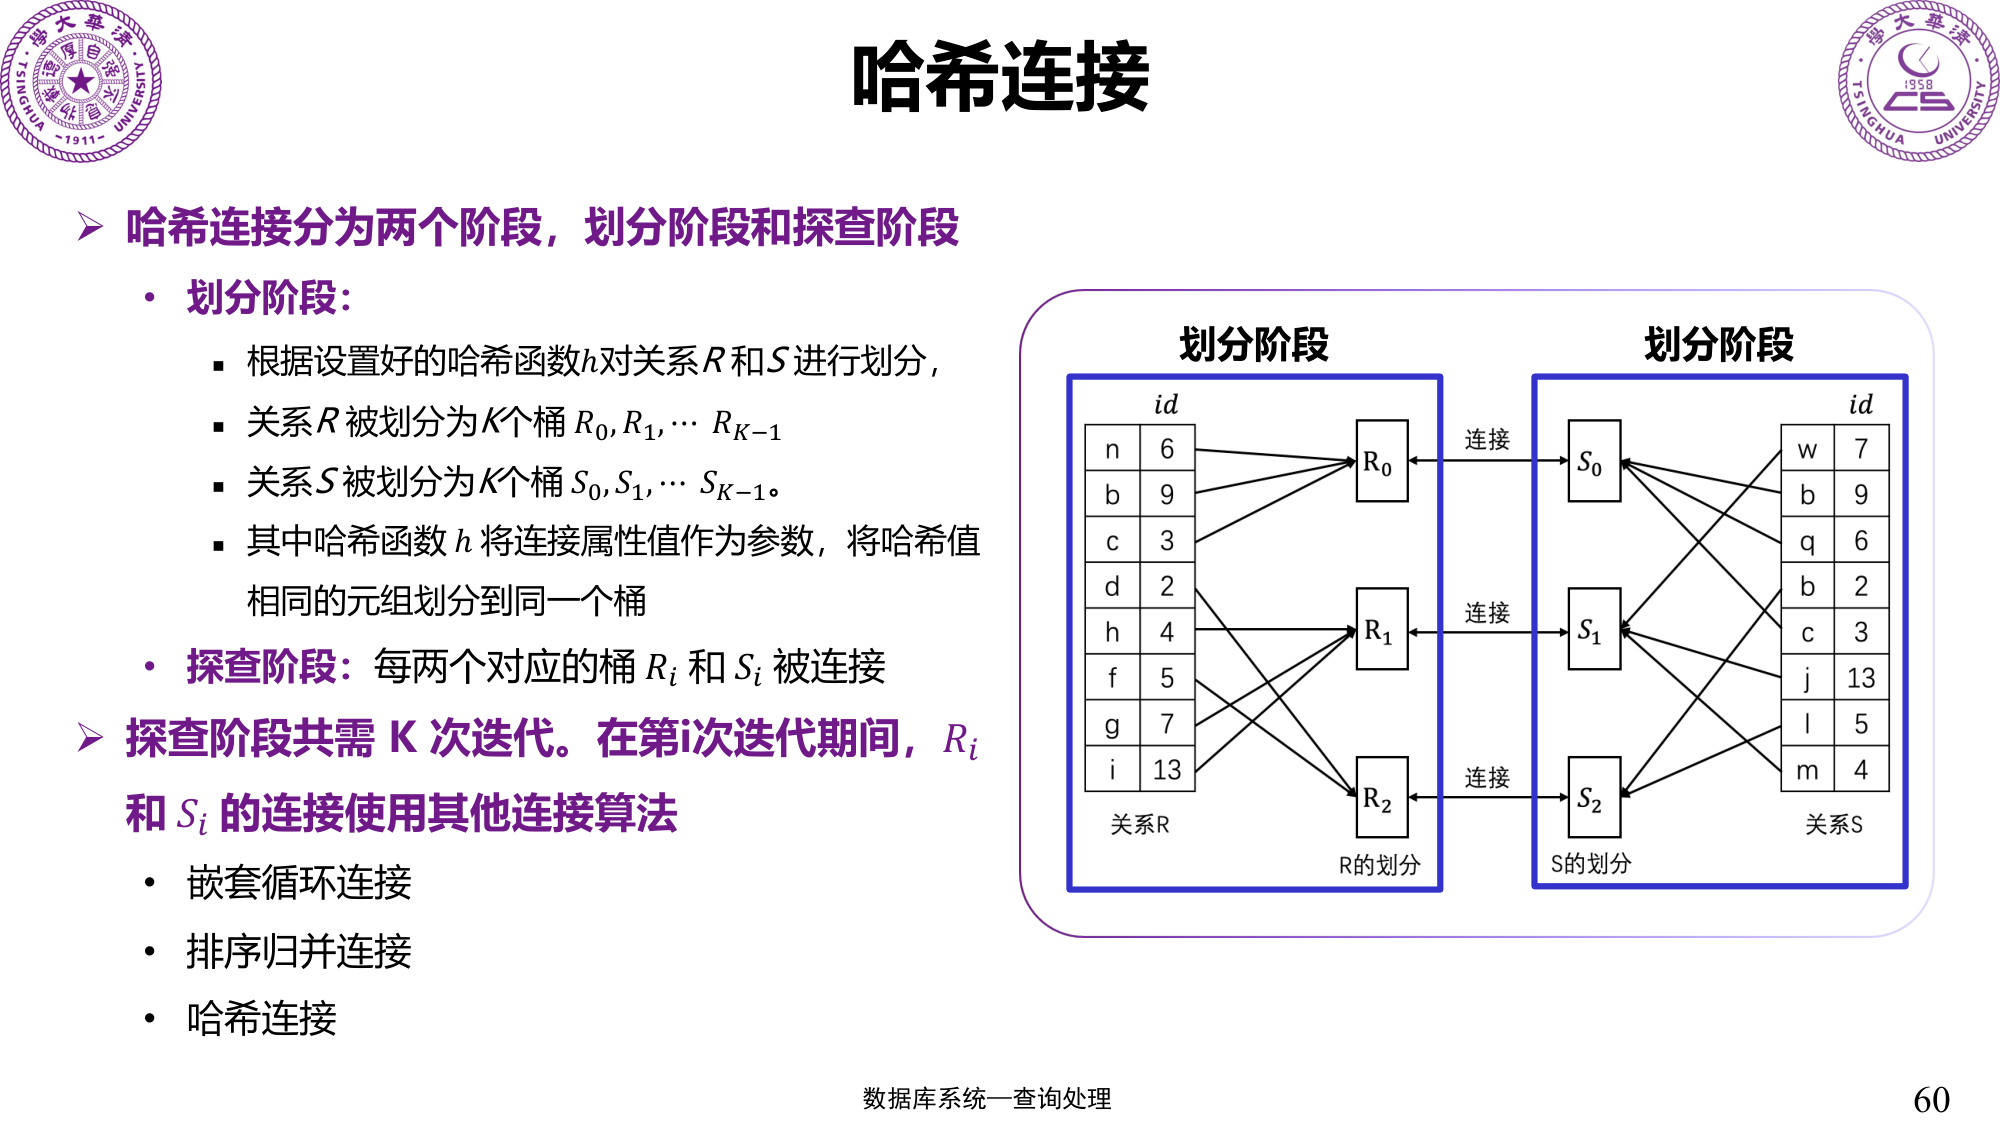
单个分区仍过大时要继续处理,热点键也可能让分区严重倾斜。哈希值相同不能证明键相等,最终仍需比较真实连接条件。
去重、集合与聚集
排序使相同键相邻,可以顺序去重、合并集合或累计组状态;哈希则把相同键送到同一桶或状态表。AVG 需要保存总和与数量,后续合并状态时不能直接对局部平均值做不加权平均。
算法选择应利用已有顺序、预估组数和内存容量。当前算子最便宜的方式,也可能失去上层能够复用的顺序属性,下一讲会把这些局部选择放回整个计划中考虑。