课程视频
B 站中英文字幕 · Stanford 官方录像 Part 8 · 课程目录
对应官方 2025 年秋季课表第 17 次课(2025-11-17):Agentic Evaluations & Long-Horizon Tasks。
能运行很久,是否就能做好工作
本节对应公开视频 Part 8、官方课表第 17 次课。课程按 METR 长任务评测、GDPval 真实工作评价和 DeepScholar-Bench 研究综合的顺序展开。三组材料分别回答任务跨度、产出价值和证据质量的问题。
课堂开场先请同学提出希望智能体完成的任务,例如整理参考文献、辅助文献综述和重构代码。评价这类系统时,单次回答基准的正确率不够,还要考虑系统怎样持续工作、在哪里失败,以及产出是否真正可用。
METR:用人类完成时长标定任务
时间跨度测量的是什么
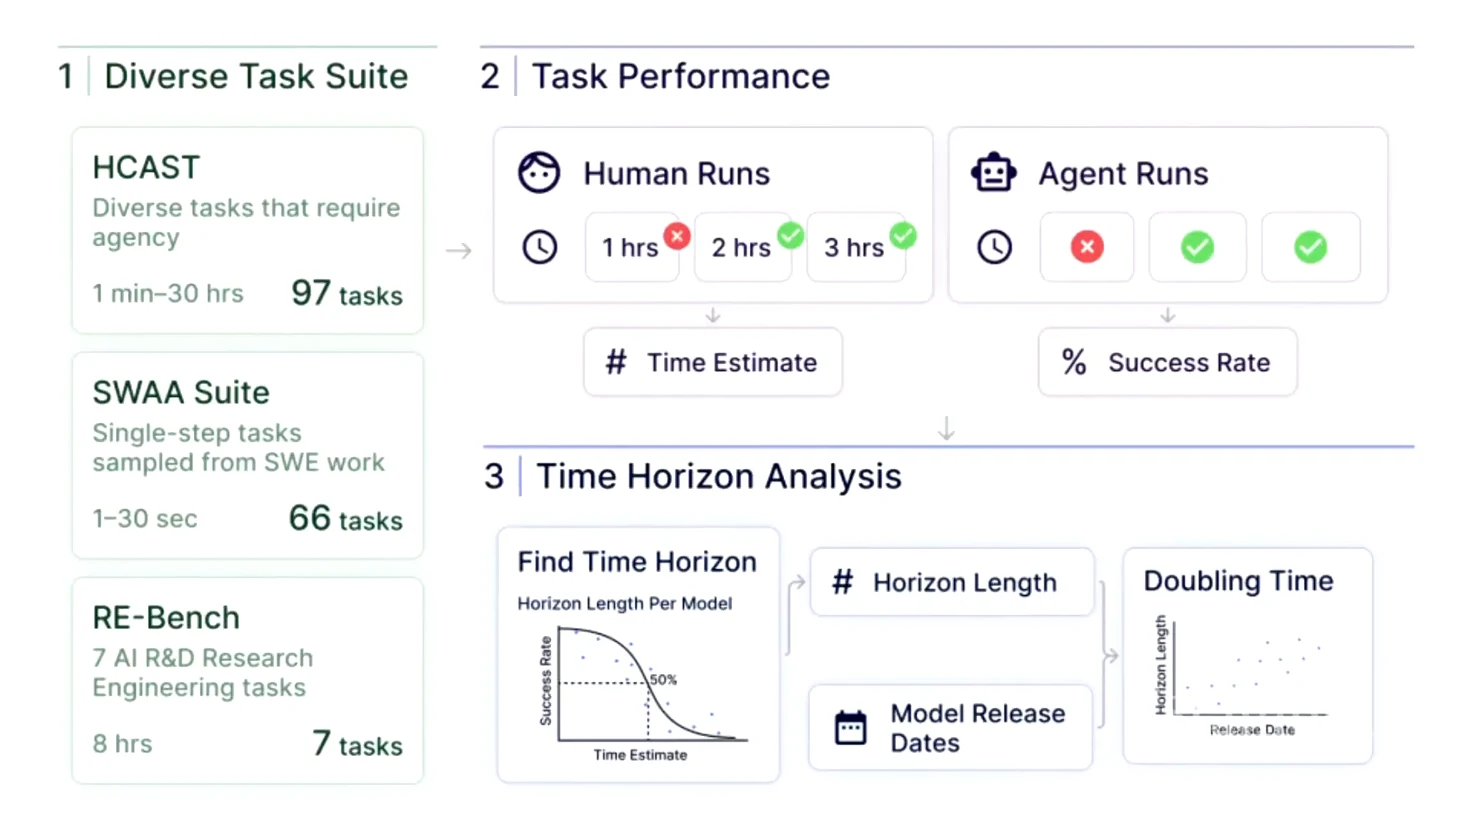
METR 收集软件工程、网络安全、推理和机器学习任务,请具备相关经验的人完成,并记录成功尝试所需时间,再测量 AI 在这些任务上的成功概率。
来源:Stanford 官方课程录像 Part 8,06:30;B 站对应位置。
这里的 time horizon 是AI 能以给定成功概率完成、且人类通常需要多长时间的任务。它不是智能体持续运行的墙钟时间,也不是上下文窗口能保存多少 token。
课件区分了较短的单步任务、分钟到小时级的 HCAST 任务,以及更长的 RE-Bench 研究工程任务。寻找脚本可能只有几秒,修复模拟输入文件中的错误需要更久,开发并优化 CUDA 工具可能需要数小时。用同一个数字概括这些任务,首先要有明确的任务采样范围。
人类基线也有测量误差
课程介绍使用经验较丰富的专业人员,依据成功完成的记录计算几何平均时长。只观察成功尝试可能低估困难任务的实际投入;专业人士与模型对同一任务的难度感受也不一定一致。
因此,这个指标提供一种跨任务比较的尺度,不能理解为“模型已经相当于做同样时长工作的人”。任务类型、反馈可用性、工具配置和评分条件改变时,时间跨度也会变化。
50% 与 80% 成功率的差距
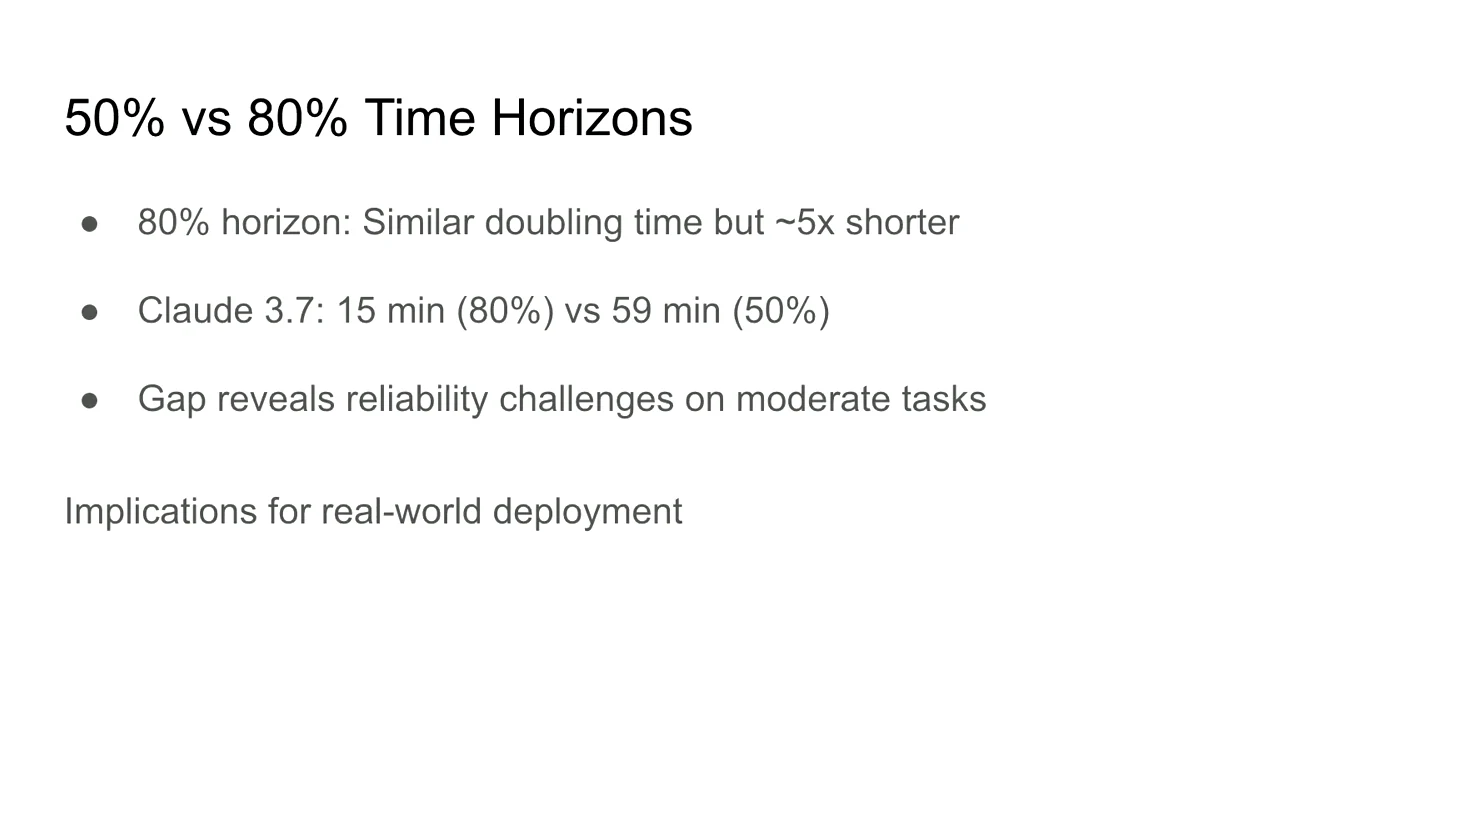
以较低成功率作为阈值,可以得到更长的时间跨度;要求稳定完成时,跨度会明显缩短。
来源:Stanford 官方课程录像 Part 8,22:10;B 站对应位置。
课件以 Claude 3.7 的一组历史结果举例:50% 条件约为 59 分钟,80% 条件约为 15 分钟。这是所研究任务集中的估计,并不表示模型每运行 59 分钟就会失败,也不是当前所有智能体的统一能力上限。
半数成功也意味着仍有大量任务失败。对真实部署而言,故障恢复、成本上限和人工接管方式,往往比展示一次最长成功轨迹更重要。
失败具体发生在哪里
课程比较的失败类型包括规划或工具选择错误、推理与算术错误、过早放弃任务,以及反复执行已经失败的动作。重复循环尤其说明,持续行动不等于取得进展。
研究还用任务的“混乱程度”、SWE-bench 复现实验等检查结论稳健性。课件提出的增长趋势与预测来自当时样本和拟合假设,不能直接变成模型何时完成任意长期工作的承诺。
GDPval:产出能否与专业工作比较
长时程指标关注能完成多难的任务,GDPval 更直接观察结果:面对真实职业中的数字工作,模型交付的文档、表格、演示或其他产出,专家认为质量如何。
来源:Stanford 官方课程录像 Part 8,34:30;B 站对应位置。
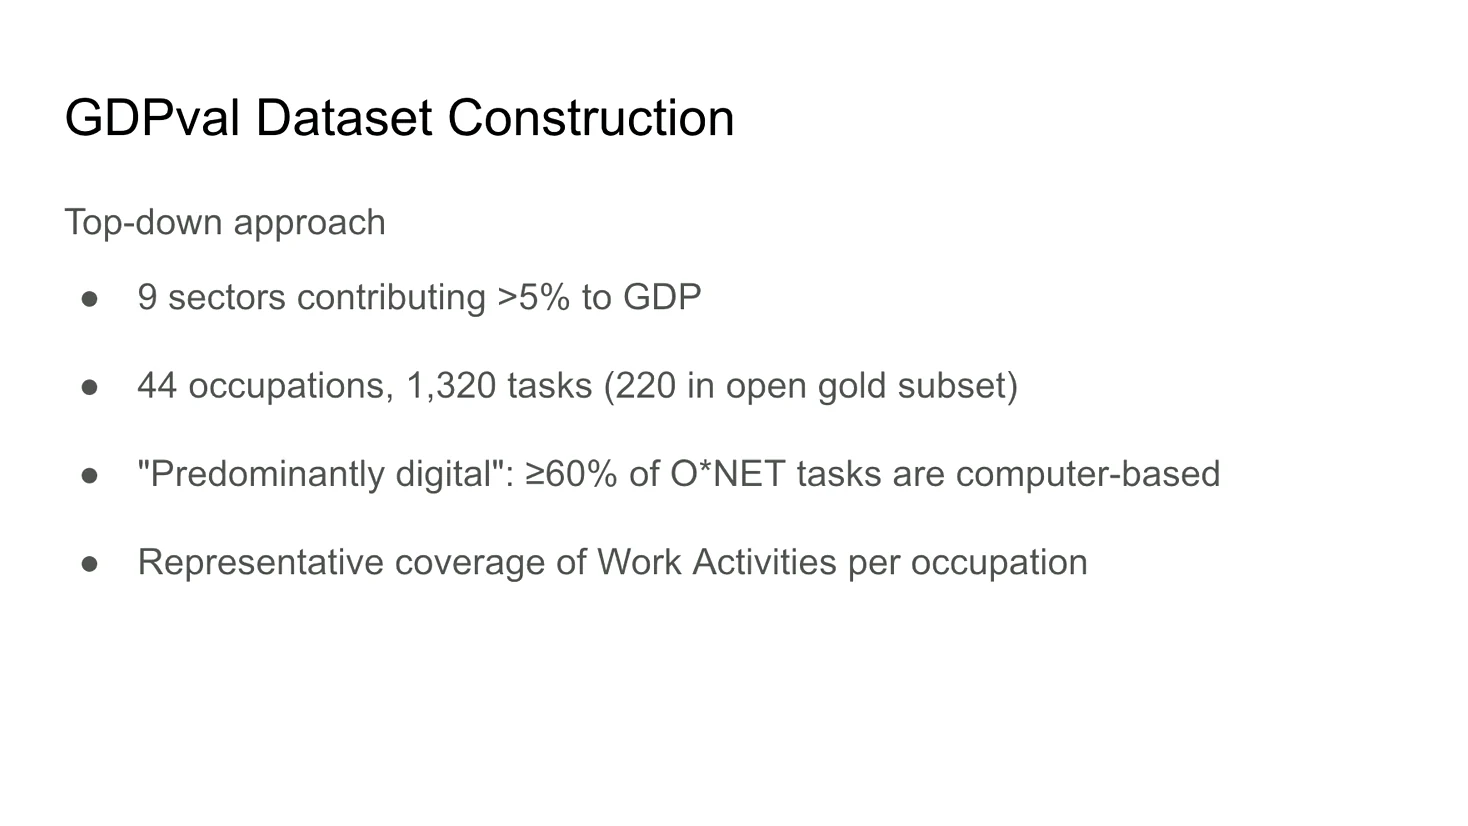
课件介绍 9 个经济部门、44 个职业与 1,320 个任务,公开 gold 子集包含 220 个任务。任务来自需要专业背景的工作场景,并提供说明和必要文件。专业人士的产出用于比较,评审再判断模型结果与人类结果谁更好。
这样的胜率不是“已经自动化了多少比例的岗位”。一个职业由很多相互依赖的任务、协作和责任构成,而基准主要观察给定说明后的一次产出。
正确性、格式与使用方式都影响评价
课堂展示不同模型在排版、美观、精确遵循要求等方面的差异。表格或幻灯片不仅要内容大致相关,还要能打开、信息准确、版式可读,适合实际使用。
失败分析把可接受但不够好的结果,与严重甚至灾难性错误分开。有些分歧还来自评审本身,所以需要查看评价标准、样本和不一致情况,不能只凭总胜率判断系统已经可靠。
删除上下文会怎样
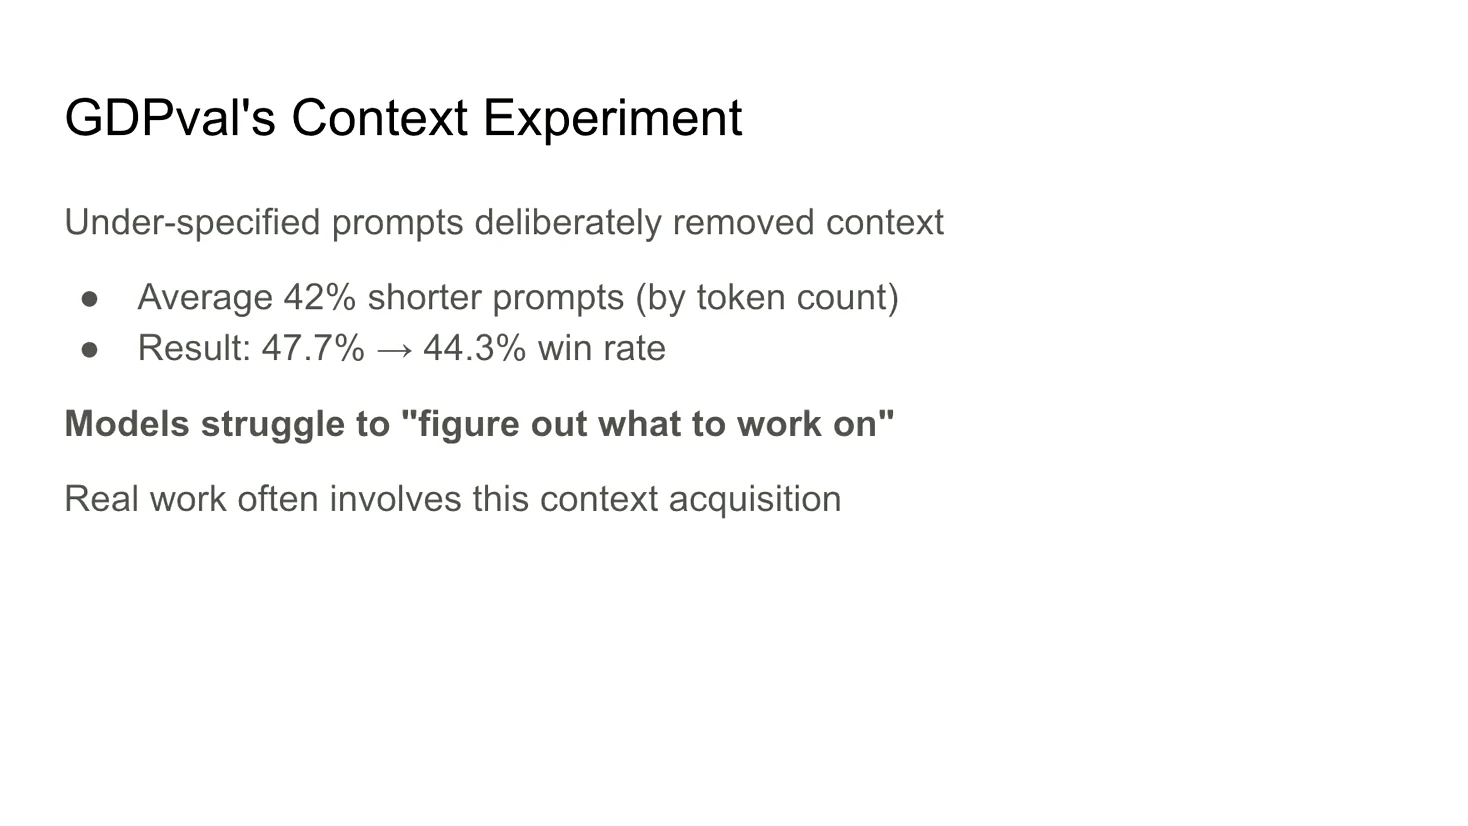
来源:Stanford 官方课程录像 Part 8,45:50;B 站对应位置。
课件中的实验有意删除部分上下文,提示 token 平均减少约 42%,对应胜率从 47.7% 降到 44.3%。这个实验说明,较完整的任务说明有帮助,但不能把变化推广为任意提示“少写 42% 就固定下降多少”。
真实工作里,人们还需要发现该做什么、理解隐含背景、向相关人员确认要求。基准中写得很明确的一次任务,不包含所有这些过程。
DeepScholar-Bench:研究报告的证据是否充分
课程最后讨论生成论文 related work 一类任务。系统需要寻找文献、理解内容,再组织有依据的综合分析。写得连贯只是其中一个维度。
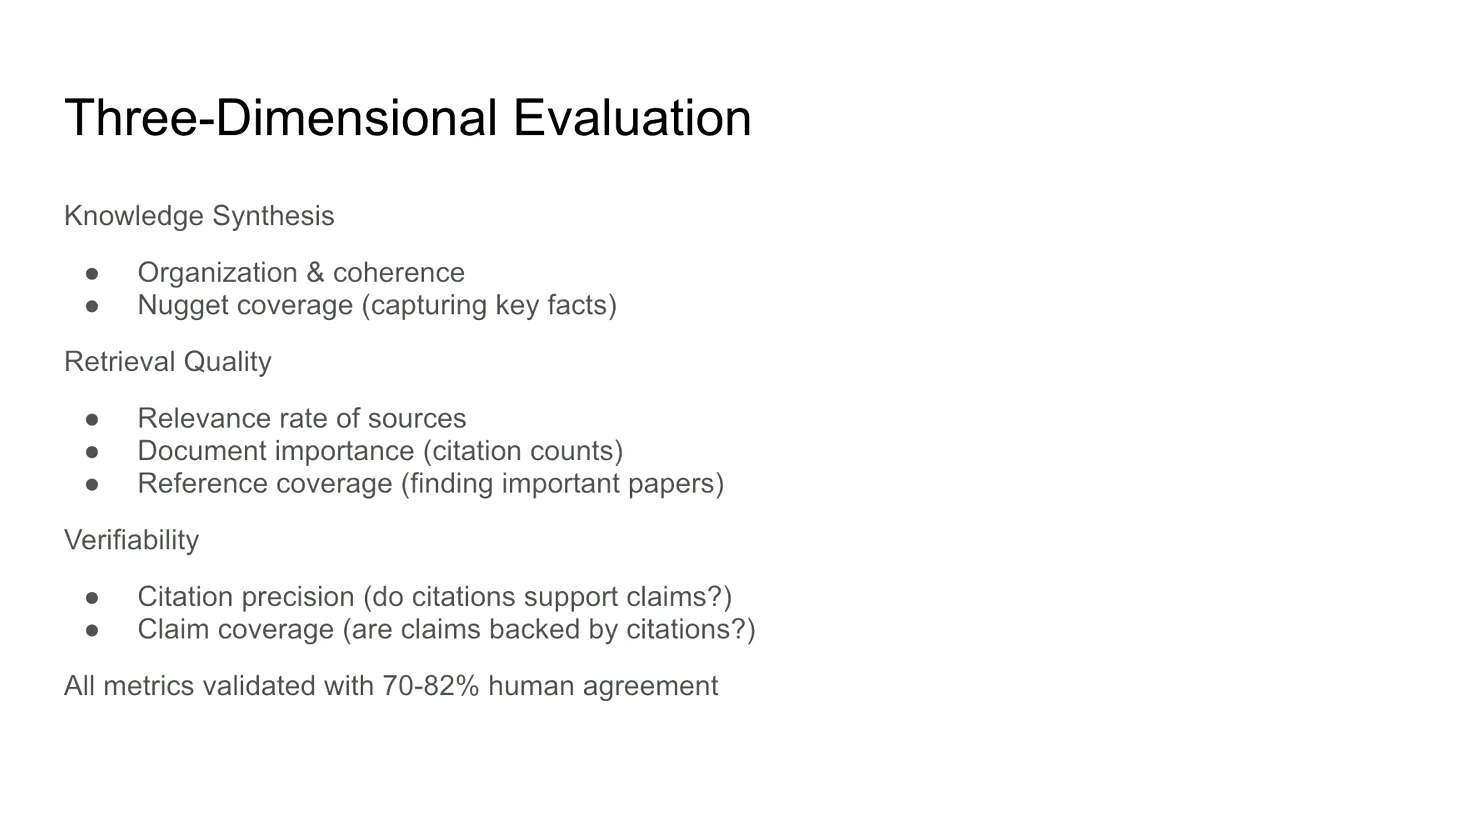
来源:Stanford 官方课程录像 Part 8,54:30;B 站对应位置。
| 维度 | 需要检查的问题 |
|---|---|
| 知识综合 | 组织是否清晰,是否覆盖关键事实或知识点(nuggets) |
| 检索质量 | 来源是否相关,是否包含重要文献,参考文献覆盖是否充分 |
| 可验证性 | 引文是否支持对应论断,重要论断是否有来源支撑 |
课程介绍使用较新论文持续更新任务的方式,减少固定基准随时间陈旧的问题。新的任务可以降低某些训练污染风险,但不能仅凭更新时间就证明完全不存在污染。
来源相关,不代表综述完整
一个系统可能找到了几篇与关键词相关的论文,却漏掉奠基性工作;也可能列出正确文献,却没有从文献中提炼出重要事实。文献的重要性、对问题的相关性和最后报告的覆盖率应分别检查。
引文精确率与论断覆盖率也不能相互替代。少写、少引用可能让已写出的引文很准确,却遗漏很多必要内容;反过来,大量引用也不保证每一个论断都有支持。
课堂的 oracle 来源实验显示,即使提供更理想的参考资料,模型仍可能漏掉重要知识点。这意味着检索与综合都是瓶颈,不能只改搜索接口就认为研究质量已经解决。
把三种评测放回真实工作
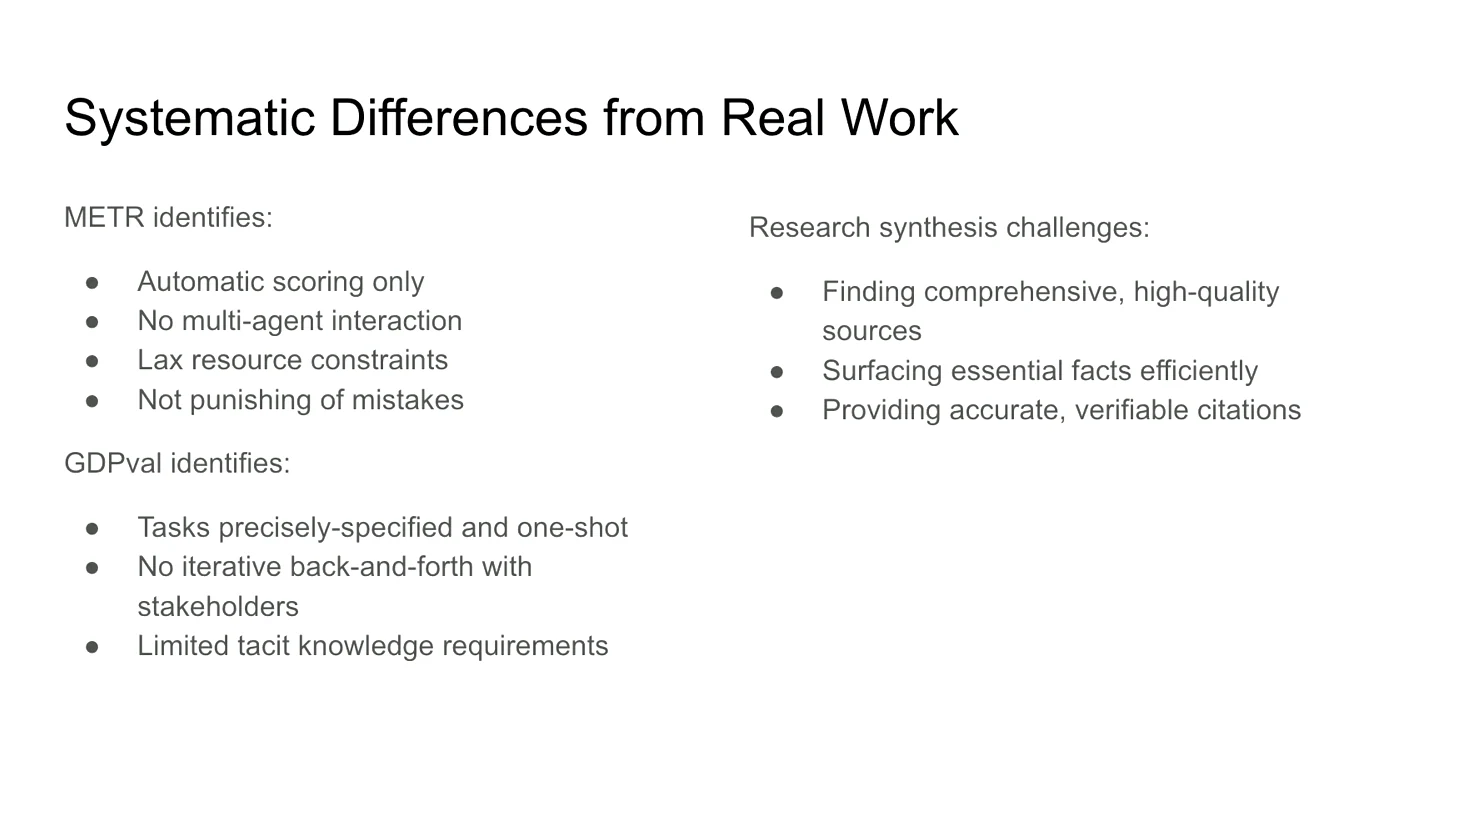
来源:Stanford 官方课程录像 Part 8,64:30;B 站对应位置。
METR 的任务评分、资源约束和交互方式,GDPval 的明确说明与一次性交付,以及研究综合中的来源范围,都与真实工作有差别。实际系统可能面对任务要求变化、多个协作者、隐性知识和不能轻易重试的错误。
从本节可以整理出三个互补问题:
- 能完成多长跨度的任务:用什么人类时间标尺、什么成功率阈值?
- 完成后的产出是否有用:与专业人士比较,错误严重程度怎样?
- 结论是否有充分证据:关键事实、来源覆盖和引用支持分别如何?
这些问题应该一起进入智能体的验收。某一次长时间运行成功,不能替代稳定性、质量和证据检查;下一节的未来研究方向会继续讨论怎样让改进循环本身更可靠、更高效。