课程视频
B 站中英文字幕 · Stanford 官方录像 Part 3 · 课程目录
对应官方 2025 年秋季课表第 3 次课(2025-09-29):Robust Verification。
正确答案已经生成,为什么还是选不出来
本节沿四组工作展开:GSM8K 验证器、过程监督、Math-Shepherd 自动标注,以及弱验证器集成 Weaver。它们共同处理上一节留下的问题:候选集合中存在正确解,系统是否能够可靠地识别它。
验证器可以作为推理阶段的选择器,也可以提供训练奖励。这两个用途都依赖验证质量,但优化的对象不同:前者改变本次任务交付哪个答案,后者还会改变模型之后生成答案的分布。
从 GSM8K 训练一个验证器
《Training Verifiers to Solve Math Word Problems》使用多步小学数学题研究生成与验证。GSM8K 约包含 8,500 道题,保留自然语言解题过程,适合检查模型怎样从题意走向答案。
生成、标注与训练
课堂先介绍生成器,再让它为训练问题生成大量候选。通过最后答案与标准答案的比较,候选可以得到正确或错误的标签,验证器据此学习判断完整解答。
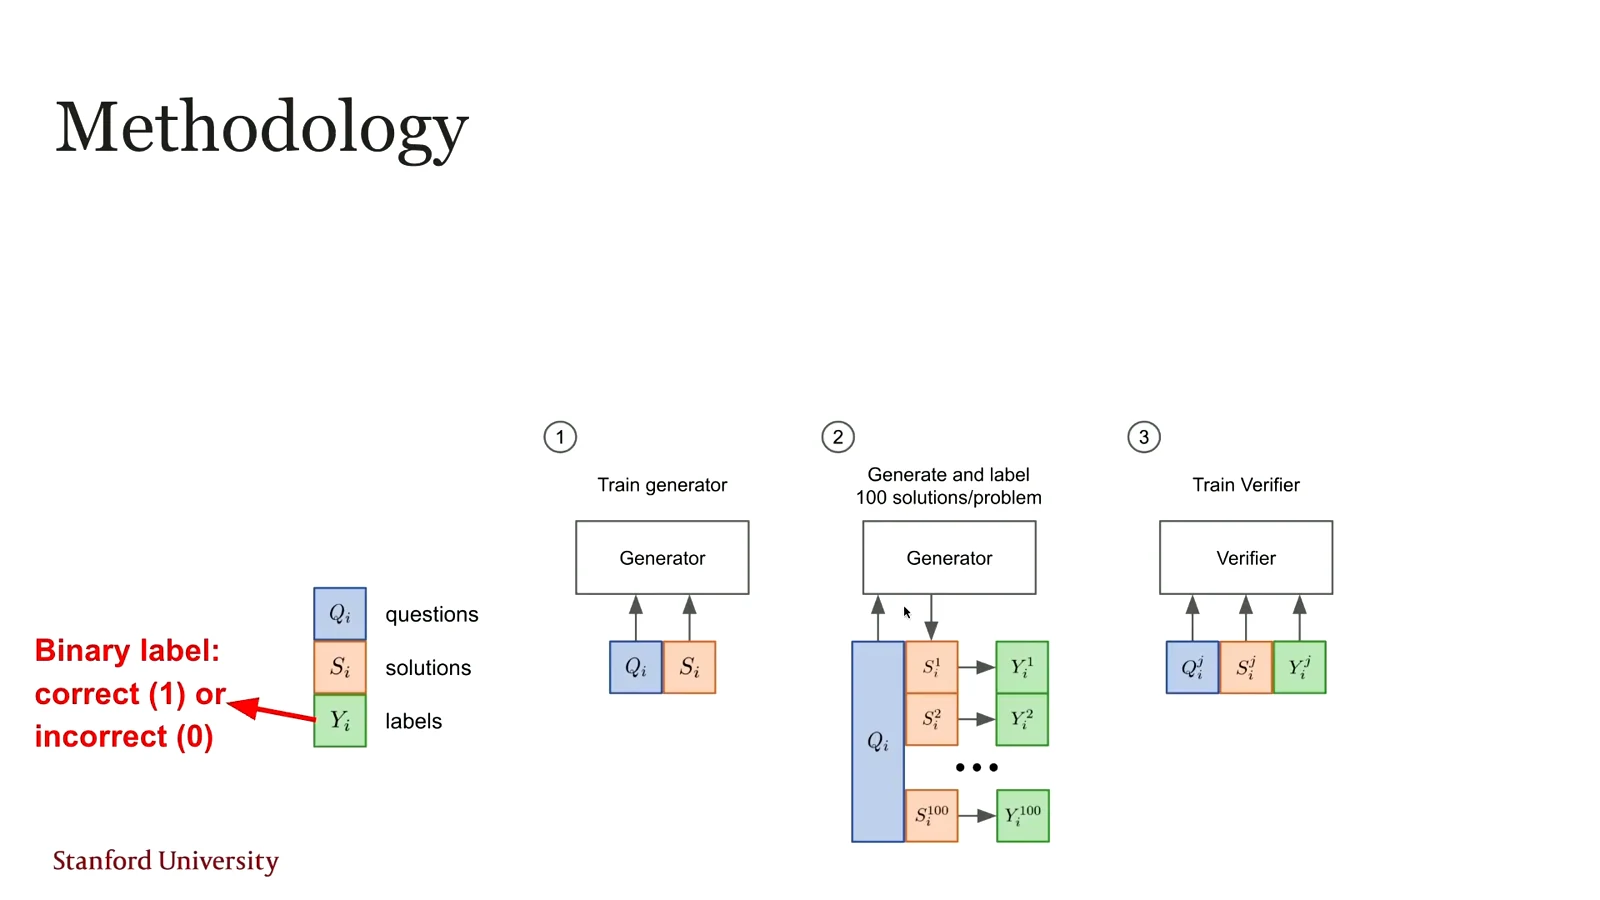
来源:Stanford 官方课程录像 Part 3,04:30;B 站对应位置。
模型使用语言模型骨干与输出标量分数的预测头。训练既包含正确性预测,也包含语言建模目标。课件区分了整段解答结束后做一次预测,以及在解答 token 位置上形成预测的变体。token 位置上有预测,不等于拥有人工提供的逐步正确性标签;这与后面的过程监督要分开理解。
推理时,对同一道测试题生成多个解答,再用验证器评分选出结果。实验里增加候选数量先带来提升,之后收益减小甚至出现下降;验证器也会受到分布外候选和看似合理的错误解影响。候选数量不是越多越安全。
最后答案标签的局限
只看最终结果,可能把“中间推理有错但碰巧答对”的解答标为正例,也不能指出哪个步骤开始偏离。反过来,前面大部分正确、最后一步算错的解答,整体会得到负例标签。下一部分因此把监督粒度从完整解答推进到中间步骤。
ORM 与 PRM:监督结果还是过程
Outcome Reward Model(ORM)主要判断完整输出;Process Reward Model(PRM)判断逐步推理。课堂以数学解题说明,一步不成立就可能导致后续全部偏离,过程监督可以更早定位问题。
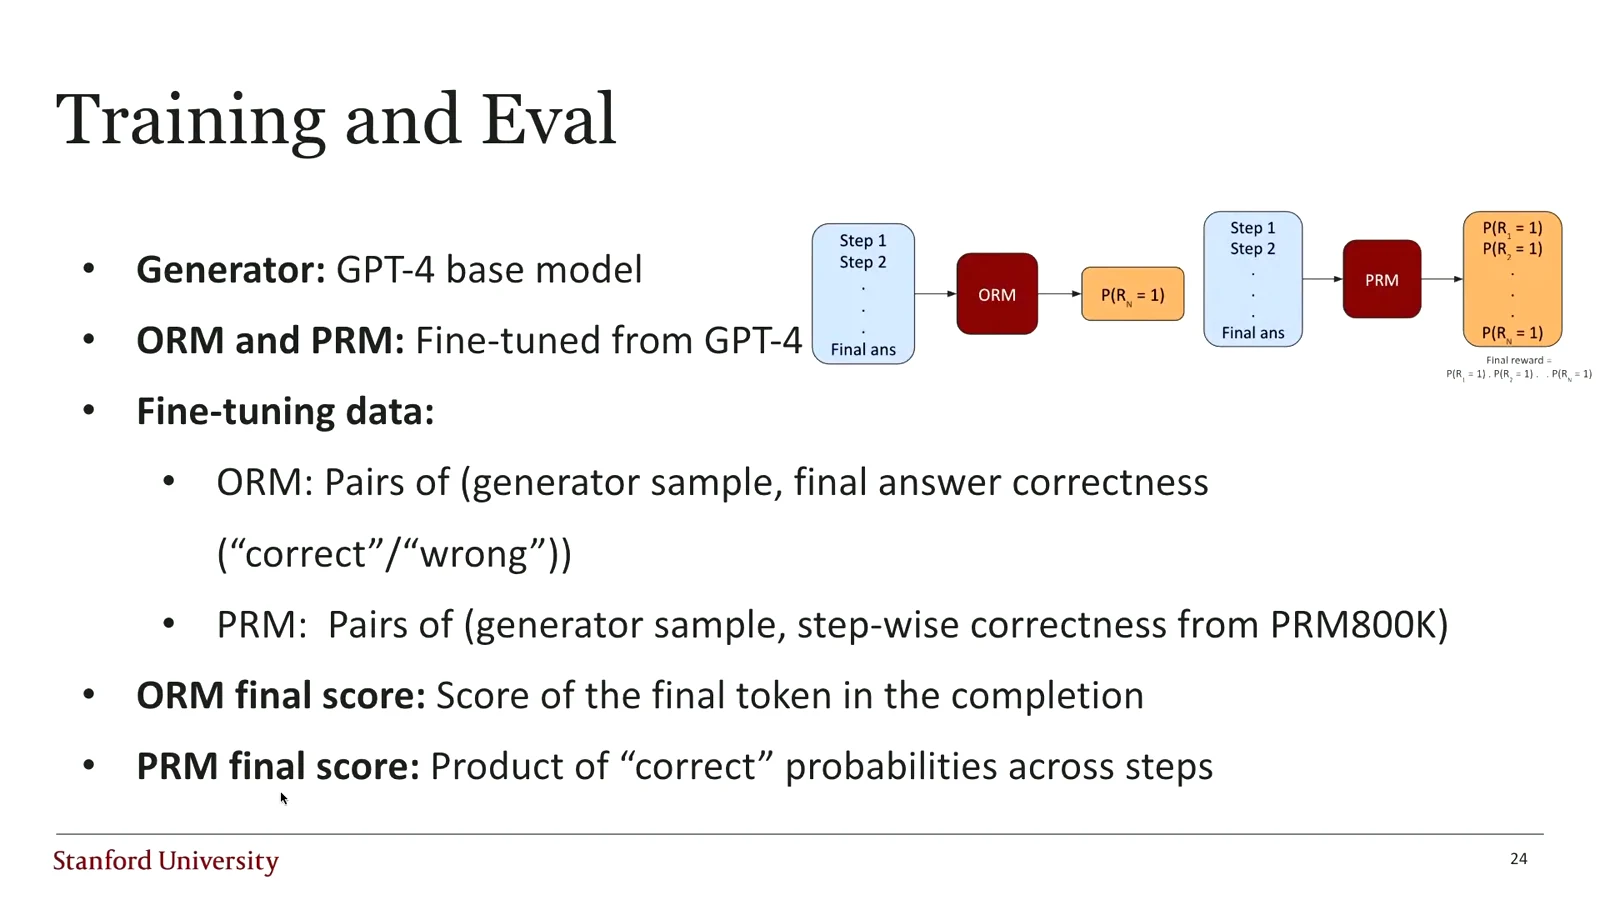
来源:Stanford 官方课程录像 Part 3,28:30;B 站对应位置。
《Let’s Verify Step by Step》让标注者给推理步骤标记正、负或中性,PRM800K 数据集提供约 80 万个步骤标签。课堂还介绍主动学习:优先选择“当前 PRM 认为很好,但最终答案错误”的候选,让人工标注更有辨别价值的难例。课件报告这种选择方式比随机选样更节省标注数据。
怎样把步骤分数变成答案分数
课件中 ORM 使用末尾位置的分数,而 PRM 将各步骤正确概率相乘:
其中 x 是问题,y 是推理过程。这个聚合方式强调全部步骤都需要成立,也会使一个很低的步骤分数明显拉低整体评分。不同聚合函数对长度和局部错误的敏感程度不同,不能把乘积直接当作任何任务都适用的规则。
这里的分数仍是模型估计。对每步打分有利于搜索和诊断,却没有把自然语言数学变成形式化证明检查;错误标注和模型盲点仍然存在。
Math-Shepherd:用续写估计中间步骤的价值
逐步人工标注成本很高。Math-Shepherd 从一个中间推理前缀继续采样多条完整解答,再检查这些续写能否到达标准答案,用结果给该前缀构造自动标签。
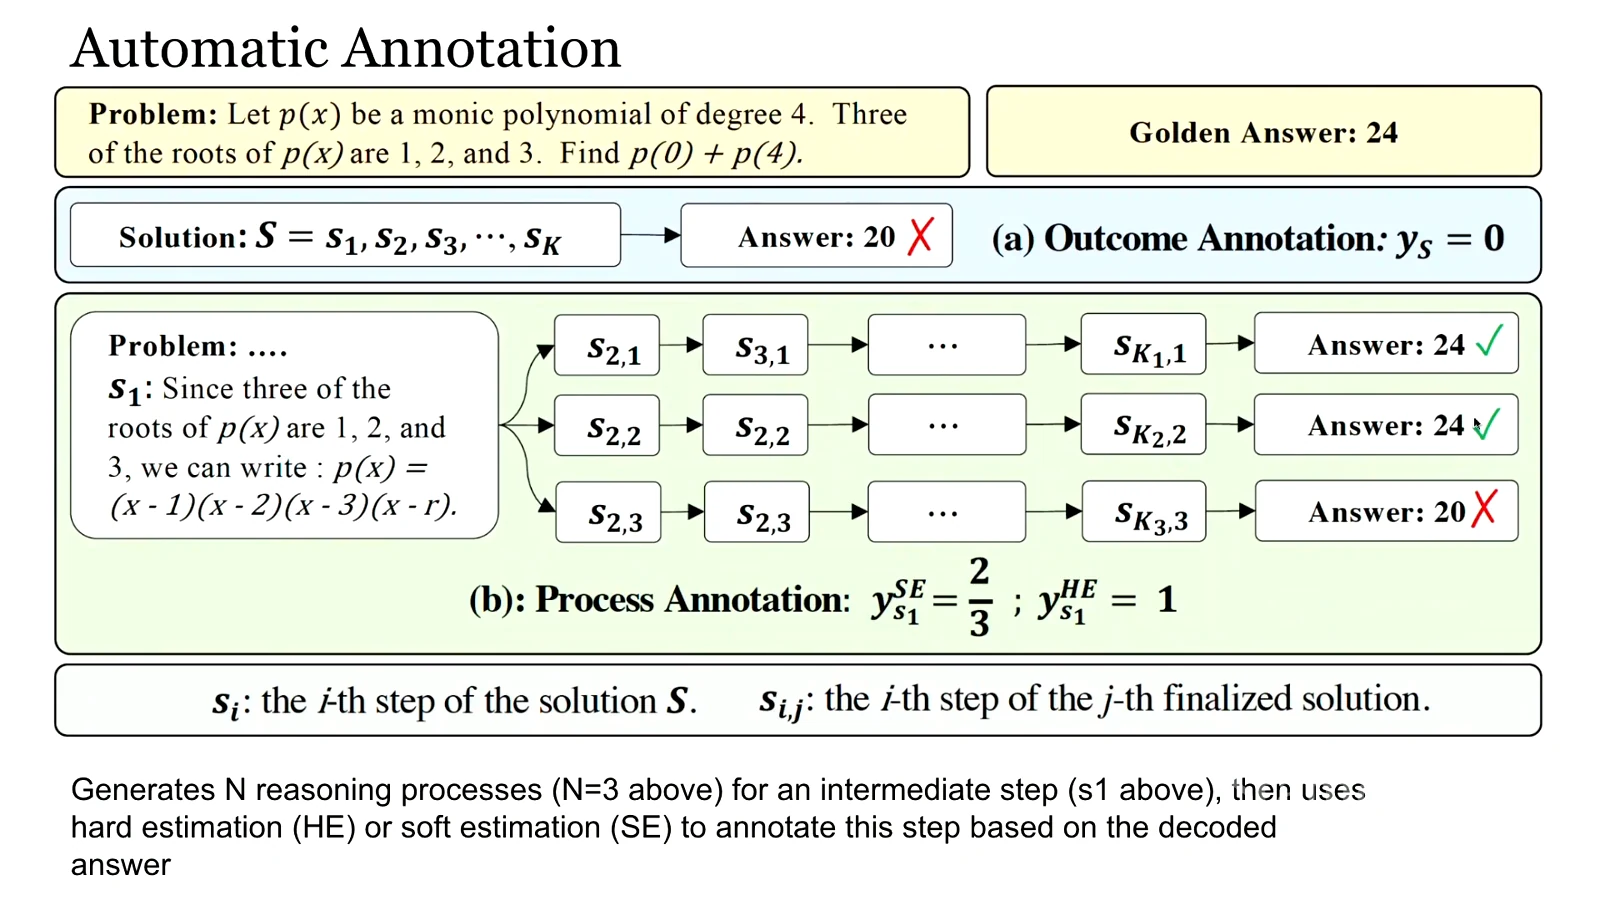
来源:Stanford 官方课程录像 Part 3,40:30;B 站对应位置。
图中从同一个前缀继续生成 3 条路径,其中 2 条到达正确答案。Soft Estimation 可以用成功比例 2/3 表示,Hard Estimation 则在至少一条成功时给出正标签。这里评估的是“当前策略从这个前缀继续,能否解出来”。
这带来一个重要限制:有限次续写没有答对,不能严格证明前缀在逻辑上错误。 也可能是后续生成器能力不足。相反,后续模型可能修正先前错误,最后答案正确也不必然证明此前每个论证都成立。
课上还比较了续写数量与性能的取舍。增加路径需要更多计算,并非持续带来同等收益。构造好的过程奖励模型可以用于候选重排序,也可以给 PPO 等训练方法提供更细的奖励信号。实验在 GSM8K 与 MATH 上比较结果奖励和过程奖励,表明过程反馈的用途不只限于选答案。
Weaver:多个弱验证器怎样合作
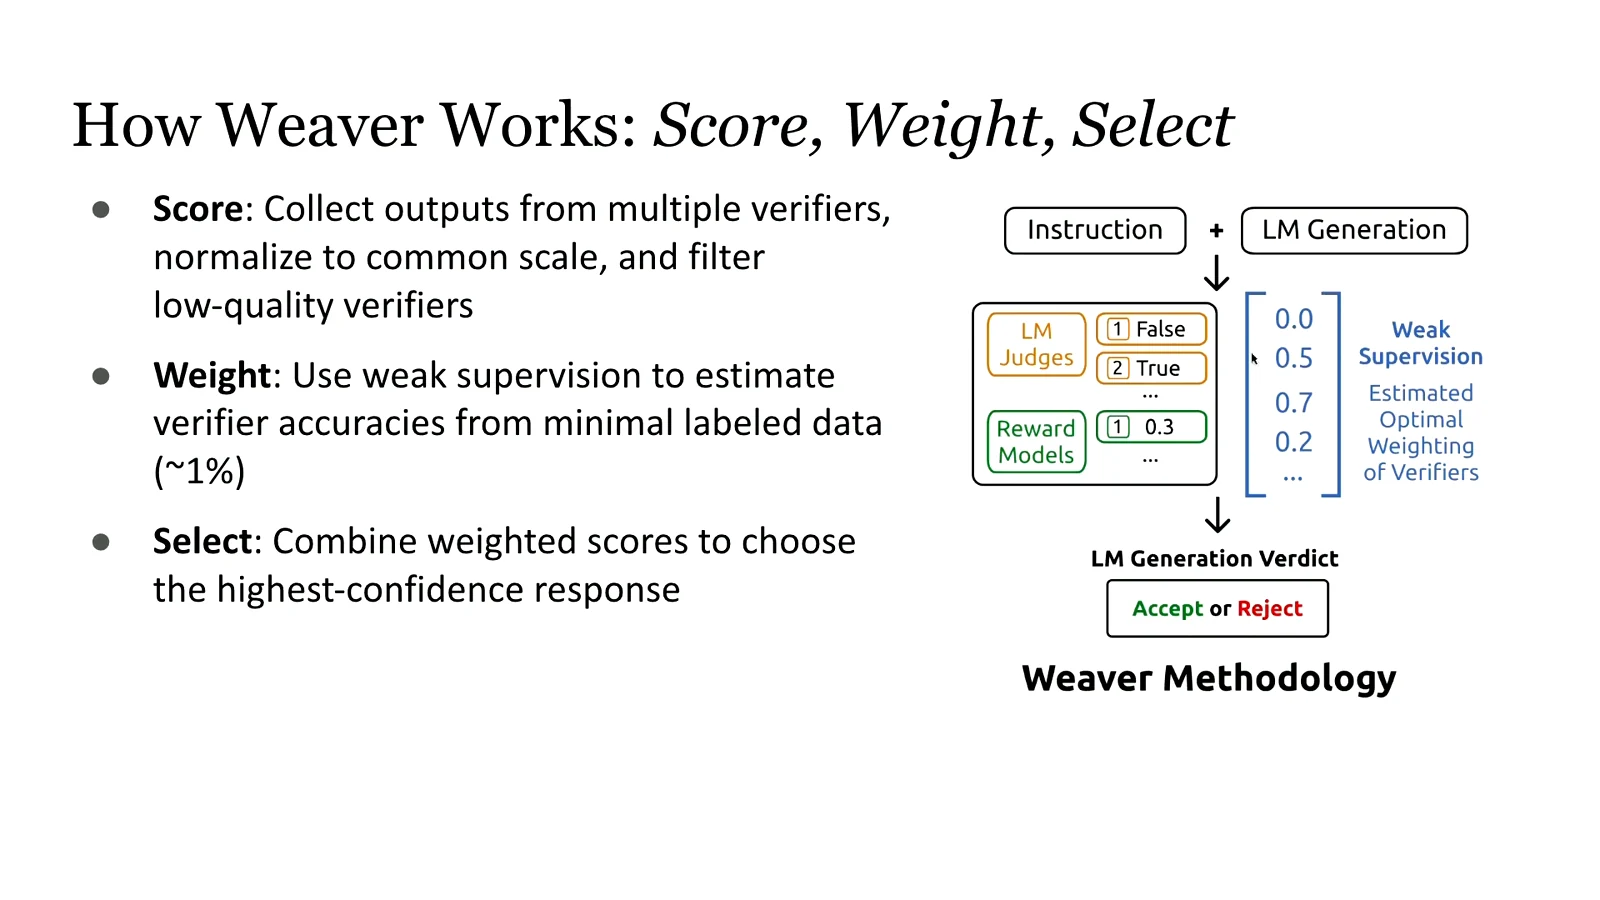
最后一部分回到 generation-verification gap。单个模型可能只能识别部分错误,简单平均或多数投票又可能让质量较差、错误相关的验证器淹没有用信号。Weaver 把验证器集成拆成评分、加权和选择。
来源:Stanford 官方课程录像 Part 3,56:30;B 站对应位置。
首先收集多个验证器的分数,统一尺度并过滤低质量来源;然后利用少量标注与弱监督估计各来源的可靠性;最后组合分数,选择置信度更高的候选。课件以约 1% 标注量说明弱监督设置,具体预算与结果仍应按论文实验条件比较。
弱监督的想法受到 Snorkel 等方法启发:把多个有噪声的来源作为标签信号,建模其准确性以及可能的相关性。课件中的概率推导采用条件独立假设来解释聚合。现实中,使用相似训练数据的验证器很可能犯同类错误,因此“多几个模型”本身不保证增加独立证据。
验证计算也需要预算
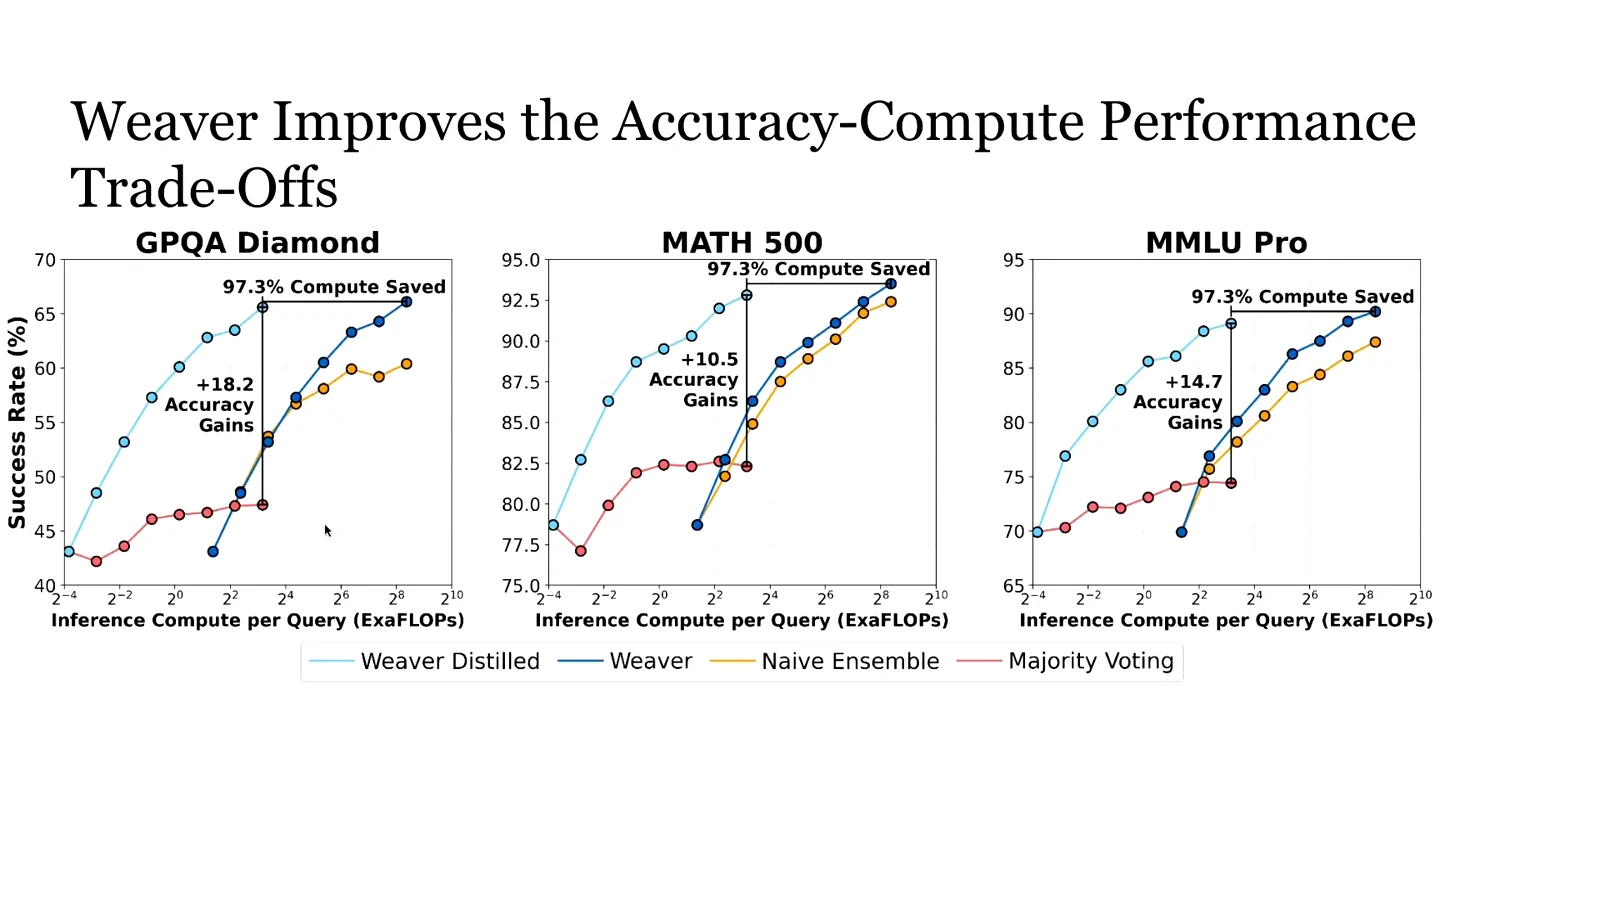
更多算力可以分给生成候选、更大的模型、更多验证器,或更昂贵的评分过程。课堂进一步介绍蒸馏:让大型验证器集成产生监督,再训练较小的模型承担验证工作。
来源:Stanford 官方课程录像 Part 3,66:30;B 站对应位置。
这样能减少部署时反复调用大型集成的开销,但需要考虑蒸馏数据覆盖、教师错误以及换任务后的分布变化。课件的计算节省来自特定模型与基准,不能直接视为任意工作负载的固定降本比例。
按照本节的材料,可靠验证需要一起检查标签从哪里来、验证器见过什么数据、怎样聚合步骤或模型分数,以及最终在哪个分布上评估。下一节将把这些反馈放进工具与代码执行循环,观察模型如何根据错误信息继续行动。