课程视频
B 站中英文字幕 · Stanford 官方录像 Part 4 · 课程目录
对应官方 2025 年秋季课表第 4 次课(2025-10-03):Learning from Feedback with Tools/Code。
让反馈参与下一步决策
本节先讲 ReAct,再介绍通过代码执行反馈训练模型的 RLEF,最后讨论 Constitutional AI。三者使用不同反馈:环境中的观察、程序测试结果,以及依据原则产生的 AI 评价。本文按公开视频 Part 4 的顺序整理。
ReAct:推理与行动怎样交替
只生成思维链时,模型可以在内部组织推理,却未必有外部证据来纠正事实错误。只采取行动时,系统又缺少显式计划,不容易判断接下来应搜索什么、为什么要这样搜索。
ReAct 将 reasoning 与 acting 交替组织。模型先形成当前想法,选择行动,环境返回观察,接下来的推理再使用这些观察。
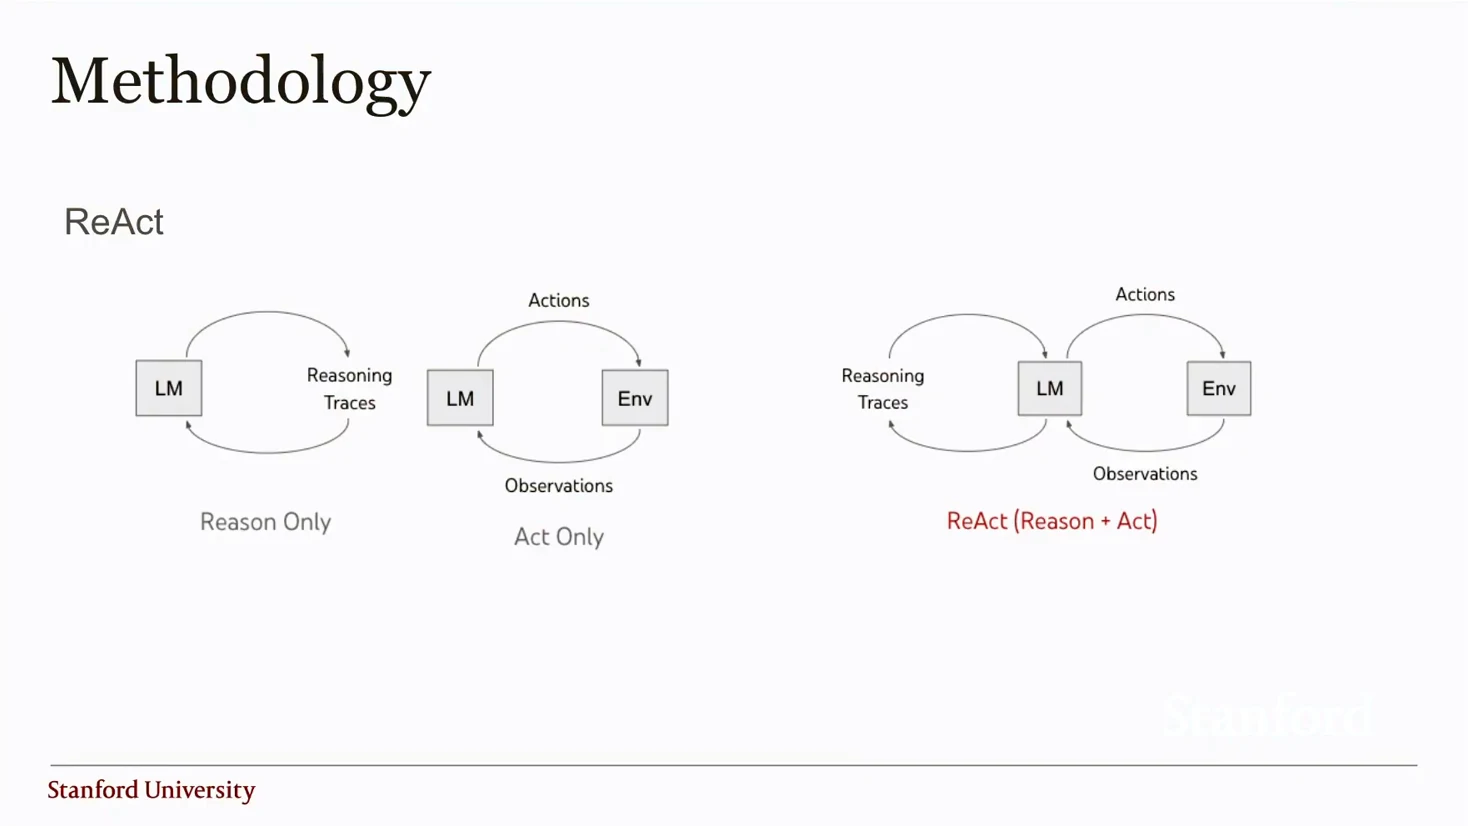
来源:Stanford 官方课程录像 Part 4,06:30;B 站对应位置。
Apple Remote 的多跳问题
课堂例子询问:除了 Apple Remote,还有什么设备能控制它原先配套的软件?单纯依赖记忆可能把问题误解成“还有哪些苹果遥控设备”,从而给出 iPhone 等看似相关的名称。
ReAct 先搜索 Apple Remote,识别它与 Front Row 的关系,再搜索 Front Row,最后从资料中找出 iPod 等相关控制方式。一次检索失败后,还可以调整实体名称继续查询。中间观察改变了后续行动,而不是让模型始终沿着最初的猜测写下去。
可以把课上的过程简化为下面的轨迹,具体返回文本以原课为准:
1 | 问题 → Thought:先确认 Apple Remote 对应的软件 |
问答、事实核验与决策任务
知识密集型任务包括 HotpotQA 与 FEVER。课堂通过移除 thought、action、observation 构造对照,并介绍 ReAct 与 CoT 自一致性的组合:外部查询步数耗尽时退回内部推理,或内部多次回答不能形成稳定答案时改用检索。
决策任务则包括 ALFWorld 与 WebShop。WebShop 里,用户给出商品属性和预算,智能体要搜索商品、选择选项并完成购买。平均属性匹配分数与“所有要求都满足”的成功率是不同指标;只匹配部分属性仍可能得到一定分数,但没有完成用户任务。
ReAct 的语言轨迹便于人观察和纠正,也增加了多轮生成成本。复杂行动空间需要更好的示范,示范又会占用上下文。课后讨论因此提出:何时值得多思考,何时应该直接行动,以及怎样避免简单任务上的过度思考。
RLEF:用执行结果训练代码模型
仅把失败日志放进提示,不保证基础模型会使用这些信息。RLEF(Reinforcement Learning from Execution Feedback)把多轮生成、运行、反馈和修改纳入强化学习过程,让模型学习根据测试结果改进代码。
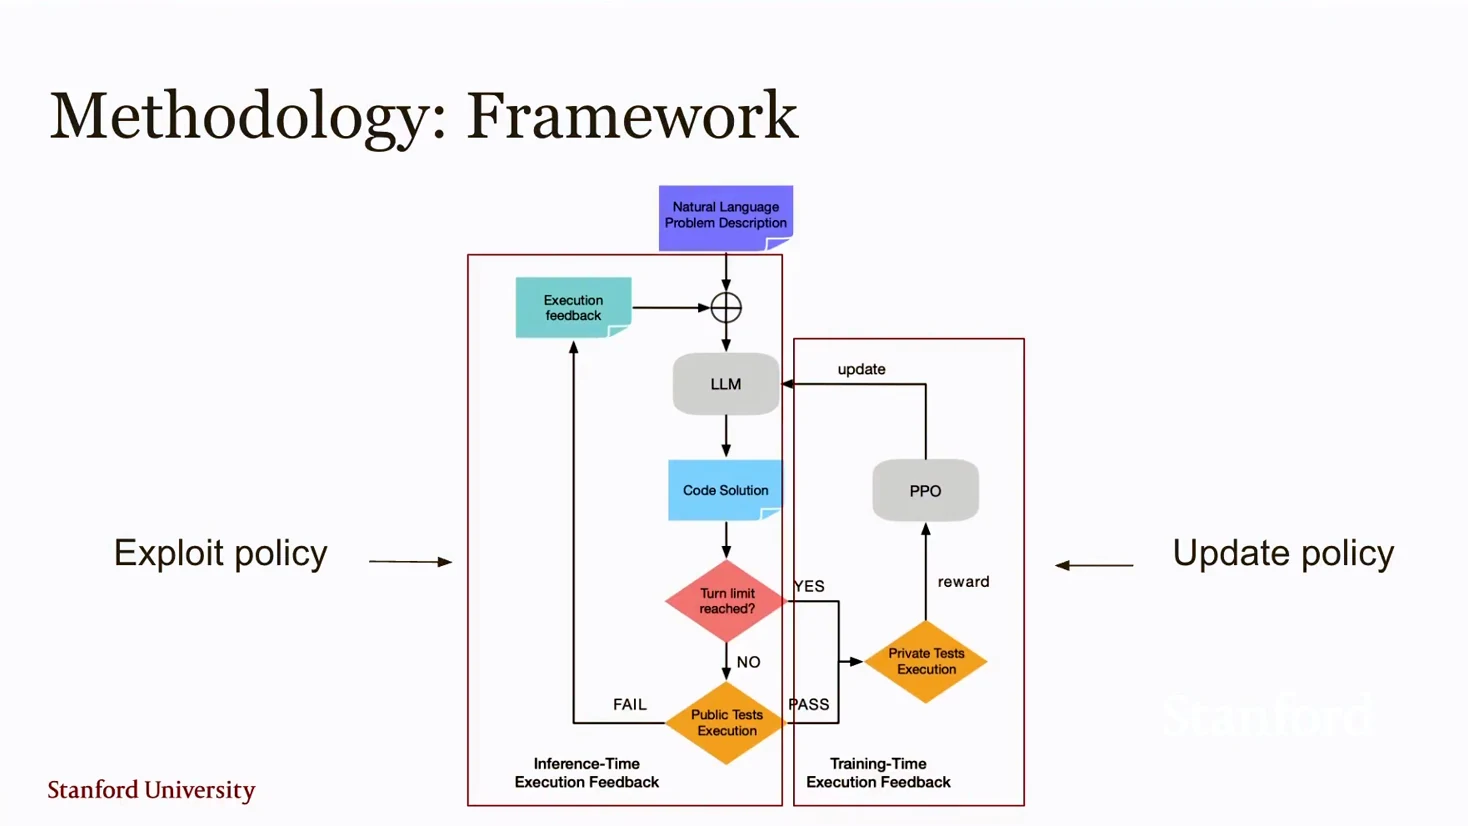
来源:Stanford 官方课程录像 Part 4,30:30;B 站对应位置。
课堂用检测回文子串的程序举例:第一次代码在公开测试上超时,模型读到执行反馈后优化实现,再次运行测试。代码通过公开测试或达到轮数上限后,系统进入最终评价,并用奖励更新策略。
公开测试与私有测试承担不同职责
公开测试在生成期间返回即时反馈,帮助模型修订;私有测试的输入与详细答案不进入生成上下文,用于最终评价并产生训练奖励。把反馈测试和评价测试分开,可以减少模型只围绕已暴露用例做表面修补的问题。
私有测试用于训练奖励时,仍会影响参数更新,因此它不是独立的最终测试集。评价跨任务泛化时,还要使用未参与训练的题目或基准。二层测试设计也不能自动保证公开测试和私有测试没有数据泄漏,仍需要实际检查数据划分。
token 级策略与轮次级价值估计
代码按 token 生成,策略需要控制各 token 的概率;一次程序是否有效,则往往要等完整代码执行后才知道。RLEF 因此将细粒度的 token 策略与轮次级价值估计结合,同一轮回答的 token 使用该轮的优势信号。
课堂没有逐项推导完整 PPO 公式,而是强调这一粒度差异。终局通过测试、未通过测试以及无有效代码等情况形成奖励信号,并结合 KL 约束限制策略偏离。执行环境通常不可微,模型通过采样及奖励优化,而不是对测试运行本身反向传播。
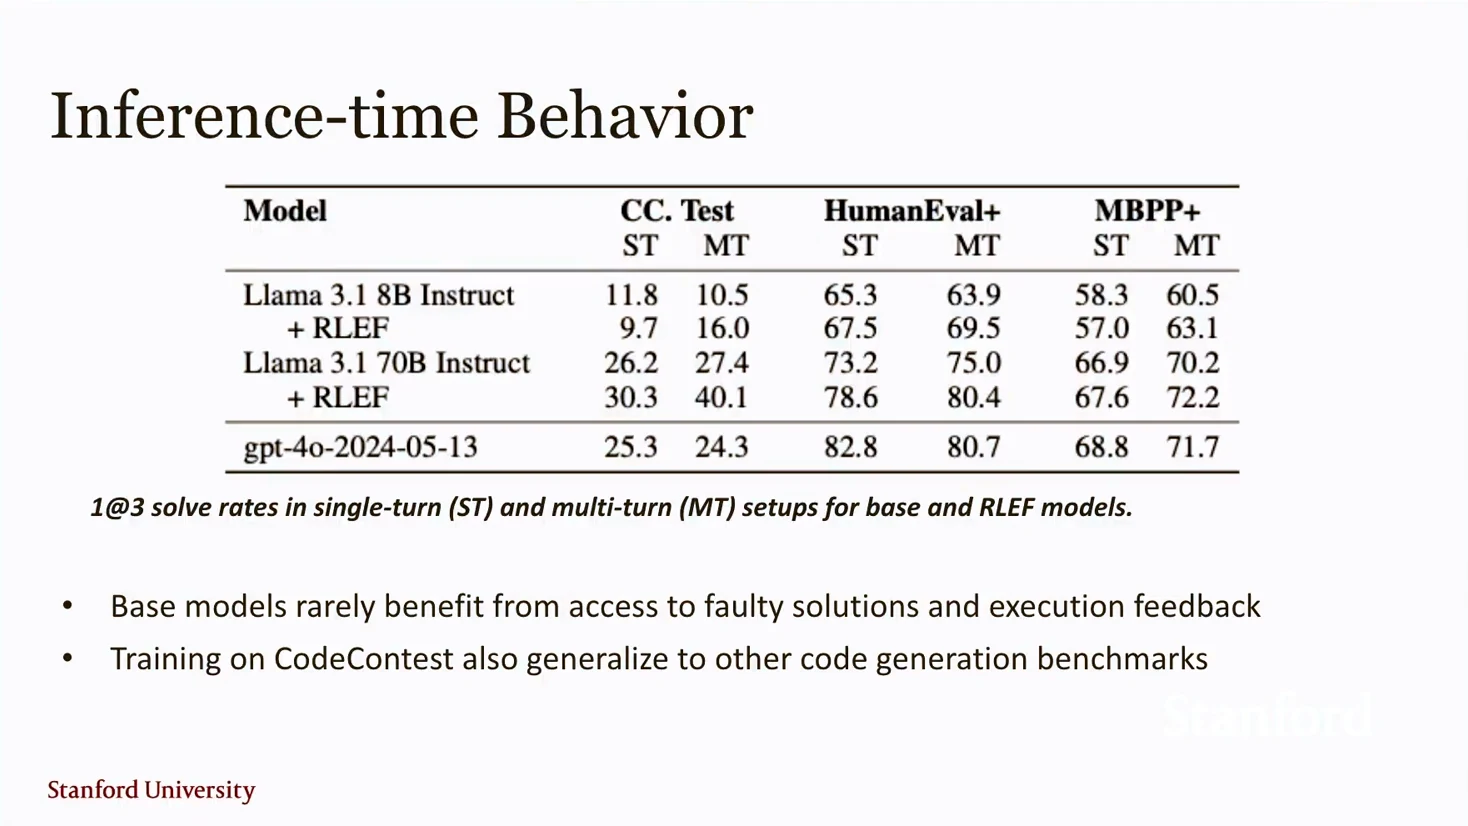
来源:Stanford 官方课程录像 Part 4,36:30;B 站对应位置。
实验比较 CodeContests、HumanEval+ 和 MBPP+。基础模型拥有多轮反馈后未必自然变好,训练后模型更能利用反馈修订;在 CodeContests 上训练后,也观察到其他代码基准上的改善。比较时需要固定采样预算和轮数,不能把更多调用带来的收益全部算到训练方法上。
讨论还延伸到整个代码仓库:仓库超出上下文时,系统必须先搜索、定位相关文件,或构造摘要,才能判断修改范围。测试反馈解决的是“这次修改表现怎样”,它不能代替获取正确上下文。
Constitutional AI:根据原则生成反馈
随后课程从代码正确性转向帮助程度与无害性。RLHF 需要大量人工比较回答;Constitutional AI 让人先写出行为原则,再让模型根据原则评价与修订,减少逐条人工打分的需求。
课堂举了三类原则:检查有害或不道德内容,检查性别偏见,以及判断内容是否适合儿童。每种原则都可以对应 critique request 和 revision request:先指出具体问题,再要求重新组织回答。
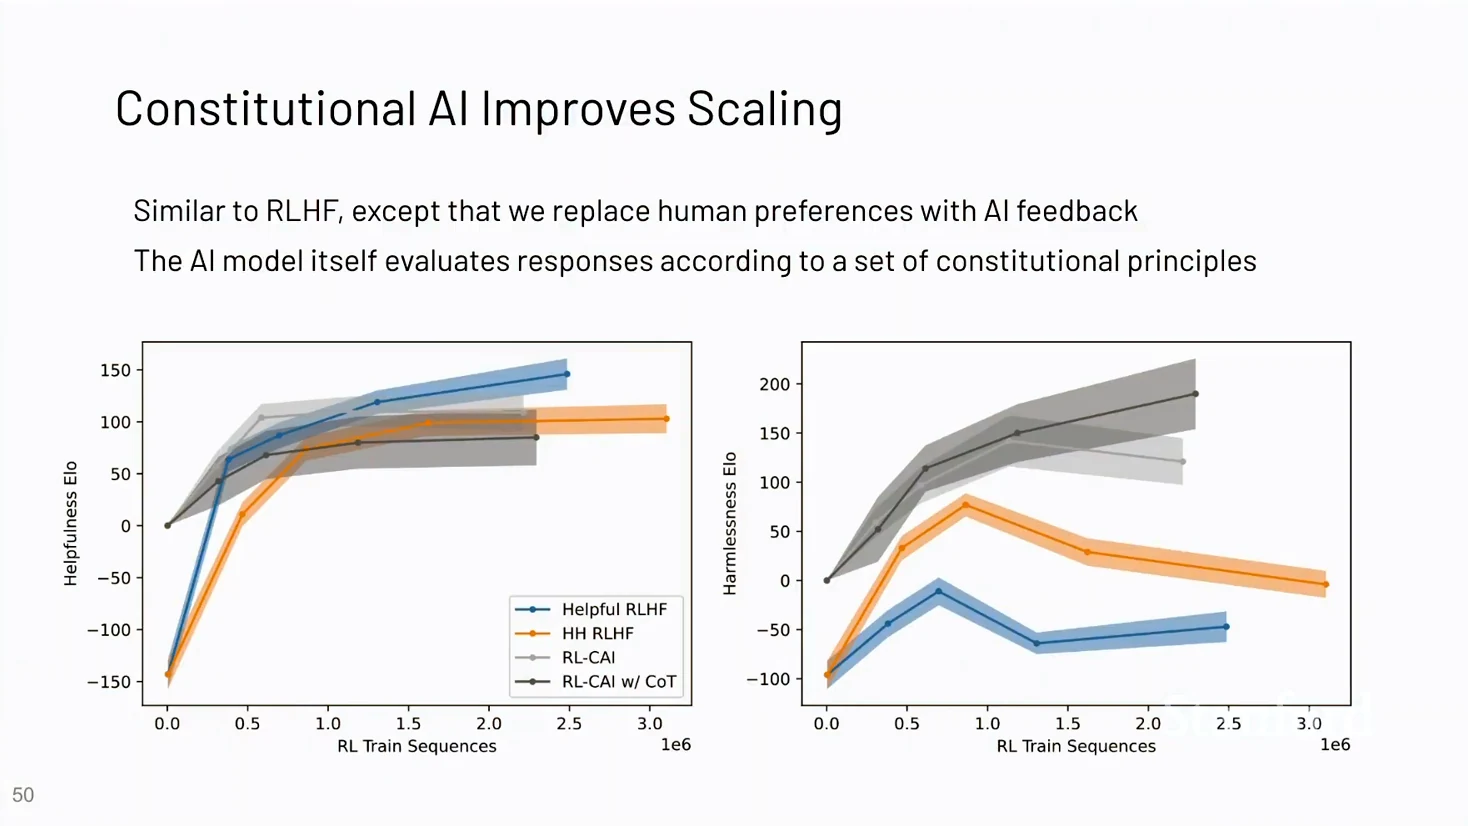
来源:Stanford 官方课程录像 Part 4,54:30;B 站对应位置。
监督阶段与强化学习阶段
监督阶段先让模型回答具有挑战性的提示,再依据原则自我批评和修订,用修订后的回答进行微调。强化学习阶段则比较不同回答,让 AI 根据原则给出偏好,训练偏好模型,再用该模型提供奖励,这通常称为 RLAIF。
人类仍然决定原则、选择任务和评价标准;模型生成了反馈,并不表示价值判断已经脱离人的选择。自我评价还可能继承模型原有盲点,写出一段批评也不能证明修改后一定符合原则。
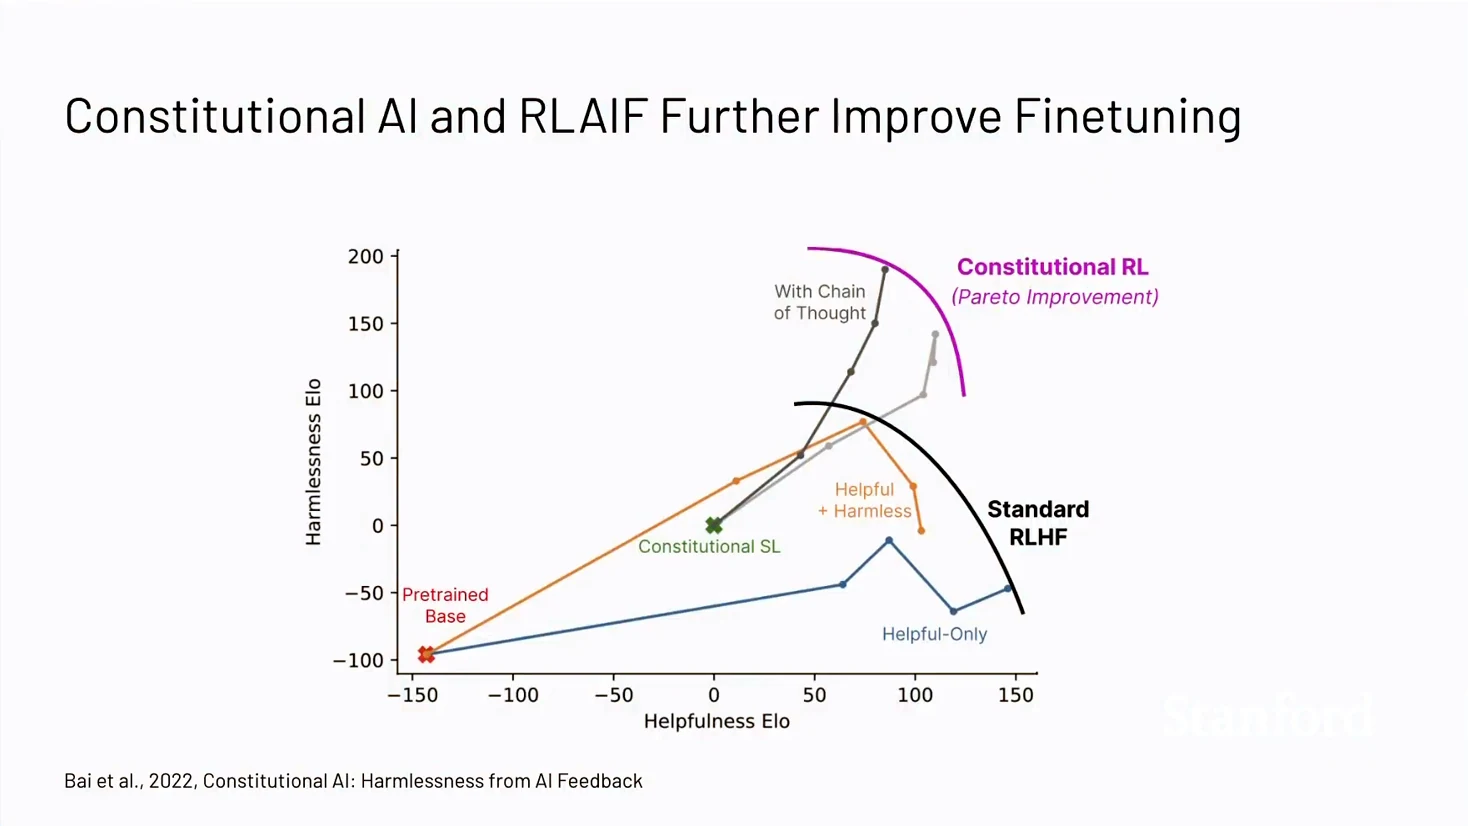
来源:Stanford 官方课程录像 Part 4,58:30;B 站对应位置。
图中把帮助程度和无害性分成两个坐标。只沿无害性反复修订,可能降低回答的具体帮助;课程介绍的是如何改善二者的取舍,并非单一分数越高就对所有人越好。
三种反馈各自改变了什么
ReAct 的环境观察帮助模型在当前任务里改下一步;RLEF 还把执行结果用于训练,使模型学会怎样修订;Constitutional AI 将原则转化为批评、修订及偏好信号。判断一个系统是否发生自我改进,需要先明确反馈进入的是上下文、候选选择,还是参数更新。
本节最后讨论了手工框架与学习方法的关系。已知而受限的行动空间更容易自动搜索,开放的真实环境仍需要获取观察、约束工具并组织反馈。下一节的规划与多步推理将继续比较搜索、并行执行与逐步训练。