课程视频
B 站中英文字幕 · Stanford 官方录像 Part 2 · 课程目录
对应官方 2025 年秋季课表第 2 次课(2025-09-26):Test-Time Compute Scaling。
推理时计算与预训练计算的区别
本节由 Azalia Mirhoseini 讲授,依次讨论重复采样、计算预算分配和 Archon 推理架构搜索。模型完成预训练与微调之后,仍可以通过多次生成、修订、验证和组合答案提高任务表现;这些操作本身不需要更新模型参数。
与一次训练、反复使用的预训练成本不同,推理时计算会在每次任务中发生。判断一种方法是否划算,需要同时说明任务分布、模型、验证方式、调用次数以及延迟约束。
重复采样为什么有效
Large Language Monkeys 将同一道题多次交给模型,统计至少一个候选答对的比例。课件展示 CodeContests、MATH、GSM8K 和 MiniF2F-MATH 等数据集上的覆盖曲线。
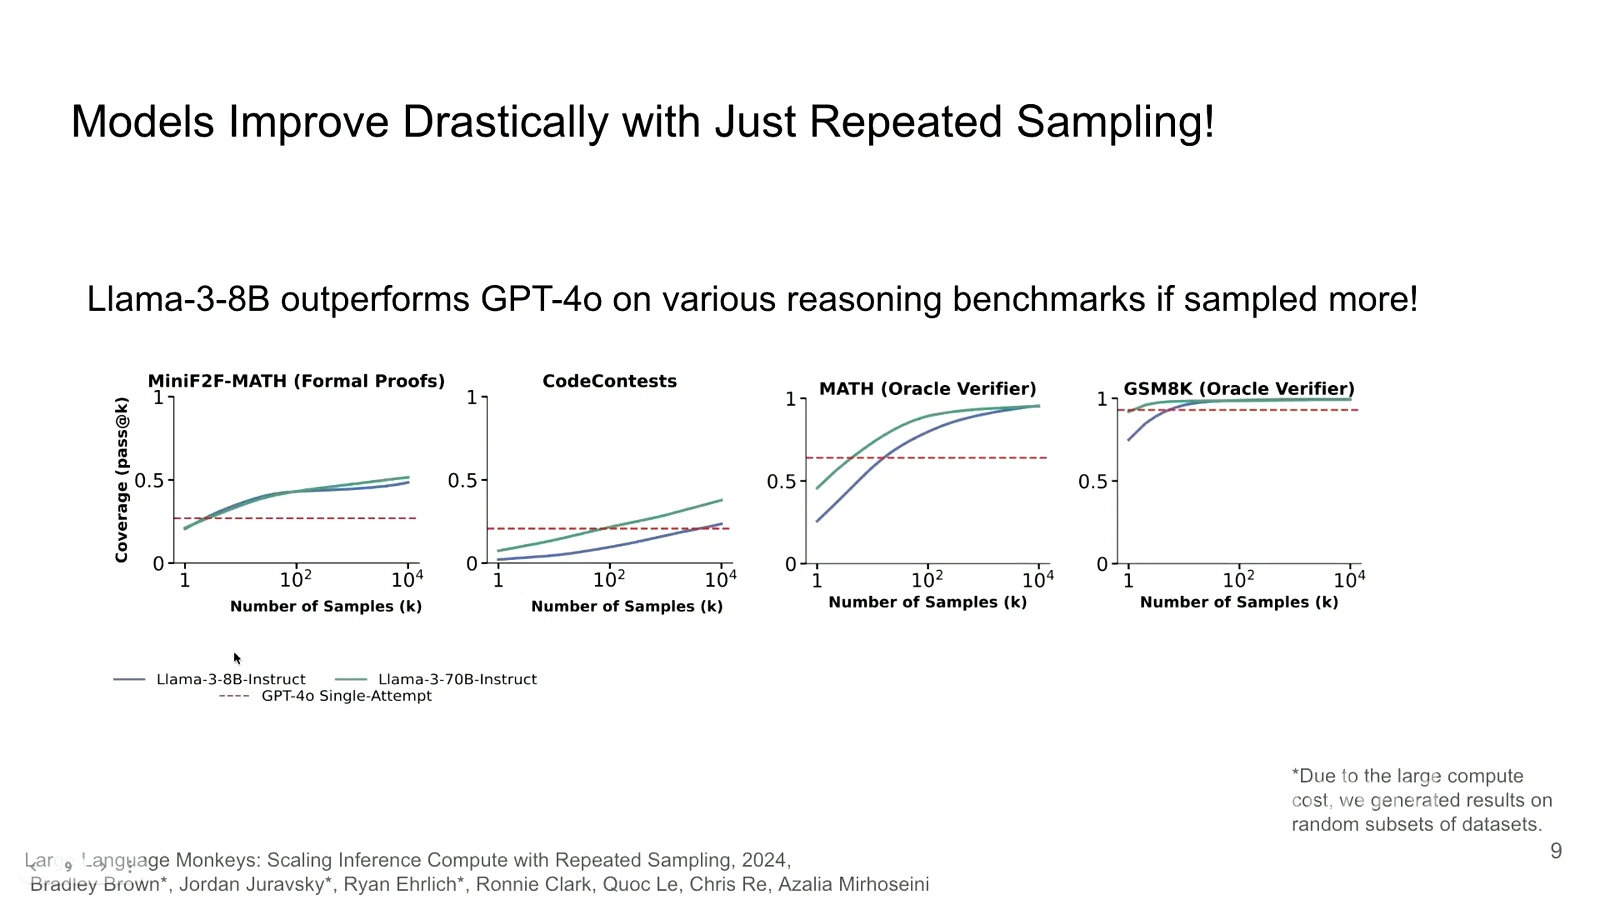
来源:Stanford 官方课程录像 Part 2,02:30;B 站对应位置。
对单道题 i,若一次独立采样的成功概率为 p_i,那么 k 次中至少成功一次的概率为:
这里的独立性是推导假设。若解码完全确定,每次都给出同一错误答案,增加调用次数就没有这样的收益。实际生成还受温度、提示、候选重复和上下文影响。
单题的指数行为与整体的幂律
课堂进一步问:单题公式看起来是指数形式,为什么一个数据集上的覆盖曲线却能呈现幂律式规律?原因在于不同题目的 p_i 不同,平均时混合了大量容易题与少量非常困难的题。
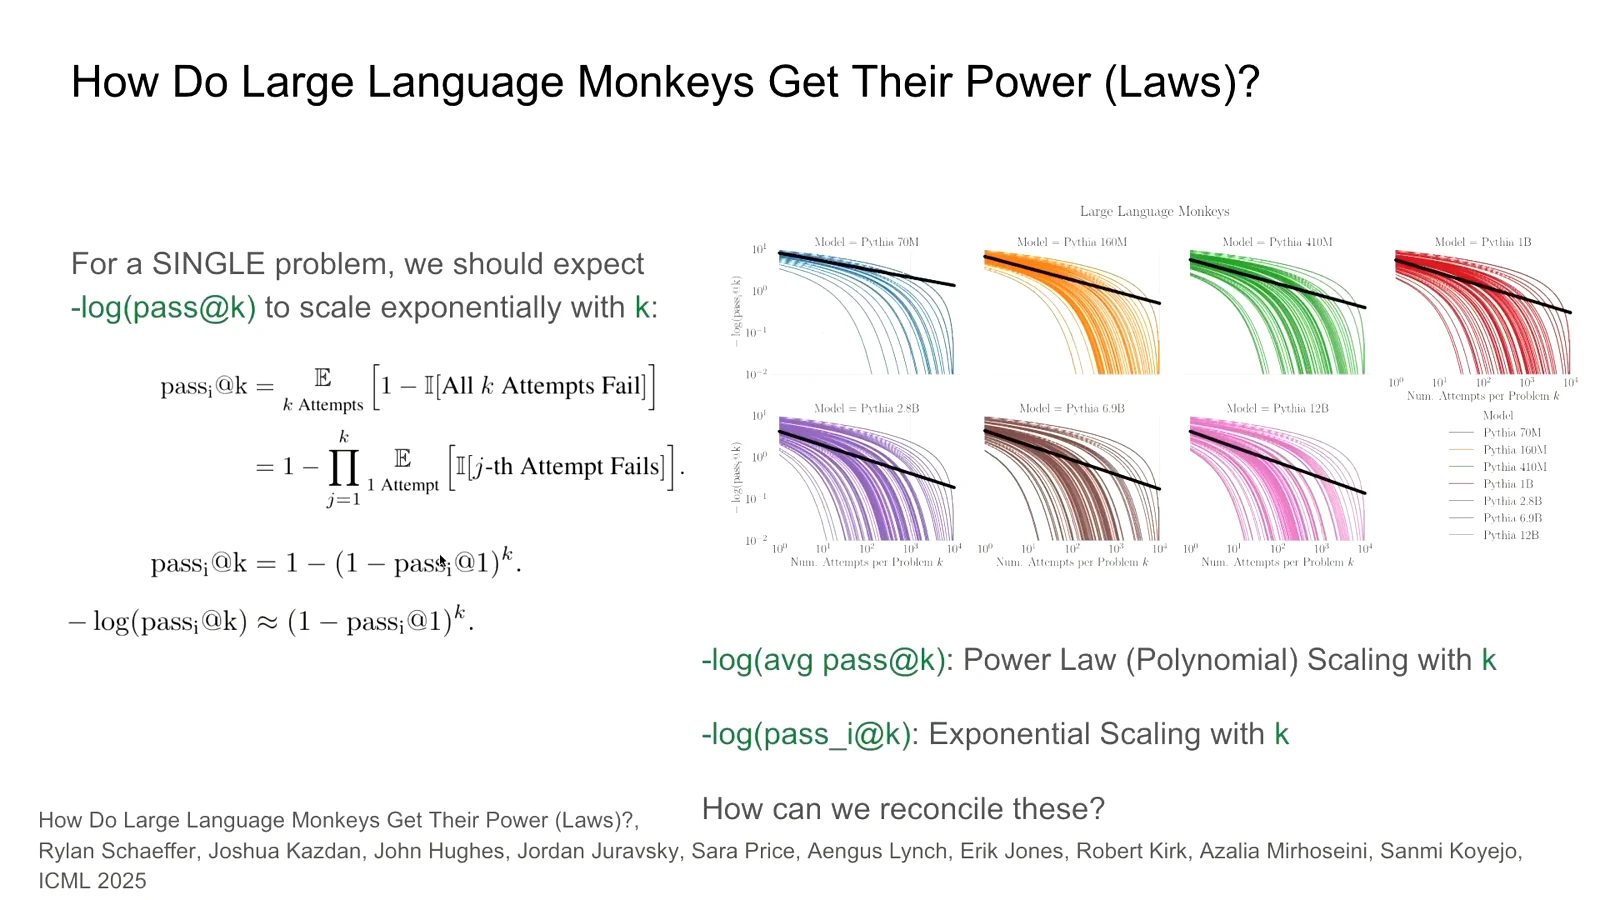
来源:Stanford 官方课程录像 Part 2,08:30;B 站对应位置。
《How Do Large Language Monkeys Get Their Power (Laws)?》分析了低成功概率区域的分布。课程把它解释为困难题的长尾:容易题很快被覆盖,后续算力主要用于那些很少生成正确答案的题。不能把单题公式直接当作全体题目的同一条曲线,也不能从观察区间外推无限收益。
有候选,不一定选得出来
数学基准使用已知答案的 oracle 验证,形式化证明和代码则可以利用检查器或测试。KernelBench 的例子把生成 CUDA kernel 的正确性与参考 PyTorch 实现进行比较,说明自动执行为何能支持大量尝试。
真实任务通常没有标准答案可查。多数投票(majority voting)根据候选出现频率选择答案,但正确候选可能十分稀少,错误解法也可能反复出现。
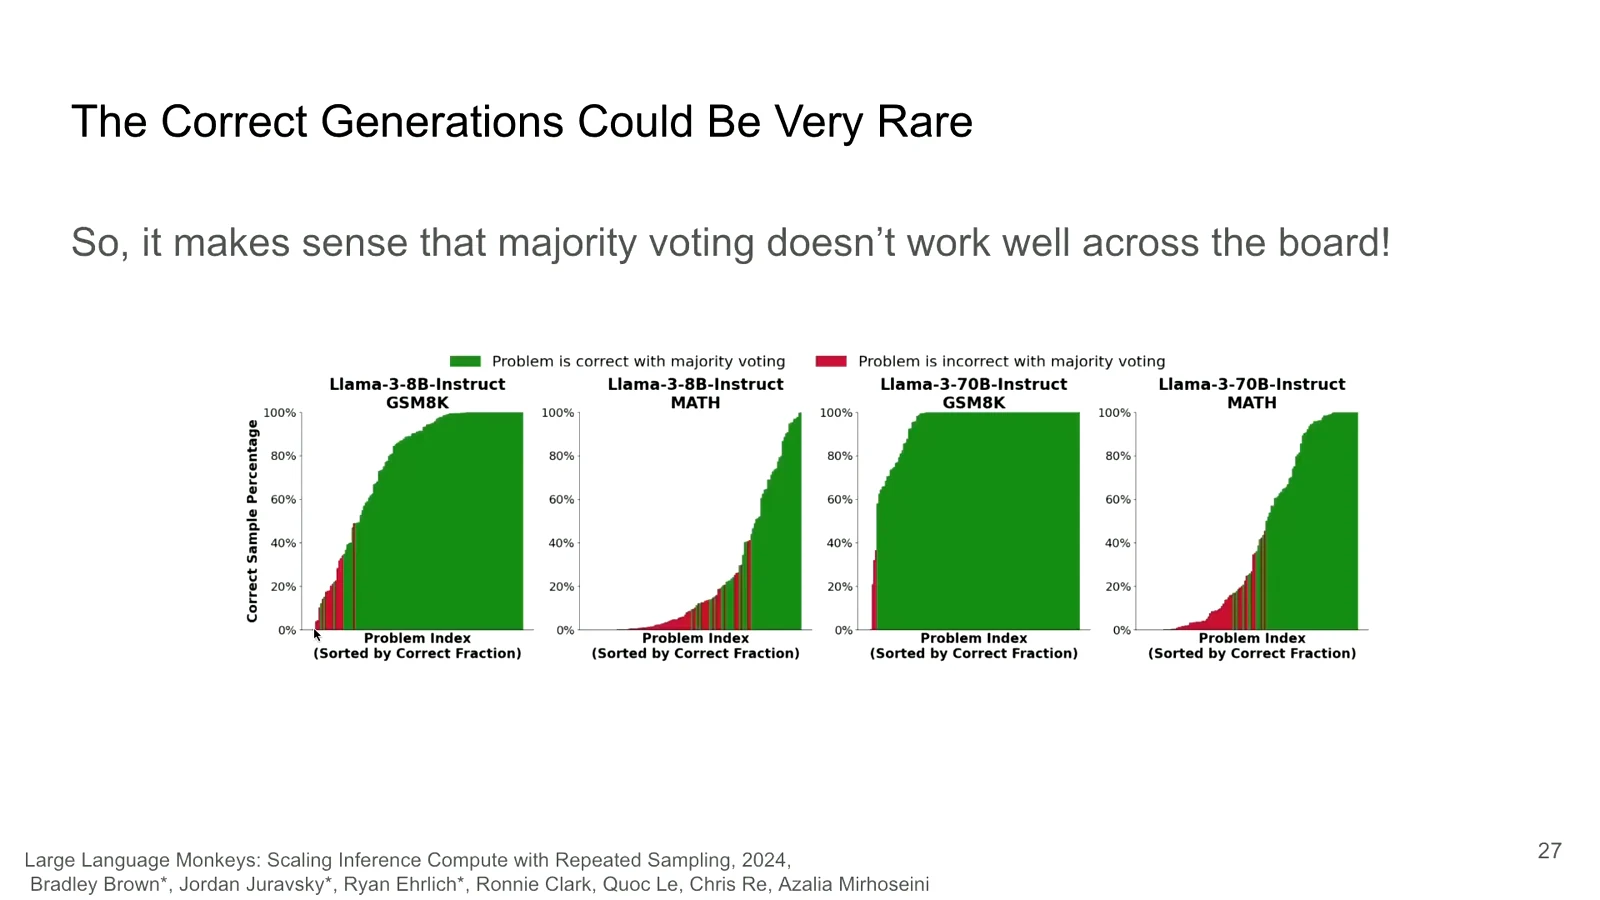
来源:Stanford 官方课程录像 Part 2,18:30;B 站对应位置。
因此,覆盖率与最终选择准确率之间存在 generation-verification gap。更多候选能提高找到正确解的机会,也可能带来更多会迷惑验证器的错误答案。测试覆盖不足同样会把错误程序当成正确程序。
并行采样、顺序修订与过程搜索
课堂接着介绍 Snell 等人的计算预算研究。并行采样让多个候选独立探索;顺序修订让后一次回答参考前一次回答及反馈。两者可以组合,例如先产生两条独立路径,再分别修订,最后比较结果。
| 方法 | 下一次生成依据什么 | 主要开销与限制 |
|---|---|---|
| 并行采样 | 同一道原始问题 | 候选数量增加,选择过程需要可靠验证 |
| 顺序修订 | 问题、先前解答与反馈 | 前后生成存在依赖,可能围绕错误起点反复修改 |
| 过程搜索 | 中间步骤及其评分 | 需要 PRM,并为扩展和筛选中间节点付出计算 |
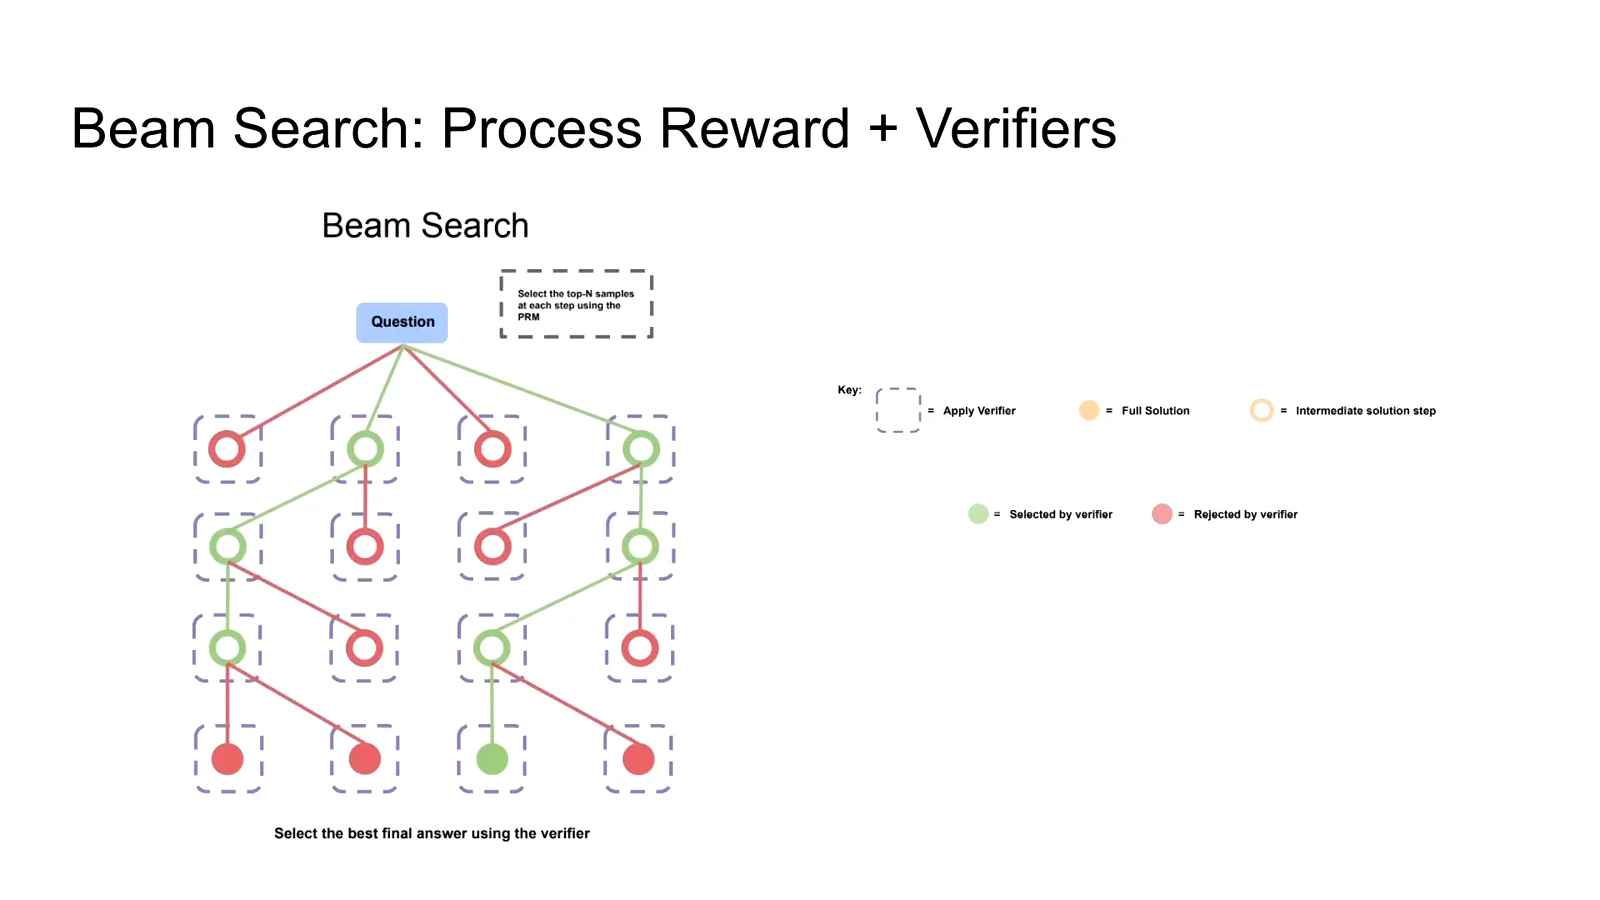
过程奖励模型(Process Reward Model,PRM)给中间推理步骤打分。课件中的 beam search 每轮扩展多个步骤,用 PRM 保留较有希望的分支,最后再对完整答案进行选择。
来源:Stanford 官方课程录像 Part 2,30:30;B 站对应位置。
图中的空心节点表示中间步骤,实心节点表示完整解。绿色分支被保留,红色分支被拒绝。这里的“步骤”是有意义的推理片段,不能直接理解为每生成一个 token 都要调用一次验证器。
给不同难度的问题分配预算
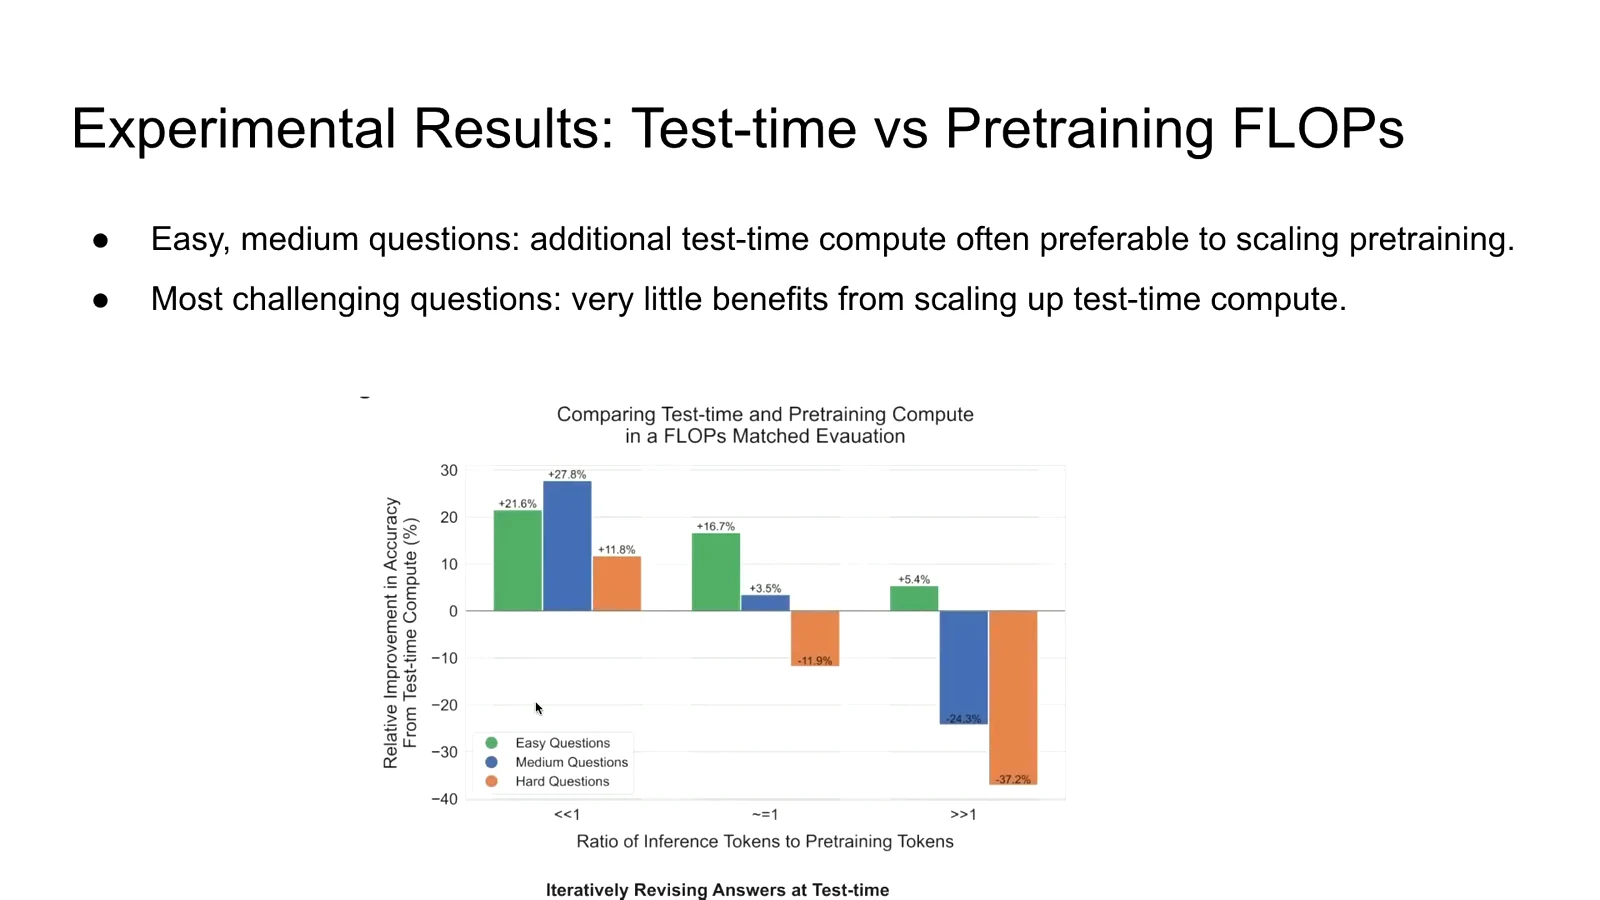
实验按基础模型的成功率把问题分成不同难度组,比较不同的并行与顺序计算比例。较容易的问题可以从顺序修订中获益;困难问题更需要探索多条路径,而最优组合并不固定。
来源:Stanford 官方课程录像 Part 2,38:30;B 站对应位置。
课上对实验的解读是:在所研究的模型、任务与计算预算下,简单和中等难度问题常能从额外推理计算中获得较好收益;最难题目仍可能更依赖更强的基础模型。这个结果不能推广成“已经不需要预训练”,因为每次请求的预算、总调用量和部署方式都会影响比较。
实际系统还要先估计难度。实验可以用大量试采样估计 pass@1,在线服务未必付得起同样的成本。如何用便宜的信号决定继续采样、改用修订或停止,是课堂保留的研究问题。PRM 的领域适配也很重要,从另一模型或数据分布收集的过程标注不一定直接适用。
Archon:搜索推理过程的架构
最后一部分介绍 Archon。前面的工作选择“采样多少次”,Archon 进一步选择由哪些操作、哪些模型以及怎样的前后依赖组成推理流程。
来源:Stanford 官方课程录像 Part 2,48:30;B 站对应位置。
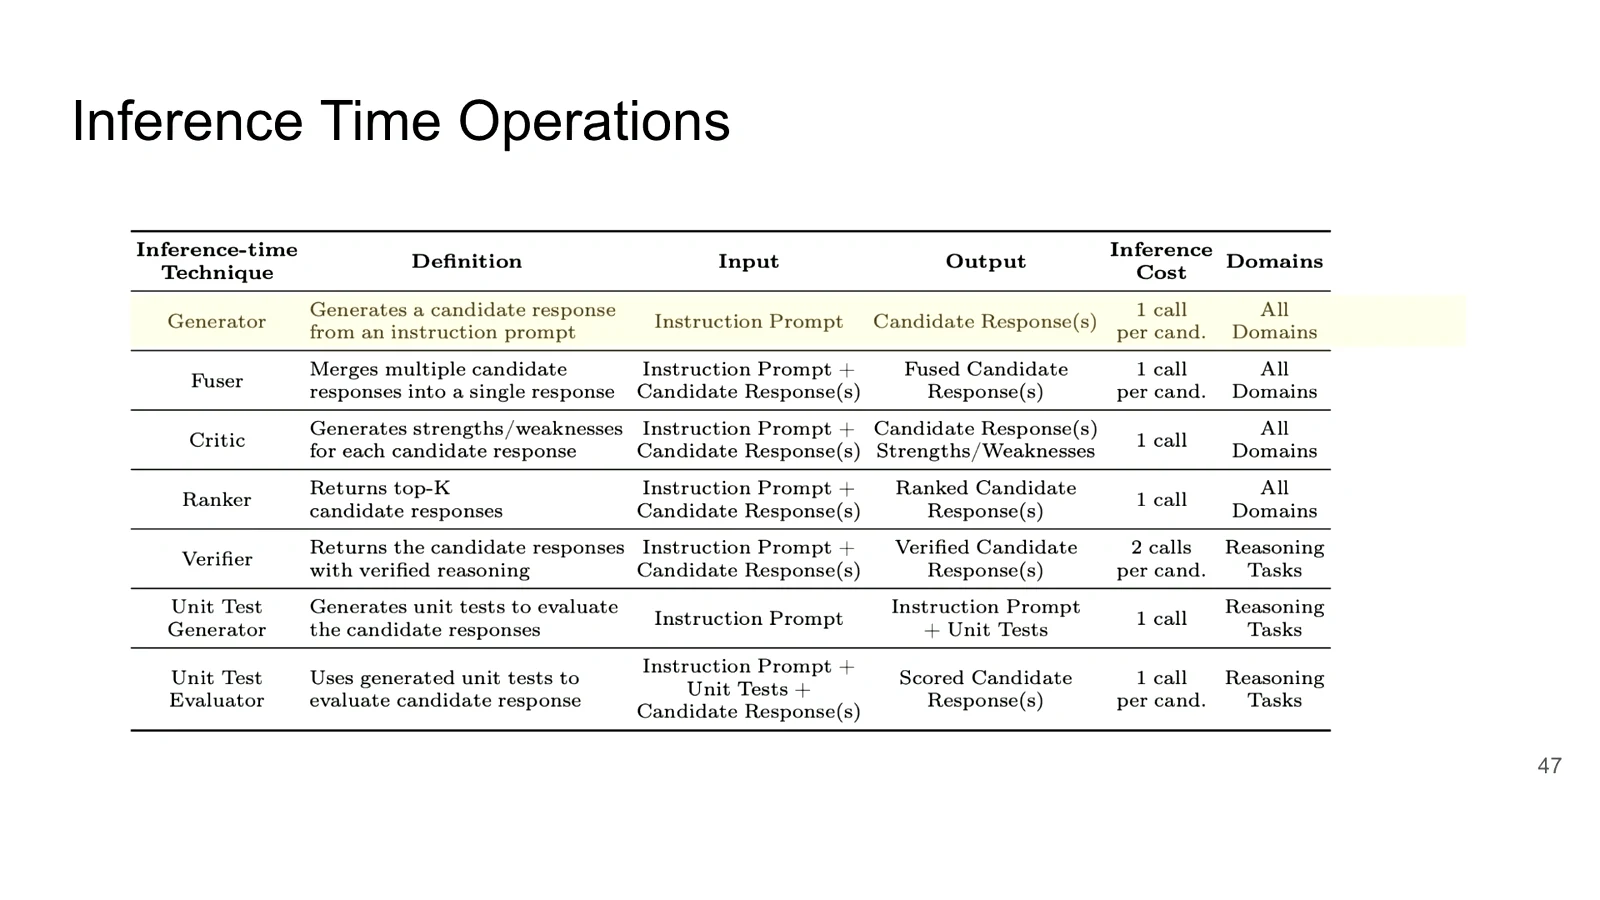
各操作的输入和输出决定了它们怎样连接:
- Generator:从问题生成一个或多个候选回答。
- Fuser:读取多个候选,综合形成新的回答。
- Critic:指出候选的优点与问题,为后续修订提供内容。
- Ranker:比较候选并选择排名靠前的回答。
- Verifier:检查推理或答案,保留通过验证的候选。
- Unit Test Generator / Evaluator:生成测试,并用测试评估候选。
融合与挑选的区别值得注意。Oracle selection 只能从原有候选里选一个;fuser 可以综合候选中的局部信息,产生原来集合中没有的新答案。因此,某些实验里的融合结果超过原候选的 oracle selection,并不意味着超过了全知验证器,而是输出集合已经改变。
ITAS 搜索什么
Inference-Time Architecture Search(ITAS)的输入包括目标基准、可用模型、推理操作和调用预算,输出是一种组合架构。课堂展示了串接多层 critic、ranker 和 fuser 的结构,以及随机搜索、贪心搜索和贝叶斯优化的比较。
架构在目标基准上搜索得到,仍需要在独立测试集上评估;更多层也会增加调用量、上下文和延迟。比较时应寻找质量与成本之间的 Pareto 取舍,而不是只比较最高分。
从本节的顺序看,计算预算先用于产生更多可能性,再用于识别和组合这些可能性。下一节的鲁棒验证会进一步分析,验证信号应该怎样训练和聚合。
参考资料
- Stanford CS329A 官方课程主页与课表
- Large Language Monkeys: Scaling Inference Compute with Repeated Sampling (Brown et al. 2024)
- How Do Large Language Monkeys Get Their Power (Laws)?
- Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters (Snell et al. 2024)
- Archon: An Architecture Search Framework for Inference-Time Techniques (Saad-Falcon et al. 2024)