课程视频
B 站中英文字幕 · Stanford 官方录像 Part 9 · 课程目录
对应官方 2025 年秋季课表第 20 次课(2025-12-05):Future Research Areas。
继续改进智能体,还缺少哪些环节
这篇笔记对应公开视频 Part 9、官方课表第 20 次课,也是公开录像中的最后一节。课程先回顾自我改进的整体循环,再依次讨论多智能体微调、DeepSeekMath-V2、Absolute Zero,以及 intelligence-per-watt。最后回到持续学习和推理基础设施的研究问题。
前面的课程已经介绍生成候选、验证、检索、规划和参数更新。但连续运行这些步骤不一定持续提高能力:训练数据可能越来越相似,验证器可能跟不上生成器,适合学习的新任务也可能越来越难找。
多智能体微调怎样保留不同推理路径
单个模型从自己生成的数据中反复学习,可能逐渐只保留少数熟悉的解题方式。Multiagent Finetuning 让一组模型从相同基础模型出发,通过交互产生数据,再用不同数据分别更新各个模型,尝试维持群体中的专长和多样性。
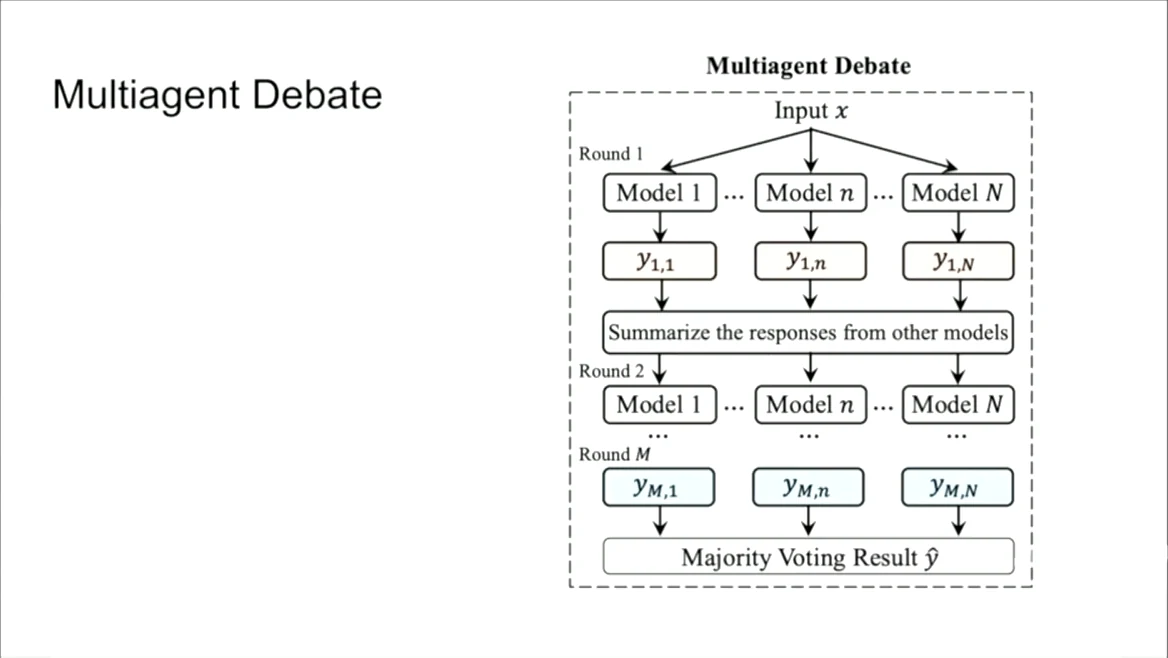
来源:Stanford 官方课程录像 Part 9,12:30;B 站对应位置。
课堂先介绍数据生成。各模型独立回答同一道题,再读取其他模型回答的摘要,更新自己的解法;多轮交流后,可以比较或投票形成候选目标。批评模型进一步检查更新后的答案,帮助筛选。
接着,不同智能体使用各自获得的训练数据进行微调,再进入下一轮。这里的“多个智能体”既包含推理阶段的交互,也包含模型之间不同的参数更新;仅在一次请求里复制多个完全相同的调用,并不等于复现了该训练方法。
多样性需要怎样评价
课程展示在数学推理任务及跨数据集上的比较,观察比单模型自举持续更多轮改进的可能性。需要分别看单体模型、群体投票、多轮辩论和微调后的表现,不能把全部收益都归因于“模型数量更多”。
互相看答案也可能导致从众。如果错误模型彼此强化同一结论,群体共识仍然可能是错的。不同数据和独立评价是否真正保留了有用差异,是这类方法需要持续检查的问题。
DeepSeekMath-V2:验证器的理由也要接受验证
课程随后把问题从“最后数值正确”推进到数学证明。证明要求每一步成立;奖励最后答案可能鼓励看似得到了目标结果、实际存在逻辑漏洞的推导。直接要求模型检查自己的证明,也可能得到过度自信的错误评价。
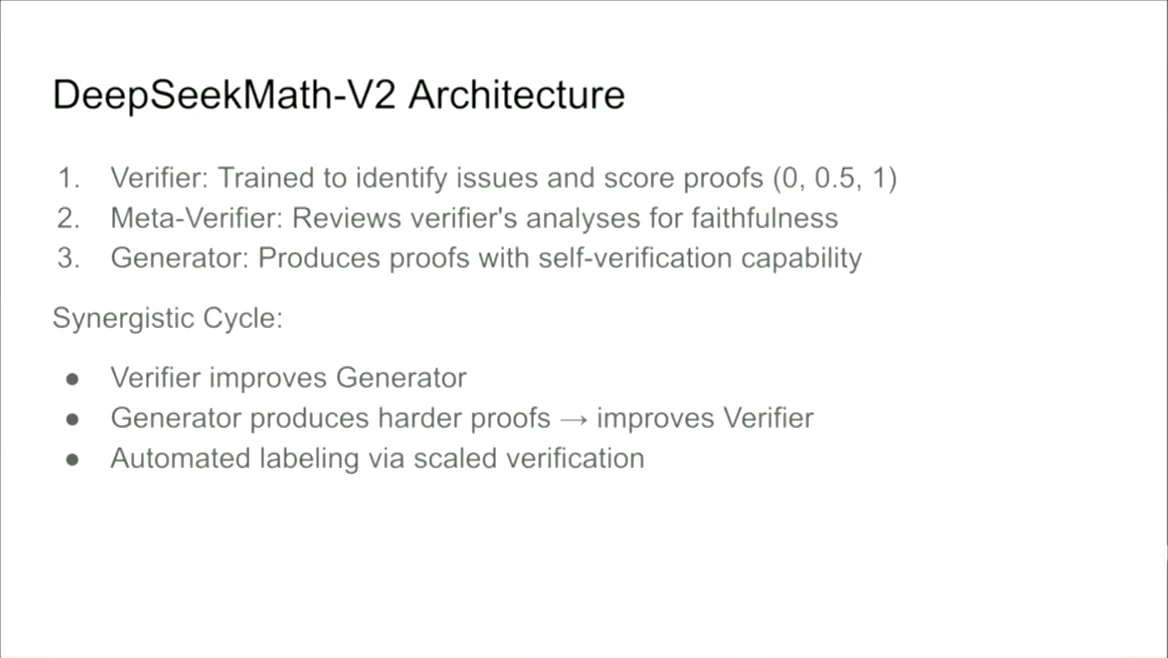
来源:Stanford 官方课程录像 Part 9,18:30;B 站对应位置。
DeepSeekMath-V2 在生成器与验证器之外加入 meta-verifier。验证器找出证明中的问题并给出分数;元验证器再检查这些评价是否忠实、指出的问题是否真的存在,以及分数是否由分析支持。
例如,证明本来正确,验证器却编造一个“缺少某个条件”的理由给低分,生成器会从错误反馈中学习。只看最终分数,无法识别这种情况;需要继续检查验证器的论据。
让生成与验证共同提高
生成器根据奖励改进证明,并尝试在最终提交前自查;更强生成器又会产生更难评价的证明,促使验证器继续学习。增加验证计算可以帮助构造新的训练标签,形成双方共同改进的循环。
这里使用的是训练得到的语言模型验证器,不能等同于 Lean 等形式化证明检查器的机械判定。元验证也仍然可能出错,它减少的是某些不忠实评价,不能保证所有自然语言证明都被严格验证。
课堂中的迭代结果分别报告 pass@1 与 best-of-32 等设置。更多验证与候选预算能够改善选择,但评价时仍要说明题目、人工评分方式和计算开销,不能把一次样本中的提高作为开放数学问题已经解决的证据。
Absolute Zero:模型能否自己提出可学习的题
现有 RL 通常依赖人类构建的问题和答案。随着模型变强,人类持续提供足够多、难度合适、又可验证的问题可能成为瓶颈。Absolute Zero 让同一个模型分别充当 proposer 和 solver,通过可执行的代码任务生成训练课程。
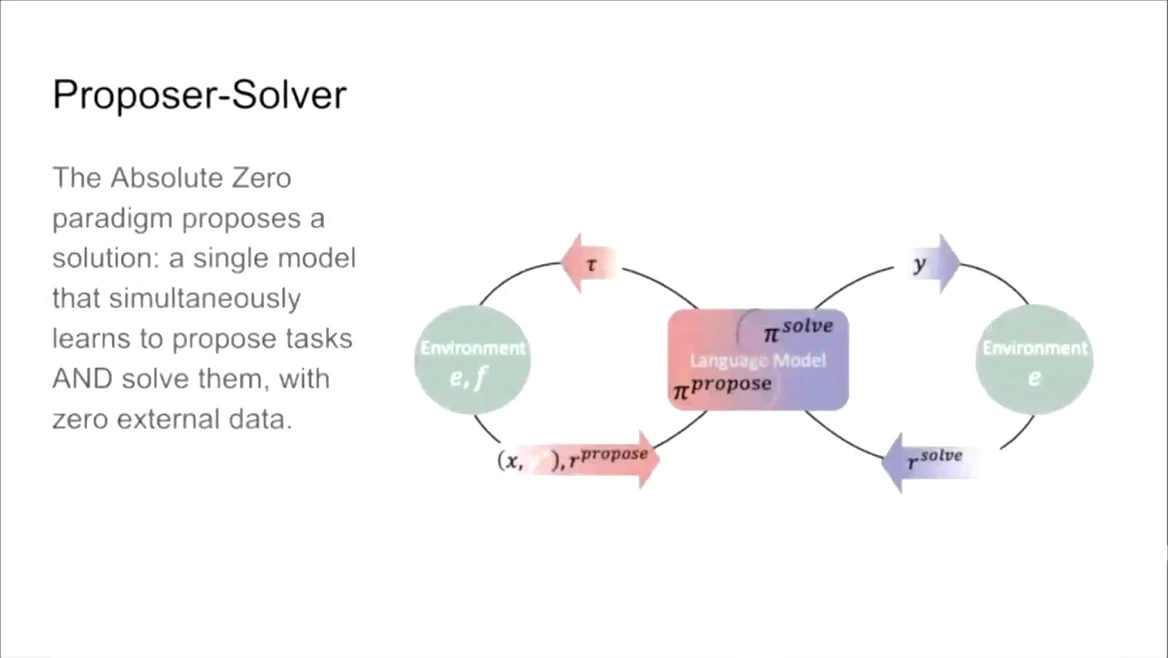
来源:Stanford 官方课程录像 Part 9,24:30;B 站对应位置。
这里的“zero data”针对额外人工整理的任务数据,不是从随机参数开始、也不是不使用预训练模型和执行环境。预训练知识、任务定义、执行器和奖励机制仍然提供了重要先验。
三种代码推理任务
以下根据论文的任务定义补充输入输出关系,方便理解课堂中的 proposer:
| 类型 | 已知内容 | 需要求解的内容 |
|---|---|---|
| Deduction,演绎 | 程序与输入 | 执行后的输出 |
| Abduction,溯因 | 程序与目标输出 | 能得到该输出的输入 |
| Induction,归纳 | 若干输入输出对及任务说明 | 符合这些例子的程序 |
代码执行器用于校验任务、生成或检查结果,使奖励尽量落在可执行反馈上。对于运行异常、不符合格式、无法确定验证结果的任务,还需要有效性过滤与缓冲区管理。
任务难度也由反馈决定
如果 solver 一次都做不出来,当前任务难以提供正向学习信号;如果全部轻松答对,继续重复的收益也有限。课堂用“成功率非零时,奖励与 1−平均成功率 有关”的例子,说明 proposer 如何倾向于提出当前能力边缘的题。
随着 solver 提高,proposer 也需要提出更难的新任务。它还会参考过去生成的例子促进多样性,避免一直在同一类简单程序上循环。最终是否泛化,应通过独立的数学、代码等测试观察,而不是只统计自己提出的题是否越来越容易答对。
来源:Stanford 官方课程录像 Part 9,34:30;B 站对应位置。
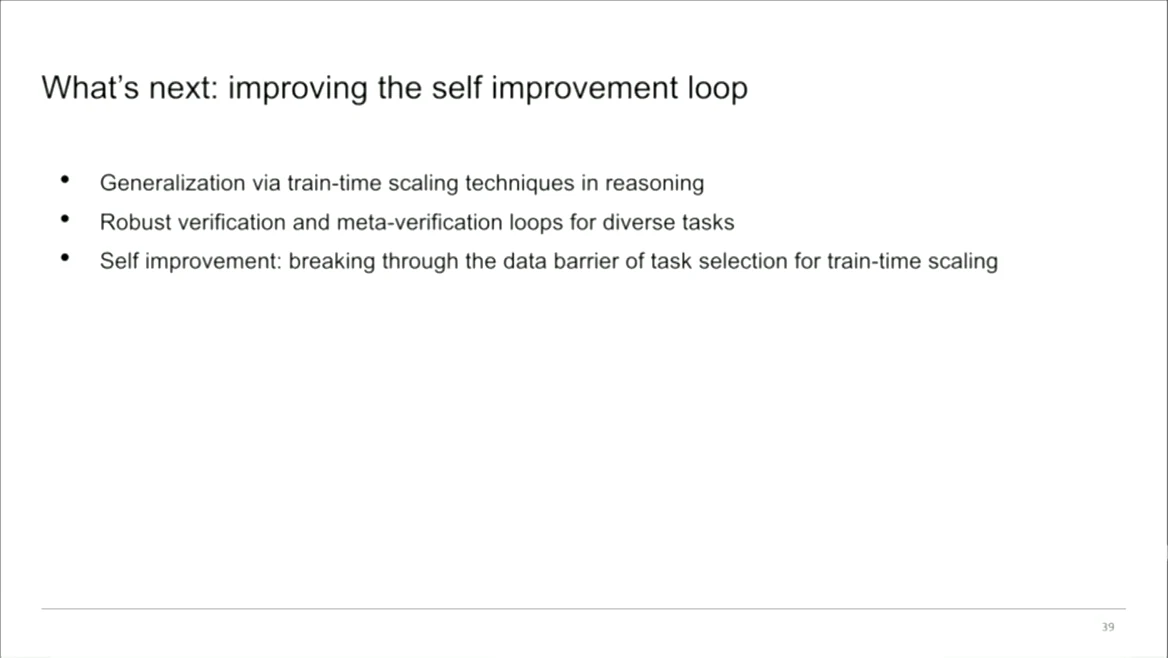
课程据此提出三个相互关联的方向:训练时扩展能否带来可迁移的推理能力,验证与元验证能否覆盖更多任务,以及任务生成能否突破人工数据选择的瓶颈。它们共同决定这个循环是否有持续的有效信号。
Intelligence-per-watt:把能力与能耗一起比较
视频后半节由 Azalia 介绍本地模型的效率研究。前面大量方法增加了推理计算,现在需要问:哪些请求值得交给最强云端模型,哪些请求可以由本地模型完成?
来源:Stanford 官方课程录像 Part 9,46:30;B 站对应位置。
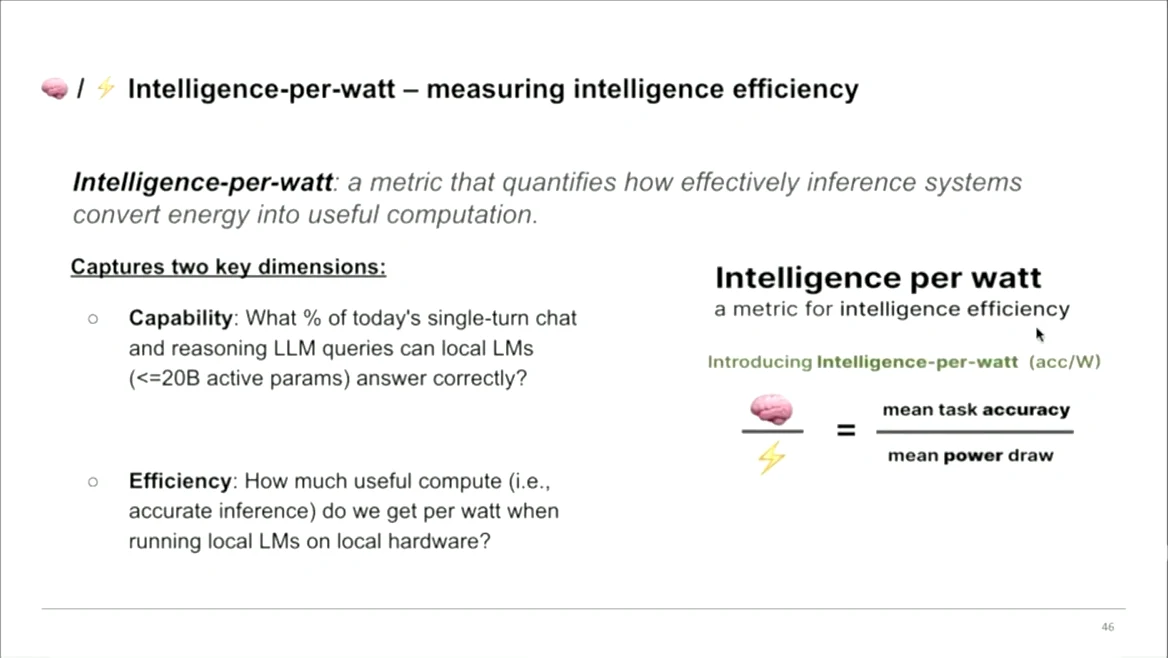
本节给出的指标可以写为:
该研究将模型、硬件、工作负载和测量条件一起比较。所称本地模型按研究中的 active parameters 等条件定义,不是任何能下载的模型都属于同一比较组。
功率与能量需要区分。 IPW 不是“每生成一个正确答案消耗多少焦耳”,因为后者还取决于运行时间与吞吐。实际选型时,应一起查看准确率、功率、延迟、能量和并发条件。
课件在其单轮聊天与推理查询分布上展示本地模型可以覆盖较大一部分请求,以及模型和硬件效率在研究区间内的改善。这里的覆盖不等于能完成相同比例的长时程智能体任务;更不能忽略困难题、工具使用和持续状态管理。
云端加速器为大模型计算做了优化,本地芯片通常还承担多种负载,因此“本地执行”也不自动意味着每瓦效率更高。模型大小、量化方式、推理内核和硬件利用率都需要实际测量。
持续学习与推理系统的后续问题
来源:Stanford 官方课程录像 Part 9,52:30;B 站对应位置。
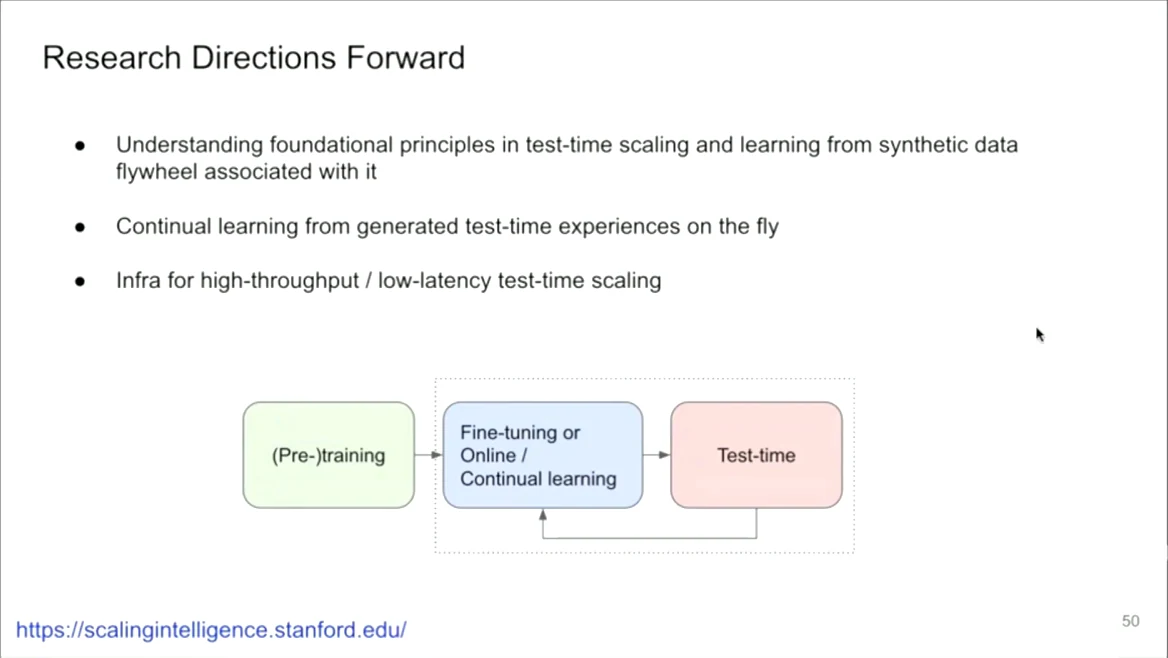
最后的研究路线回到训练与推理之间的连接:理解合成数据循环什么时候有效,从运行经验中持续学习,并构建高吞吐、低延迟的推理基础设施。自我改进需要的不只有更大的模型,也包括任务分布、可靠反馈与系统资源组织。
持续更新还会引入旧能力退化、错误经验污染和验证分布变化。对应的实验应比较更新前后独立任务的表现,记录所用数据、预算和失败案例;不能只用更新所针对的训练分数判断进步。
至此,9 段公开录像串起了候选生成、验证、工具反馈、规划、训练和评测。课程资料与每段录像对应的官方课表编号见课程目录。若继续做研究项目,可以从某个可测量的瓶颈入手,再把它放回完整智能体系统里检验。