课程视频
B 站中英文字幕 · Stanford 官方录像 Part 5 · 课程目录
对应官方 2025 年秋季课表第 5 次课(2025-10-06):Planning and Multi-Step Reasoning。
多步任务为什么需要规划
本节依次介绍 Language Agent Tree Search(LATS)、SPRINT 和 SWiRL:先在推理与行动组成的树中搜索,再减少顺序执行的等待,最后训练模型做出更好的逐步决策。三种方法分别处理路径探索、执行调度和策略学习,不能只按“是否用了多个模型”来分类。
LATS:把推理、行动与反馈放入搜索树
只生成一份计划再照着执行,容易受最初方案限制;遇到失败后,系统也未必知道还有哪些值得尝试的路径。LATS 在 ReAct 的推理和行动之上加入蒙特卡洛树搜索(Monte Carlo Tree Search,MCTS),让系统能够探索多条轨迹并利用结果更新后续选择。
课堂先用夏威夷旅行规划说明:可以询问去过的朋友,也可以查阅网上讨论;不同路径带来不同观察。模型需要比较这些路径,而不是第一步选中一个信息源后就一直执行到底。
迷宫例子中的六个阶段
接着,课程用“从昏暗房间找到出口”的例子,依次解释 selection、expansion、evaluation、simulation、backpropagation 和 reflection。
初始房间有左右两扇门,模型可以提出开左门、开右门或检查房间等行动。行动作用于环境后得到新观察,再把观察与已有轨迹一起构成新的搜索节点。
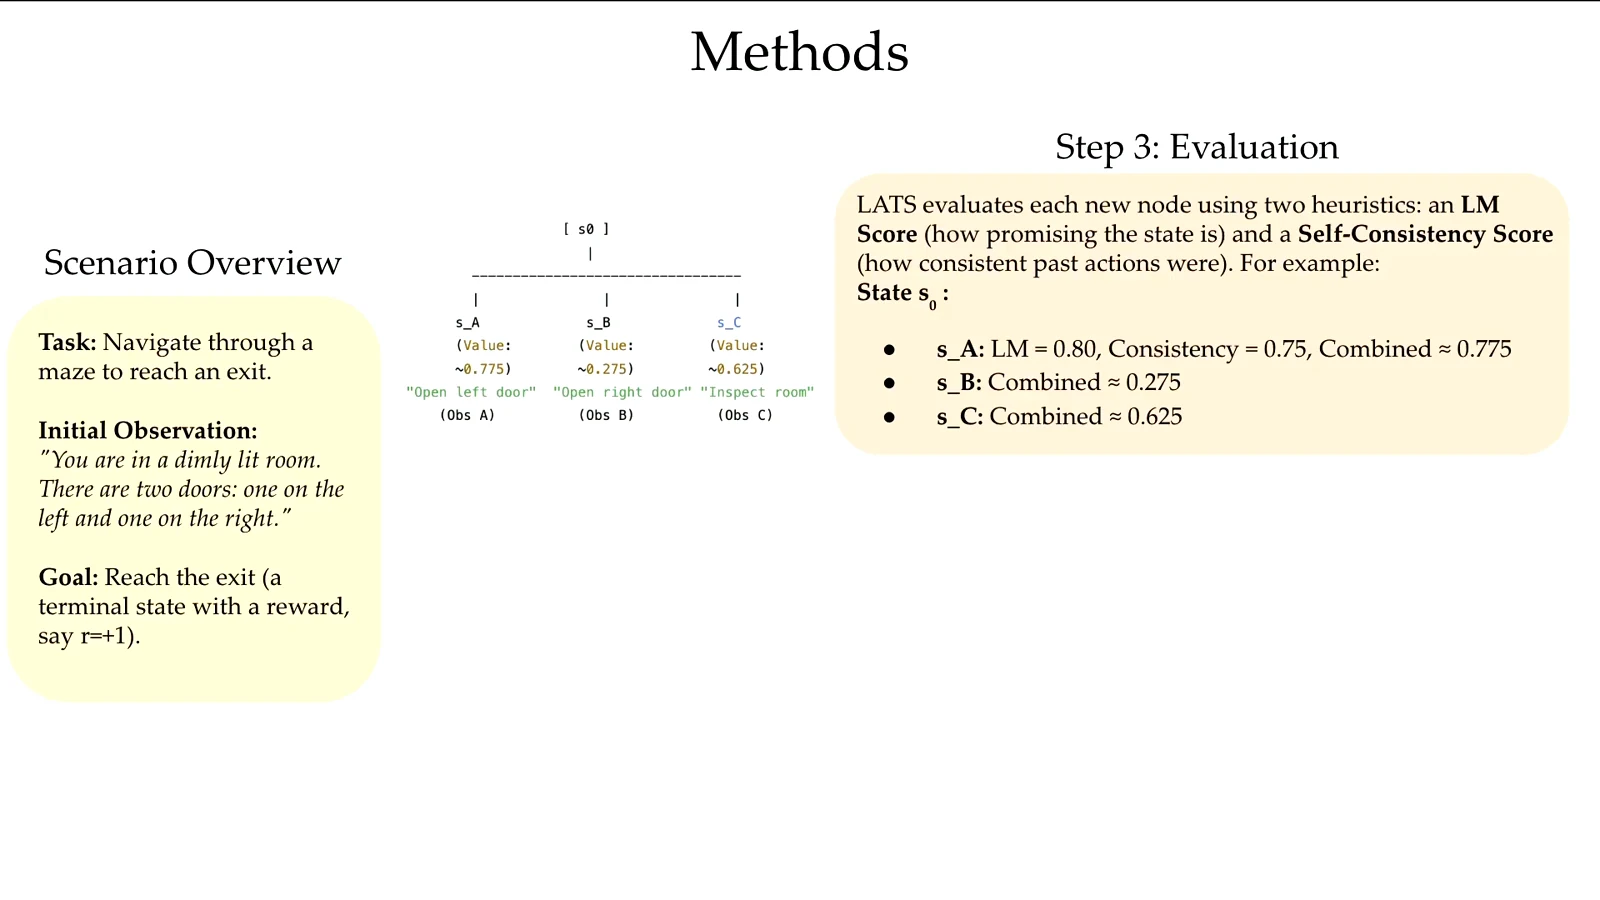
来源:Stanford 官方课程录像 Part 5,10:30;B 站对应位置。
评价结合两个信号:语言模型判断该状态是否有希望完成任务,以及自一致性信号。课堂中的自一致性来自同类行动被采样的频率;它不是事实正确性的独立证明。例如,一条行动的模型评分为 0.8、采样频率为 0.75,等权组合得到 0.775,这个数值只用于演示节点评价。
模拟从候选状态继续执行,直到成功、失败或预算耗尽。得到结果后,将回报沿搜索路径传回,更新访问次数和价值估计。这里的回传更新的是搜索统计量,不是对语言模型参数做梯度反向传播。
UCT 平衡利用与探索
如果始终选择目前评分最高的节点,就可能错过尚未充分尝试的路径。课堂引入 UCT(Upper Confidence Bounds applied to Trees),可以概括为:
V(s) 表示已有的价值估计,N(s) 表示访问次数,c 控制探索强度。第二项提高访问较少分支的探索机会,具体实现还要处理未访问节点。
失败后的语言反思可以描述哪里出错,并进入后续尝试的上下文。但“写了反思”不代表反思正确,真实环境反馈仍然十分重要。对有不可逆副作用的任务,也不能像在可重置迷宫中一样任意展开所有分支。
得分提高不等于完全解决任务
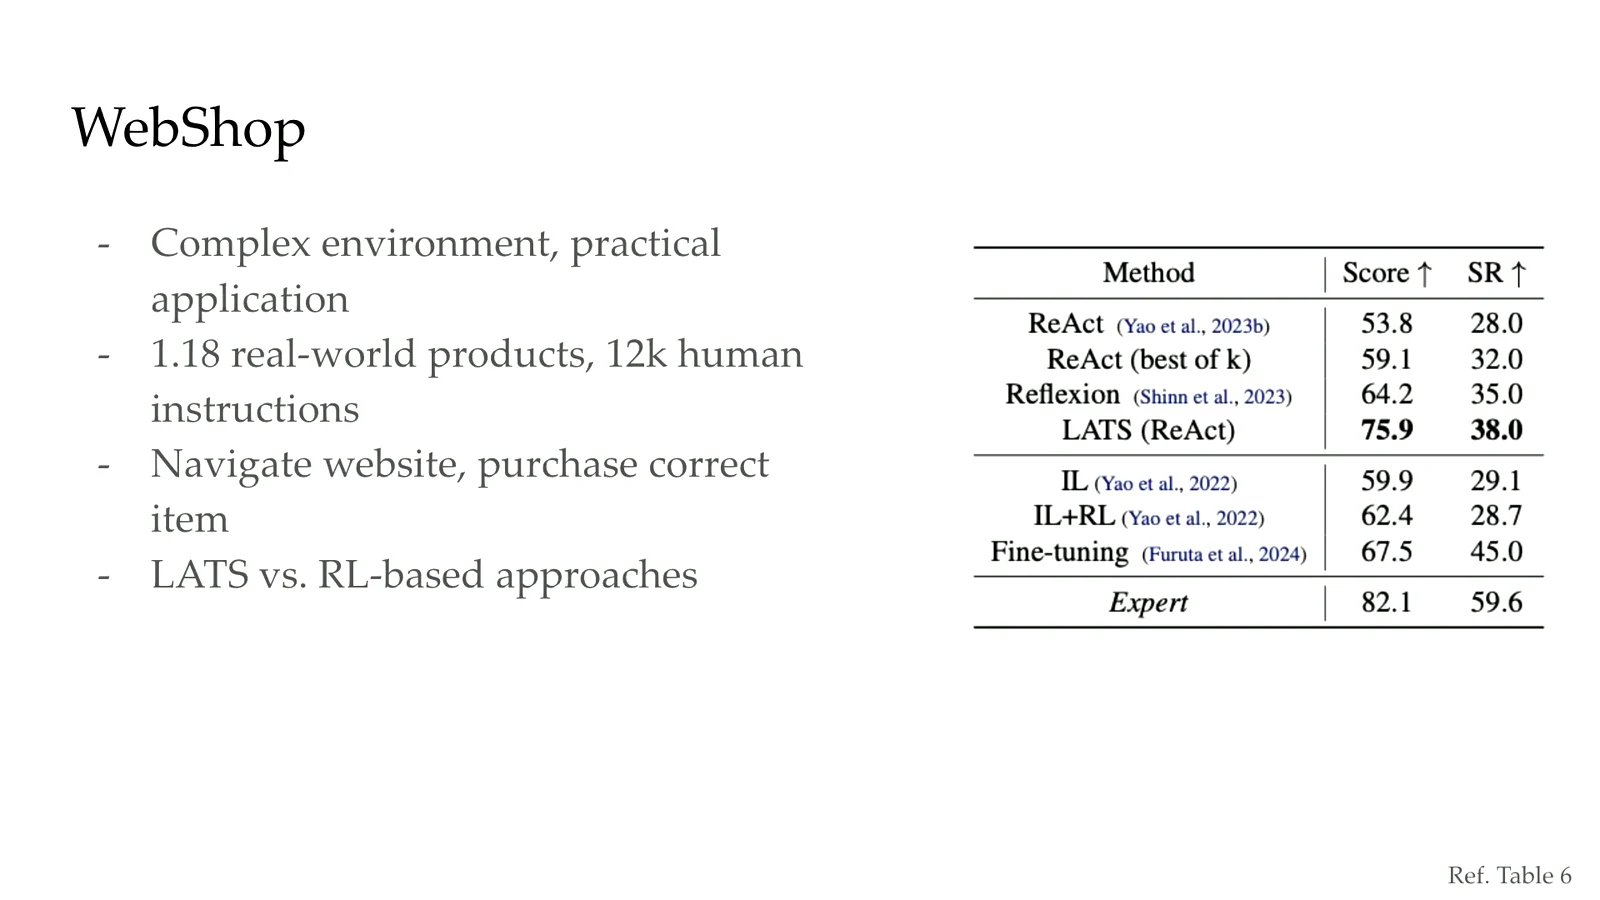
来源:Stanford 官方课程录像 Part 5,18:30;B 站对应位置。
WebShop 的平均分衡量满足了多少属性,成功率要求全部条件满足。课件里,LATS 相比 ReAct 提高了这两个指标,但与专家仍有差距;不同训练方式的系统也不能只凭一个数字判断优劣。搜索预算、工具调用量和环境可重置性都是比较条件。
SPRINT:把规划和执行交错起来
视频约 24 分钟后,课程转向长推理链的延迟。推理模型可能连续生成很多 token,其中有些计算互不依赖,却仍被顺序执行。
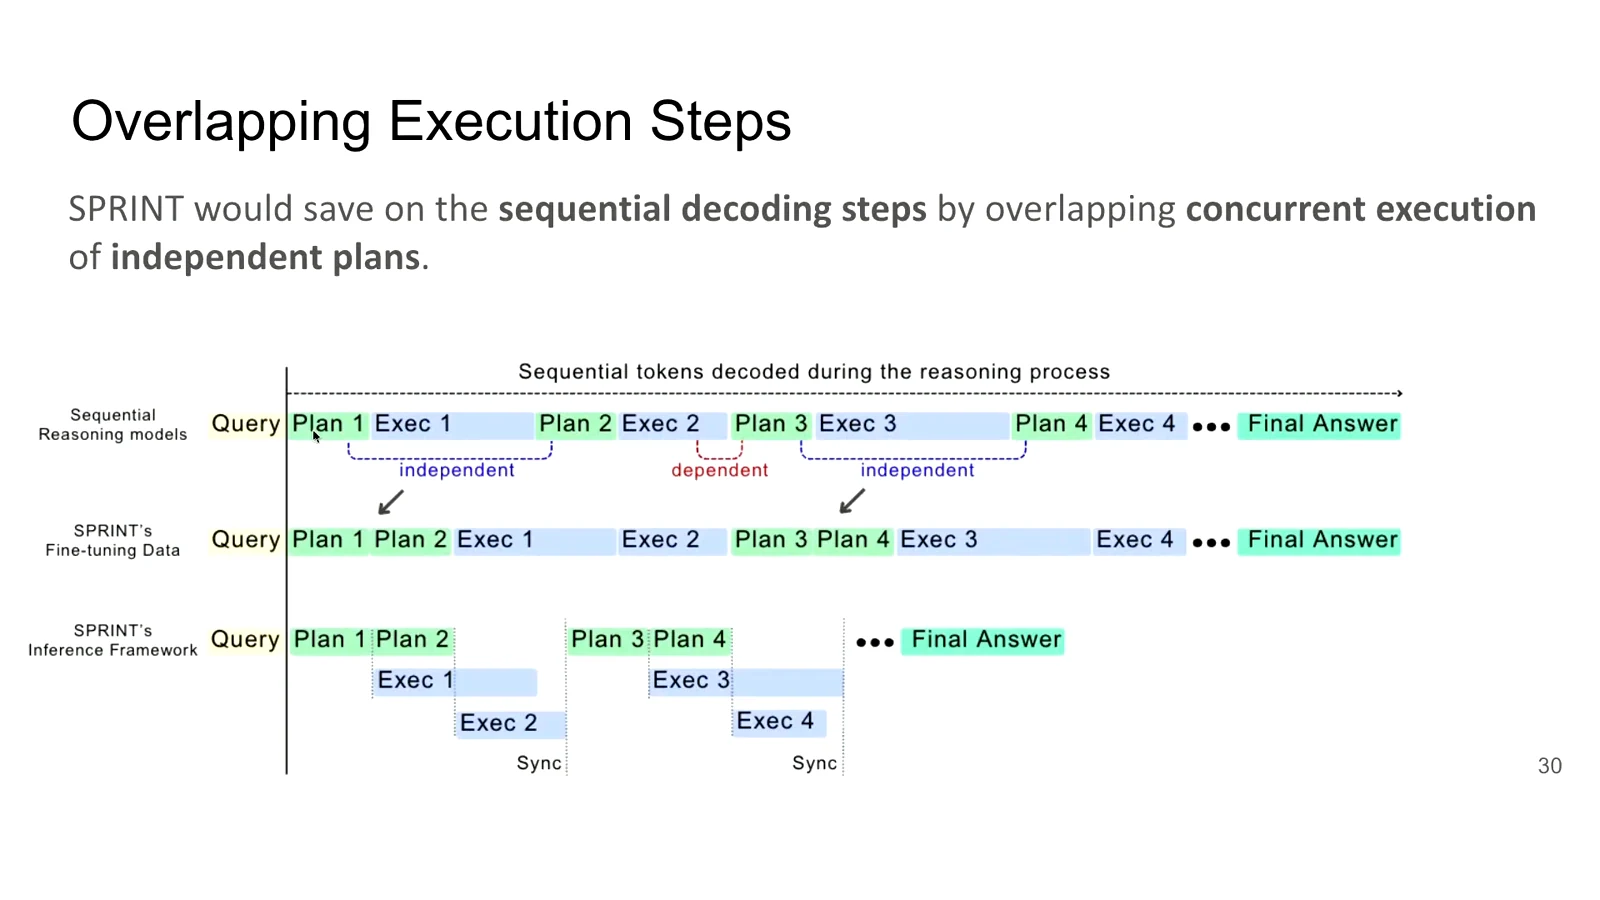
SPRINT 将模型组织为 planner 与多个 executor。规划器描述待执行任务,执行器完成计算;在依赖允许时,规划器继续生成后面的计划,同时让多个执行器工作。
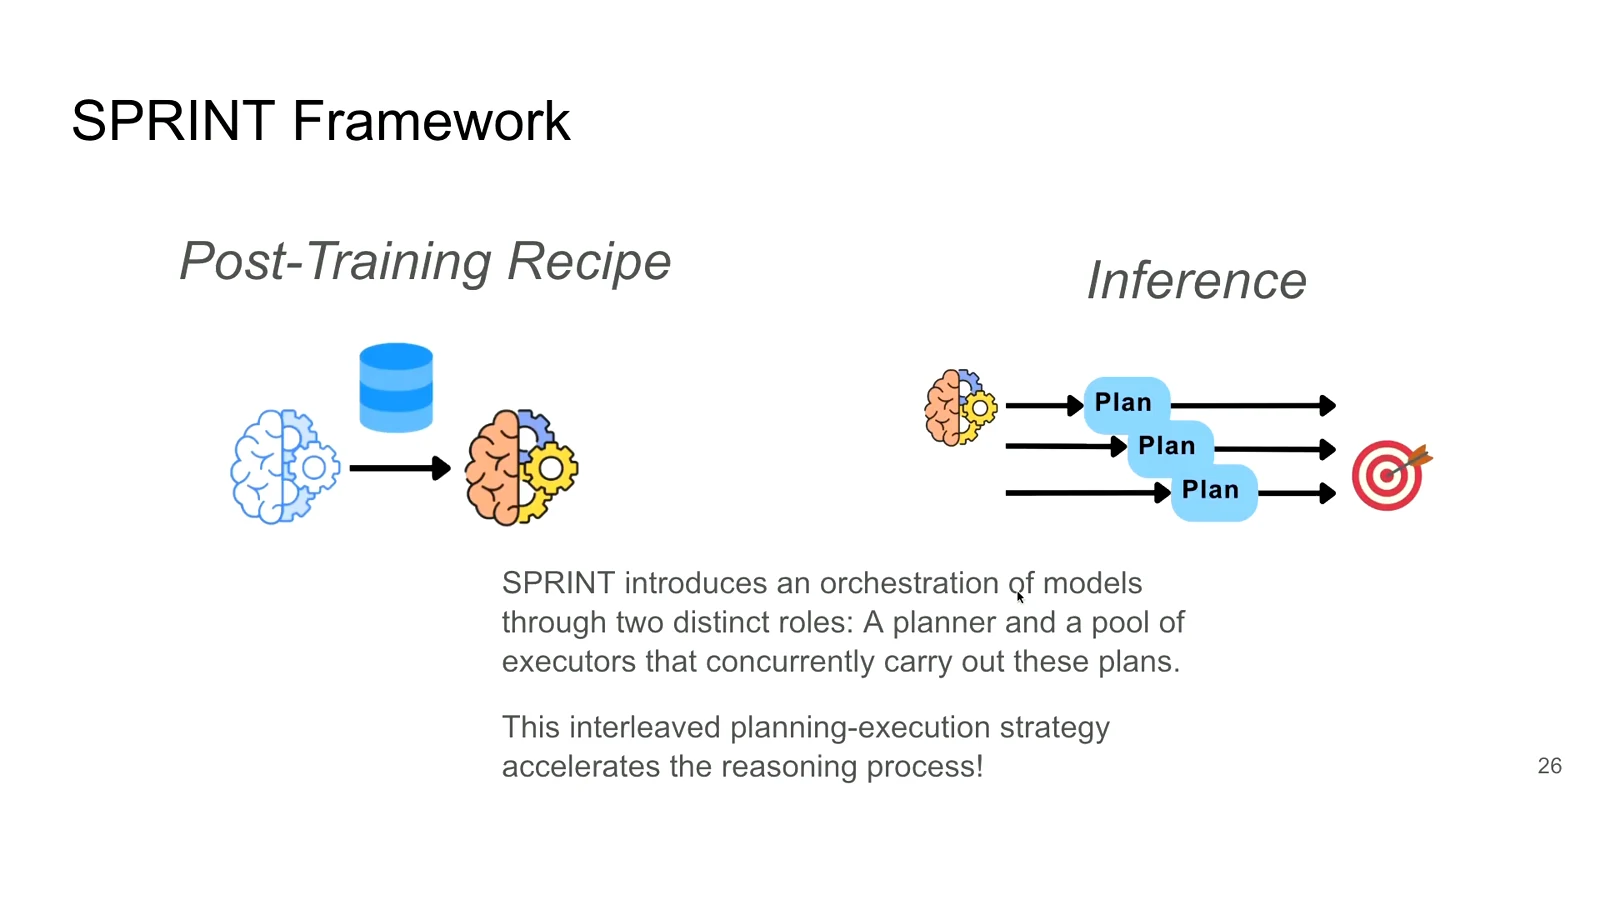
来源:Stanford 官方课程录像 Part 5,26:30;B 站对应位置。
训练数据怎样重排
课程介绍从 DeepSeek-R1 推理轨迹出发,使用模型把轨迹拆为多个步骤,再把每一步区分成规划部分和执行部分。之后分析依赖关系,重排能够并行的执行块,构造用于微调的数据。
这需要模型学习一种不同于长串独立自言自语的生成方式:计划应足够清楚,能够交给执行器;执行结果返回后,又要能继续整合。
来源:Stanford 官方课程录像 Part 5,32:30;B 站对应位置。
图里,传统顺序过程是 Plan 1 → Exec 1 → Plan 2 → Exec 2。如果第二项执行不依赖第一项结果,就可以提前规划并重叠执行。存在依赖的步骤仍然要等待前序结果,不能简单地把全部步骤同时发出。
课件在 MATH500、Countdown、GPQA-Diamond 上比较准确率与顺序解码 token。以图中 MATH500 的一组结果为例,SPRINT 是 92.5% / 2440,RFT 是 91.0% / 2880。这里的 token 数表示顺序路径长度,不能直接当作系统总 token、总 FLOPs 或实测墙钟时间;并行执行仍然消耗资源,并有通信和调度开销。
SWiRL:训练模型做好每一个行动
最后一部分转向多步推理和工具调用的训练。模型需要知道何时调用工具、怎样提出有用的查询、怎样利用观察、何时恢复错误,以及什么时候可以停止。
如果在 RL 训练的每一步都实时调用外部工具,工具延迟、失败和不稳定会影响训练吞吐。SWiRL 将工具轨迹收集和逐步 RL 优化分开。
第一阶段:离线收集多步轨迹
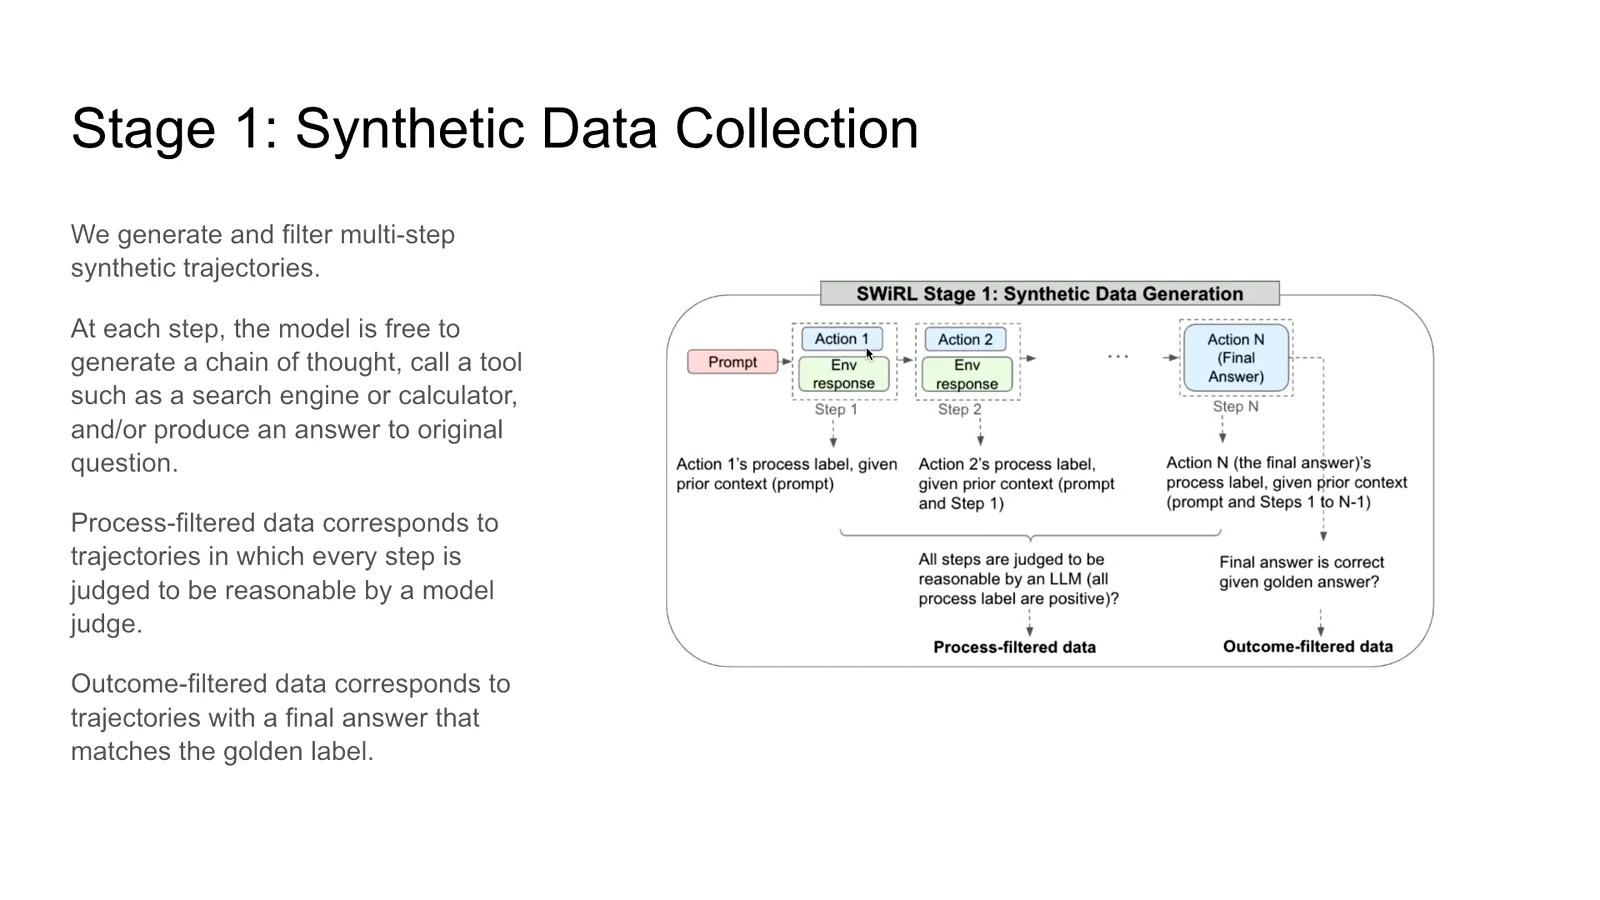
模型可以选择生成推理、调用工具,或输出最终答案。工具的实际返回结果会进入轨迹,作为下一步的上下文。另一个语言模型作为评判者,给行动提供过程分数。
来源:Stanford 官方课程录像 Part 5,56:30;B 站对应位置。
可以依据每一步的质量筛选,也可以只按最终答案是否正确筛选。两种方式保留的数据不同:最终正确的轨迹可能有多余或不恰当步骤,过程良好的轨迹也可能最后算错。
第二阶段:根据历史训练下一行动
来源:Stanford 官方课程录像 Part 5,58:30;B 站对应位置。
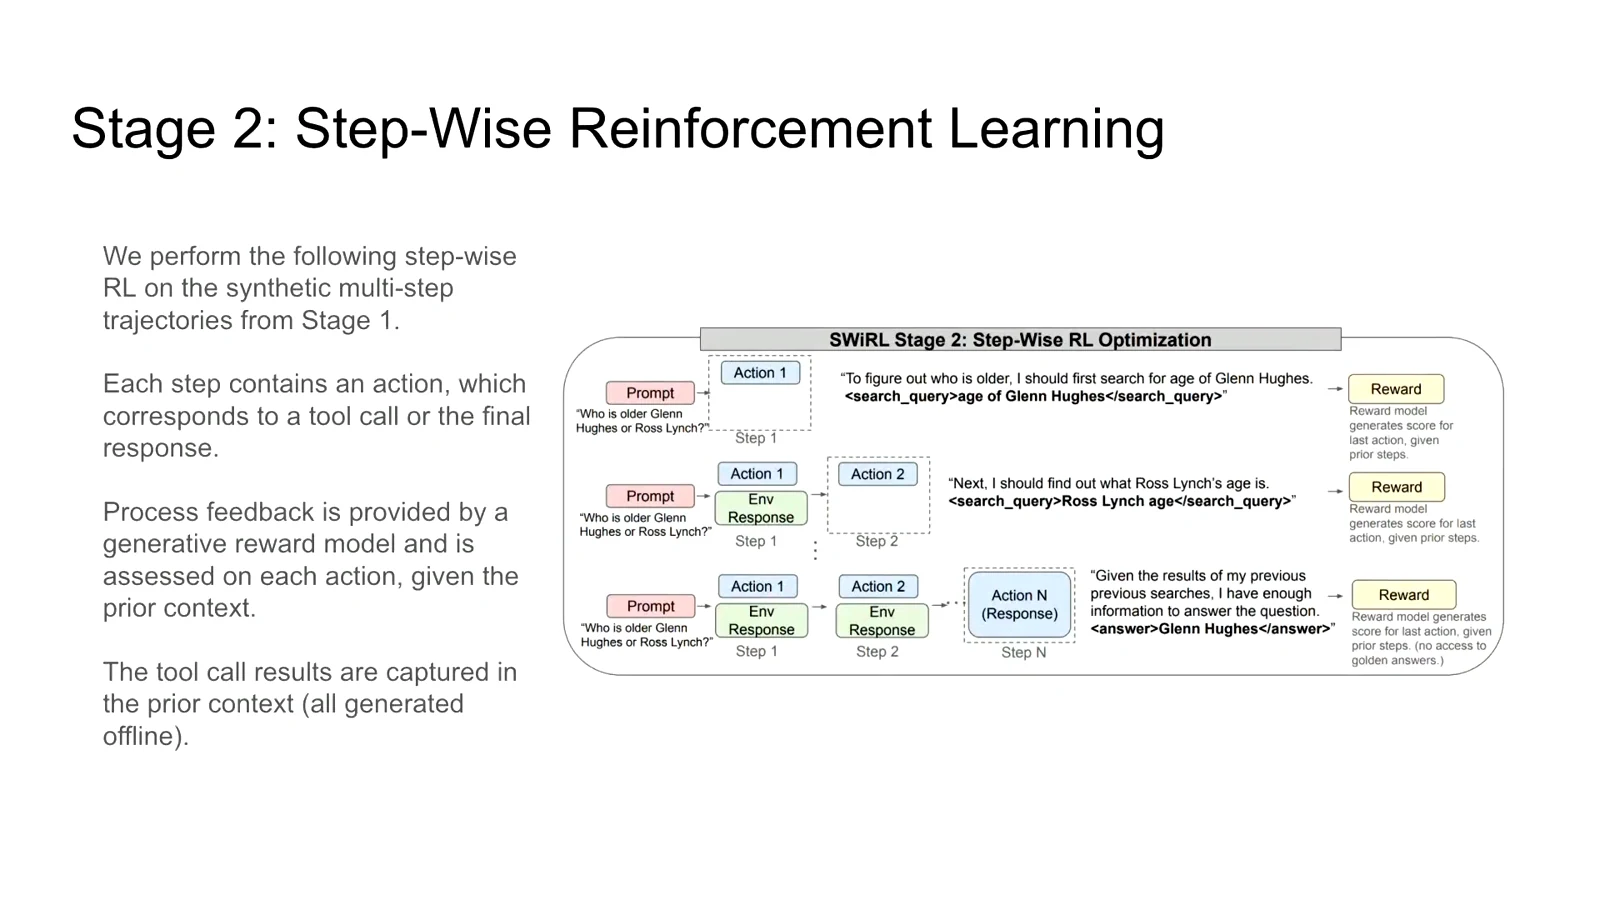
课堂用比较两个人年龄的任务说明。模型先搜索第一个人的年龄,再搜索第二个人,最后比较并回答。对下一次搜索查询,评判者可以先判断“这个查询是否有助于解决当前任务”,不必先知道搜索结果。
训练时,历史工具结果来自已收集的数据,模型在这样的历史上生成下一行动,再根据行动质量进行优化。这里避免的是 RL 优化循环中的实时工具执行,不是完全不需要工具,也不是可以凭空得到真实观察。 工具执行已发生在数据收集阶段。
模型推理时重新与真实工具交互,因此训练数据覆盖、评判者偏差以及历史分布变化都会影响表现。只会在固定历史中提出好查询,不一定代表自主运行时能稳定到达这些历史。
第三阶段:运行多步智能体并检查泛化
训练后的模型循环接收任务、已有行动和观察,决定继续调用工具还是给出最终答案。课件比较了数学与多跳问答中的训练及迁移,观察到过程筛选和逐步 RL 的收益,也对照了监督微调。
这些实验需要分开看训练数据规模、模型、领域与奖励定义,不能把某个问答数据集的提高直接等同于任意智能体都会变好。下一节的训练时扩展与强化学习会继续讨论,怎样让合成数据和奖励真正推动参数更新。