冷启动为什么变成存储问题
Marc Brooker 的 2026 年课件围绕 AWS Lambda 的容器加载和 SnapStart。函数执行前需要代码、依赖、运行时和隔离环境;如果每次都完整下载大型镜像,再启动计算,镜像大小会直接进入冷启动延迟。
课件引用 Slacker 的研究说明,启动阶段通常只访问镜像的一小部分。这里关注的是能否把大镜像变成按需读取的块设备,在应用无感知的情况下,只为真正访问的数据付出传输成本。课件中的历史容量与实验数字用于解释设计,不作为当前产品规格。
从镜像层转成可按需访问的文件系统
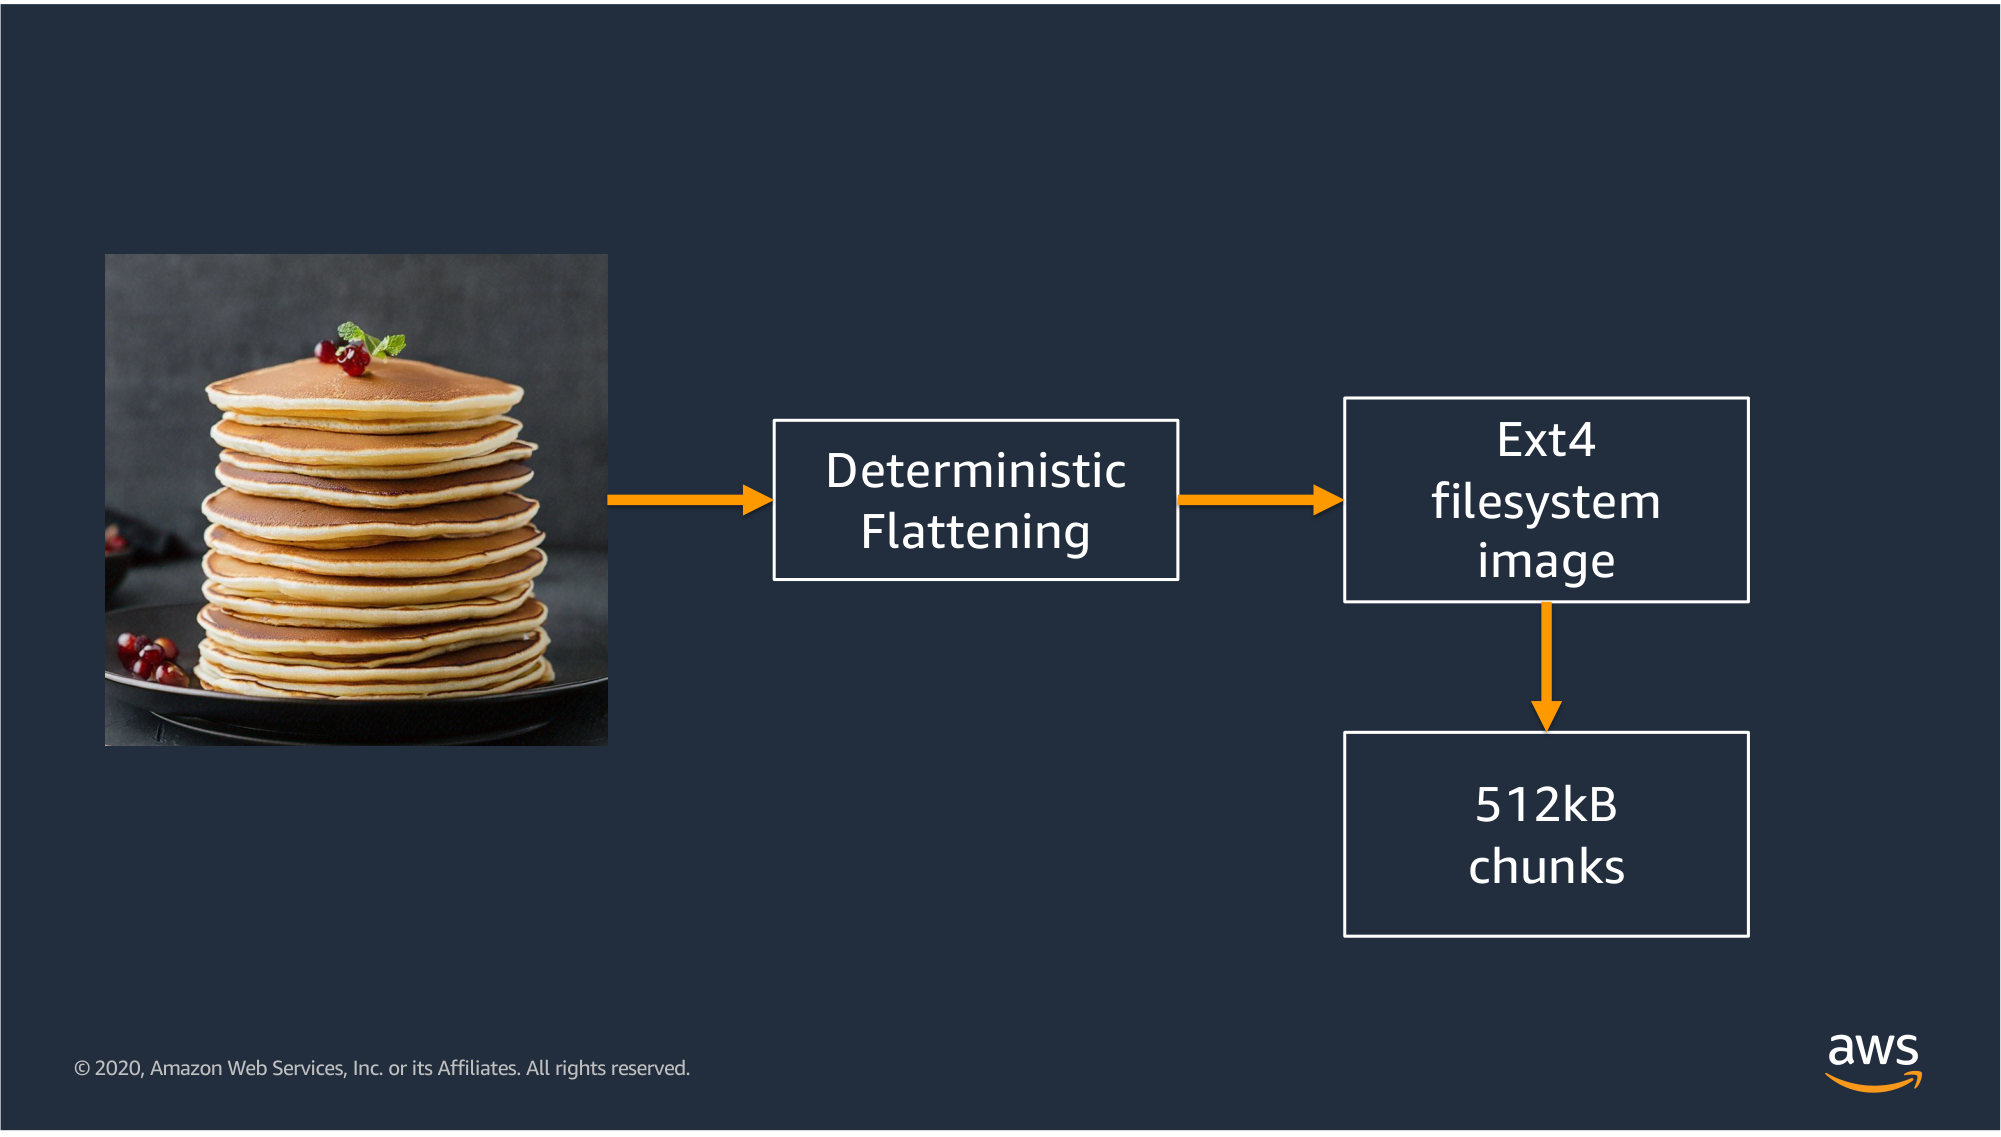
容器镜像由多个层组成,不能直接当作已展开的文件系统块设备。确定性 flattening 把相同内容转为稳定的文件系统布局,再切成课件中的 512 kB chunk,建立 manifest 描述块的位置和读取方式。
Firecracker 为函数提供 microVM,底层块访问进入按需加载路径。应用仍然执行普通文件读取,存储系统则在缺块时从后端取回内容。确定性布局也有助于识别多个镜像共有的数据,减少重复存储和重复缓存。
缓存层次跟随访问热度
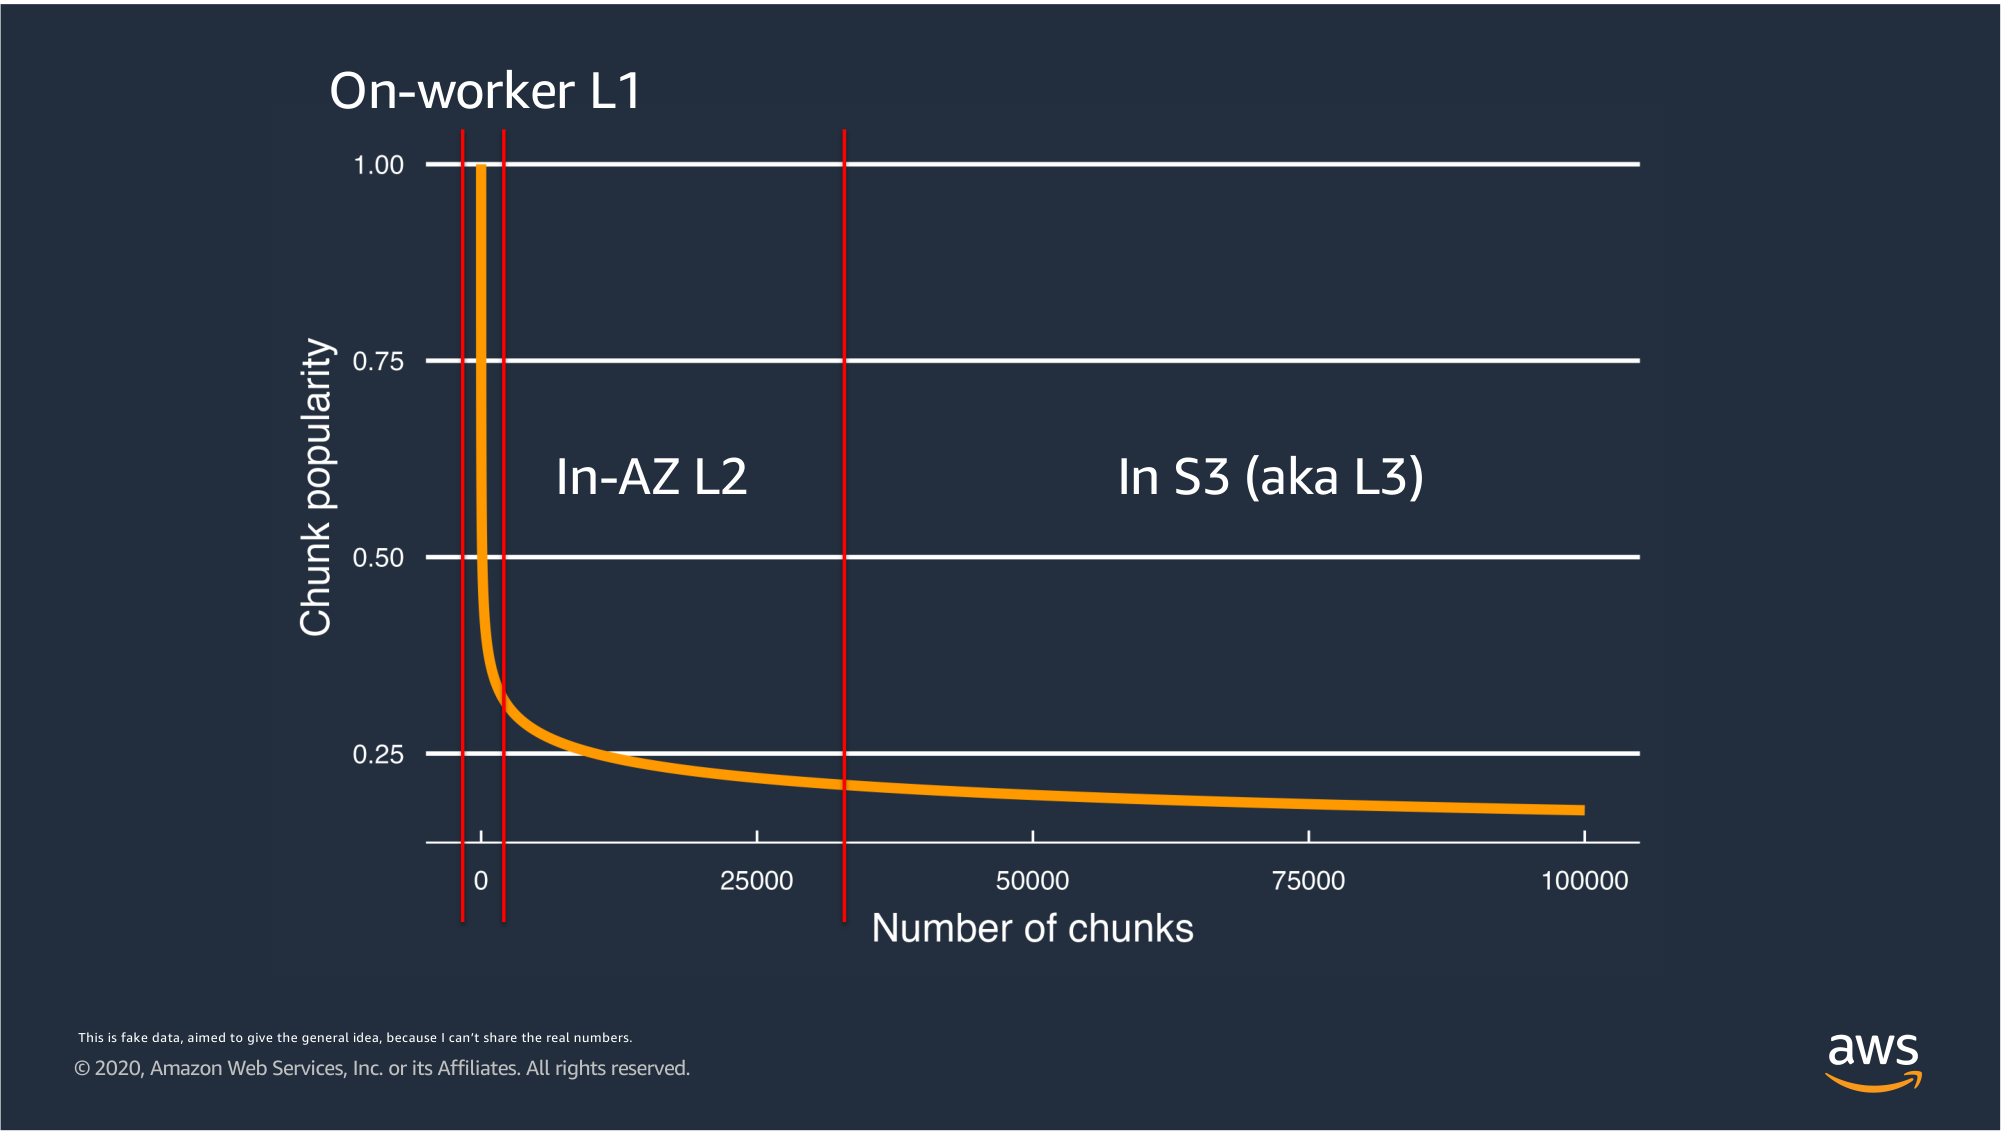
热 chunk 留在 worker 本地 L1,较大共享工作集进入可用区 L2,完整数据由 S3 层保存。图中曲线是讲者用于说明概念的示意数据,不能读取成真实生产容量或命中率。
本地缓存越大,延迟通常越好,但成本也越高。课件借用缓存成本与重新加载成本的比较,再叠加延迟目标:即使某部分数据按成本计算不值得缓存,为了尾延迟也可能需要保留足够容量。
副本、纠删码与尾延迟
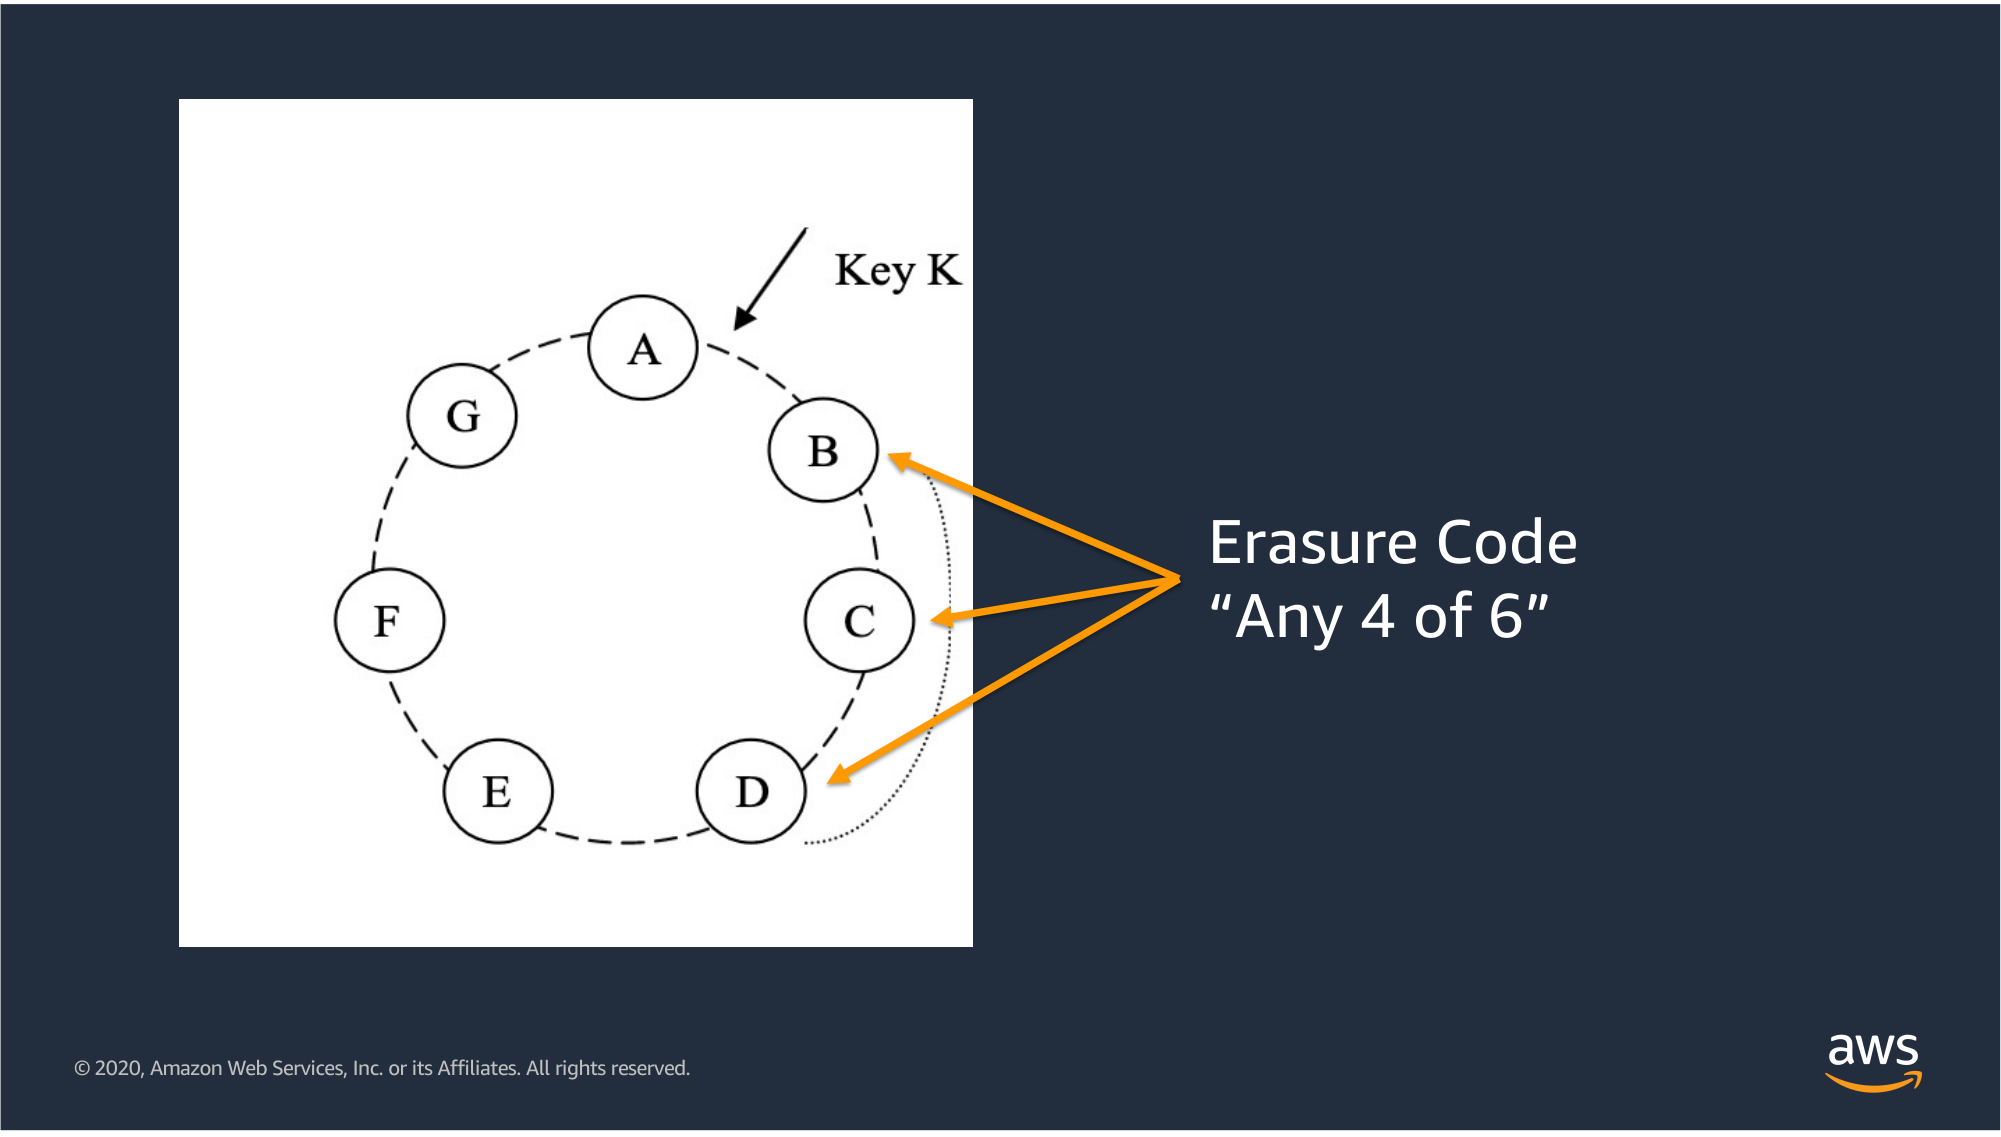
一份缓存容易受节点失效影响,多份完整副本则提高成本。纠删码把数据编码成多片,例如图中任取四片即可重构,在容量与容错之间提供另一种选择。
读取多片时,最慢的响应又可能拉长尾延迟。并发发起超出最低数量的读取,可以在足够片段到达后继续,减少对某一慢节点的依赖,但增加请求流量。不能只比较平均读取速度,还要观察函数冷启动的高分位延迟与失败恢复。
去重还需要租户隔离
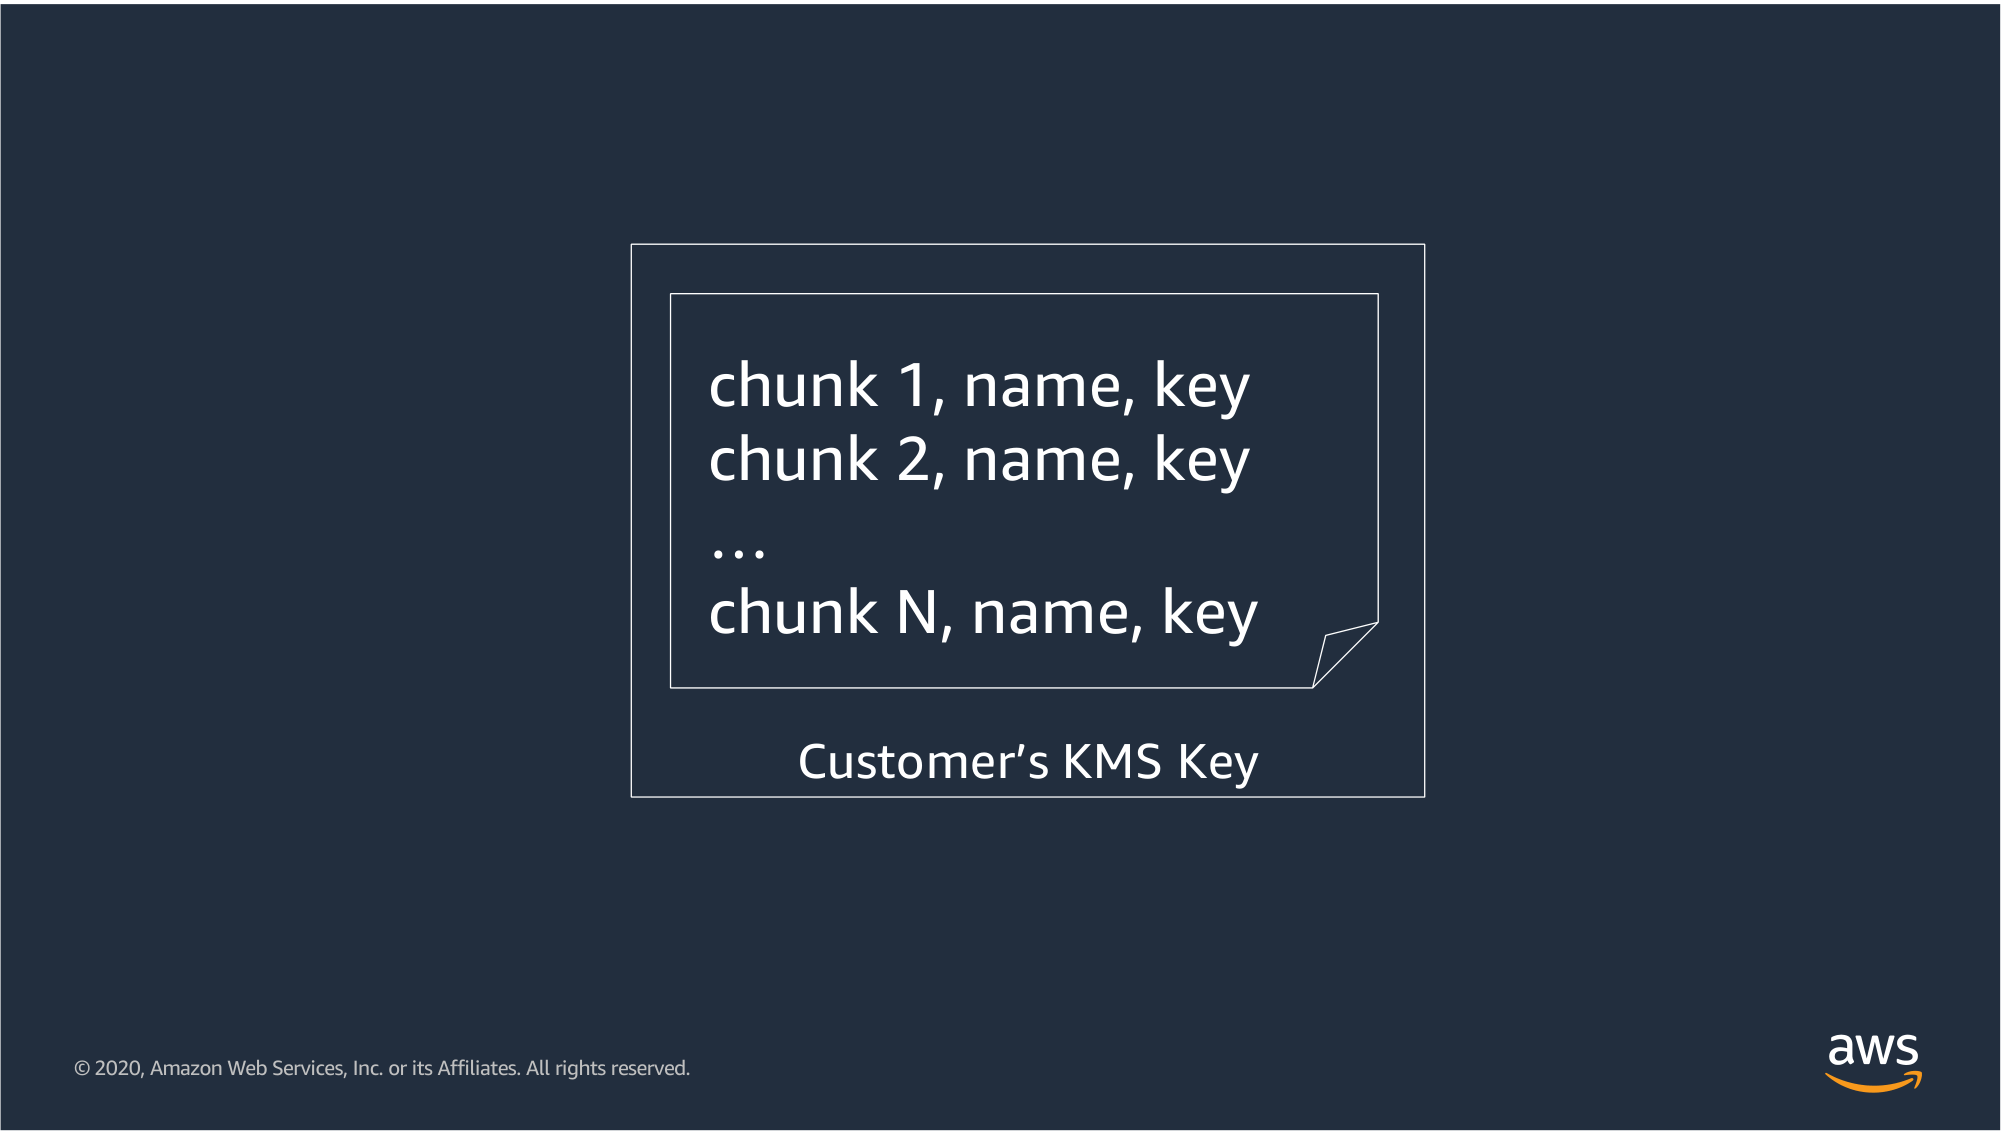
内容寻址便于去重,却不能让任意 worker 凭一个哈希读取其他租户数据。课件把块命名、加密与 manifest 授权放在一起:worker 只获得正在运行函数所需的读取能力,manifest 中的名称和密钥还受到客户密钥体系保护。
课件后段讨论内容派生加密等技术,理解它们时需要同时保留威胁模型;稳定密文与去重之间的关系,不等于任意敏感数据都适合不加限制地按内容共享。
快照启动不能复制所有身份状态
相同思路也可以扩展到内存页:恢复 microVM 快照时按需加载,减少初始化工作。快照还会复制运行时状态,随机数生成器、唯一标识和已有连接等不能在多个恢复实例中不加处理地重复使用。
SnapStart 相关研究因此同时讨论恢复后的唯一性。存储加载缩短了启动时间,隔离与恢复钩子则维持实例应有的身份和状态边界;两部分都需要明确,不能把冷启动优化理解成简单复制一份已经启动好的进程。