课程视频(2021 年公开录像)
从局部失败开始理解分布式系统
MIT 6.5840 关注的是多台计算机共同提供一项服务时,如何处理通信、并发与故障。增加机器可以扩大容量,也可以保存副本,但这些收益都有一个前提:应用能够承受机器之间出现分歧。网络请求没有返回时,我们无法直接判断对方已经宕机,还是请求或回复仍在途中。
课程把这个问题放到存储、事务和计算框架中讨论。容错、一致性与性能会同时影响设计:多等几个副本,可以加强故障后的保证,却增加通信和等待;允许读取旧副本,可以缩短读延迟,却把一部分复杂性留给应用。
用 MapReduce 表达词频统计
第一讲使用 MapReduce 说明框架如何隐藏分布式执行。词频统计的 Map 函数逐个读入单词,输出 (word, 1);Reduce 收到某个单词对应的全部计数,再求和得到结果。应用描述计算,框架负责任务分配、数据传输与失败重试。
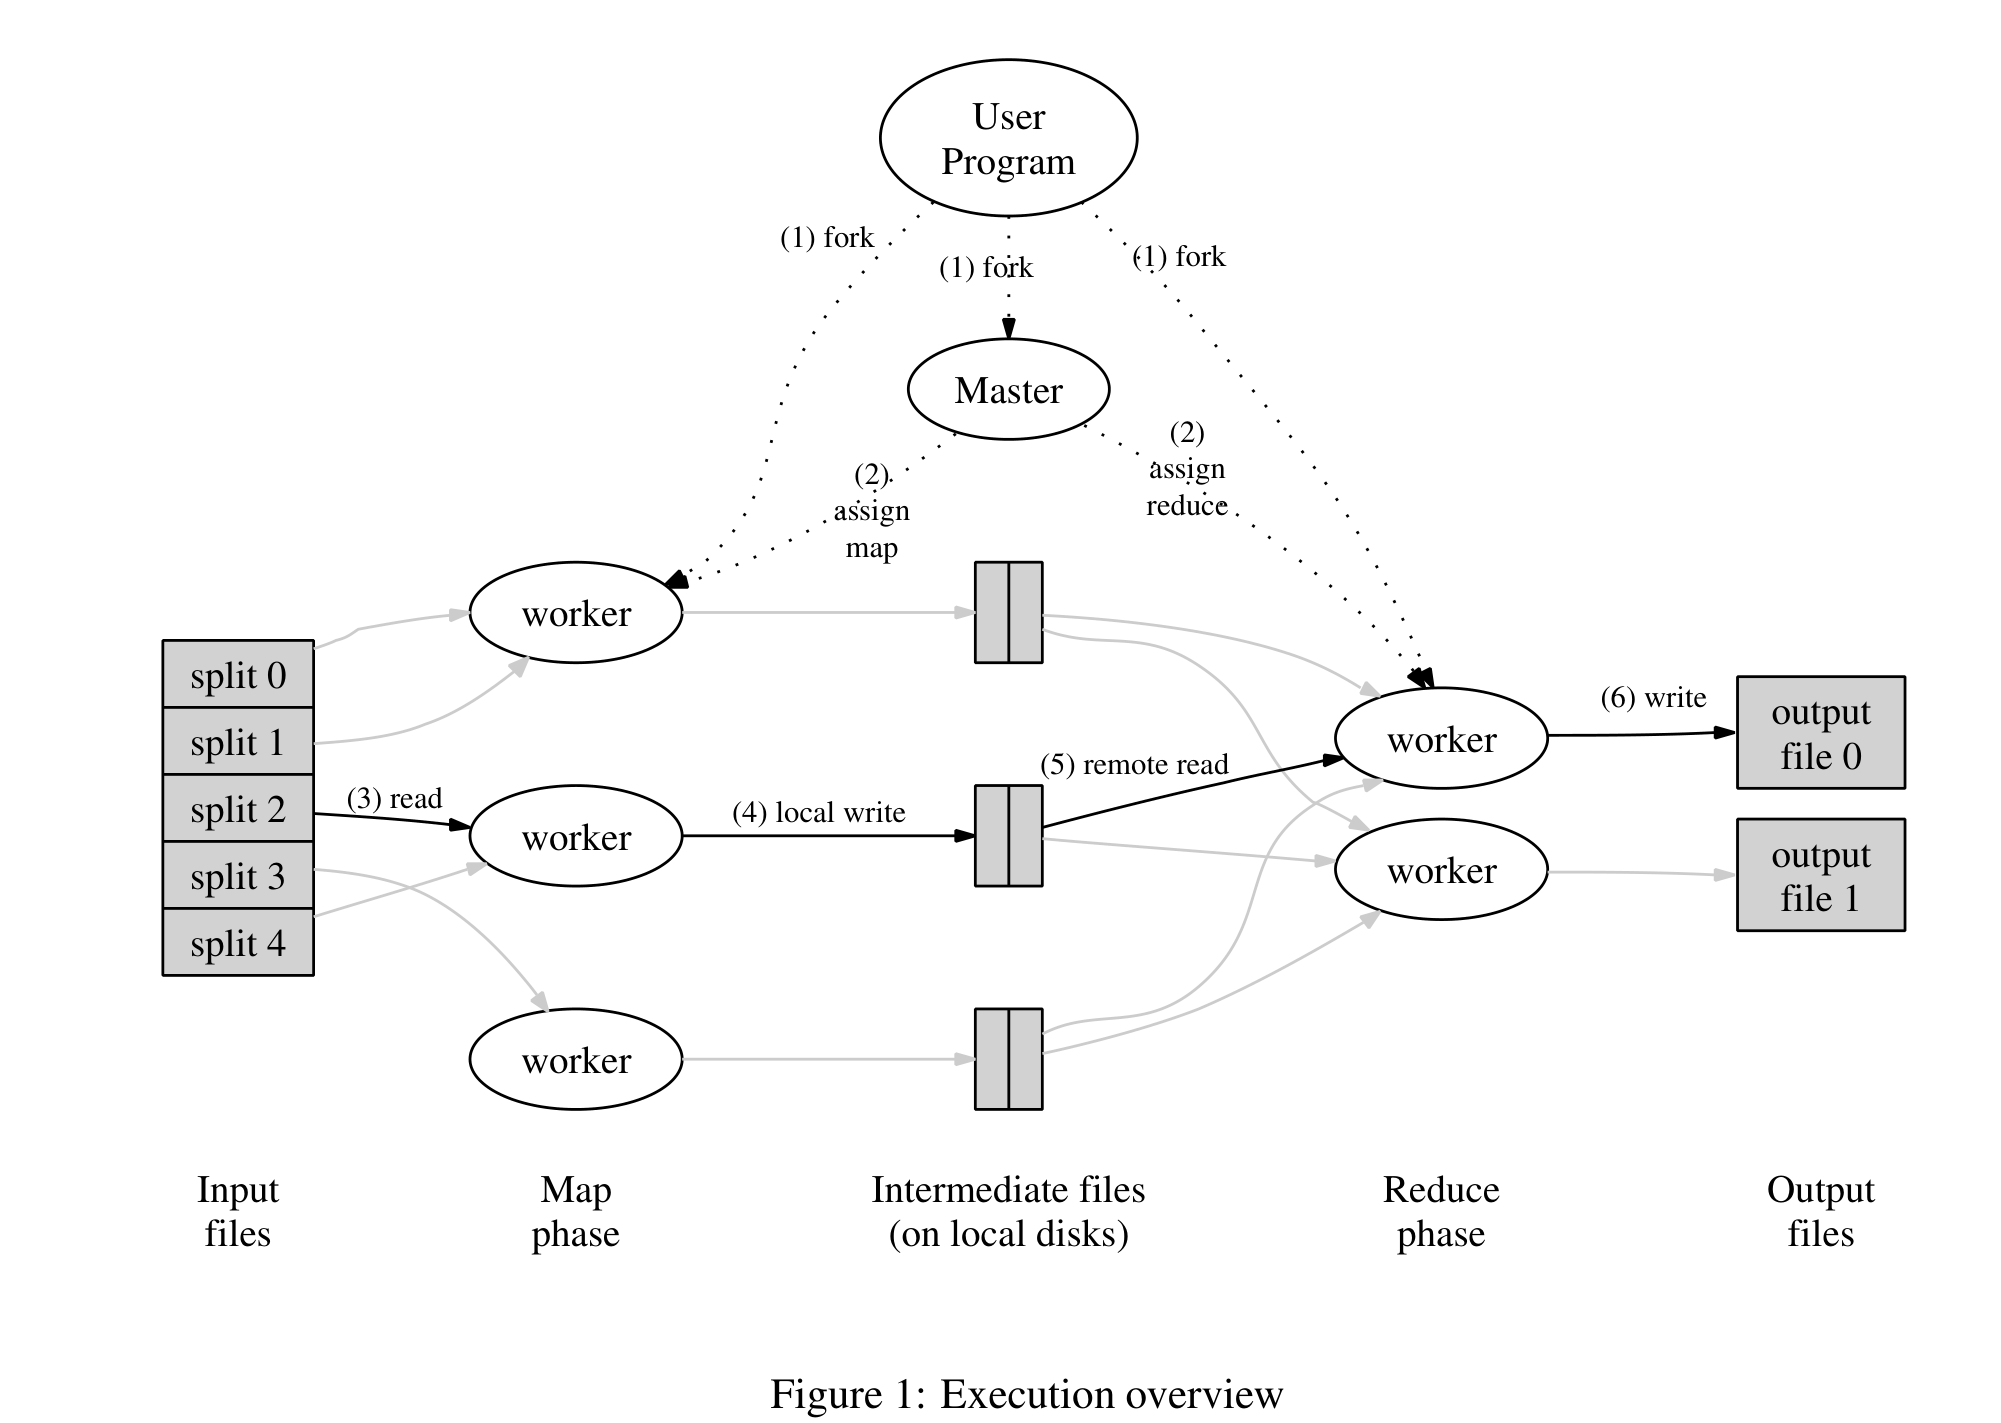
输入分成 M 份,每份对应一个 Map 任务。Map 输出按照 hash(key) mod R 划分到 R 个桶,每个 Reduce 任务从所有 Map worker 获取属于自己的桶,再排序、分组并调用 Reduce。相同 key 必须采用同一分区规则,否则同一个单词会被拆到不同结果中。
中间结果保存在 Map worker 的本地磁盘;最终结果写入 GFS。这里两类文件的容错方式不同:GFS 负责最终文件的复制,中间文件丢失后则重新运行相应 Map 任务。把可以重算的数据全部复制到分布式文件系统,会额外消耗网络带宽。
数据本地性与负载均衡
论文中的网络具有分层结构,跨交换机传输可能成为瓶颈。调度器尽量让 Map 在保存输入 chunk 的机器上运行,使输入读取利用本地磁盘;shuffle 仍需通过网络把中间结果送到 Reduce。增加 worker 之前,需要分清限制来自 CPU、磁盘还是网络。
任务数通常大于 worker 数。某台机器完成任务后继续领取新任务,速度快的机器自然承担更多工作,比固定给每台机器分配一大块输入更容易平衡负载。作业接近结束时,少量慢任务仍可能拖住全部结果,因此论文对最后的任务启动备用执行,以先完成的一份为准。
重试为什么不会改变结果
worker 失败后,协调器重新安排受影响的任务。一个 Map 任务可能运行两次,而不同 Reduce 可能看到不同次执行的输出,因此确定性的 Map 和 Reduce 对故障透明非常重要。若函数依赖随机数、外部状态或不可重放的副作用,重算就可能改变作业含义。
重复 Reduce 还涉及输出发布:不能让两个执行把最终文件交错写坏。论文使用临时文件与原子重命名,让外部看到完整的一份结果。这里解决的是结果的可见性,不能据此推断任意外部副作用也具有“恰好一次”语义。
MapReduce 通过限制计算形态换取简单的并行和恢复:任务之间主要通过中间数据联系,适合批处理,不适合把任意交互程序直接搬到集群。Lab 1 从这个受约束的模型起步,后续实验再逐步加入不可靠网络、共识、复制和分片。