课程视频(2021 年公开录像)
GFS 面向什么工作负载
GFS 论文讨论的是 2003 年 Google 内部的大文件存储。系统由大量普通机器组成,硬件失败是持续发生的事件;应用主要顺序读取大文件、追加记录,而不是把它当作通用本地文件系统使用。理解这些前提,才能判断 64 MB chunk、单个 master 和较弱写入语义为什么适合当时的任务。
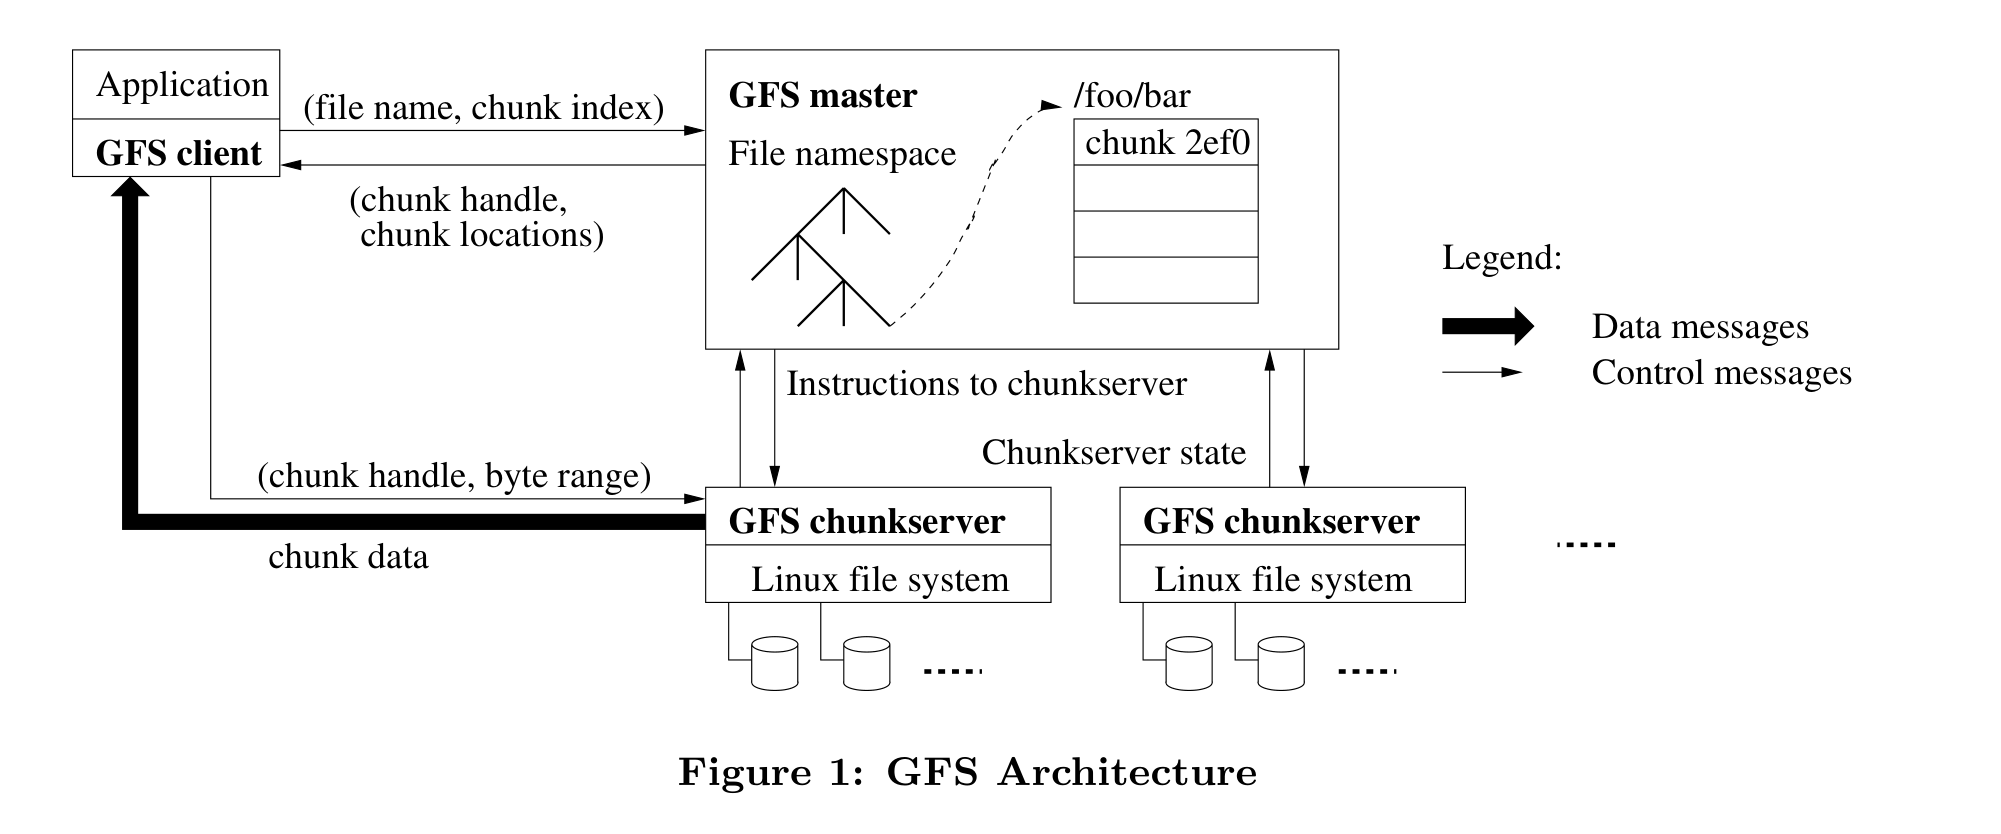
文件被切成 chunk,分散到 chunkserver,通常保存三个副本。master 管理文件名到 chunk handle 的映射、版本和副本位置,客户端先查询元数据,再直接访问 chunkserver。大块数据不经过 master,客户端缓存位置,减少控制节点的负担。
读请求与写请求走不同路径
读操作先把文件偏移换算成 chunk,再选择一个副本读取。写入则需要让副本按相同顺序处理并发修改:master 为 chunk 指定 primary,其余副本为 secondary,primary 决定修改顺序。
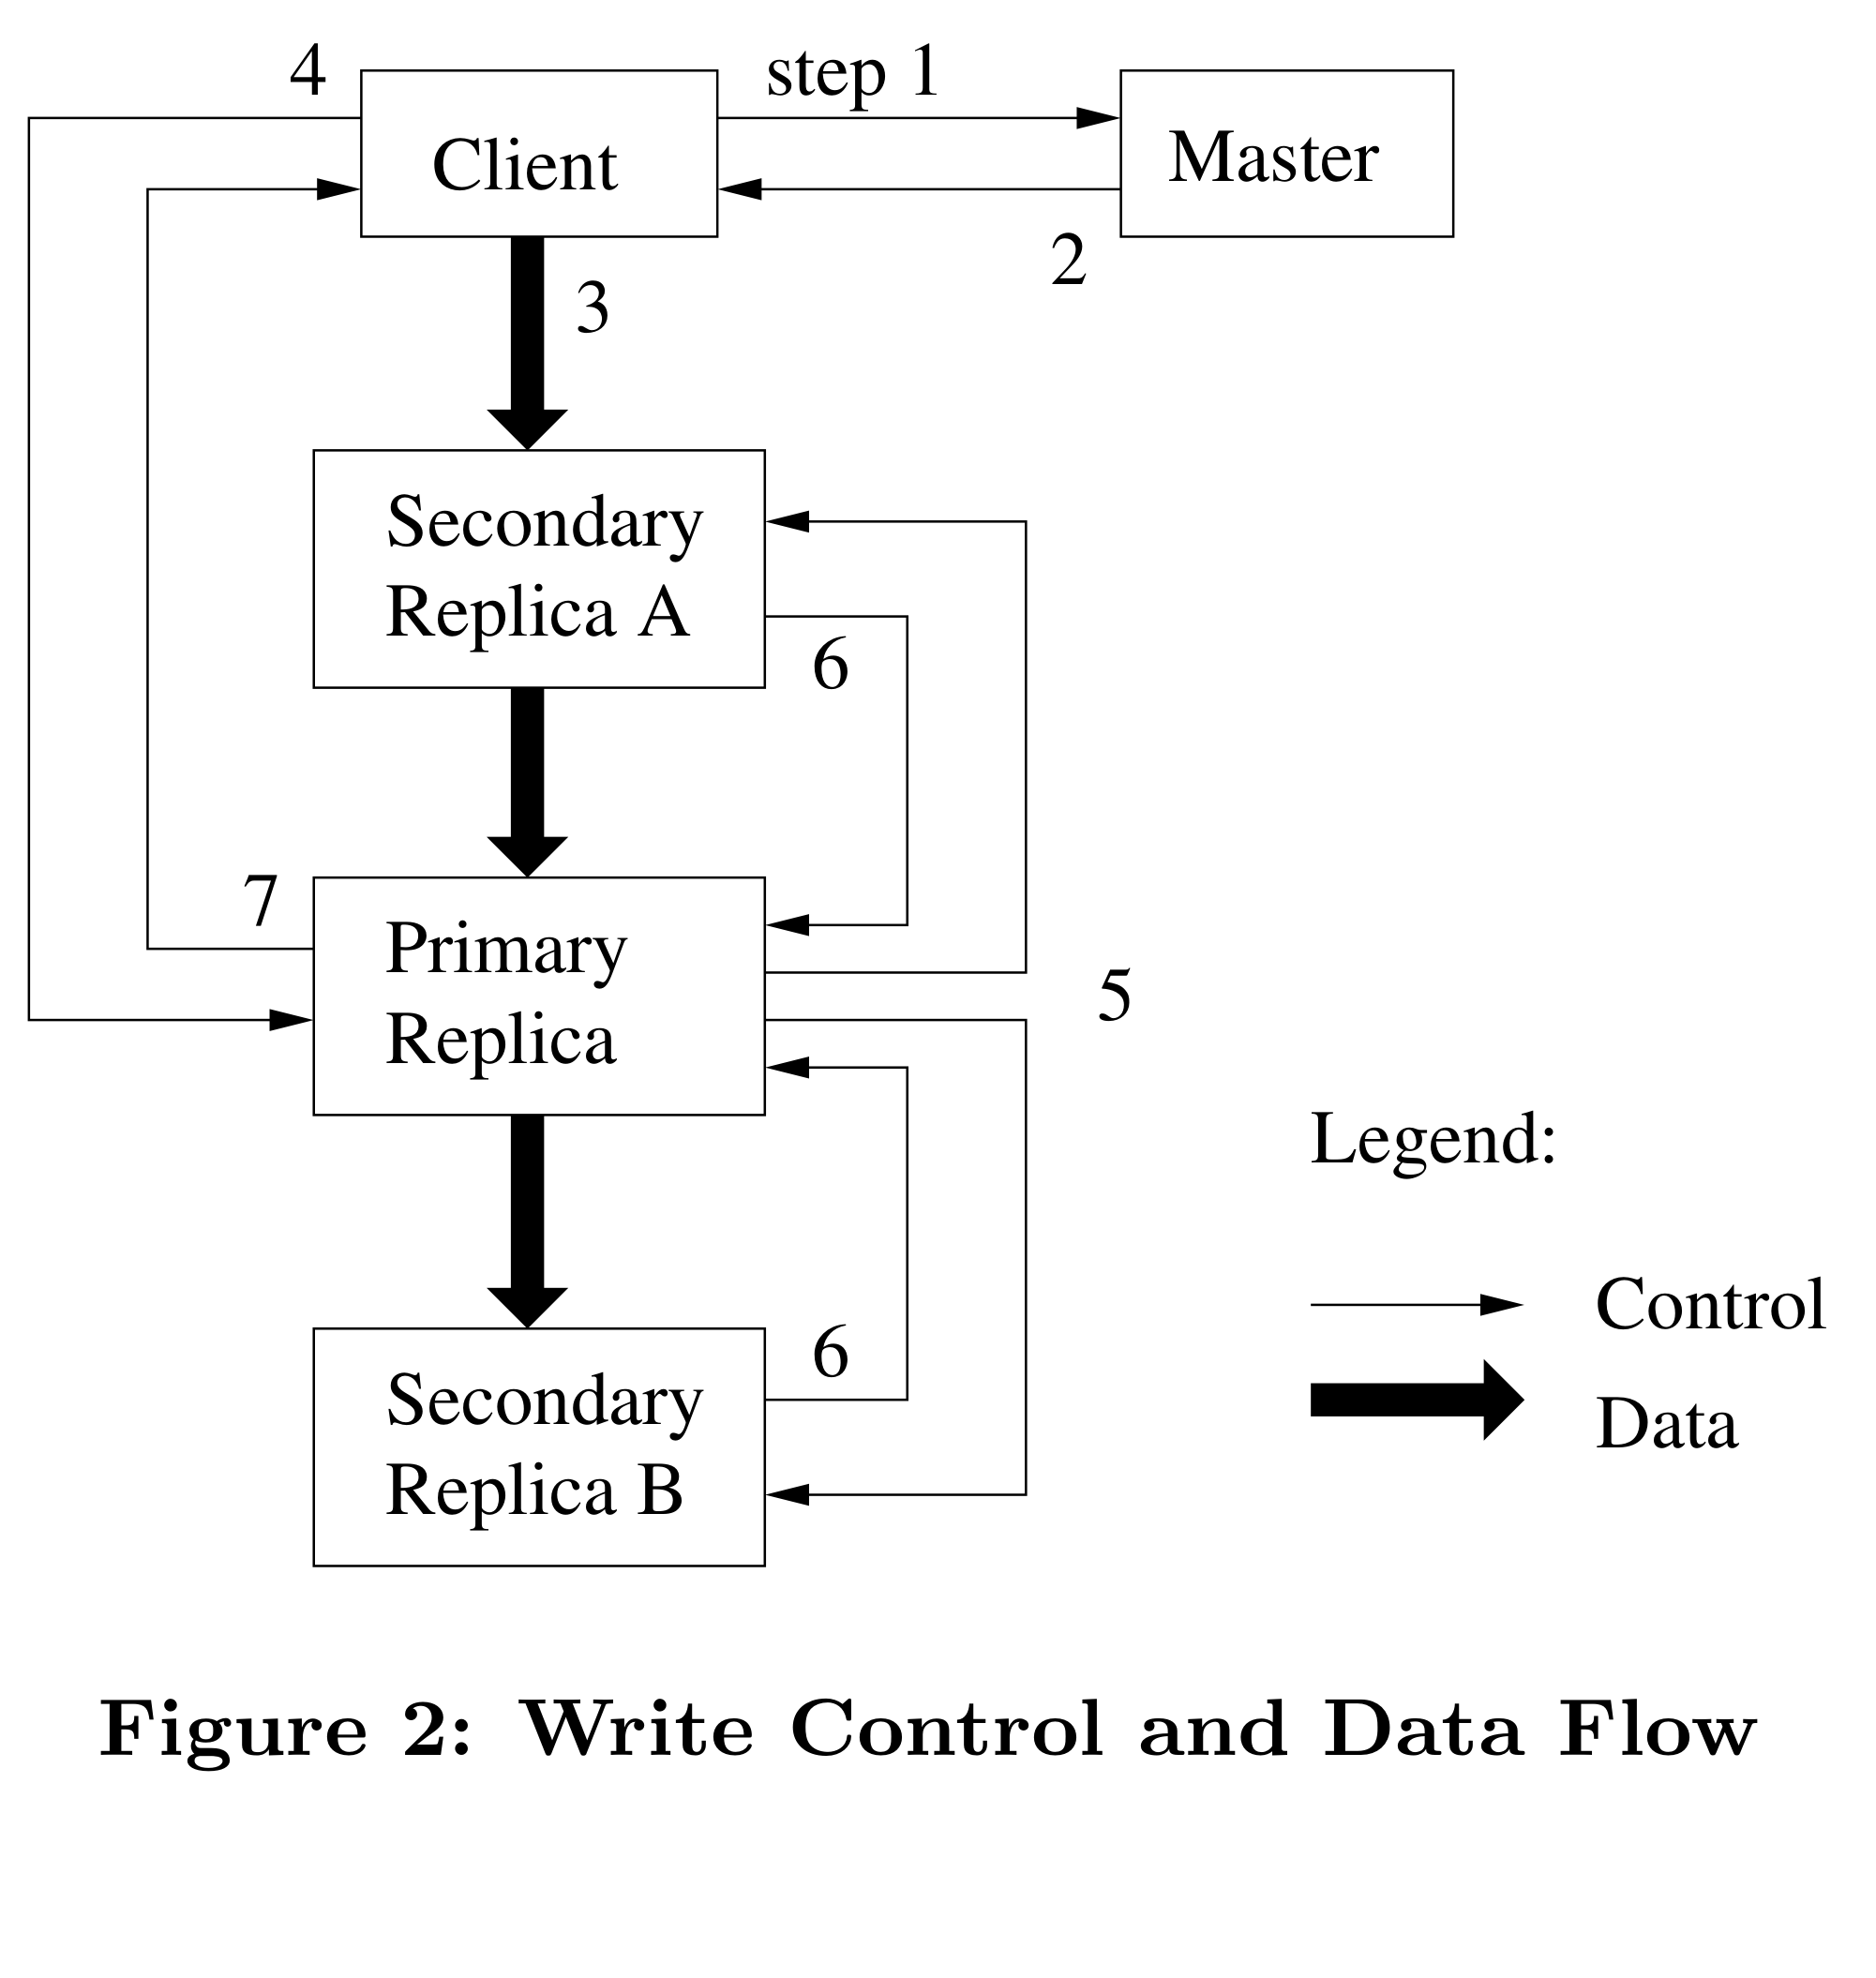
客户端先把数据推送到所有副本的临时缓冲区,随后请求 primary 执行修改。primary 分配顺序,通知 secondary 按相同顺序落地,收集回复后再告诉客户端结果。数据流可以按网络拓扑组成流水线,控制流仍由 primary 决定,两者没有必要采用相同路径。
如果 primary 已写入而某个 secondary 未完成,客户端可能收到失败,但部分数据已经改变。失败回复不能当作修改从未发生,直接从不同副本读取也可能得到不同内容。
Record Append 保证了什么
普通跨 chunk 写入会被拆成多个修改,并发写可能让文件最终包含来自不同请求的片段。Record Append 让 primary 选择偏移,使一条成功追加的记录在某处完整出现;记录跨不过当前 chunk 的剩余空间时,系统可能填充后转到下一个 chunk。
失败重试可能留下重复记录、填充或不一致片段。因此应用仍需用记录 ID、校验和等办法识别有效数据并去重。Append 的“原子”不能理解为整个文件拥有事务语义,也不表示调用返回失败后文件一定保持原样。
用租约避免两个 primary
master 授予 primary 有限时长的 lease。primary 必须在租约到期前停止接受相应写入,master 也必须等待旧租约失效后才能任命替代者。这样即使旧 primary 只是网络隔离,系统也不会简单地把“没回复”解释成已经停止。
租约依赖时钟与到期规则;它缩短了反复查询 master 的成本,也让故障切换需要等待。缓存旧位置的客户端请求失败后重新查询,chunk 版本号则帮助 master 排除过期副本,避免旧数据重新成为正常副本。
master 恢复与重新复制
master 把关键命名空间、chunk 映射和版本变化记录到持久日志,并建立 checkpoint;副本位置可以在恢复时向 chunkserver 查询。重启后仍需处理尚未过期的旧 lease。元数据持久化与自动选择新 master 是不同问题,原论文没有给出后来共识系统那样完整的自动切换设计。
chunkserver 丢失后,剩余副本用于重新复制。恢复窗口内,系统处于较低冗余状态,复制速度、前台负载和再次故障风险需要一起考虑。GFS 把复制、租约和应用可接受的一致性组合起来;下一讲 Paxos 则进一步解决控制节点如何在失败后达成统一决定。