课程视频(2021 年公开录像)
从日志分叉检查安全性
第二讲 Raft 从故障重连开始。旧 leader 与多数断开后,可以在本地积累尚未提交的条目;另一侧选出新 leader,并在同一位置提交不同命令。旧节点恢复后,日志较长不代表它更正确,新 leader 必须修复它的未提交后缀。
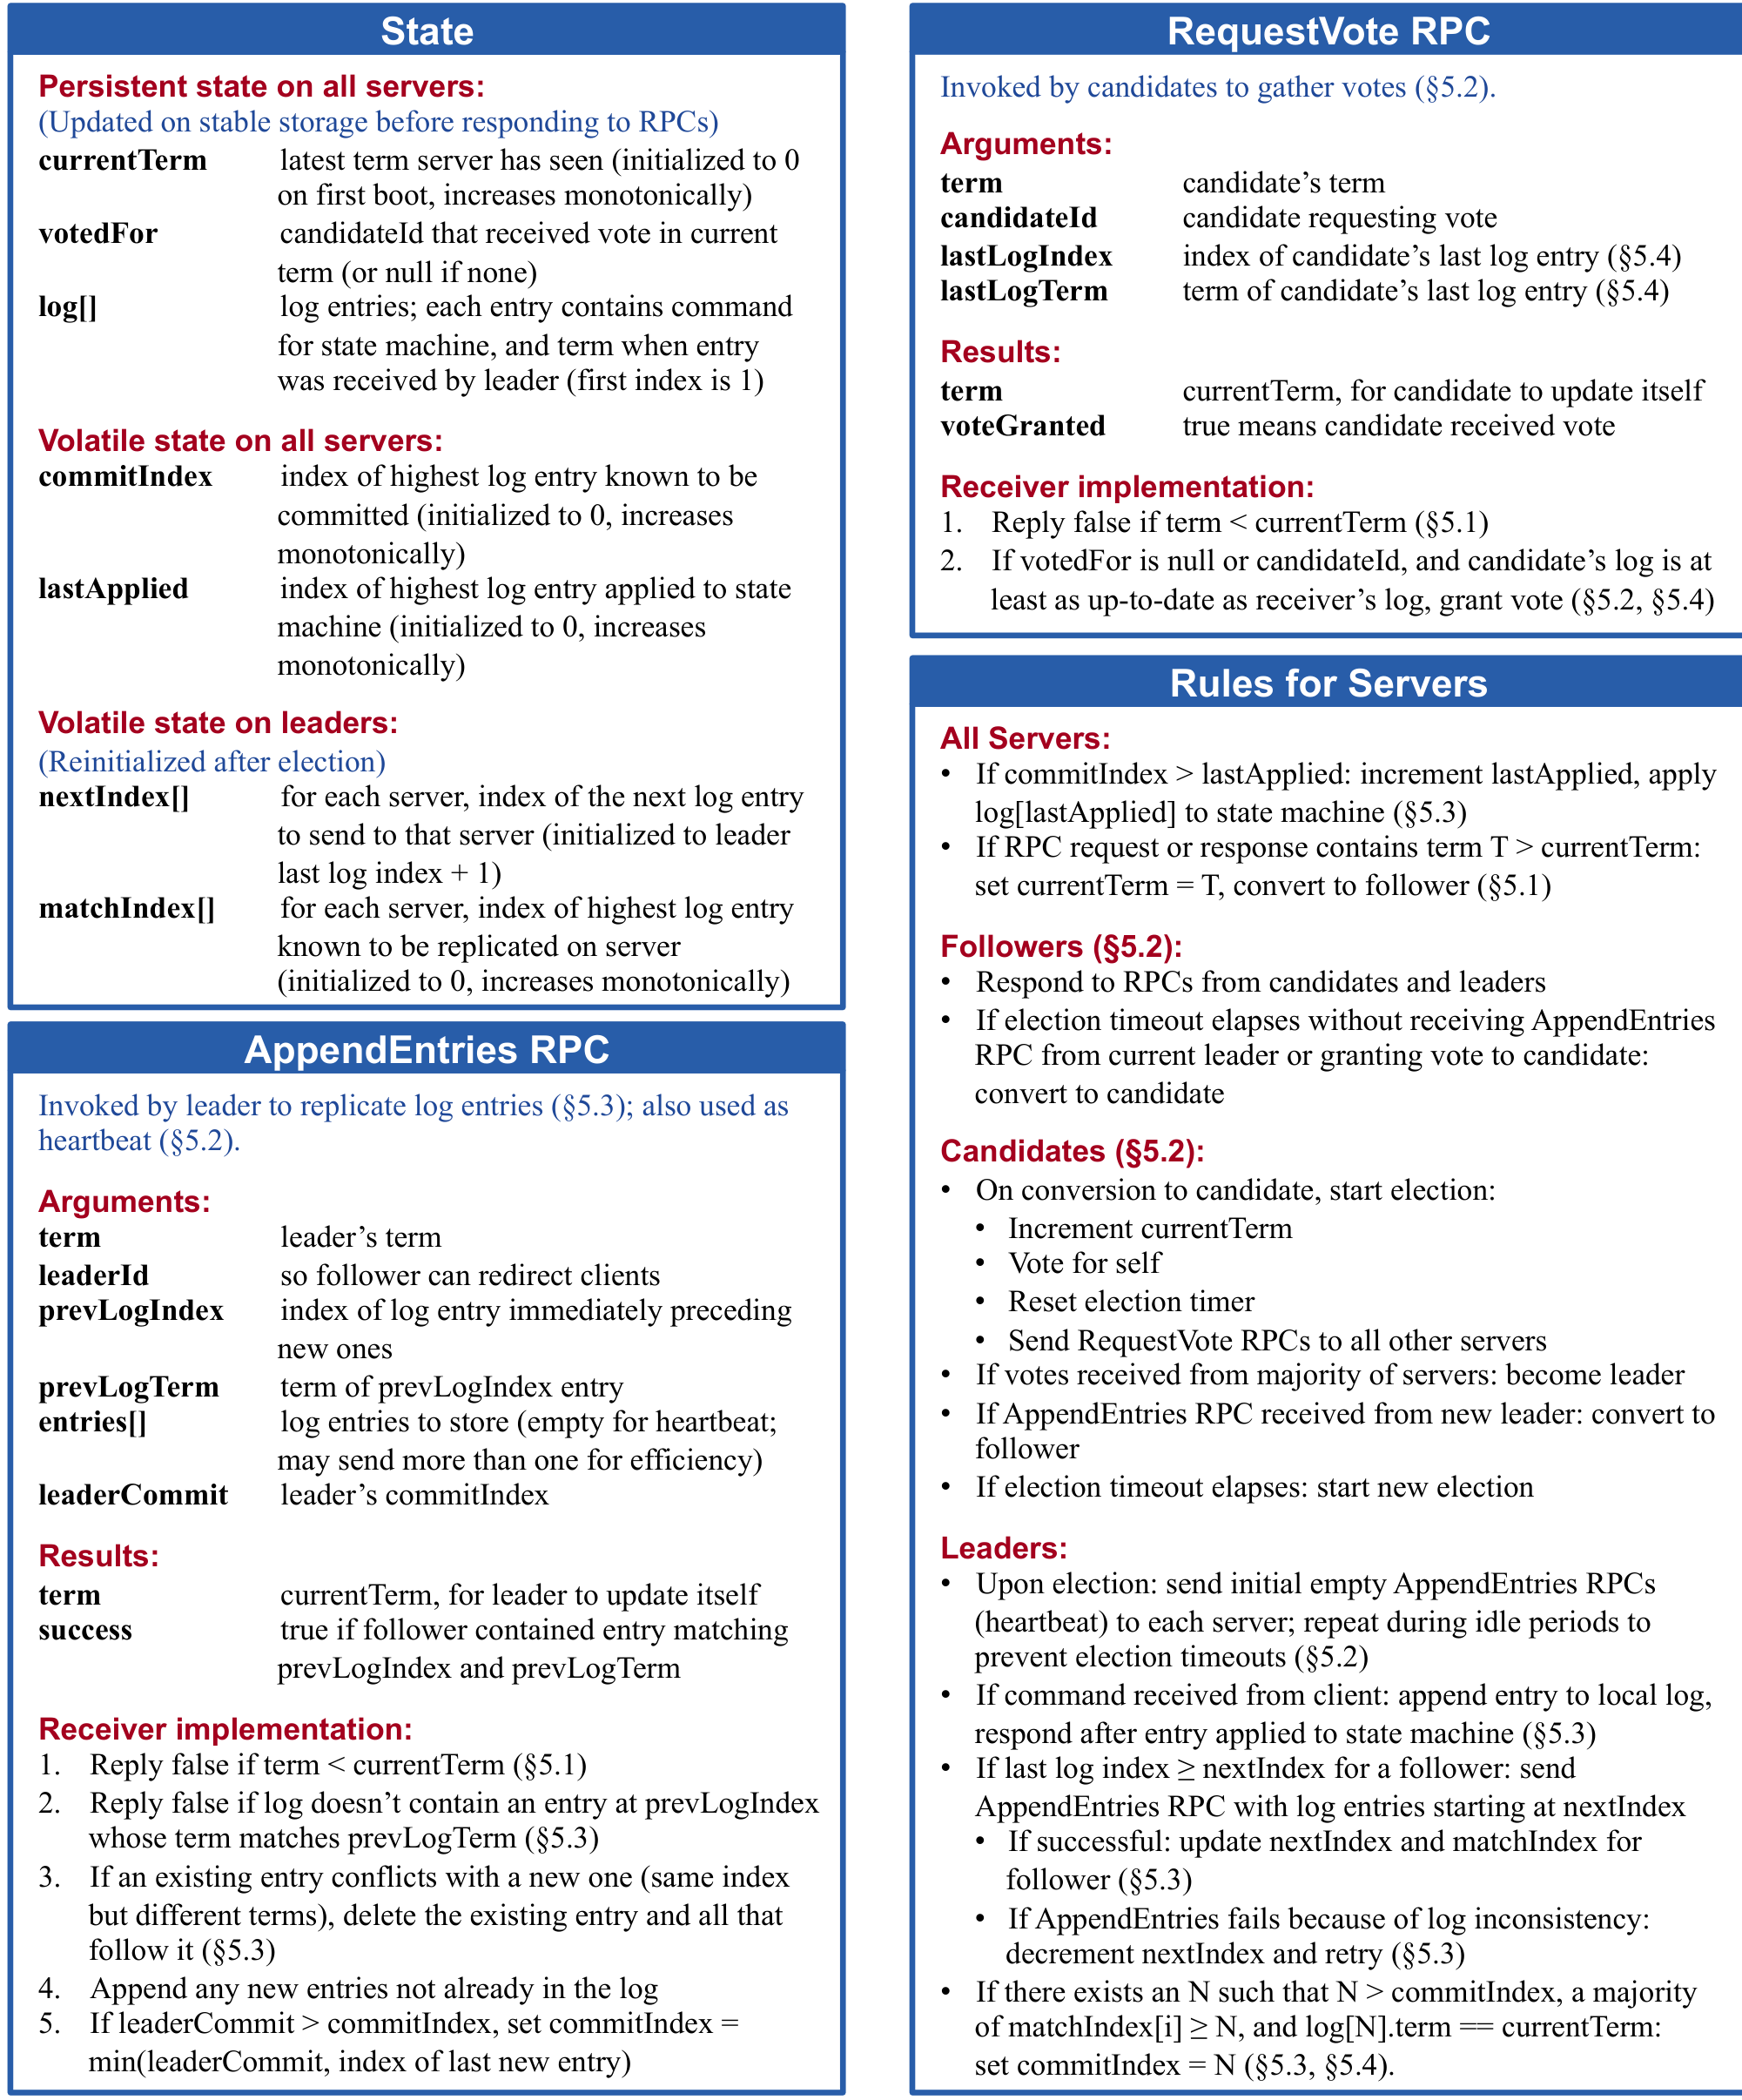
RequestVote 比较候选人的 (lastLogTerm, lastLogIndex):先比较末条日志的 term,相同时再比较 index。较新 term 的短日志可以比旧 term 的长日志更新。这个限制与多数派交集配合,使拥有已提交条目的节点不会支持缺失必要历史的候选人。
AppendEntries 怎样修复后缀
leader 为每个 follower 保存 nextIndex。请求带上前一条日志的 index 与 term,follower 只有找到匹配前缀才接受后续条目;遇到相同 index、不同 term 的冲突时,删除冲突条目及其后缀,再追加 leader 的内容。
不能因为收到一次较短的 AppendEntries,就把 follower 上全部额外条目无条件截掉。旧 RPC 可能晚到,删除应由真实冲突触发;leader 也要检查异步回复对应的 term 与自身当前角色,避免旧回复污染新任期状态。
逐条回退 nextIndex 在大分叉上会很慢。论文建议按冲突 term 跳过一段日志,减少修复往返;具体实现仍要用日志的逻辑 index 处理快照边界。
多数复制与本任期提交条件
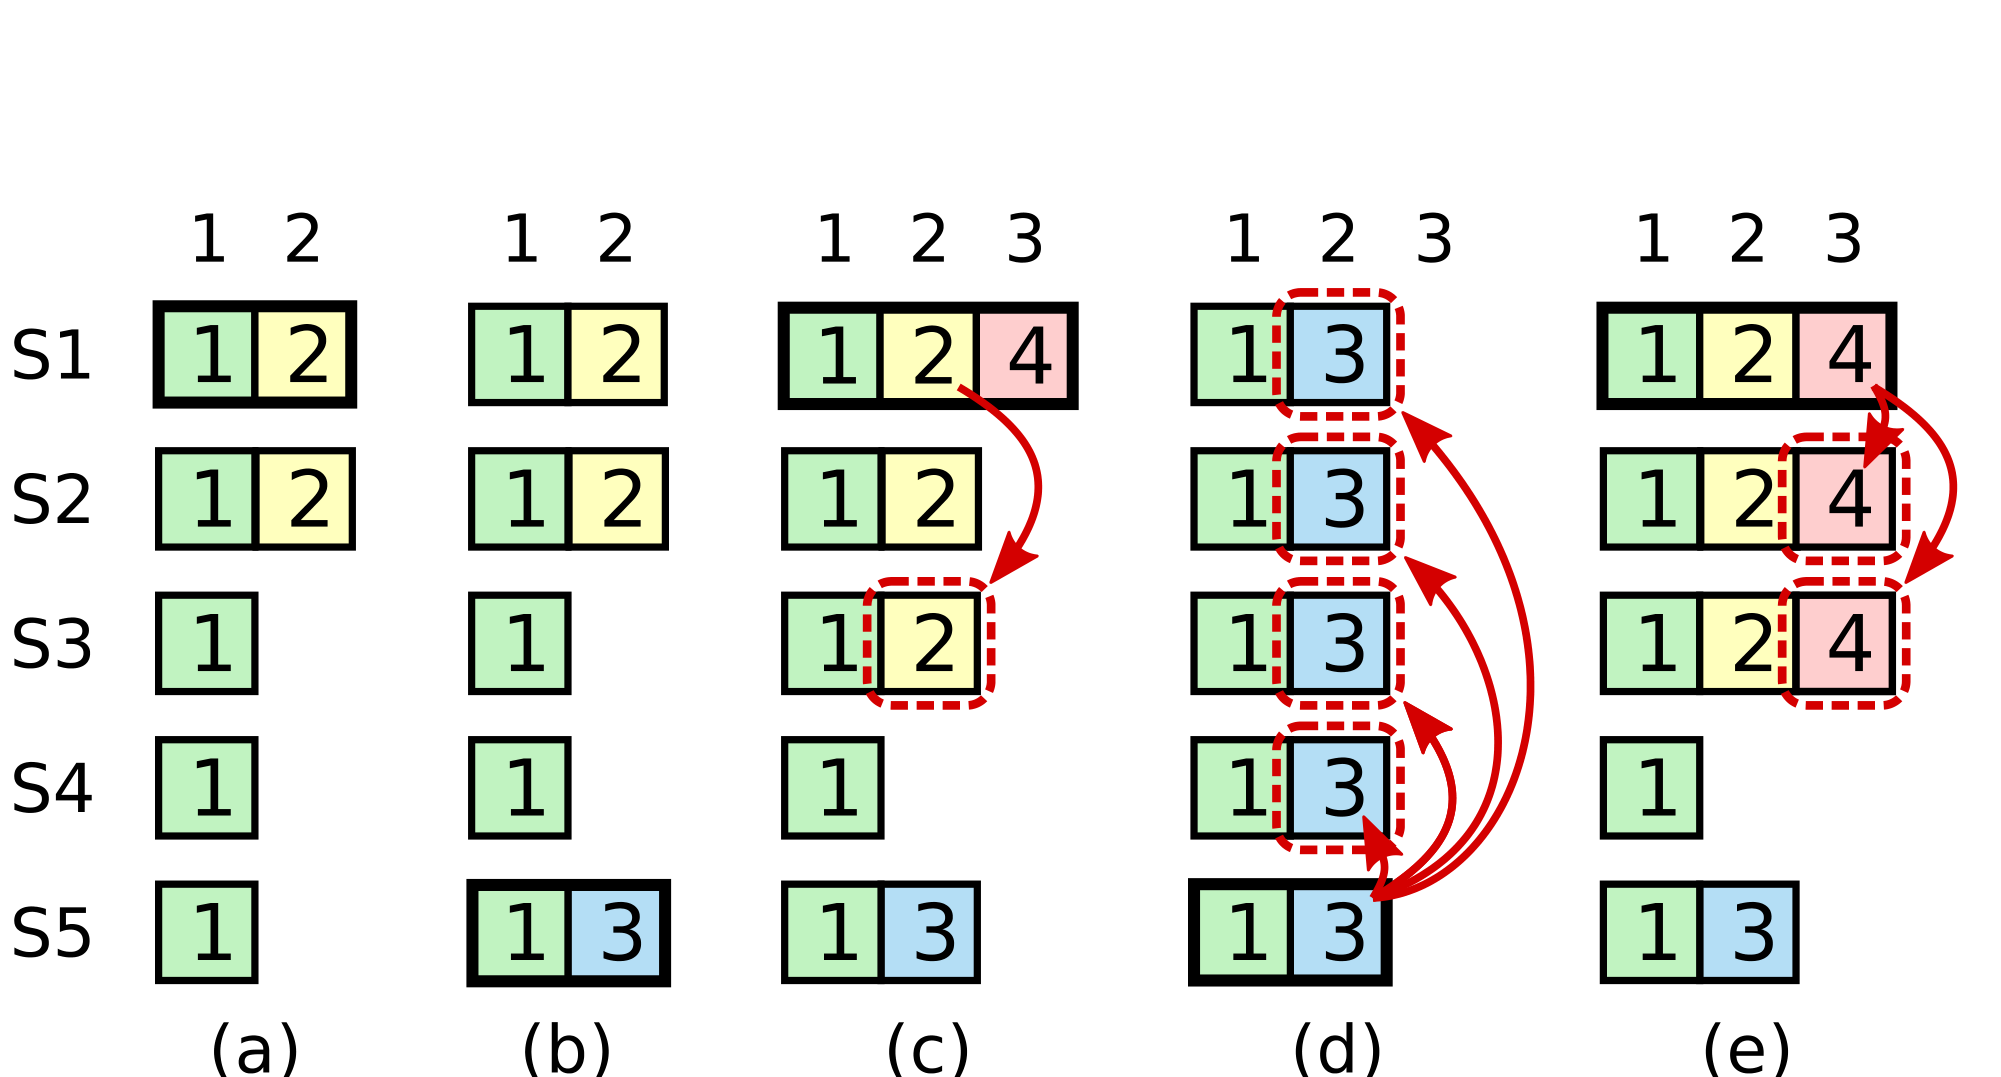
Figure 8 说明一个容易遗漏的条件:leader 不能仅凭某个旧任期条目出现在多数副本上,就据此直接推进提交。按多数计数确认 N 时,还要求 log[N].term == currentTerm。本任期条目提交后,它前面的日志才一起成为已提交前缀。
应用只能执行已提交条目,并按 index 顺序推进。提交、交付和应用完成是不同阶段,客户端回复还需要等待业务操作真正执行。已提交的命令不能在后续换主中消失,尚未提交的命令则可能被覆盖。
重启以后必须记住哪些事
currentTerm、votedFor 与日志属于持久状态。回复投票或日志接受成功之前,要先保存会影响该承诺的状态。否则节点可能在重启后同任期再次投票,或忘记自己已经确认的日志。
commitIndex、nextIndex、matchIndex 等可以按协议重新建立。这个划分依赖应用的恢复方式,不能把“Raft 某字段是 volatile”直接推广成整个服务无需恢复执行位置或请求去重信息。
快照替代已执行历史
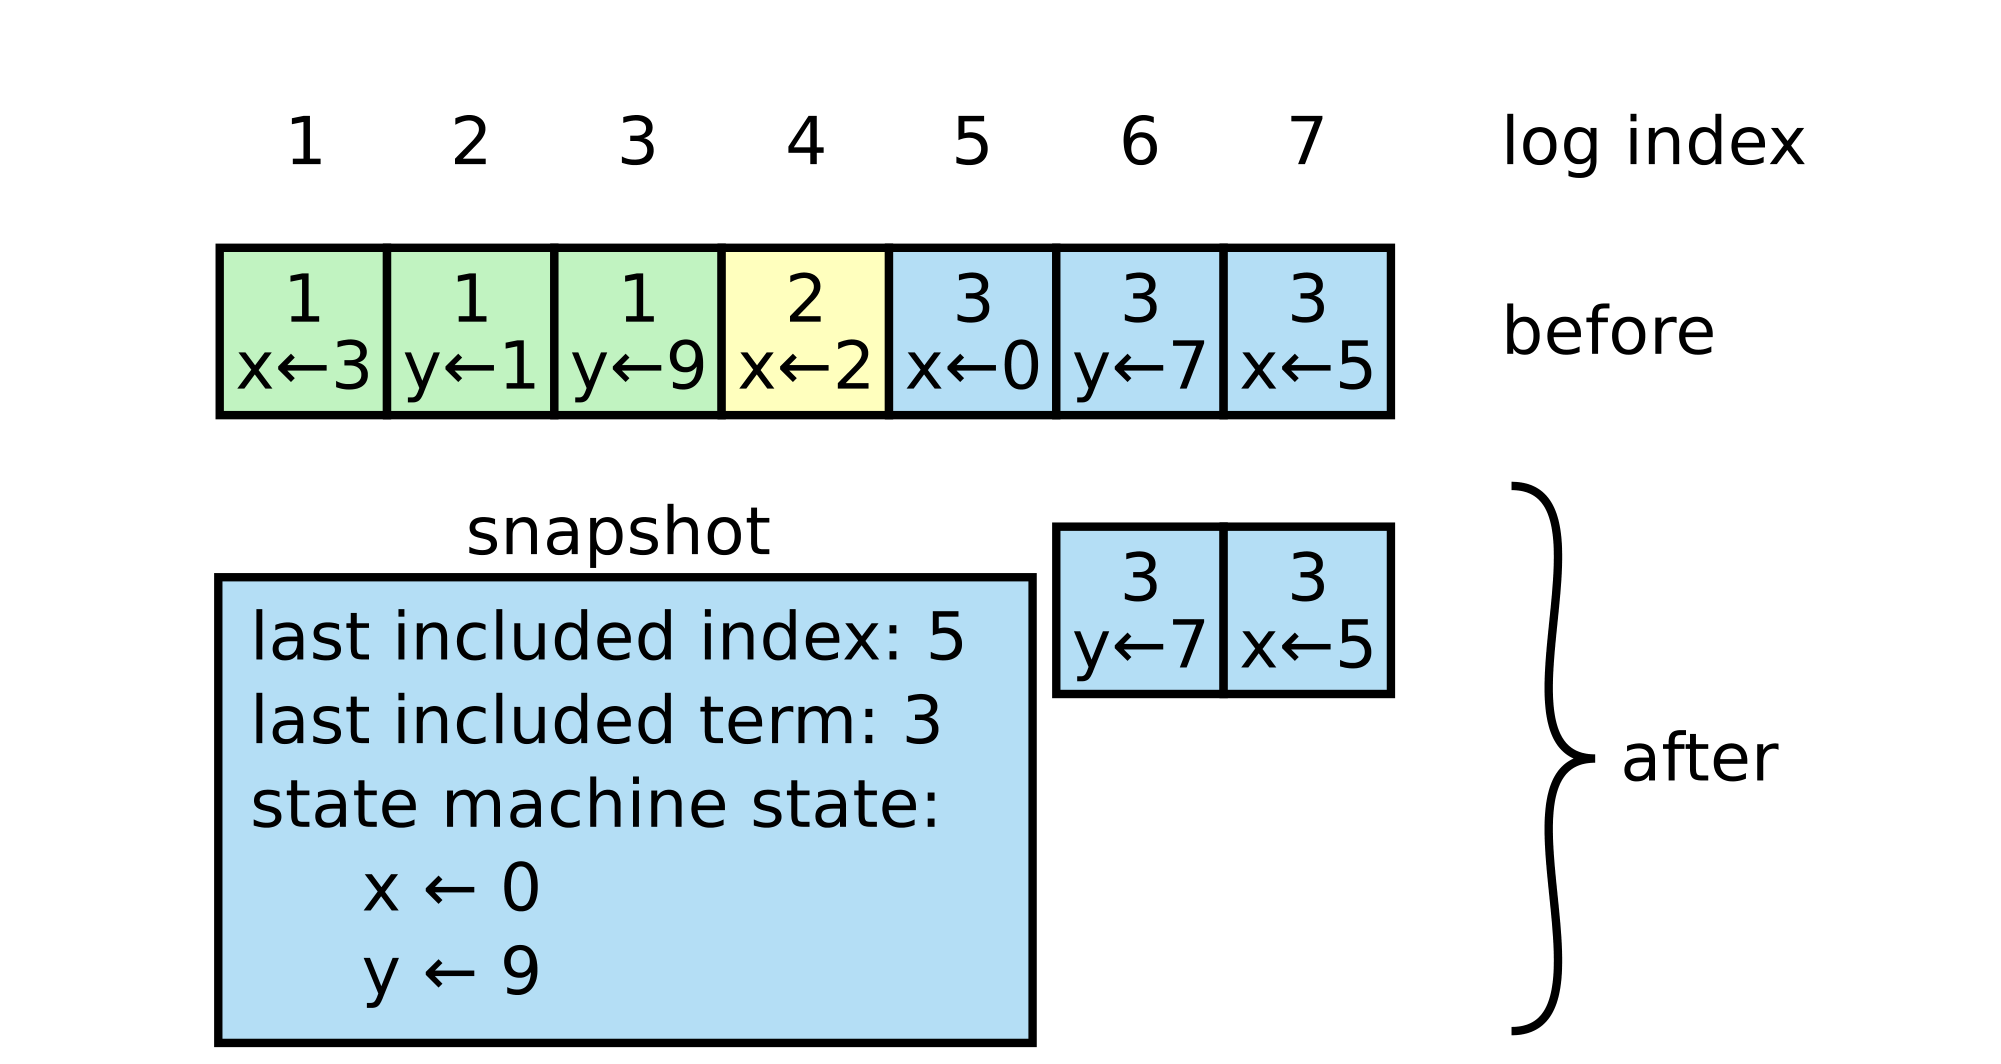
运行时间越长,日志越可能远大于当前 KV 状态。服务在已应用的位置生成快照,Raft 保存快照及其 lastIncludedIndex、lastIncludedTerm,随后丢弃被覆盖的前缀。恢复时先装入快照,再重放尾部日志,避免重复执行快照已经包含的操作。
落后 follower 需要的日志若已被 leader 压缩,就通过 InstallSnapshot 追赶。快照必须与相应的 Raft 状态一致持久化;它也不能包含尚未提交、尚未执行的猜测状态。
读请求与重复请求
仅从 leader 的本地 map 返回 Get,可能读到隔离旧 leader 的状态。实验采用把 Get 也写入日志的办法,以多数确认建立有效顺序;论文另外讨论不写日志的安全读优化,但仍要确认领导权并保证状态已经应用到相应位置。
RPC 重试也不能只靠日志共识解决。同一客户端请求可能作为两条日志进入系统,应用需要用客户端身份与请求序号识别重复,并保存回复。做快照时,这些去重状态也应与业务数据一起保留。