课程视频(2021 年公开录像)
把协调能力从业务中提取出来
ZooKeeper 为其他系统提供少量可靠的协调状态:谁是当前 coordinator、配置版本是什么、有哪些服务成员。它保存的是协调所需的元数据,应用的大块业务数据仍放在自己的存储中。
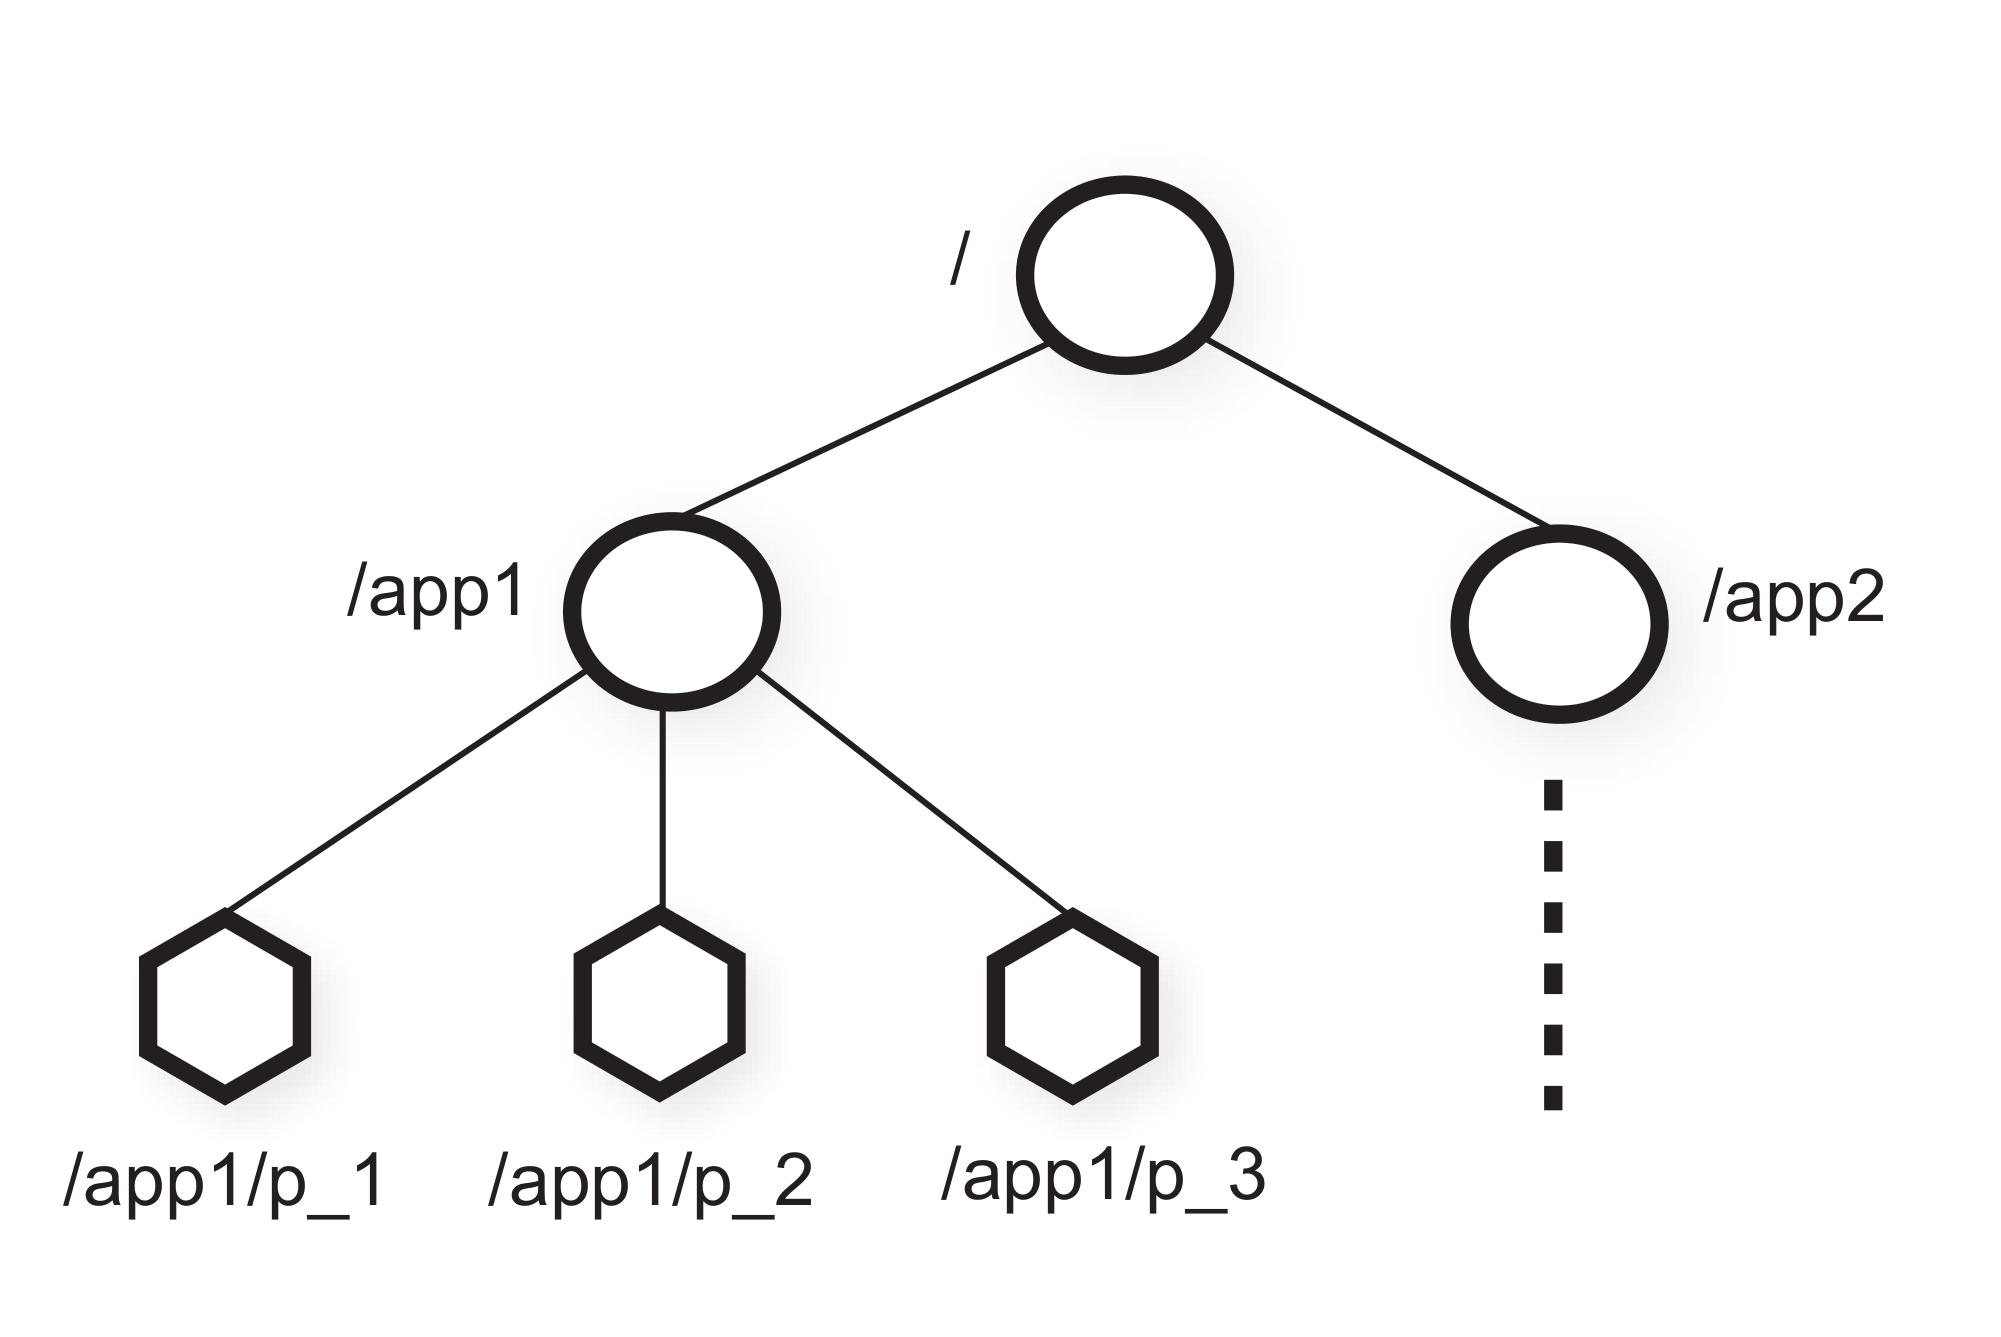
znode 构成类似文件系统的树,每个节点包含数据与版本。普通节点持续存在,ephemeral 节点随 session 结束删除,sequential 节点在名称后分配序号。create 的排他性、带版本的 setData、watch 与 session,一起成为构建协调协议的基础。
API 如何处理并发修改
多个客户端同时创建同一路径,只有一个成功,适合竞争某个角色。getData 返回数据和版本,setData(path, value, version) 只有版本匹配才更新,避免客户端基于旧读覆盖他人的修改。
watch 用来通知状态已经变化,减少反复轮询。收到通知后应重新读取状态并根据协议重新注册;不能把一次通知当成包含所有变化的事件日志。判断条件与注册 watch 的操作也需要结合,否则可能在检查后、开始等待前错过变化。
用临时节点选 coordinator
候选者先建立 session,竞争创建 /mr/c 临时节点。成功者承担 coordinator 工作,失败者观察节点并等待变化。旧 session 到期后,ZooKeeper 删除其临时节点,其他候选者才有机会接替。
如果 coordinator 在更新多个 znode 时失败,新 coordinator 还要识别半完成状态。讲义讨论 ready 标记,以及先写完整新版本、再切换指针的方式。它们把“完成一组更新”的判定集中到一个最终发布动作上。
session 结束是一项协调决定,不是机器真的停止运行的证明。旧进程可能只是在网络分区另一侧。ZooKeeper 会拒绝旧 session 对自身状态的访问;如果旧进程还能操作外部数据库或文件,就仍需要外部资源能够校验的 epoch 或 fencing token,不能仅凭临时节点自动防住所有旧主操作。
写入排序与本地读取
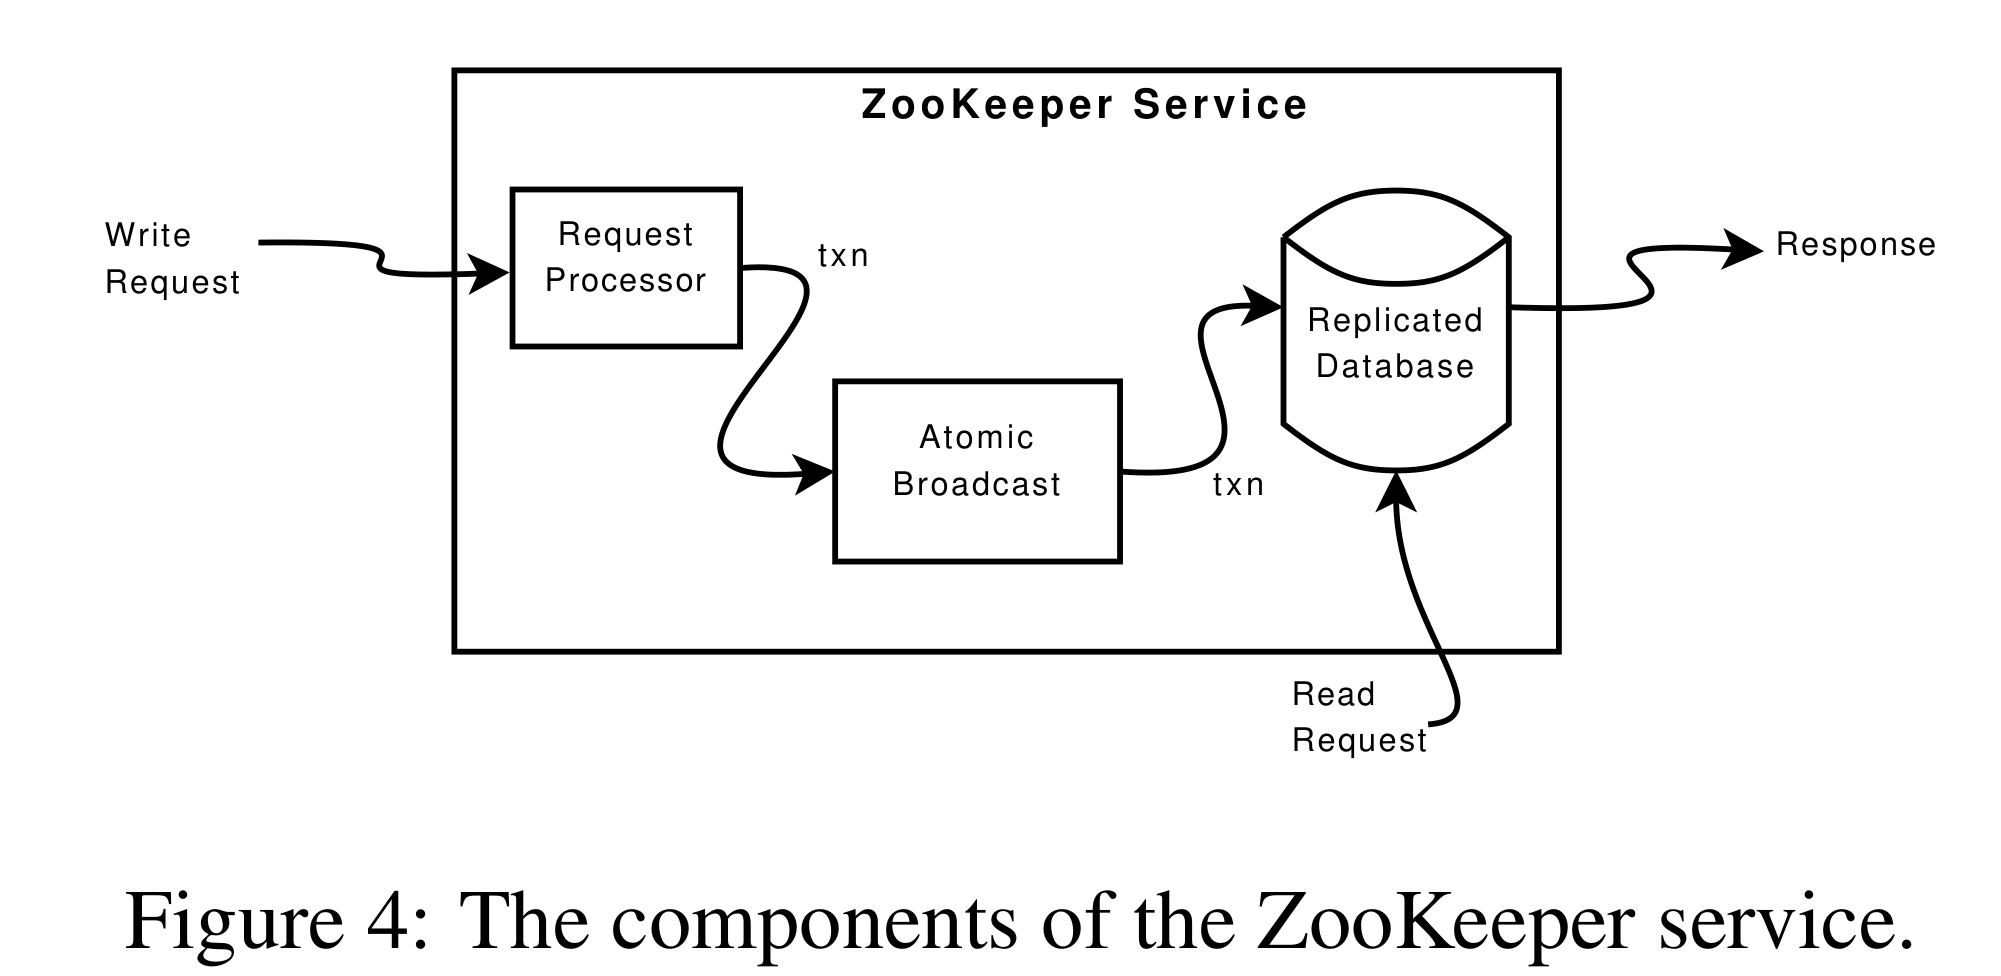
ZooKeeper 的复制协议是 Zab,思路与课程中的复制日志相关,但不是 Raft。leader 给写入确定统一顺序,副本按相同顺序应用;读通常由客户端所连服务器在本地完成,因此普通读可能落后于其他客户端已经完成的写。
论文版本同时提供重要的客户端顺序保证:客户端看到自己的先前写,观察到的更新顺序一致,而且切换服务器后也不能倒退到自己已经观察过的位置。这些保证使很多协调模式成立,却不意味着所有普通读都满足线性一致性。
为什么增加副本不总能增加吞吐
更多副本可以分摊本地读和 watch,却会增加写复制的工作。原论文的吞吐曲线需要结合读写比例理解,不能脱离请求大小和机器配置给出通用性能结论。
异步请求与批处理可以摊薄通信、日志落盘的成本。服务的恢复则依靠日志与快照,leader 故障期间仍有选举停顿。学习这一讲时,可以把 API 保证和业务协议逐一对应:哪些步骤依赖排他创建,哪些依赖客户端顺序,哪些还需要外部 fencing。