课程视频(2021 年公开录像)
把配置管理与数据复制分开
Chain Replication 把每个对象的副本排成链。配置服务决定链的成员和顺序,数据操作沿链传递。配置服务通常需要可靠的共识机制,数据链本身则使用更简单的有序转发。
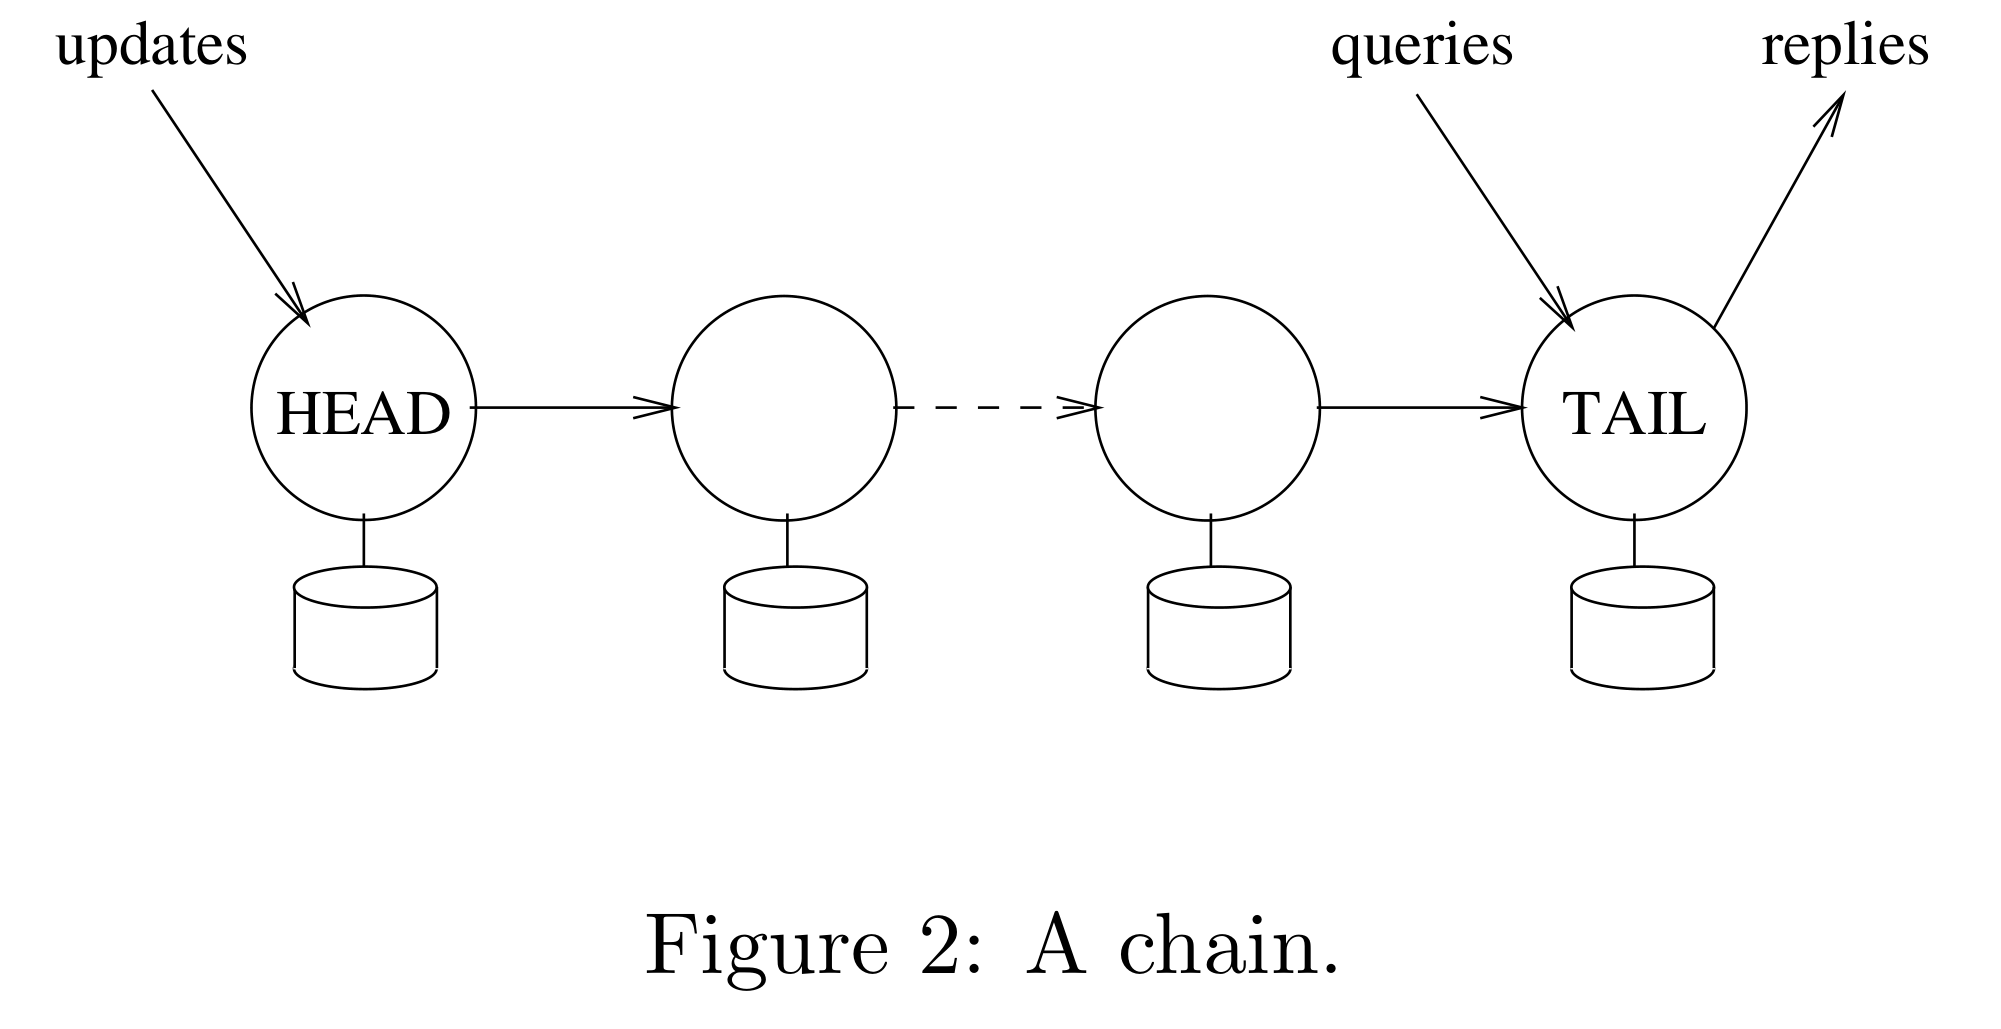
客户端把更新送到 head,head 排序后逐个向后转发,各节点保持相同的更新顺序。tail 收到更新后,可以向客户端确认;查询也在 tail 执行,因此只暴露已经到达链尾的前缀。
为什么不能由 head 提前回复
head 把更新发给下一个副本,并不代表更新已经到达 tail。如果此时客户端得到写成功,随后向 tail 发起查询,却仍读到旧值,就违反了线性一致要求。
链上节点可暂时拥有不同长度的历史,但下游的历史是上游已接收历史的前缀。尾部的统一读点把暂时差异隐藏起来。更新确认还会沿链反馈,用于清理待确认状态和支持重配置。
与并行主备复制比较
传统 primary/backup 可以由 primary 同时向所有 backup 发送,并等待当前配置全部副本确认;链复制让每个中间节点主要承担一次接收和一次转发,减少 head 的发送扇出,并把客户端读负担放在 tail。
代价是更新要依次经过链,单次延迟随着链长度增加;tail 也可能成为读瓶颈。流水线提高稳态吞吐,不等于每个请求的延迟都比并行主备更小。论文的性能图应结合读写比例与链长分析。
节点失败后怎样接链
head 失败时,配置服务把下一个节点提升为新 head;只在旧 head 上的未完成更新可以由客户端重试。tail 失败时,前一节点成为新 tail,已经传播到旧 tail 的更新必然也经过它,才能保留已完成请求。
中间节点失败更需要处理在途后缀:上游已发送、下游未收到的更新,必须在新连接上继续传递。节点要依据序号和待确认集合对齐进度,不能只删除故障节点后就假定全链同步。
增加新 tail 也需要先传送状态和追赶更新,再切换读写完成点。客户端与服务器应按新配置访问,防止旧链在分区另一侧继续对外作出过期承诺。
“只剩一个副本仍可用”的前提
固定配置的每次写入都到达全部链节点后,单个存活副本就保存了已完成更新;但能否安全继续,还取决于配置服务能够决定新配置,以及旧角色被正确隔离。
因此不能把“数据链有 N 个副本可承受 N−1 个副本丢失”直接解释成整个系统拥有比 Raft 更强的无条件可用性。它把一部分共识和故障判定责任移给了配置层,而不是消除了这些问题。