Future 把等待与数据移动分开
Ray 这一讲阅读的是 NSDI 2021 的分布式 Future 论文。普通 RPC 通常让调用者等待结果,再把结果传给下一次调用;Future 先返回一个引用,允许程序继续构造任务依赖,真正需要值时再等待。
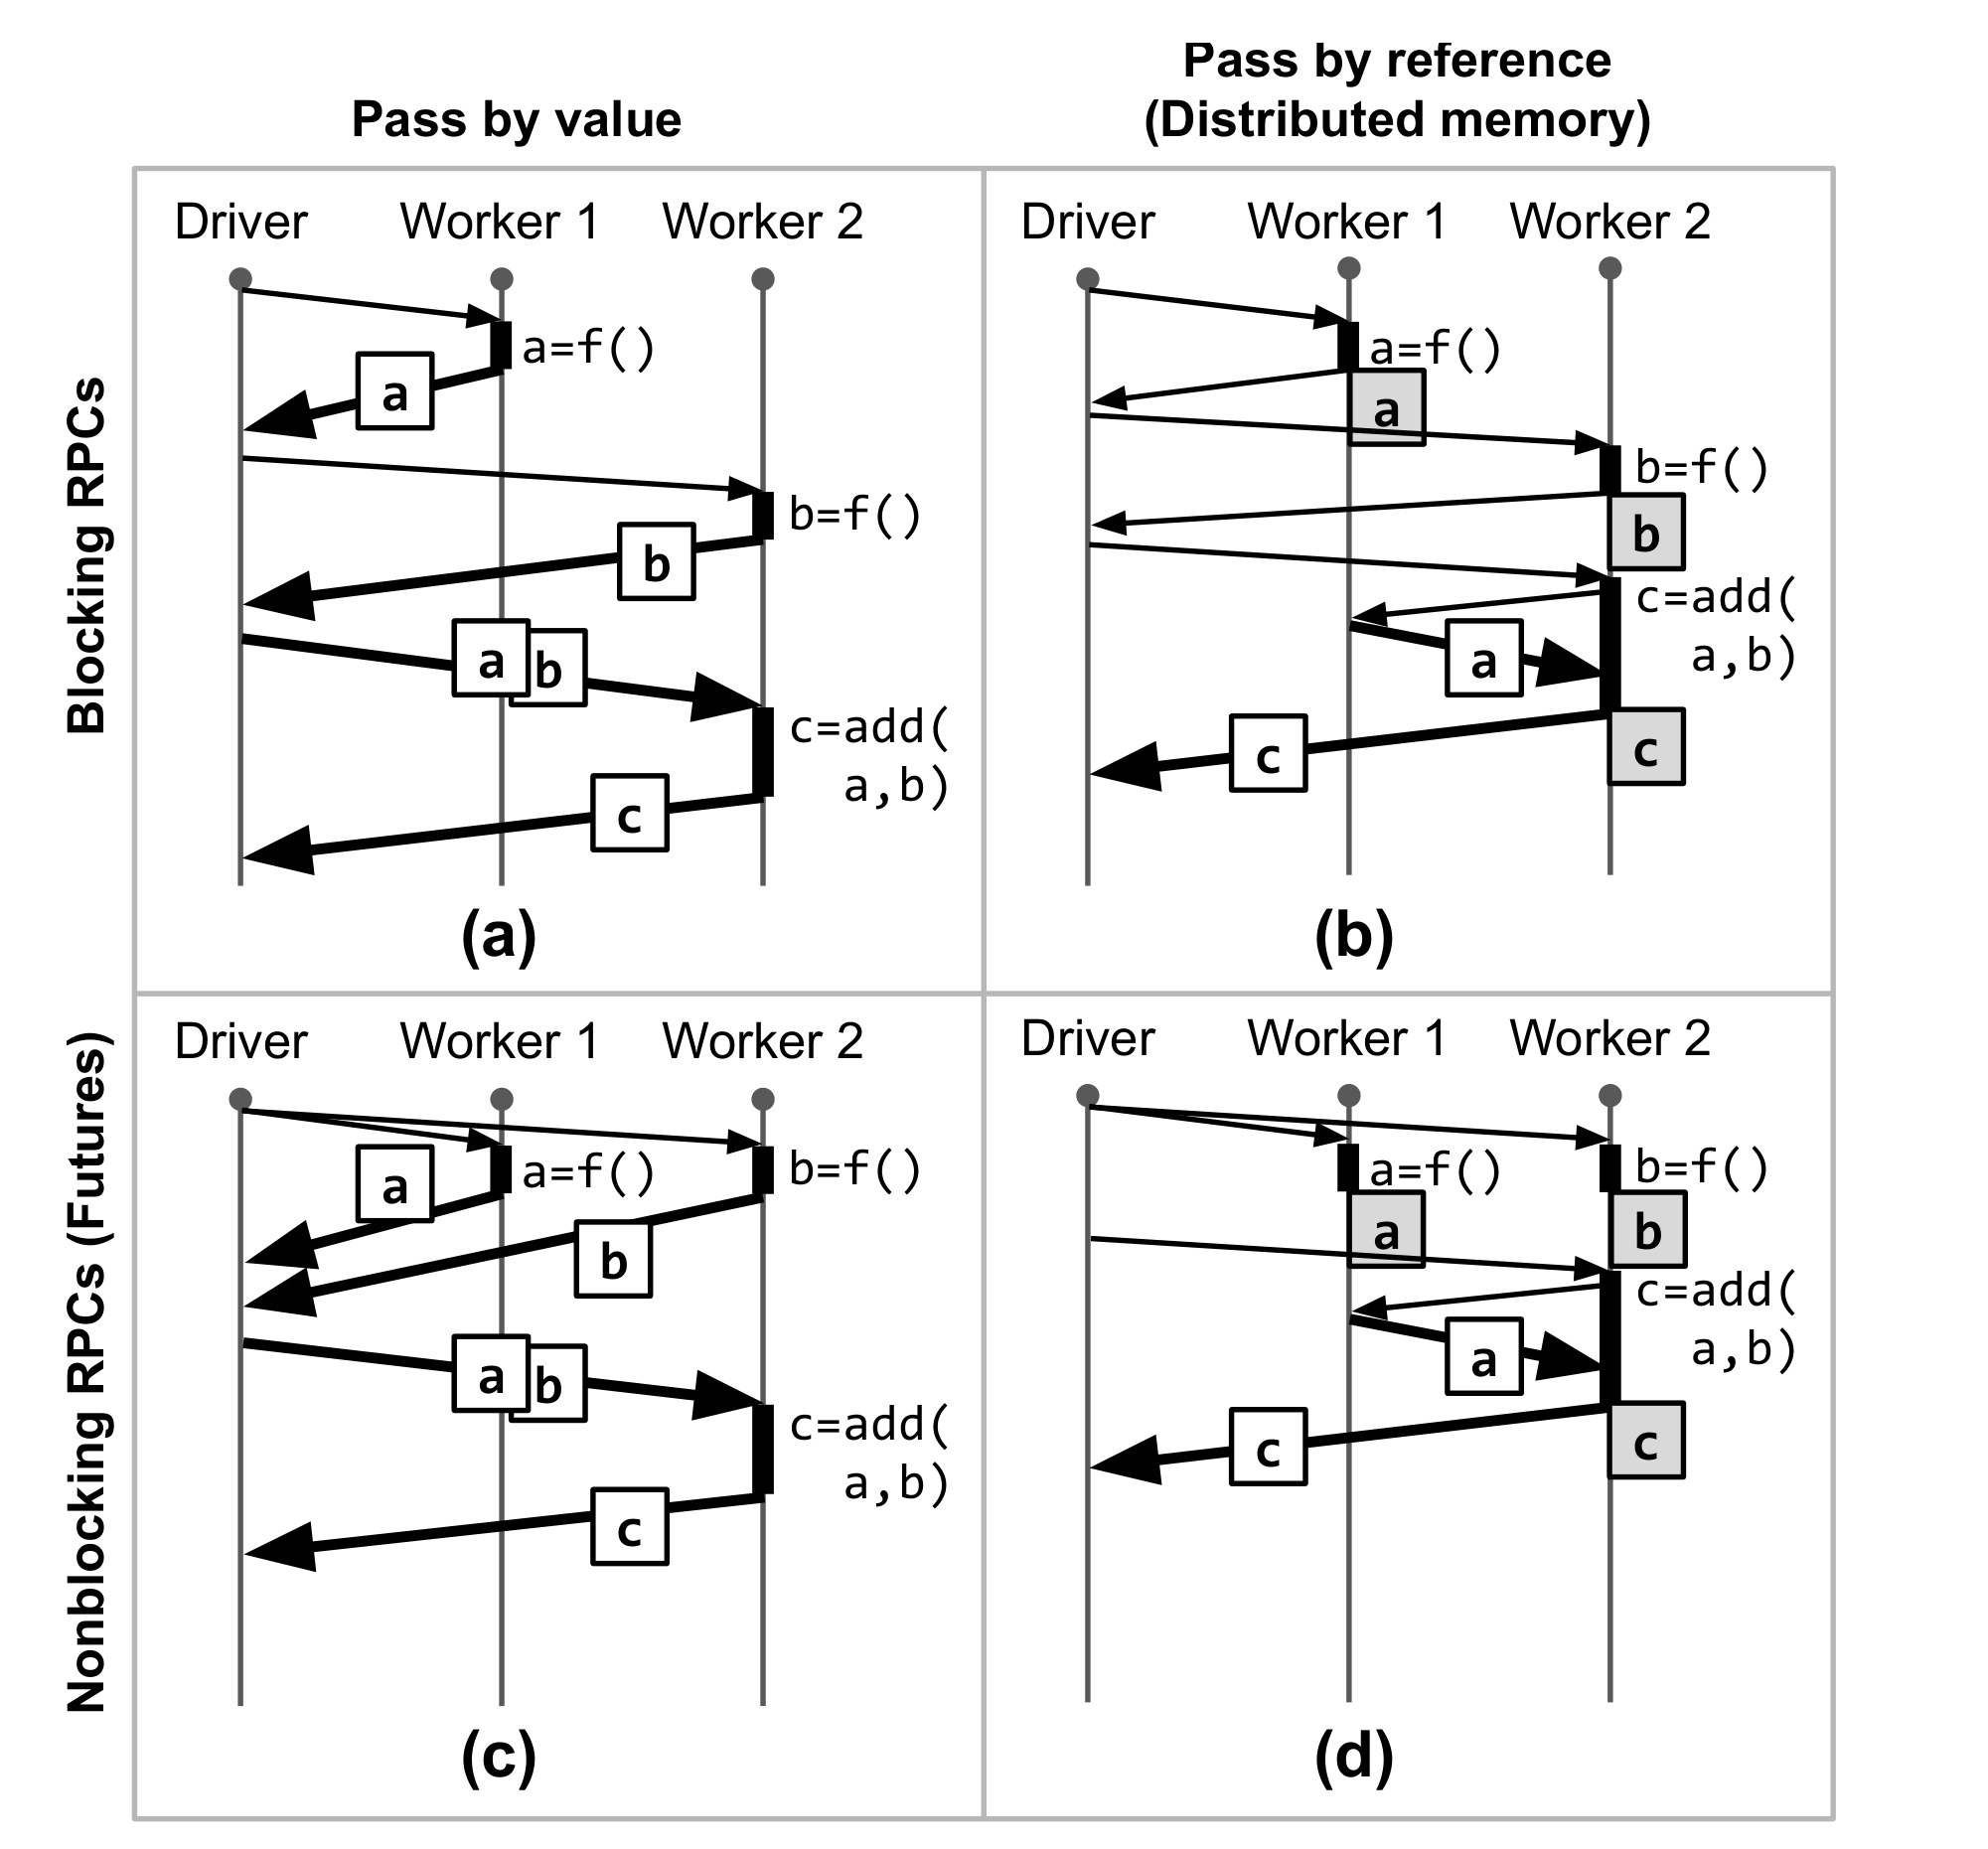
论文的例子先计算 a、b,再执行 add(a, b)。Future 允许前两个计算并发,按引用传参让 a、b 的大对象直接移向消费任务,不必全部绕经发起者。并发与减少数据复制是两个可以组合的收益。
Task 与 Actor 各自保存什么
无状态 task 根据参数计算结果,适合重执行和数据流调度。Actor 保留跨调用状态,例如计数器、模型副本或视频处理中的上下文,方法调用会影响后续行为。
因此,保存 Future 的引用不代表数据已经算好,也不代表它存放在 owner 本机。实现需要分别管理任务、对象内容、引用关系与位置。对 Actor 的恢复更不能不加区分地套用纯函数重算,因为重新执行副作用可能改变语义。
中央目录为什么成为瓶颈
一个直观方案是由 coordinator 保存所有 Future 的任务、引用者、执行 worker 和结果位置。查询与创建都经过同一个中心,对于细粒度任务,一次额外目录往返就可能占据很大比例。
按对象 ID 随机分片能分散容量,却仍然需要访问远端目录,引用回收也可能跨多个分片。论文改为利用应用的调用关系:创建某个 Future 的调用者成为它的 owner,把元数据管理沿调用树分布。
Ownership 让创建者管理生命周期
假设 worker 1 上的 A 调用 B 得到 x,再把 x 传给 worker 3 上的 C。A 是 x 的 owner,B 的执行机器可能保存 x 的实际值,C 是借用引用的 borrower。后续再次传递引用,也需要跟踪借用关系,避免对象仍被使用时就被回收。
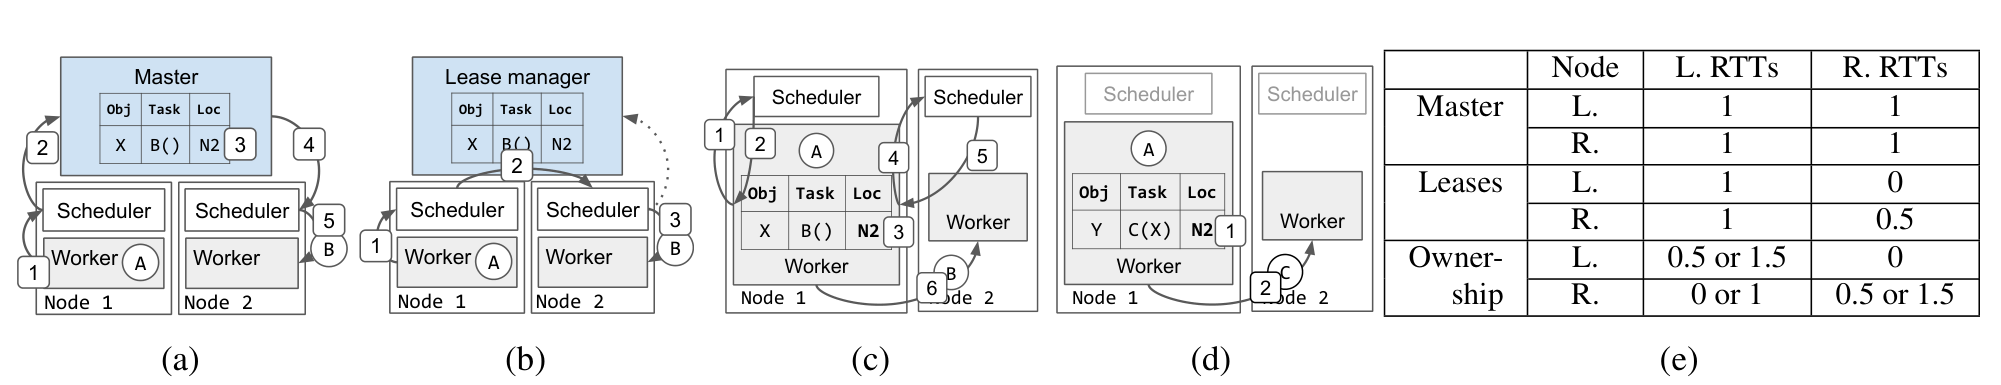
owner 已经知道任务和引用之间的关系,可以直接推进调度。scheduler 为任务租用 worker,调用者在规则允许时复用 worker,减少后续任务启动成本。图中的往返数是论文方案对比,依赖本地或远端执行路径。
对象回收与任务重建
对象存储区分创建、获取、固定和释放等动作。仍有引用或执行依赖的对象不能删除;内容可以复制到消费者所在机器形成缓存副本,减少后续传输,也降低部分故障后的重算成本。
如果执行 B 的 worker 失败,而 owner A 还活着,A 保存的 lineage 可以用于重新发起 B。重建依赖任务要求计算满足相应可重执行条件,不能为任意外部写操作自动提供 exactly-once。
owner 失败时为何采用 fate sharing
owner 消失后,它创建的 Future 可能再也无法被解析。系统不能让 borrower 无限等一个失去控制者的引用。论文采用命运共享:依赖失效 owner 的工作失败,再由更上层仍然存在的调用者重新构造相应子计算。
这与把全部元数据同步复制到一个全局高可用目录是不同取舍。正常路径更短、更分散,部分故障则以应用计算结构为边界向上恢复。理解 Ray 的容错时,应同时追踪谁拥有引用、谁存储值,以及失败后哪一层还掌握可重建的信息。