课程视频
从单机扩展到多个节点
分布式数据库把一个逻辑数据库分布到多个物理资源上,主要目标包括扩展容量、计算能力和故障容忍。应用通常仍通过统一的表和查询接口访问,但系统必须处理节点故障、消息延迟与通信中断。
共享资源与计算位置
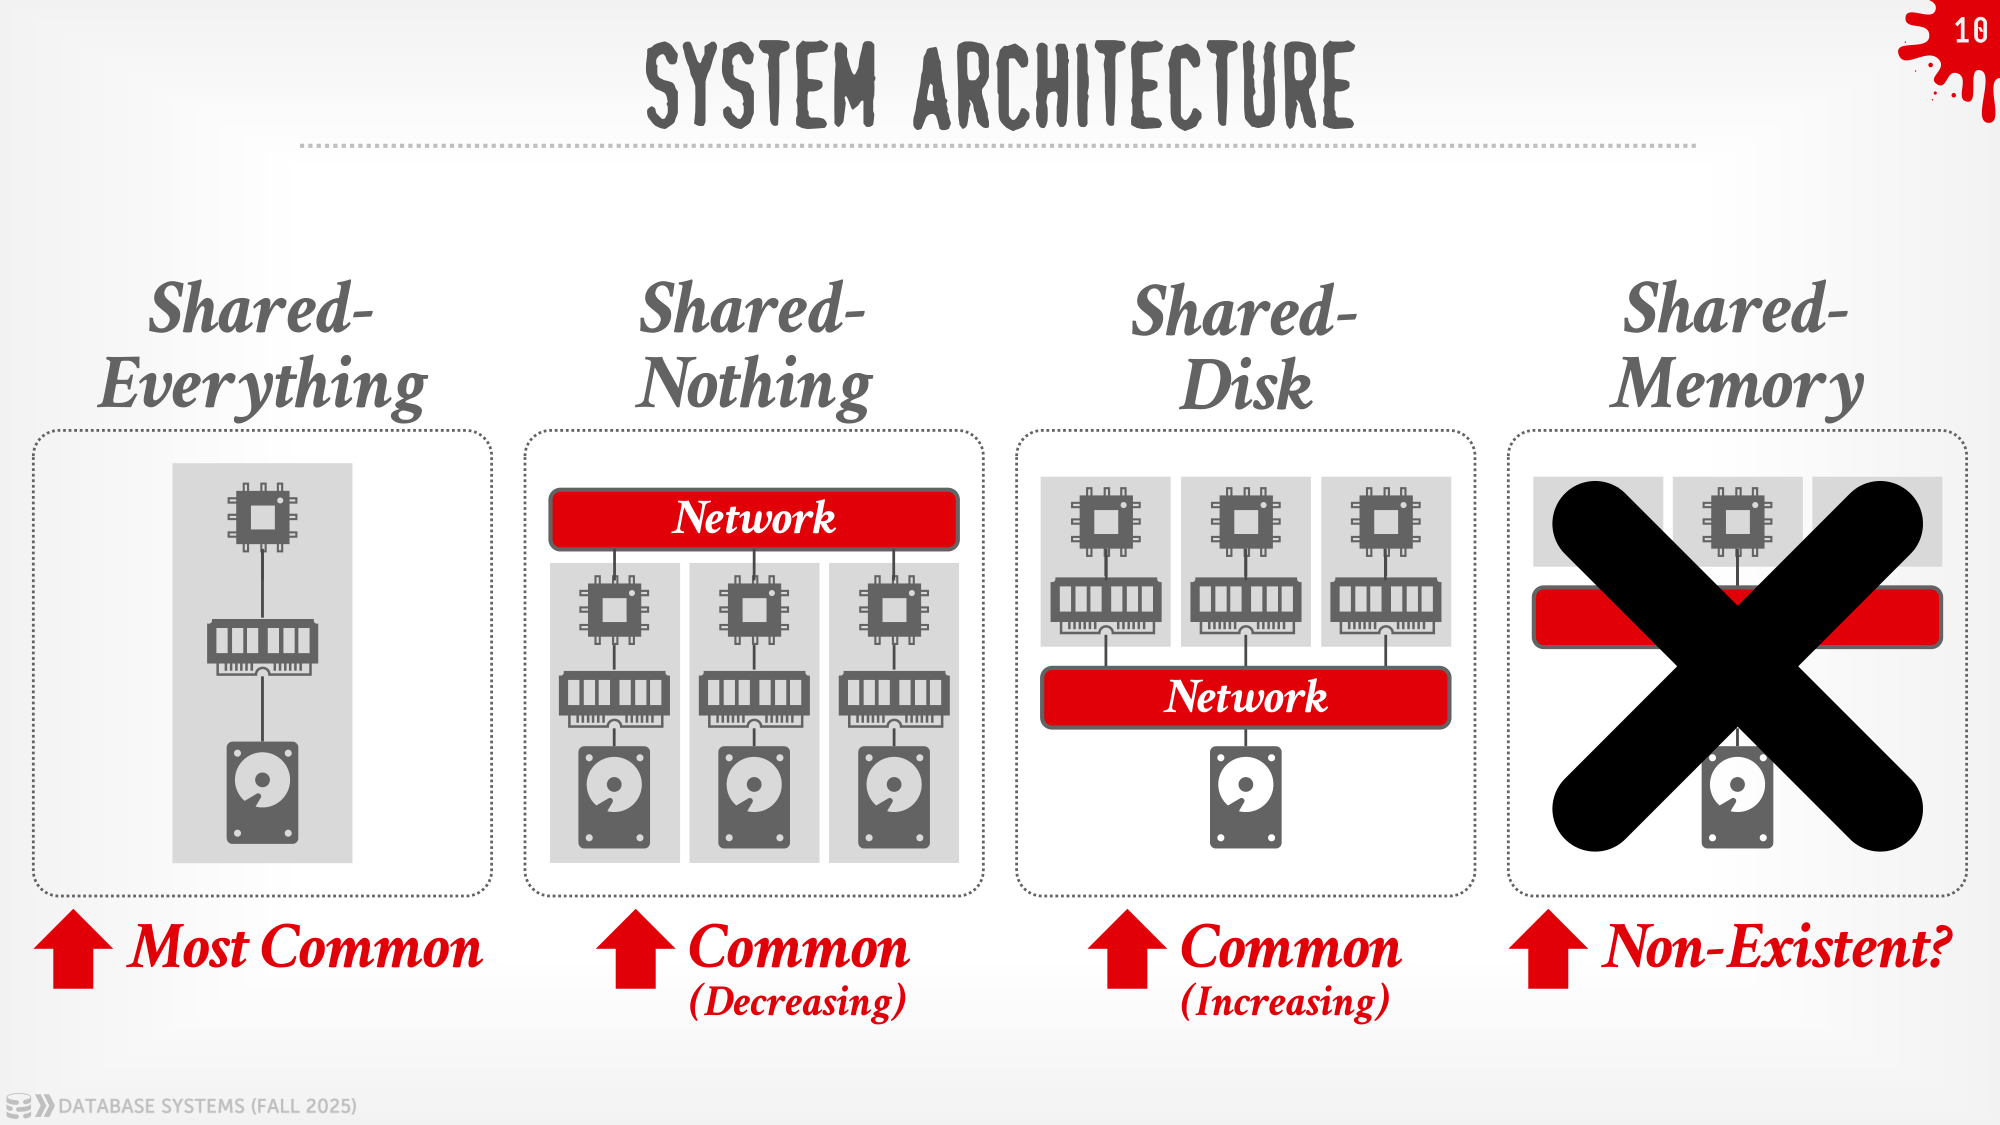
Shared-Nothing 中,每个节点拥有自己的 CPU、内存与本地存储,通过网络交换信息。增加节点后,需要考虑数据迁移和重平衡。Shared-Disk 则让计算节点访问统一的共享存储,各节点仍有独立内存和缓存,使计算与存储可以分别扩容,但缓存一致性与访问协调仍然存在。
执行查询时,可以把计算推到数据所在节点,也可以把所需数据拉到执行节点。选择取决于网络流量、数据量、节点负载以及算子是否能够下推;网络传输同样需要进入成本模型。
数据分区
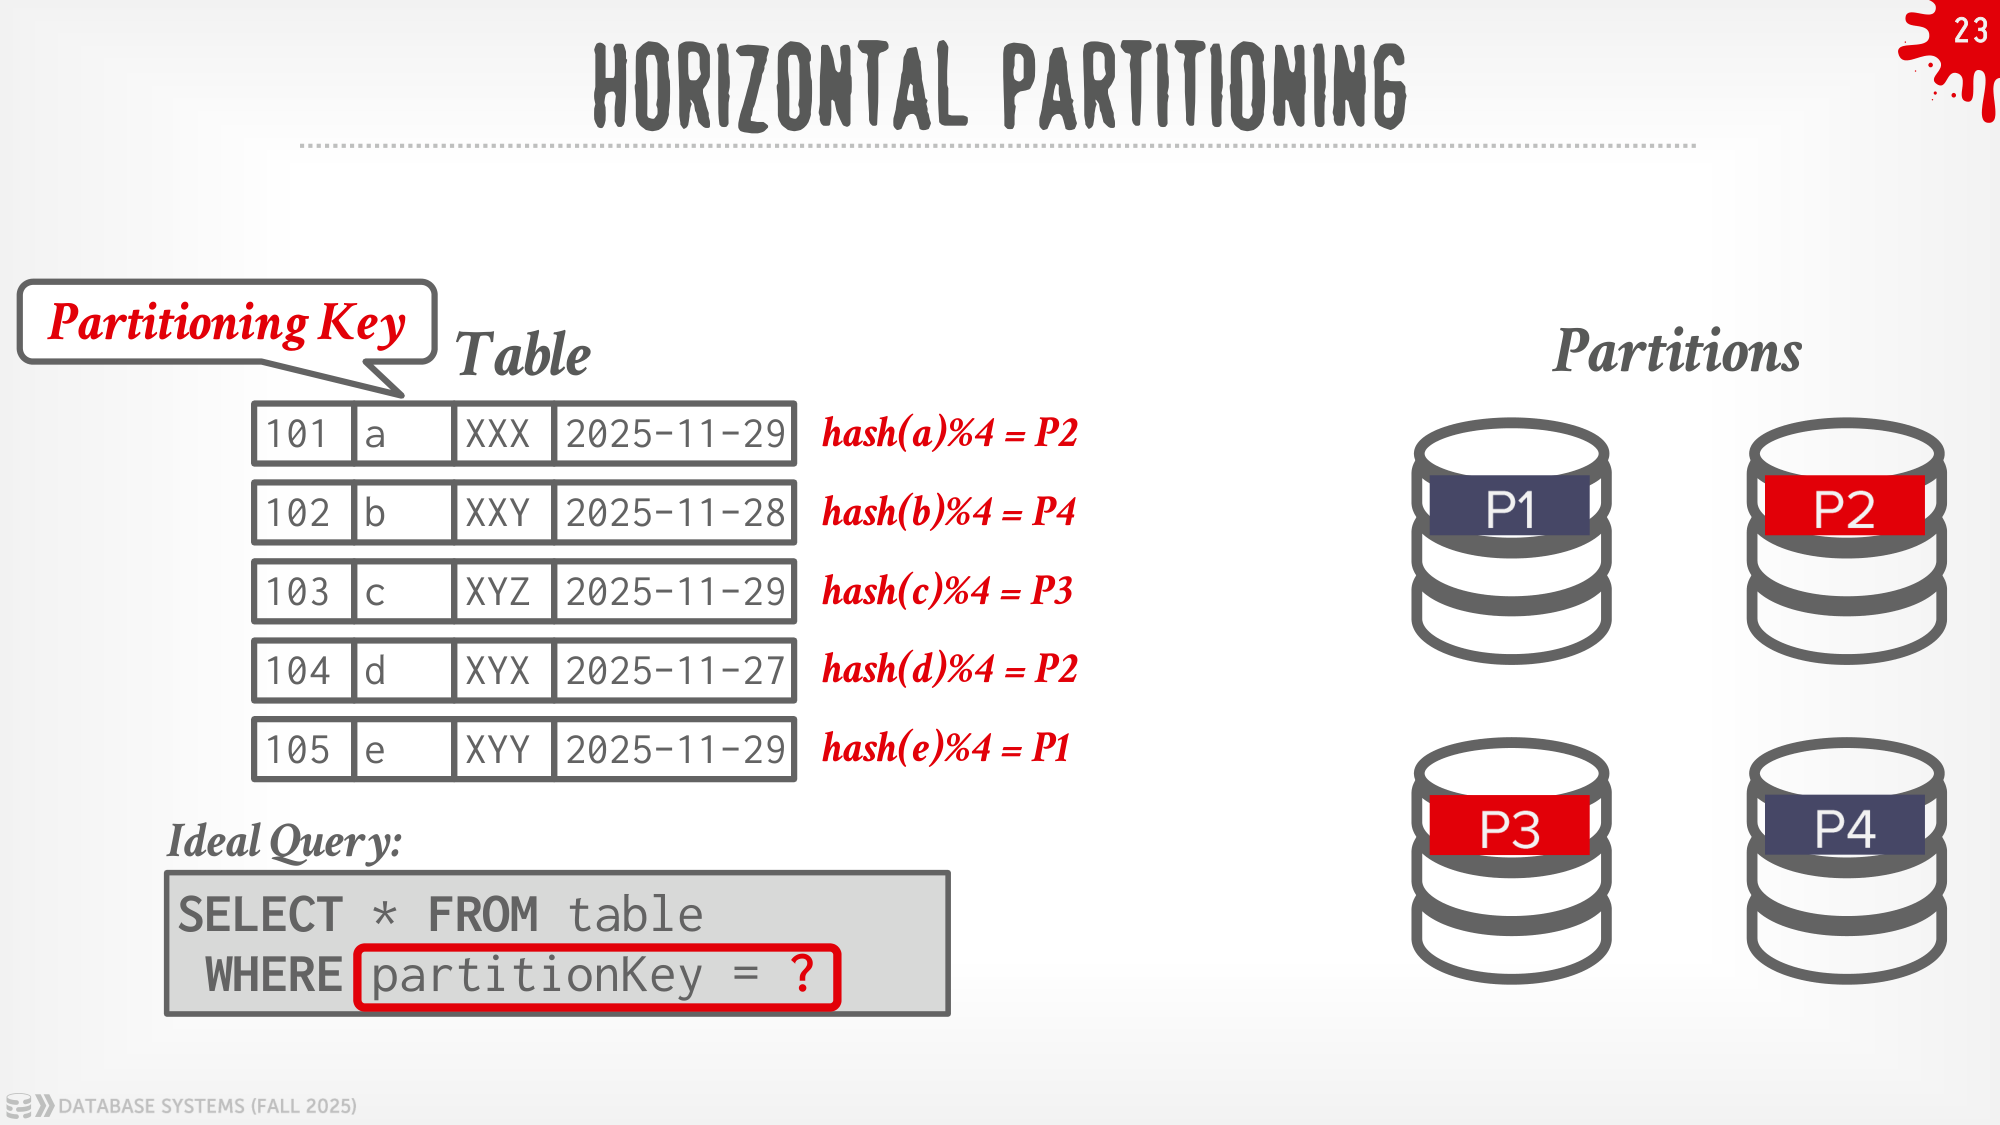
将每张表整体放到一个节点容易实现,但一张大表仍受单节点容量限制,跨表连接也可能搬运大量数据。Vertical Partitioning 按列拆分,需要保留重组记录的标识;Horizontal Partitioning 按行拆分,通常根据哈希、范围或其他谓词选择分区。
分区键应结合访问模式选择。让常一起访问的数据位于同一分区,可以增加单分区事务比例,减少跨节点协调;只追求每个分区记录数相同,仍可能让热点请求集中在某个节点。
在 Shared-Disk 中,分区还可以描述哪个节点负责哪些键,而不要求物理文件只存于该节点。责任划分与字节存放位置需要分别理解。
节点变化时的映射
直接使用 hash(key) % 节点数,节点数量变化后可能移动大量数据。一致性哈希将键和节点映射到环上,按规则寻找负责节点,使变化主要影响相邻范围;虚拟节点有助于改善负载分布。
Rendezvous Hashing 为每个“键、节点”组合计算分数,由得分最高者负责。增删节点时,只有获胜者发生变化的键需要重新分配。它不需要环结构,但朴素实现需要为候选节点分别计算分数。
复制的几个维度
Primary-Replica 将某份数据的更新送到指定主节点,再传播给副本;Multi-Primary 允许多个入口接受更新,需要额外协调冲突和全局结果。
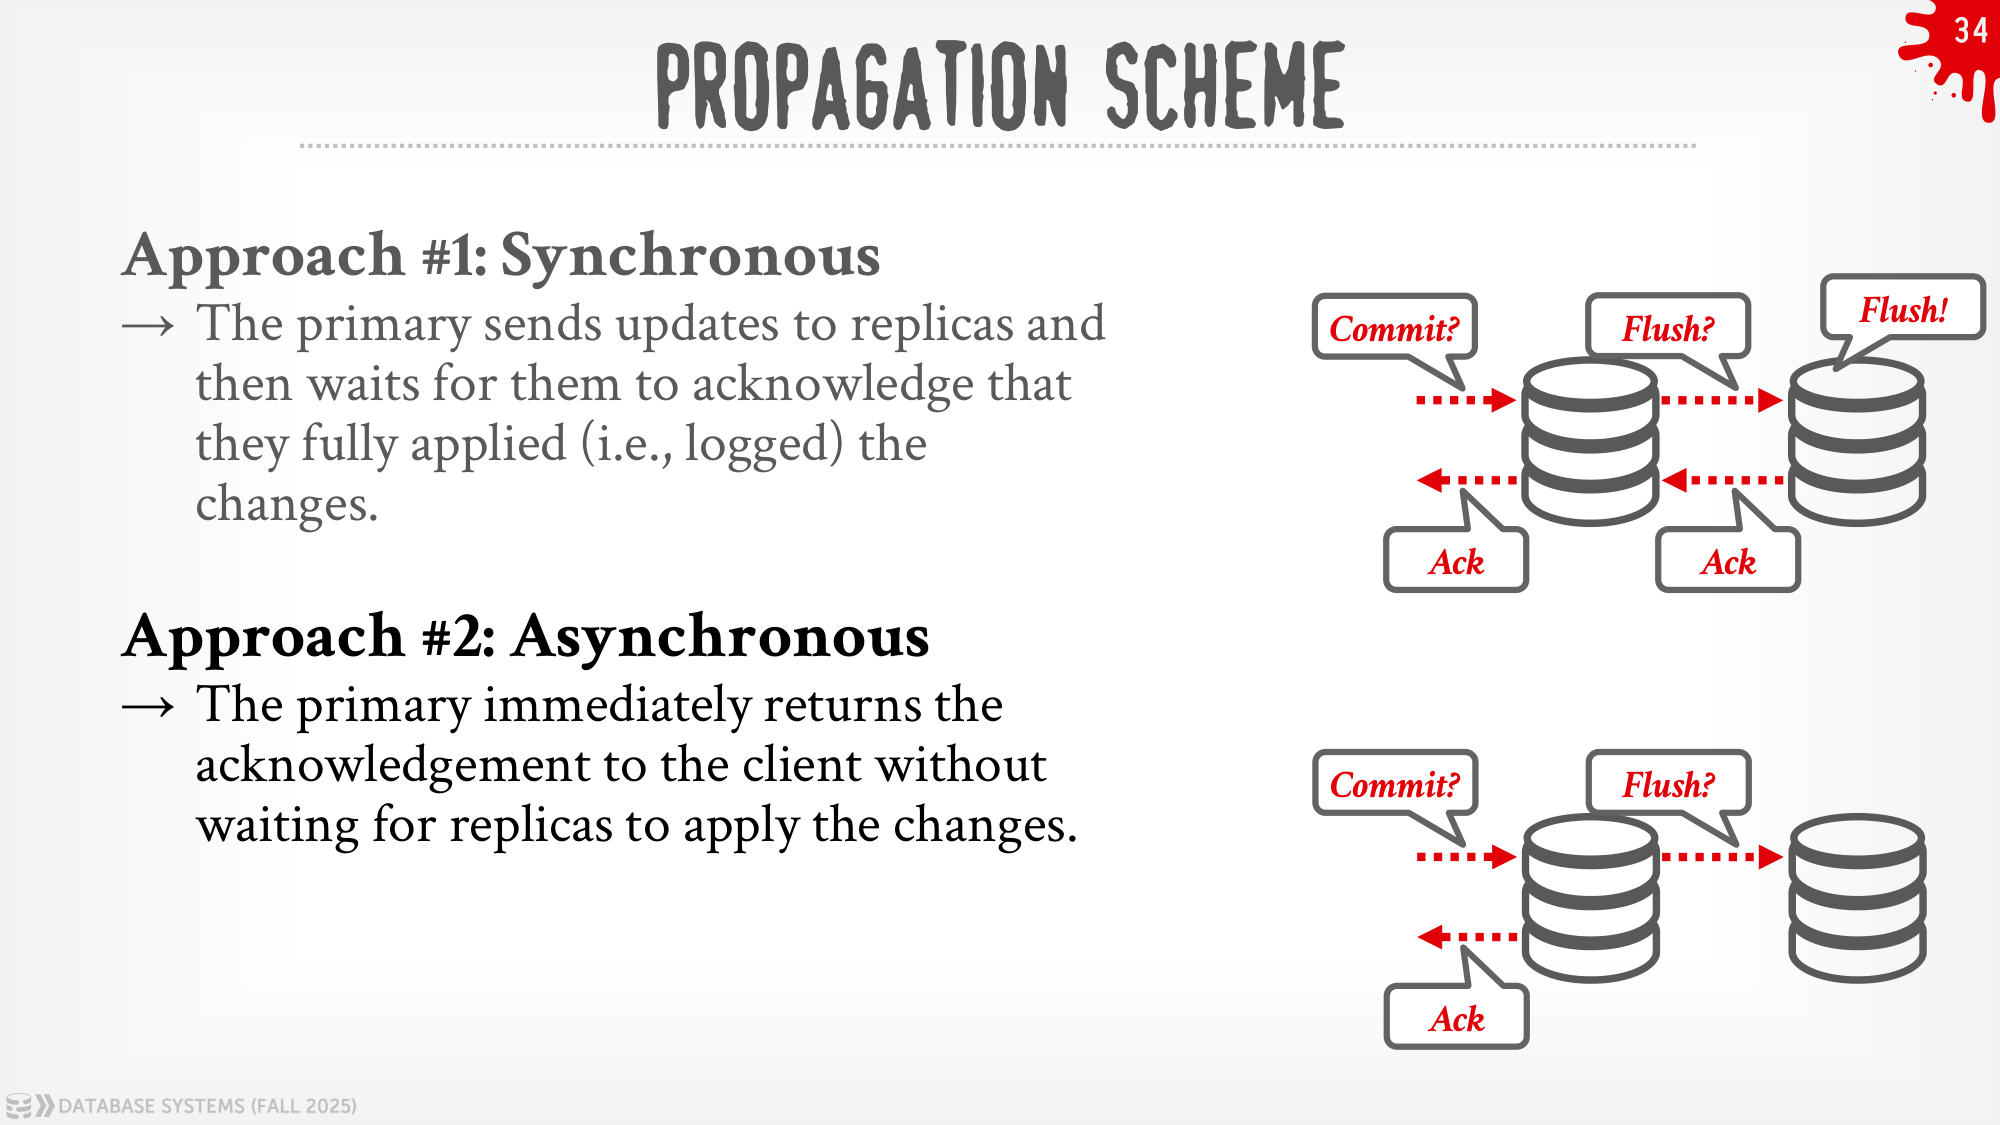
同步传播在提交确认前等待协议要求的副本确认,异步传播则可能先向客户端确认,再由副本追赶。复制延迟会影响副本读到的状态,同步确认也不自动定义所有读取的隔离语义。
Continuous Propagation 边执行边发送日志,On-Commit Propagation 则等提交后再发送。Active-Active 让副本执行操作,Active-Passive 让一处执行并传播结果;这个执行方式的分类,与谁能接受写入的主从配置不是同一维度。
事务协调与联邦数据库
集中式协调器可以承担路由、全局锁和提交安排,但要考虑瓶颈与故障恢复。去中心化方案可以让接收某个事务的节点负责协调其他参与者,使协调角色按事务分散,而不是所有事务都经过同一个固定节点。
分布式 2PL 将锁获取扩展到远端节点,等待图与死锁也可能跨节点。并发控制决定哪些操作可以同时发生,下一讲的原子提交则决定参与者如何对最终提交或中止达成一致。
Federated Database 将多个可能不同的数据库通过连接器呈现为统一查询入口。难点包括数据模型、类型与语义差异、远端支持的下推能力,以及跨系统统计和数据搬运;统一入口并不会消除这些差异。