课程视频
从哈希索引到 B+Tree
上一讲的哈希表擅长等值查询,但是 key >= 100 这样的范围条件无法直接利用哈希值定位一段连续的数据。B+Tree 将键保持有序,既能沿树定位单个键,也能找到范围起点后顺着叶子节点扫描。
B+Tree 是多路平衡搜索树,所有叶子到根的距离相同。内部节点保存分隔键和子节点指针,实际记录或记录位置保存在叶子节点中;叶子之间通过链表连接。一个节点能够容纳许多键,因此树的扇出很大,访问大型索引通常也只需经过少量层级。
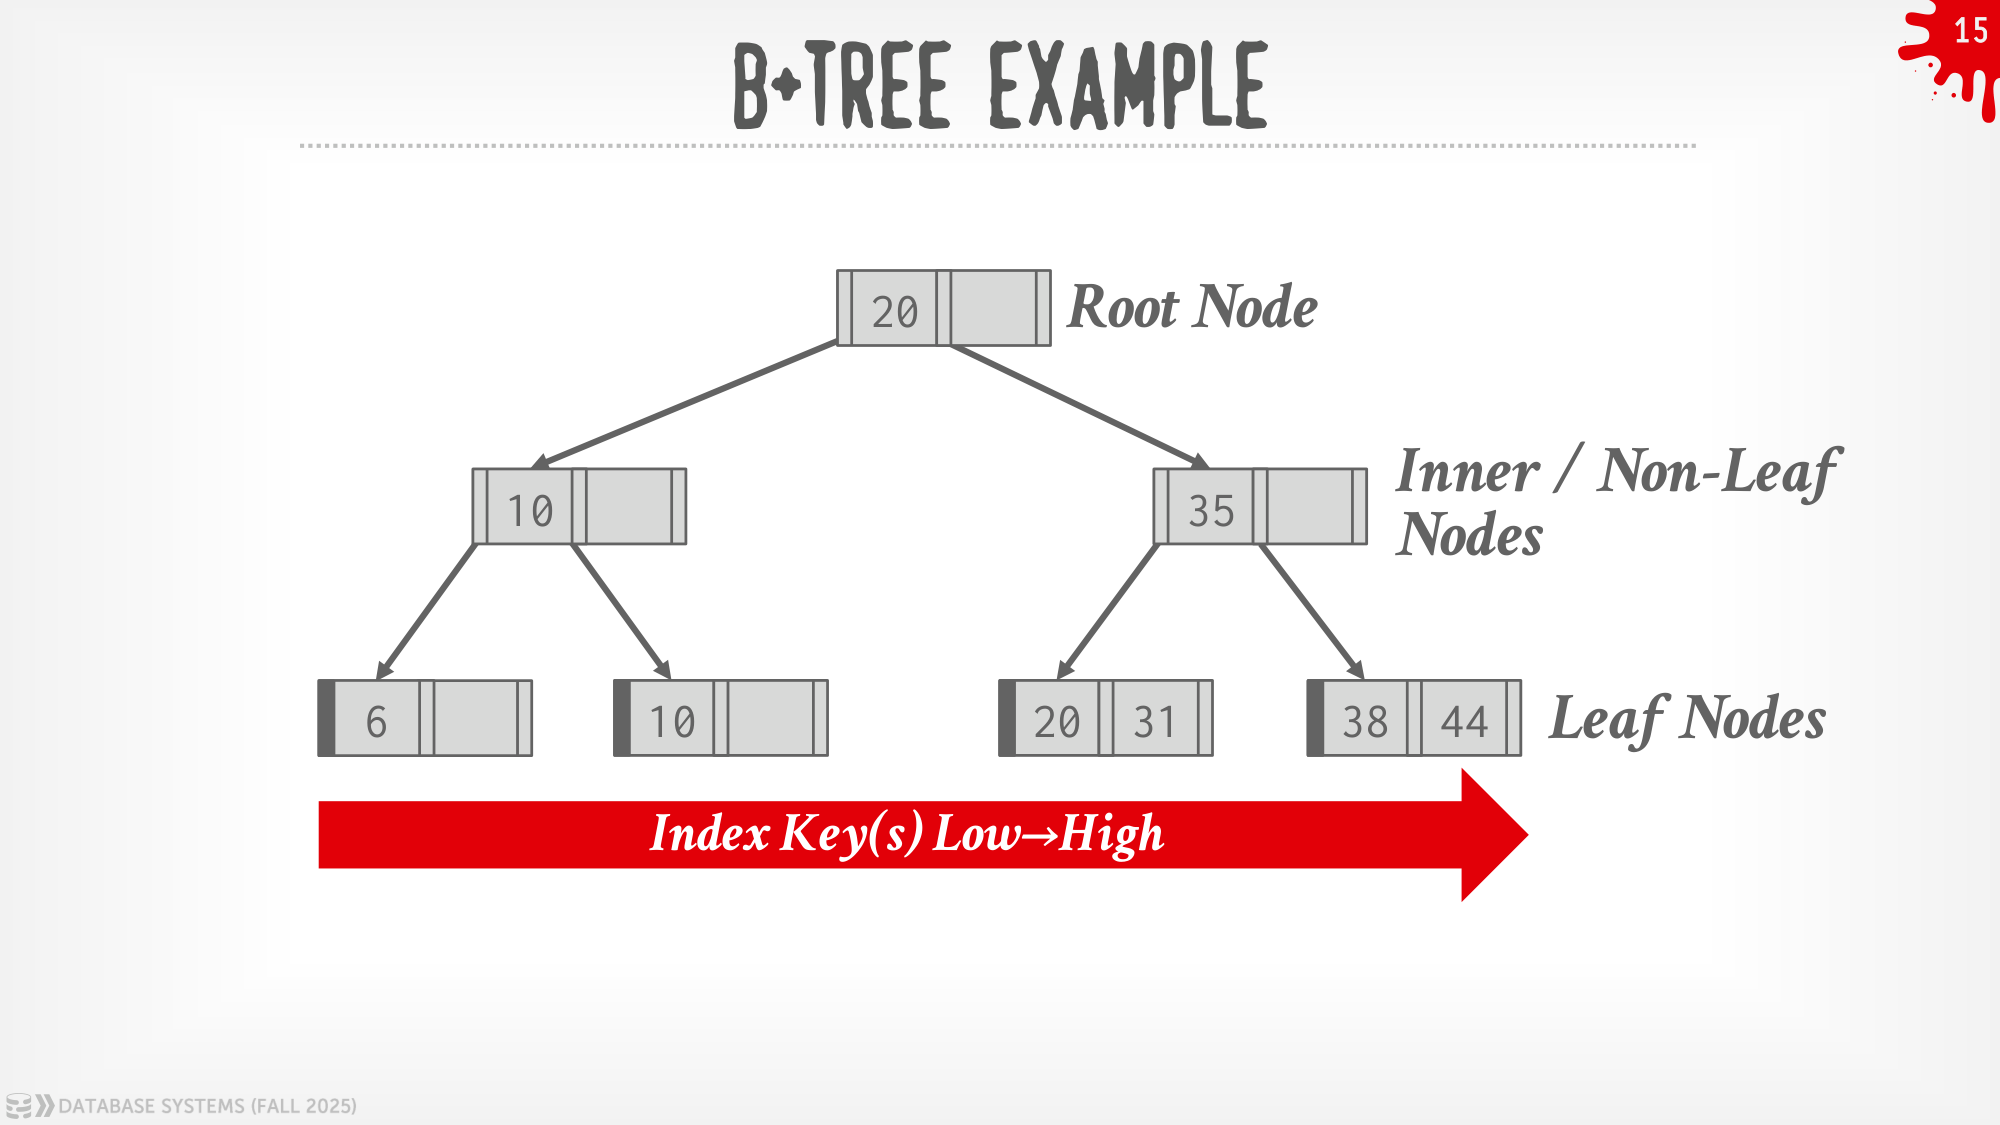
课程区分了叶子节点的两种内容:索引组织表可以直接存放完整元组,辅助索引通常保存键和 Record ID。后者定位到叶子后,还需要根据 Record ID 访问数据页。B-Tree 也允许在内部节点存记录,B+Tree 则将数据集中在叶子,内部节点可以容纳更多导航信息。
插入、分裂与删除
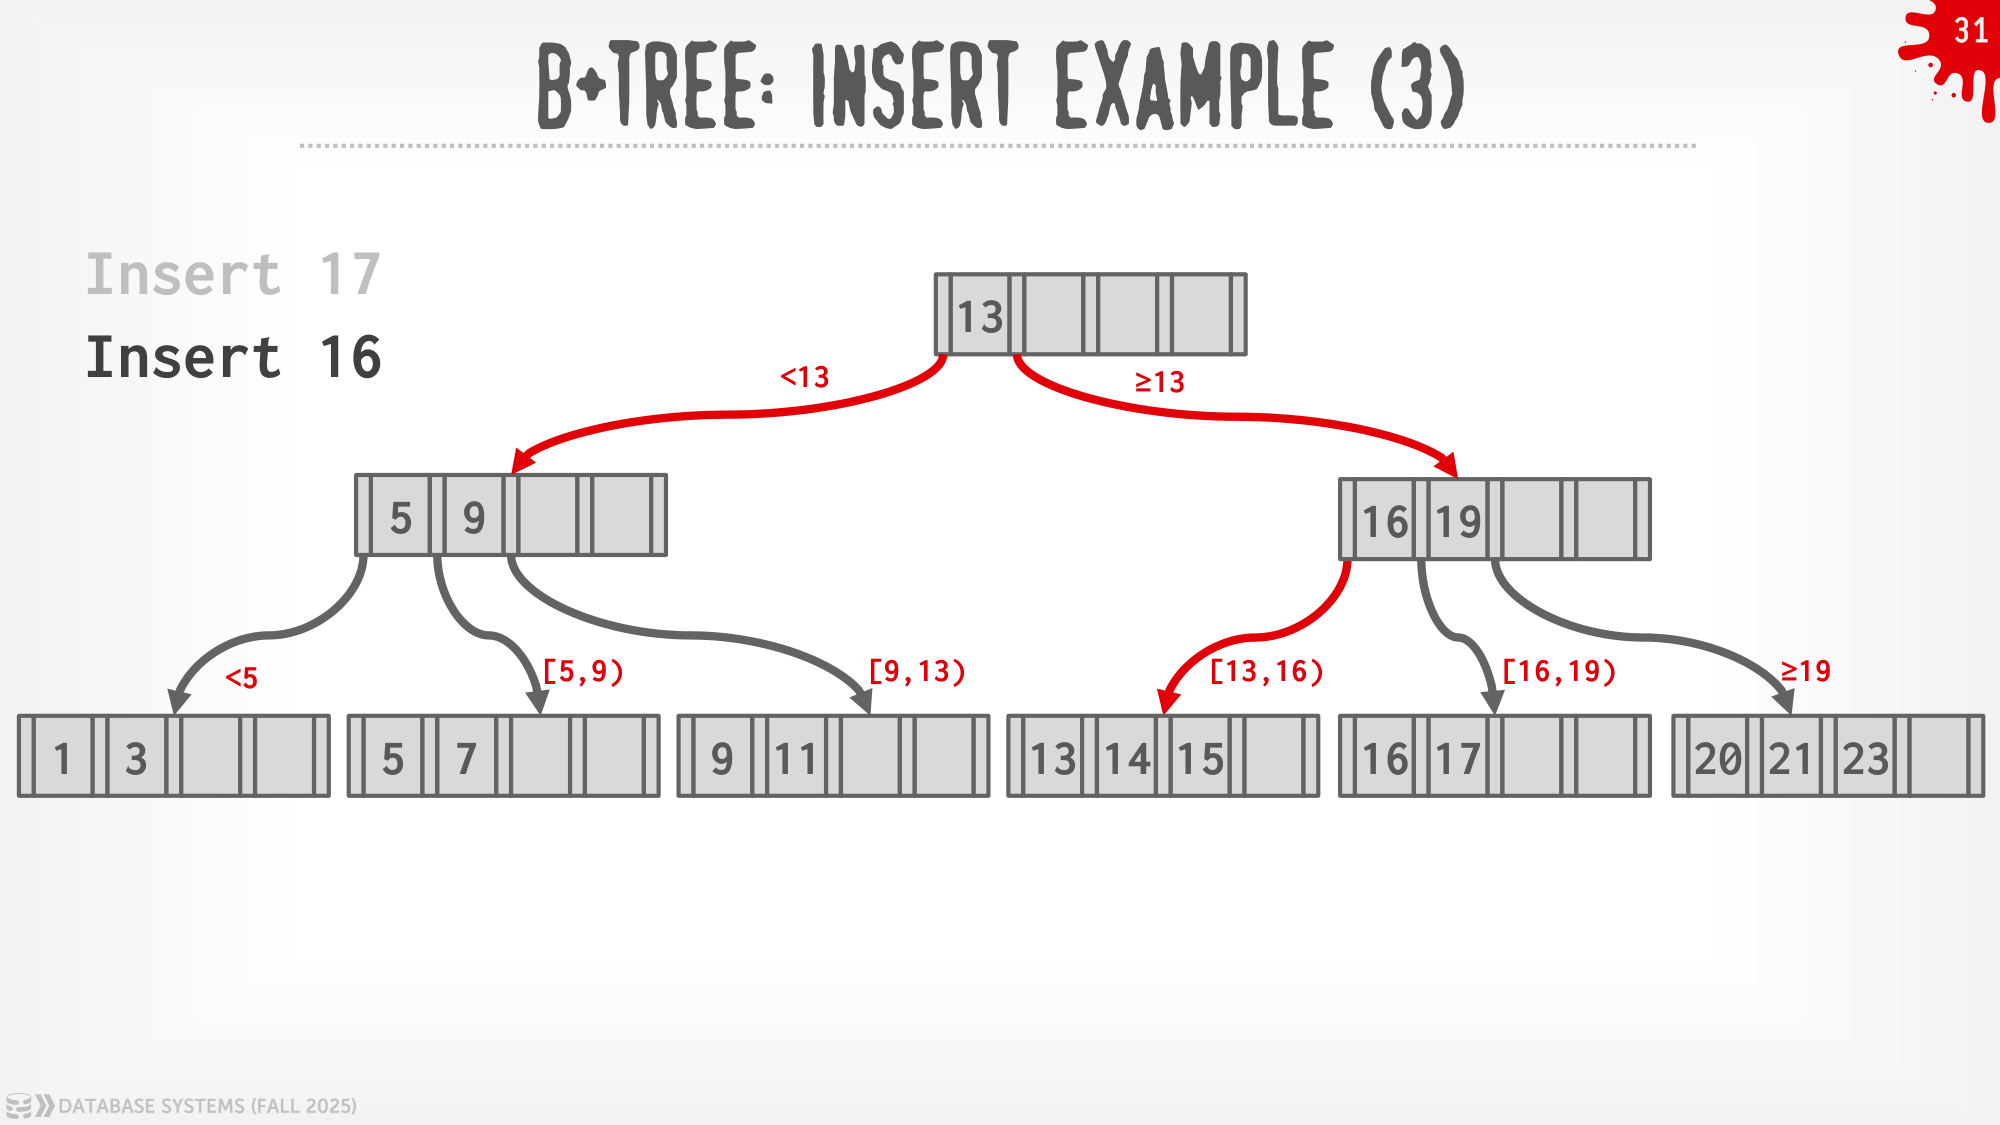
插入时先找到目标叶子,在节点内按序插入。如果节点空间不足,就将条目分配到两个节点,并向父节点增加一个分隔键和指针。父节点也可能继续分裂,直到遇到有空间的节点,或者分裂根节点并增加一层。
课件先演示插入 6、8,再演示需要修改上层节点的插入过程。观察这些动画时,需要同时看叶子中的数据和内部节点中的边界:叶子分裂后,上层增加的是用于导航的分隔键,记录仍留在叶子中。
删除则先移除叶子条目。节点过于稀疏时,可以从相邻兄弟节点重新分配条目,或者合并节点并删除父节点中的对应入口。调整也可能向上传播。实际系统不一定每次删除都立即合并:频繁插入、删除同一范围时,过于积极的合并会造成反复分裂与合并,可以采用较低的合并阈值或延迟整理。
组合键、重复键与聚簇
组合索引按各列的顺序进行字典序比较。例如 (a, b) 先按 a 排序,a 相同再比较 b。a = 1 对应连续区间,可以定位后扫描;只有 b = 2 时,满足条件的记录可能分散在不同的 a 下,不能简单视为一次连续的范围查找。
重复键可以通过追加唯一 Record ID 来区分,也可以让一个键关联多个记录位置或溢出节点。唯一性约束检查与内部条目如何唯一标识是两个问题,不能因为叶子存储了不同 Record ID 就认为业务键满足唯一约束。
聚簇组织使相邻索引键对应的数据在物理存储上更接近,范围扫描能够减少随机访问。使用非聚簇索引时,系统也可以先收集 Record ID,按数据页排序后回表,避免反复读取同一个页面;代价是需要保存和整理中间结果。
节点布局与工程优化
节点大小需要结合介质和负载选择。较大的节点可以提高扇出、摊薄 I/O 成本,但一次点查可能读入更多无关数据,也会扩大节点内搜索和并发访问的范围。变长键可以采用间接指针、变长布局或键映射等方案,选择时还要考虑缓存局部性。
节点内可以使用线性查找、二分查找或辅助结构;键少时,连续访问的线性查找未必更慢。Pointer Swizzling 将已驻留内存页面的逻辑页号转换为可直接访问的内存指针,减少反复查页表的成本,但驱逐页面时必须正确处理这些引用。
课件最后介绍了一组针对不同成本的优化:
- 写优化 B+Tree 将更新暂存在内部节点的缓冲区中,再批量向下传播,用额外的读路径工作换取较少的随机写。
- 部分索引仅索引满足指定谓词的记录;查询只有在能保证需要的记录都在该子集中时才能使用它。
- Include Columns 将额外的输出列存入叶子,增加覆盖查询的机会,但这些列不参与搜索键排序。
- 前缀压缩、重复键去重和内部节点分隔键截短减少空间占用;截短后的键仍必须正确区分相邻子树。
- 批量建树可以先排序输入、连续填充叶子,再建立上层节点,避免逐条插入造成的反复分裂。