课程视频
同一棵计划树如何执行
SQL 被转换成执行计划后,数据通常从叶子流向根节点,但这并没有规定运算符如何相互调用。本讲比较执行模型,再介绍扫描、数据修改和表达式计算。
Iterator Model 为每个运算符提供 Next() 接口,每次返回一条记录或结束标记。父节点调用孩子的 Next(),孩子继续向下请求输入,结果再逐层返回。算子容易组合,LIMIT 收集足够结果后也可以停止继续拉取。
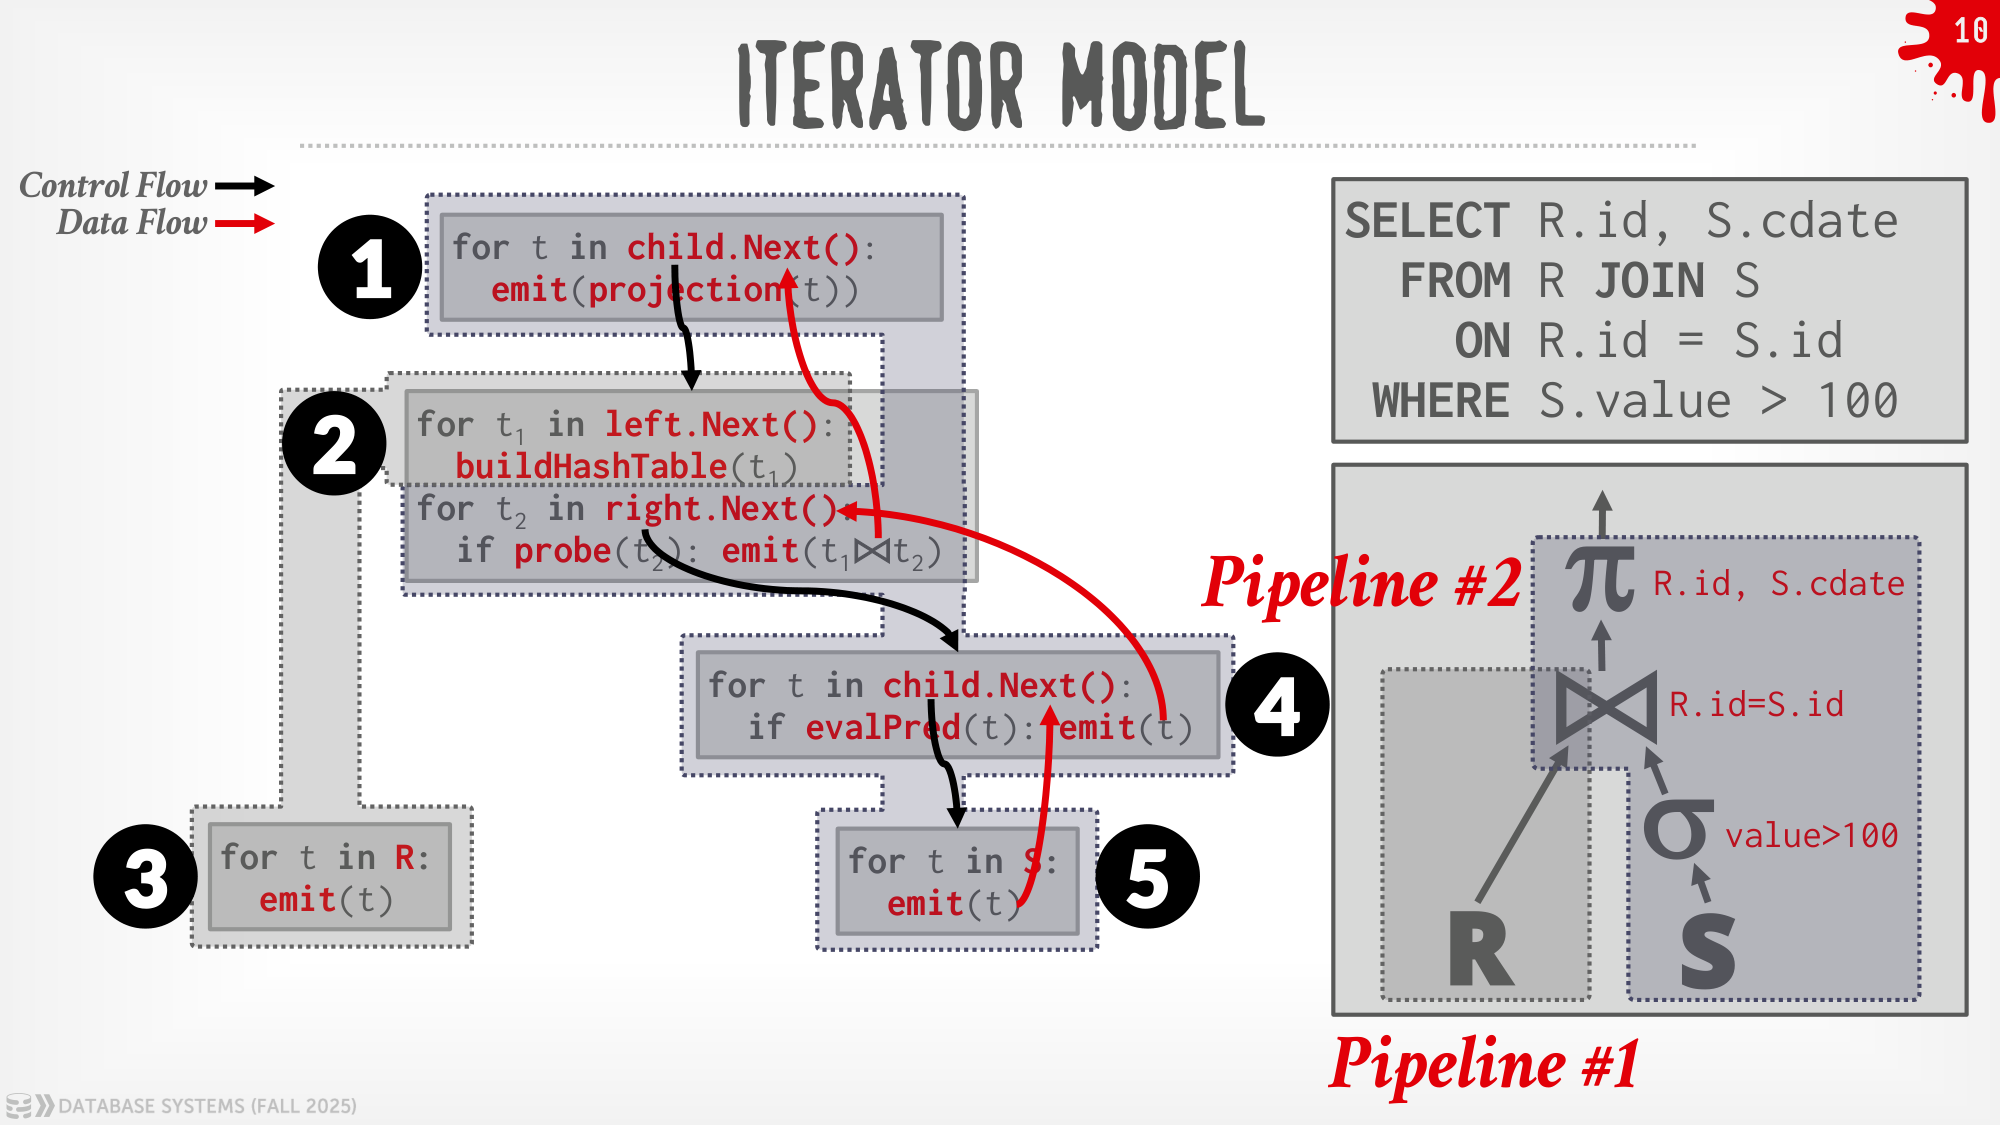
元组可以穿过一连串算子而不落盘,这段路径称为 Pipeline。排序、哈希连接的 Build 阶段等操作需要积累输入,因而形成 Pipeline Breaker。不能将所有 Join 都视为必须等两侧输入完整物化后才能输出,具体取决于算法和阶段。
物化与批量处理
Materialization Model 一次处理完整输入并返回完整结果,减少逐元组函数调用,但中间结果大时会占用大量内存甚至落盘。它适合的一个场景是只访问少量数据的短查询。
Vectorization Model 仍可使用 Next(),每次返回一批记录。一次调用摊到更多元素上,内部可以使用紧凑循环处理数组,为 SIMD、预取和 CPU 流水线提供条件。批量执行并不自动等于所有表达式都使用 SIMD,数据布局和操作本身也必须适合。
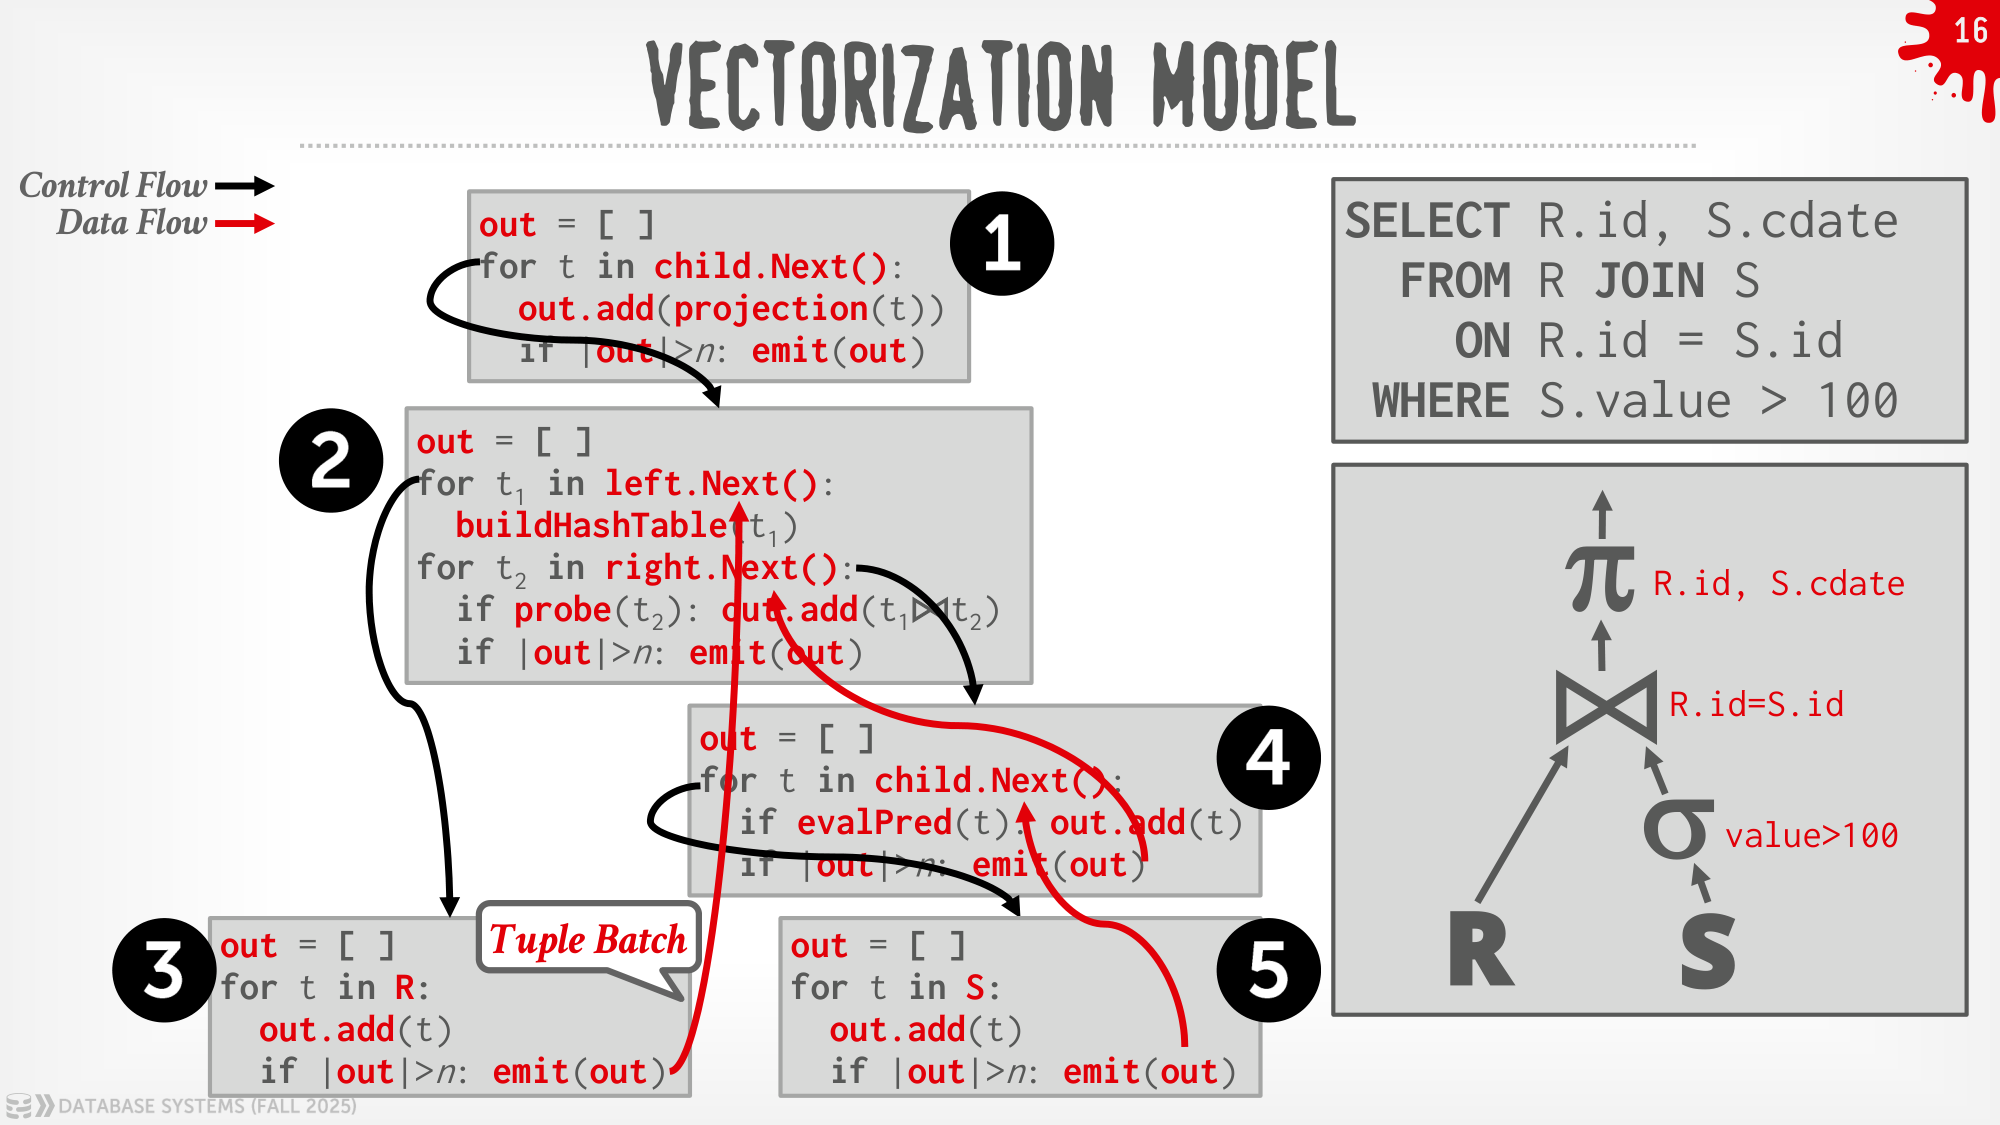
以上描述的是传输粒度,Pull 与 Push 描述的则是控制方向。Pull 从根节点发起请求,便于控制需求数量;Push 从扫描端产生数据并调用上层消费逻辑,有利于融合流水线,但也需要安排停止、背压和多输入算子的状态。
顺序扫描、索引扫描与数据跳过
顺序扫描逐页访问元组并计算谓词,可以结合预取、压缩、并行扫描、缓冲池旁路和延迟物化减少成本。它适合读取表中较大部分数据;如果索引会导致大量随机回表,顺序扫描也可能更便宜。
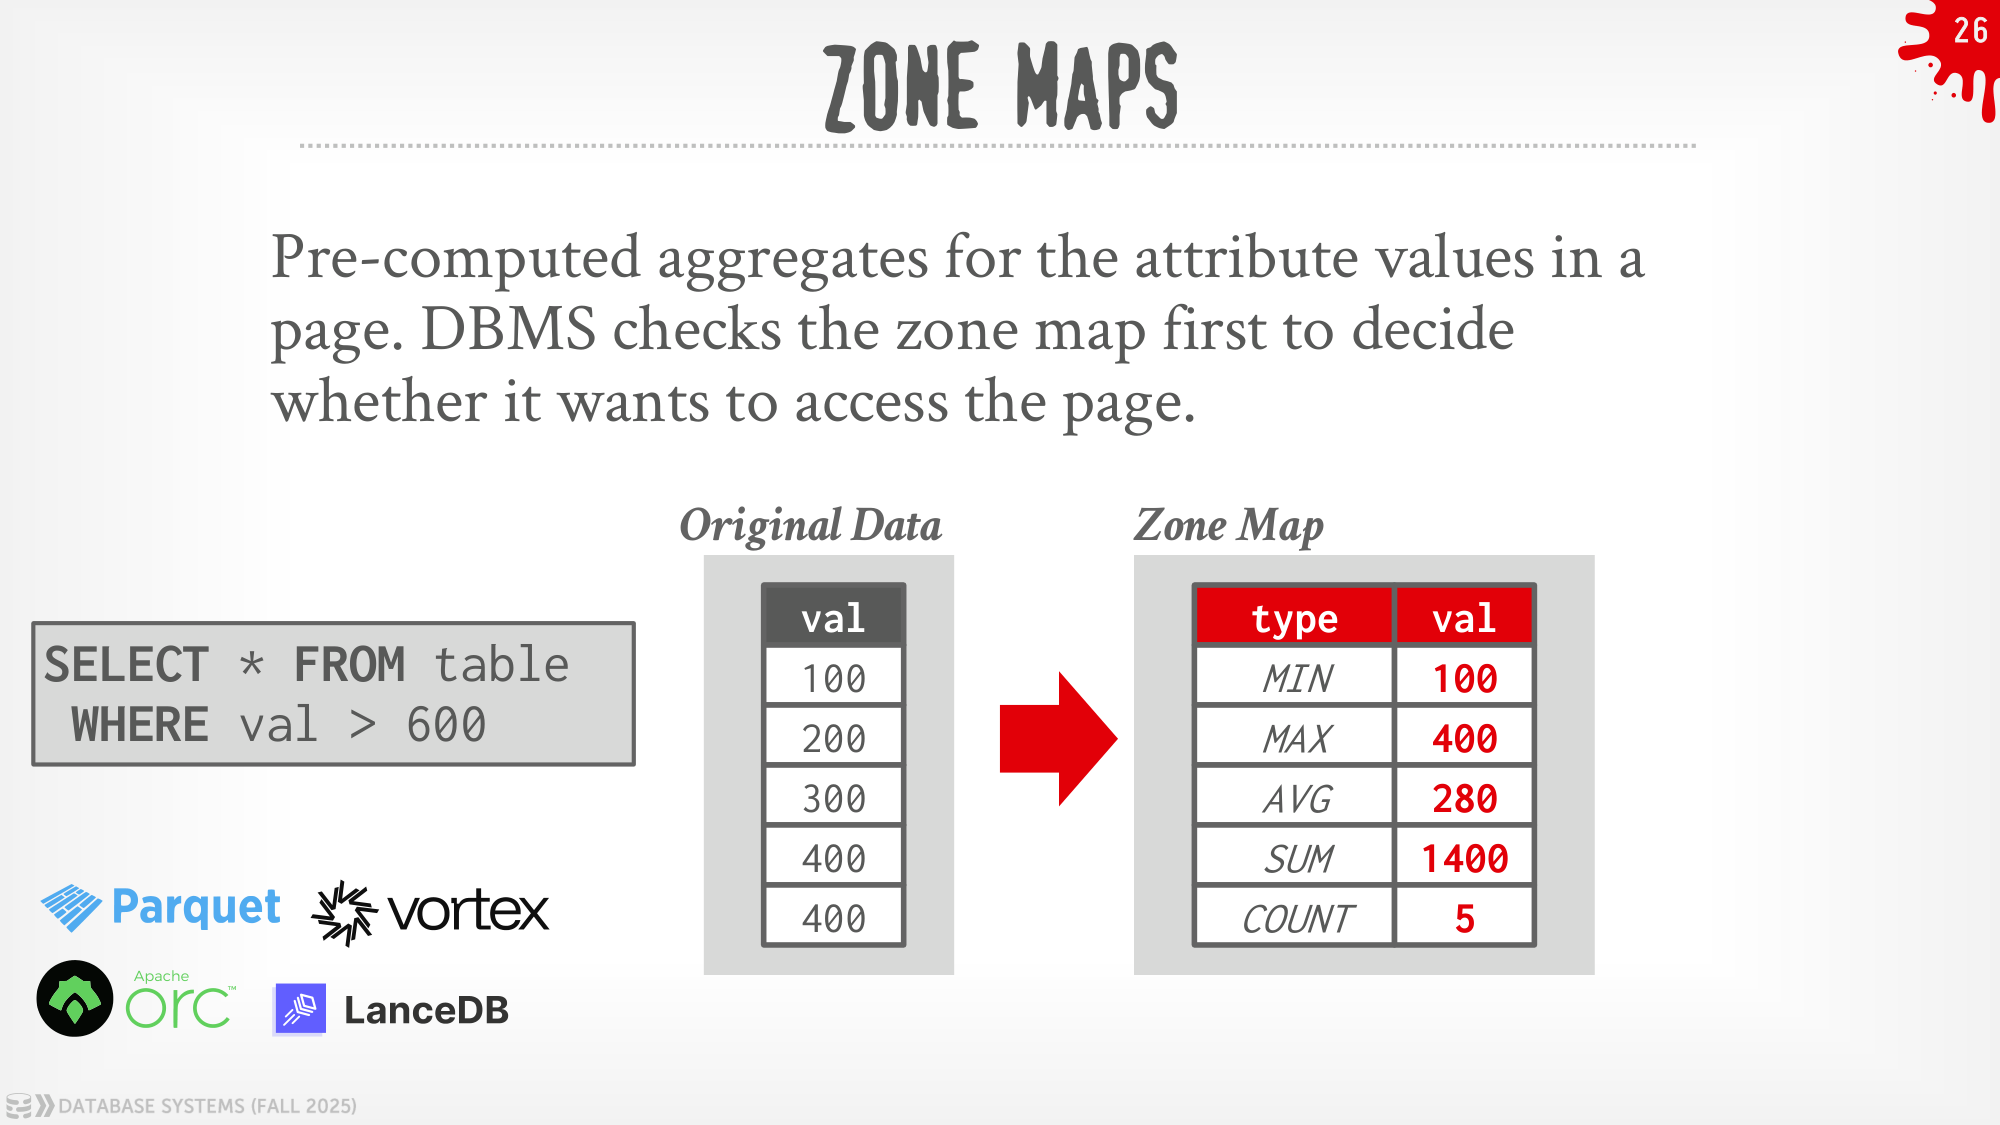
Zone Map 为页面或数据块保存最小值、最大值等摘要。例如块中最大值只有 400,查询 value > 600 时就能跳过整块。摘要无法排除某块时仍要检查具体记录,因此它属于无损的数据跳过;采样近似查询则允许结果误差,两者不能混为一谈。
索引扫描需要考虑索引包含的列、查询条件、取值分布和匹配数量。课件用 age 与 department 两个索引说明,不同谓词可能对应完全不同的候选规模。多索引扫描可以分别得到 Record ID 集合,再按 AND、OR 条件求交或求并,随后回表计算剩余条件。
修改查询与 Halloween Problem
INSERT、UPDATE 和 DELETE 不仅修改数据,还要检查约束、维护索引。更新和删除通常由下层算子提供目标 Record ID。
如果扫描正使用某个索引,而更新又改变该索引键,记录可能移动到尚未扫描的区域并被再次访问。这就是 Halloween Problem。解决时必须保证目标记录只按该语句应有的语义处理一次,可以先物化目标 Record ID、使用能够避免重访的访问路径,或者维护已处理记录信息。具体方式要结合引擎的并发与可见性机制。
表达式计算
谓词可以表示成表达式树,节点包含比较、布尔运算、算术、常量、参数和列引用。解释执行沿树递归求值,易于实现,但每条记录都要重复分派节点类型并访问上下文。
常量折叠提前计算与输入无关的部分,公共子表达式消除复用重复计算。代码生成可以将表达式专门化成直接执行的代码,向量化则对一批输入重复同一种操作。是否采用编译还要考虑编译时间,不能让一个很短的查询先付出更大的准备成本。