课程视频
排序在执行计划中的位置
表中的元组没有天然顺序。除了显式的 ORDER BY,分组、去重和 Sort-Merge Join 也可能使用排序。本讲开始从访问方法转向执行算法,主要按照磁盘页面读写次数分析成本,并尽量使用顺序 I/O。
排序条目由比较键和关联内容组成。关联内容可以是完整元组,也可以只是 Record ID:前者减少后续回表,后者减小排序过程中的数据量。比较还必须遵守类型、升降序、字符串排序规则和 NULL 的排序要求。
Top-N 与外部归并排序
如果只需要 ORDER BY ... LIMIT N,可以维护一个至多保存 N 个候选的堆。扫描新元组时,只有比当前最差候选更好的记录才需要进入堆,最后再对候选排序。它仍可能需要扫描全部输入,但不必保存和排序全部记录;WITH TIES 还需要保留与边界排序键相同的记录,候选数量可能超过 N。
数据超过内存后,外部归并排序分两步执行:先将能放入内存的片段排序并写成有序 Run,再将多个 Run 归并成更长的 Run,直到只剩一个有序结果。
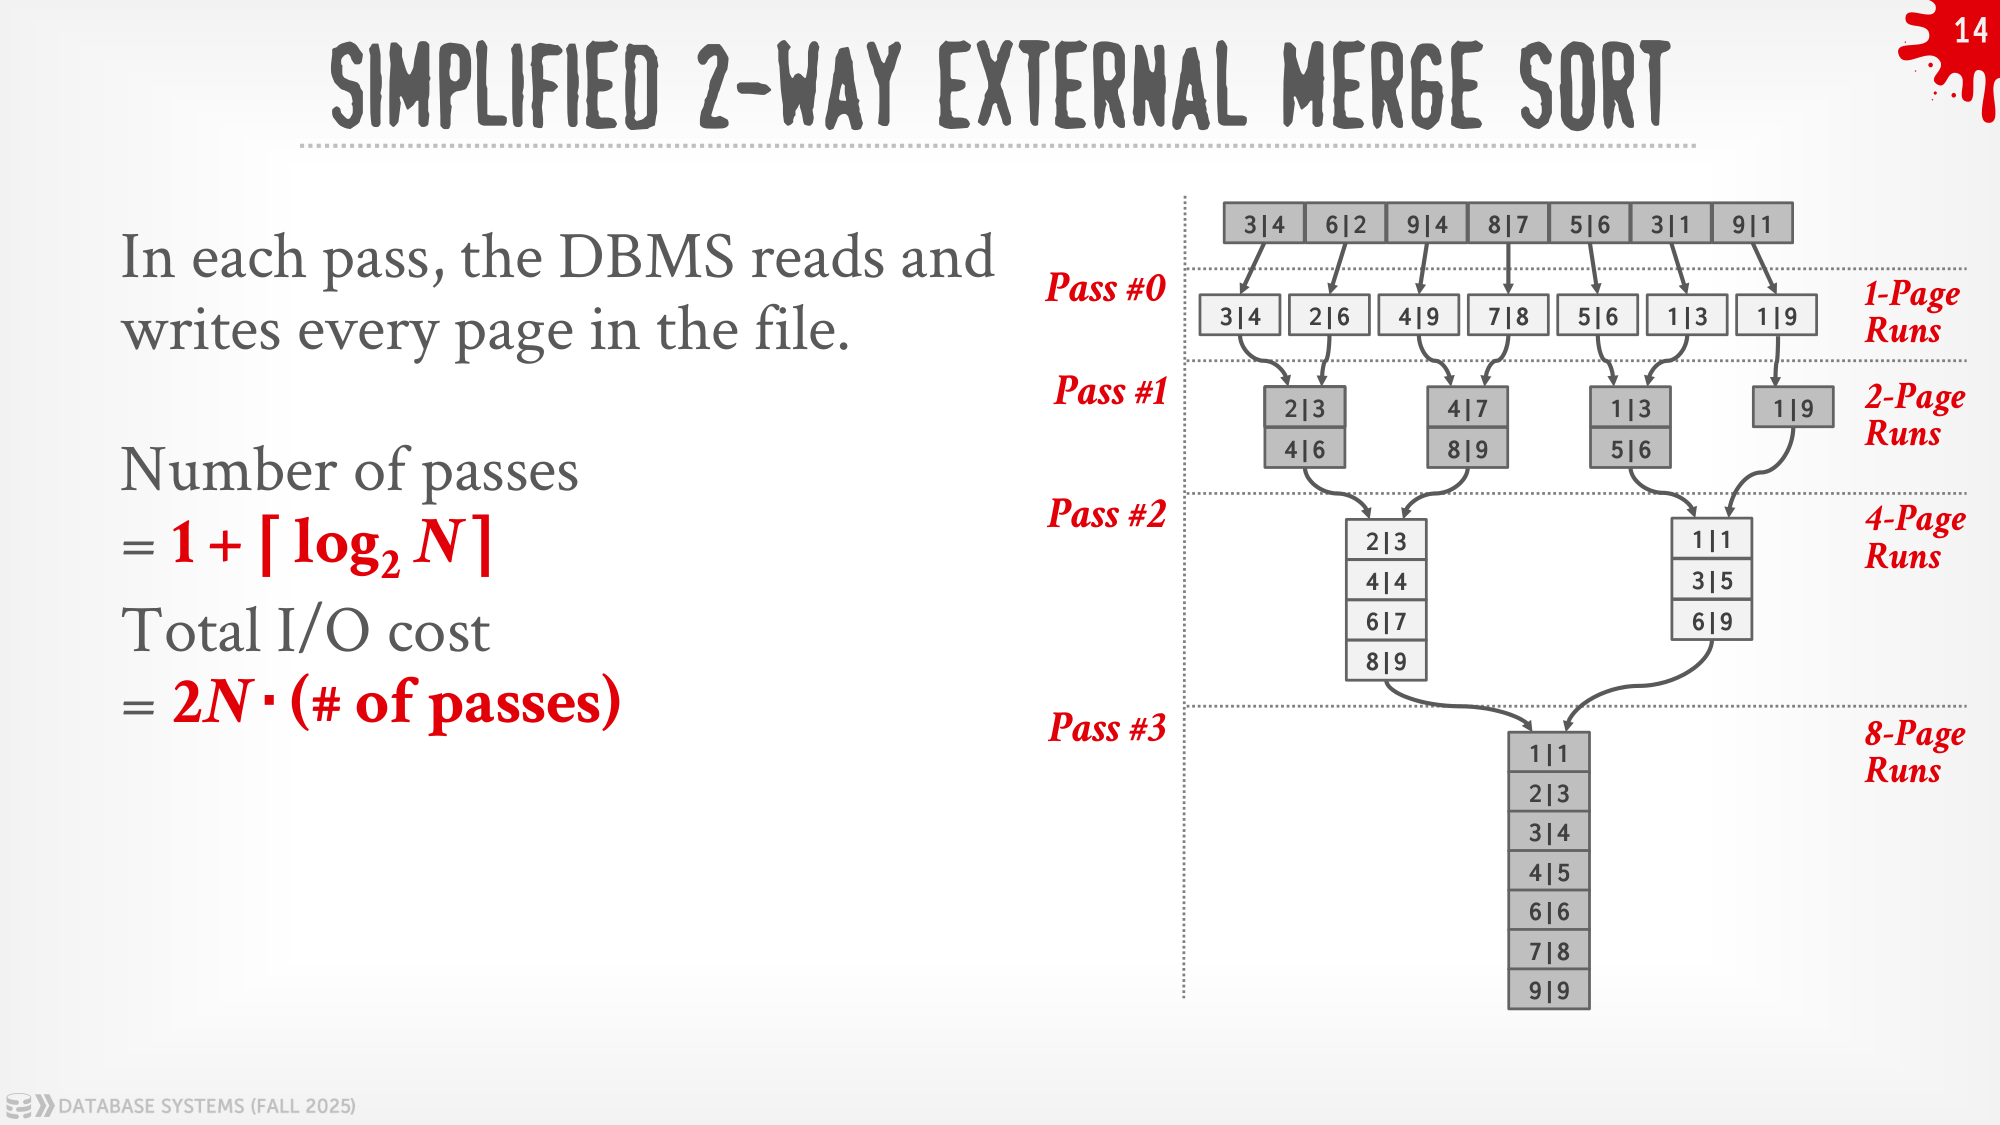
设输入占 N 页,可用 B 个缓冲页。初始排序一次处理至多 B 页,形成 个 Run。归并时保留一个输出缓冲页,其余 B−1 页分别读取各路输入,因此每轮最多归并 B−1 个 Run。忽略边界和最终流水化等优化,完整读写每一轮的成本为 2N:
这里假设 B 至少为 3。内存增大既能减少初始 Run 数量,也能增加归并路数;只有归并轮数下降时,才会出现一次少读写整个数据集的明显收益。
Double Buffering 在处理当前缓冲内容时,提前读取下一批输入,以计算覆盖 I/O 等待,但预取缓冲也占用内存,会减少可用归并路数。比较器还可以按类型专门化,先比较字符串前缀,或者将复合键规范化成保序编码,减少重复判断。
利用已有索引排序
如果 B+Tree 的键顺序满足查询要求,沿叶子扫描可以省去显式排序。聚簇组织能使读取数据的顺序更接近索引顺序,覆盖索引则可能直接提供所需列。
非聚簇索引扫描也可能带来大量随机回表。因此,“索引已经有序”不代表总成本更低,还要看需要多少行、是否覆盖查询以及是否只有很小的 Top-N。排序可以避免的收益,要与额外的数据访问成本一起估算。
排序聚合
将输入按分组键排序后,相同组的记录连续出现。执行器只需维护当前组的累计状态,遇到下一个组时输出结果并重置状态。若输入已经满足分组顺序,就能直接流式计算;否则前置排序可能成为主要开销。
聚合状态并不一定就是最终结果。AVG 需要累计 SUM 和 COUNT,最后再相除;不能直接将不同分区的平均值做不加权平均。DISTINCT 也可以利用相邻重复值进行去重。
哈希聚合与外部哈希
哈希聚合维护“分组键 → 累计状态”的临时哈希表。遇到已有键就更新状态,否则创建一个新组。它不要求输入有序,输出也不保证按分组键排序。
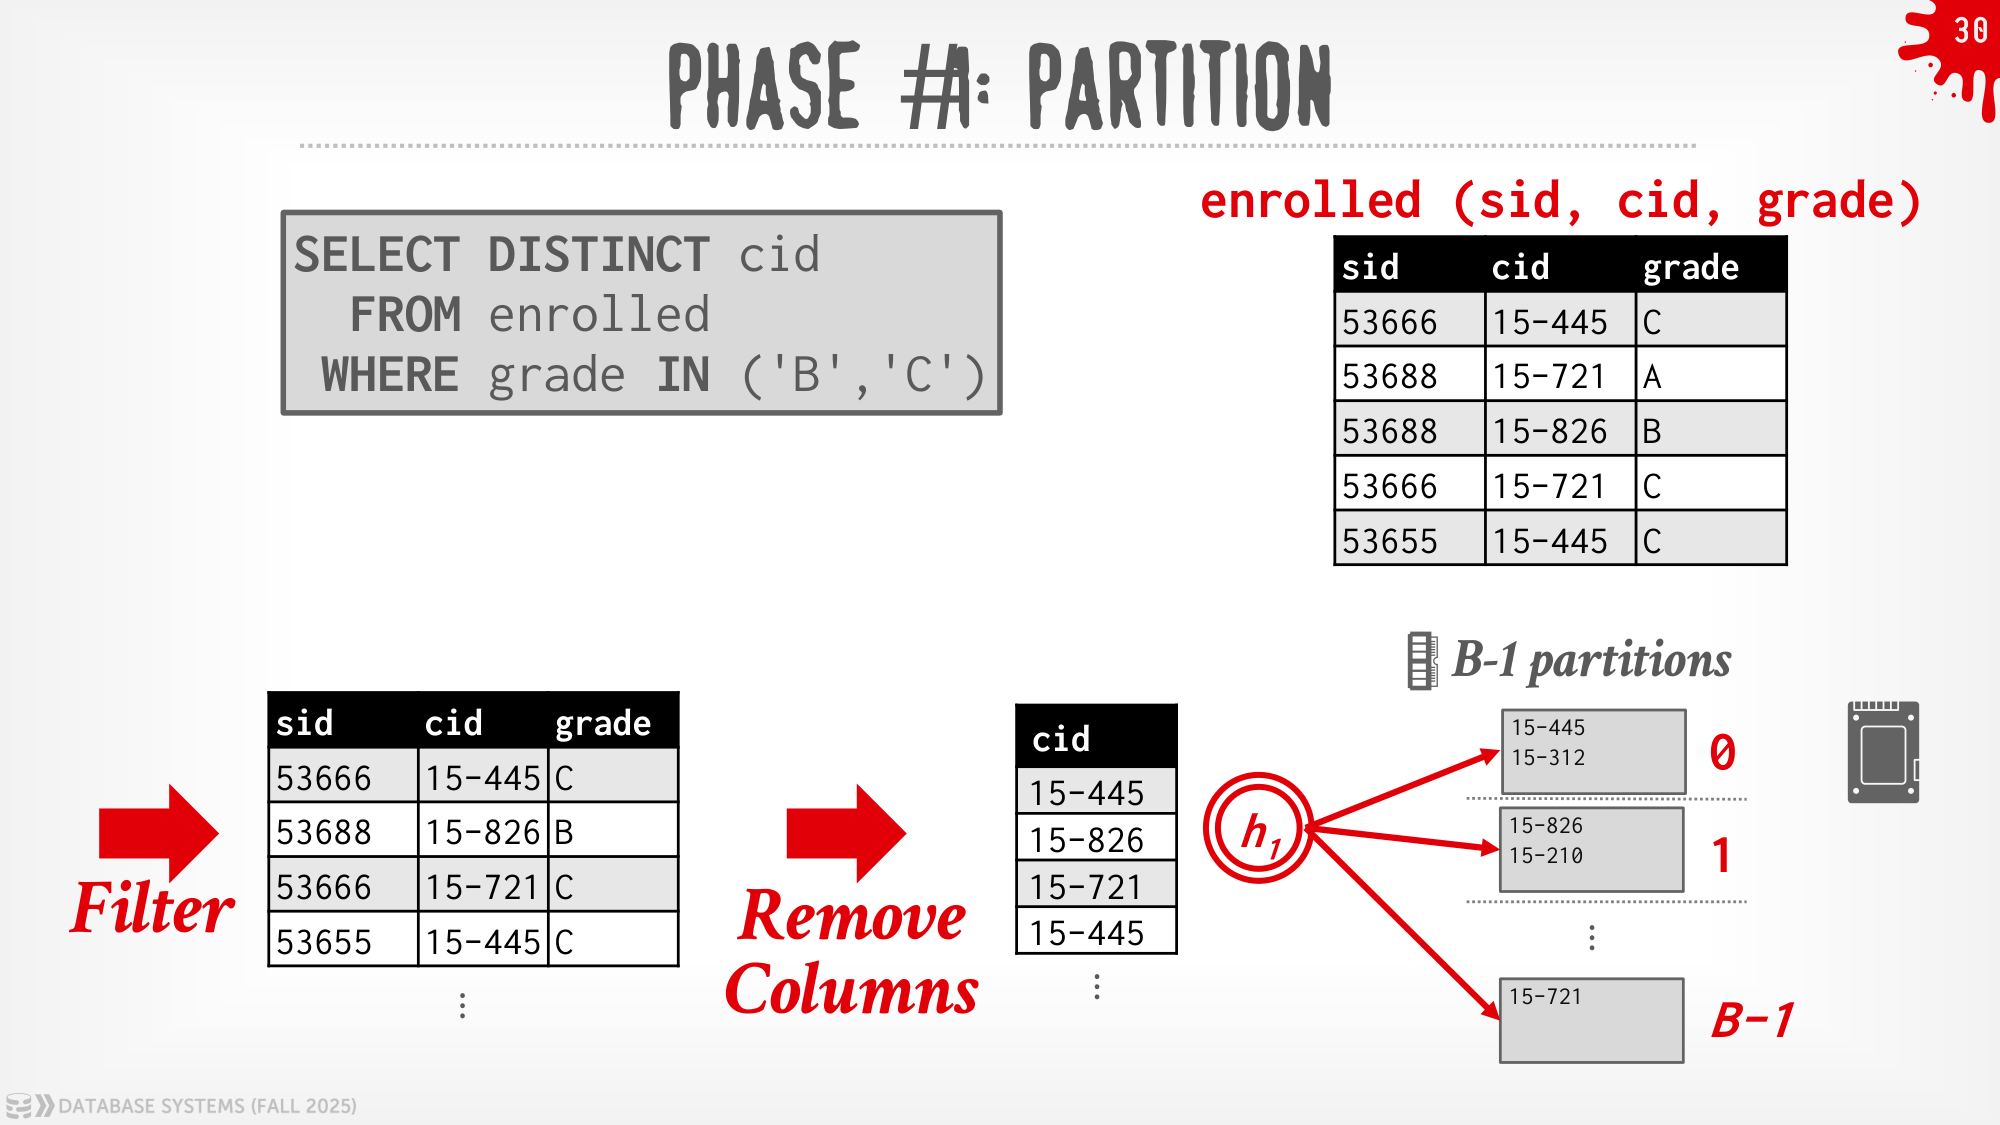
内存不足时,先用哈希函数将相同分组键的记录送入同一个磁盘分区,再逐个读回分区,用另一个哈希映射建立内存聚合表。单个分区仍过大时可以继续分区;若问题来自一个异常大的组,仅改变哈希函数无法将这个组拆到独立计算后不再合并,需要结合聚合函数设计处理方式。
排序聚合和哈希聚合的选择取决于组数、已有顺序、内存容量、倾斜以及后续是否需要排序,不能只根据算法名称决定。