课程视频
SQL 描述结果,系统决定执行方式
SQL 从 System R 项目的 SEQUEL 发展而来,用声明式语句说明需要什么结果。课程列出标准历次增加的能力,包括窗口、时间数据、JSON 和图查询,也提醒不同数据库支持的语法与扩展并不完全相同。
关系代数通常按集合讨论,SQL 默认允许重复行,采用多重集语义。DISTINCT 是显式去重操作,需要额外工作,不能因为结果“看起来重复”就默认删除。
本讲继续使用 student、course 和 enrolled 三张表。student.sid 标识学生,course.cid 标识课程,选课表通过两个外键连接它们,后面的聚合与嵌套查询都围绕这组关系展开。
聚合、分组与 HAVING
COUNT、SUM、AVG、MIN 和 MAX 把一组输入归约为标量。COUNT(*) 统计行数,COUNT(col) 统计该列非空值;COUNT(DISTINCT col) 再对非空值去重。不能在存在空值时假定这几种写法总是等价。
1 | SELECT e.cid, AVG(s.gpa) AS avg_gpa |
WHERE 在分组前筛选输入行,HAVING 对分组后的聚合结果筛选。查询还输出非聚合属性时,需要维护该属性与分组之间的语义,不能任意挑选某条输入记录的值来代替分组结果。
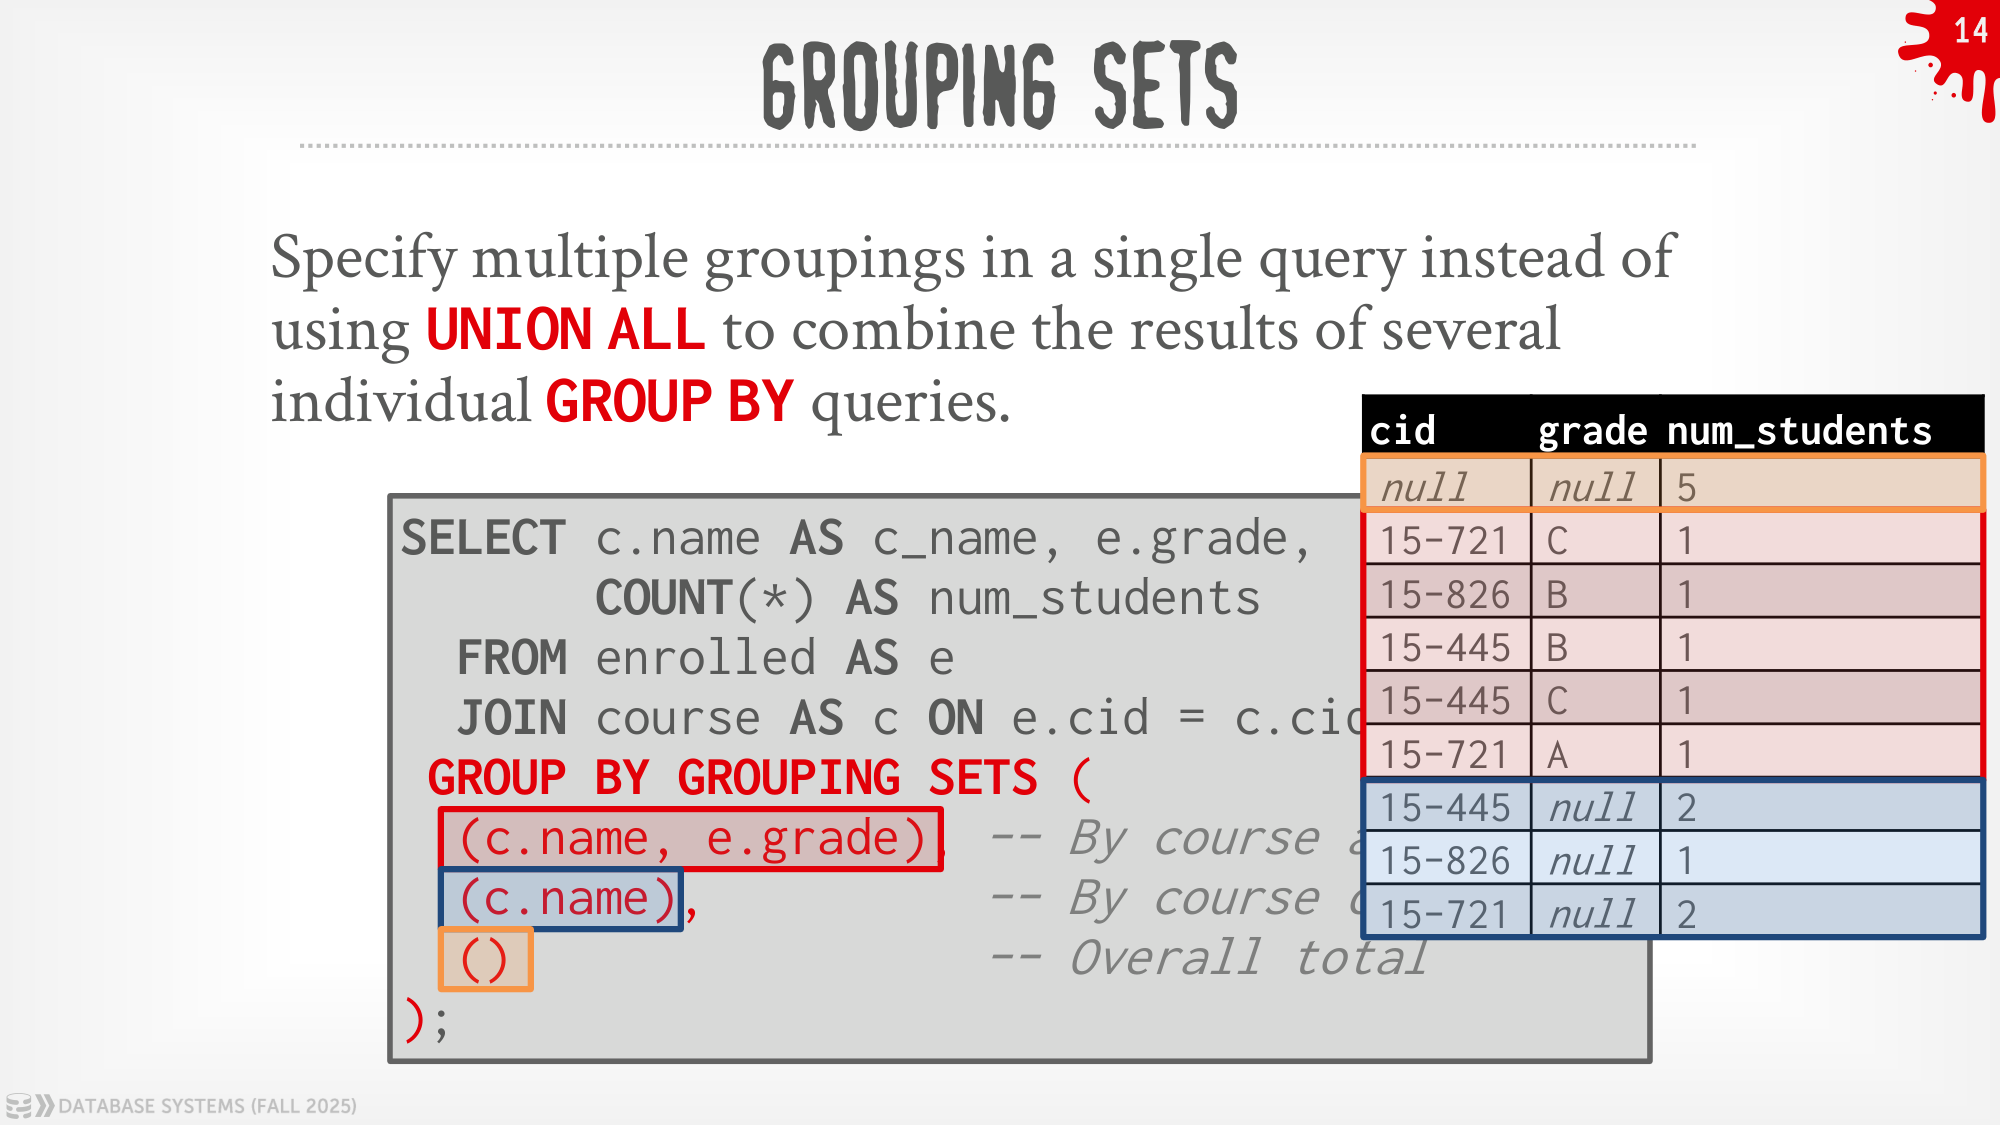
GROUPING SETS 明确列出多个分组组合,例如按课程与成绩、只按课程,以及整个输入的汇总。它让同一个查询表达多个统计层次,实际怎样共享扫描与聚合由优化器和执行器决定。
字符串、时间与输出控制
LIKE 中 % 匹配任意长度子串,_ 匹配一个字符。字符串函数、连接符、日期计算以及大小写规则存在方言差异,阅读例子时需要确认目标数据库的具体语义。
没有 ORDER BY 时,结果顺序没有保证。LIMIT 只限制返回数量,不会自动定义“前几条”的稳定含义。需要稳定分页时,排序条件还应能区分并列记录。
查询结果可以通过 INSERT ... SELECT 写入已有表,或使用对应方言支持的建表/输出重定向语法保存为新表。保存结果与只给子查询命名并不是同一个操作。
嵌套查询与 Lateral
子查询可以出现在输出、FROM 或条件中。无关子查询不引用外层值;相关子查询使用外层记录作为参数,逻辑上可能随每条外层记录变化。
1 | SELECT * |
这个例子寻找无人选修的课程。EXISTS 判断是否存在结果,IN 检查成员关系,ANY 与 ALL 则结合比较表达不同量化条件,空值和空输入时也需要维护各自语义。
Lateral 允许 FROM 中后面的子查询引用前面输入的列,可以用来对每门课程计算人数和平均 GPA。它表达数据依赖,并不要求数据库一定逐行执行;后续优化器有机会将其改写。
CTE 与窗口函数
CTE 通过 WITH 给当前语句中的辅助查询命名,便于分解复杂逻辑。递归 CTE 在初始结果基础上不断执行递归部分,需要明确终止条件。
1 | WITH RECURSIVE numbers(n) AS ( |
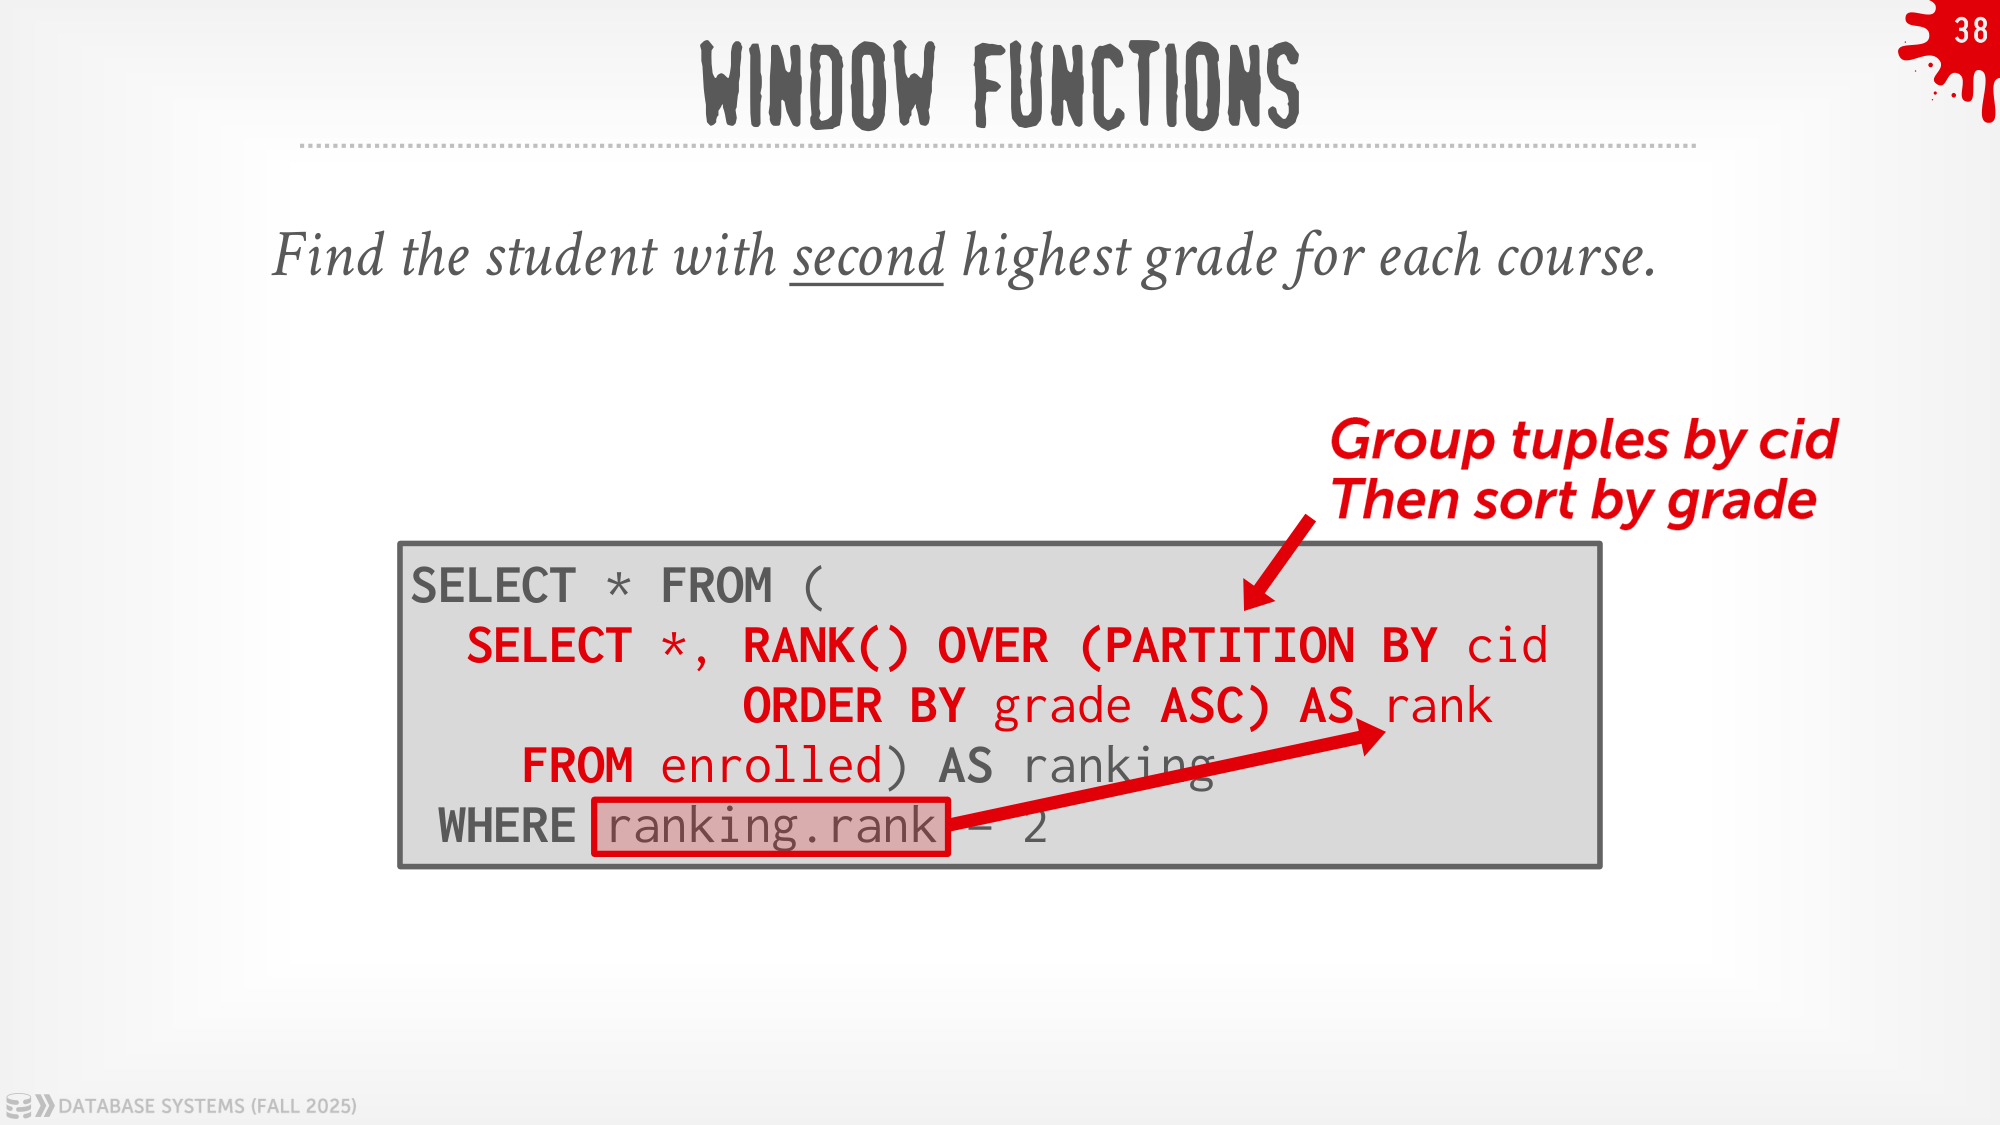
窗口函数与分组聚合的区别是保留输入行。OVER 定义分区、排序和需要的窗口范围,ROW_NUMBER 逐行编号,RANK 对并列值给予相同名次并可能留下空档。课程用按课程分区、按成绩排序的查询寻找第二名;并列时返回几人,取决于选用的排名函数,而不是简单的第二条记录。