课程视频
搜索算法与物理属性
本讲先延续 System R 与 Top-Down 搜索。动态规划复用较小关系子集的结果,Memo 则复用等价表达式与子目标的探索结果。除了输出哪些列,计划还可能要求输入按某个键排序、按某个键分区;不能满足要求时,需要 Sort、Exchange 等 Enforcer 提供属性,这些操作也要计入成本。
成本模型
计划成本可能包含页面 I/O、CPU、内存和网络工作量。磁盘访问重要,但数据已经驻留内存时,表达式计算、哈希、比较和缓存访问可能成为主要开销,不能始终忽略 CPU。
课件以 PostgreSQL 的模型说明,顺序页面读取、随机页面读取和元组处理可以分别赋予成本系数。估算值用于比较候选,不一定对应真实执行的毫秒数。模型需要估计每个算子处理多少行,因此基数估计会直接影响连接方向、算法和内存判断。
统计摘要
Catalog 可以保存表行数、列的不同值数量、NULL 比例、最小值与最大值等信息。只保存一个平均频率无法反映数据倾斜,因此还需要更丰富的摘要。
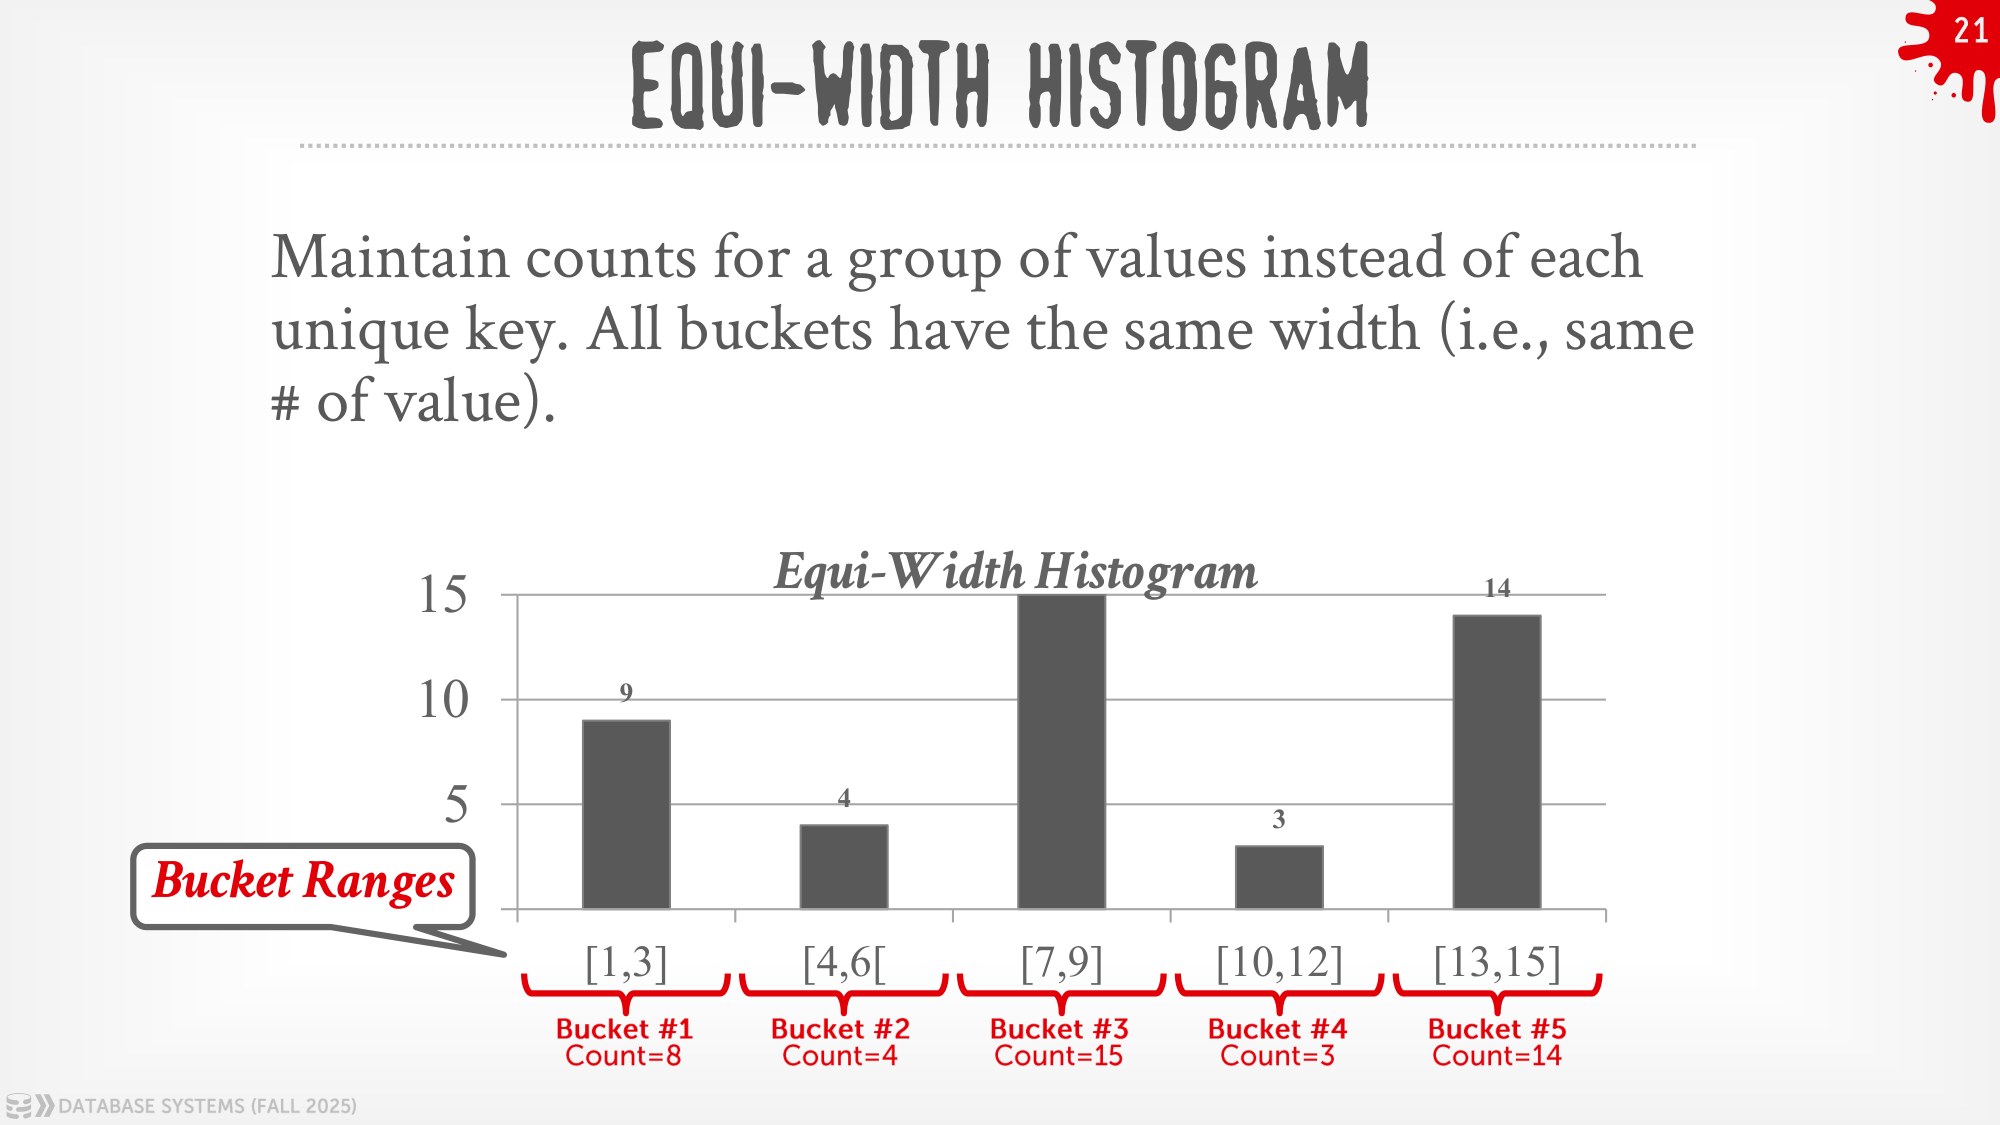
Equi-Width Histogram 将值域划成等宽区间,记录每个区间的频率;Equi-Depth Histogram 让每个桶包含大致相同数量的记录,桶宽随数据密度变化。高频值可以单独保存,其余值再使用平均分布,避免热点被平均值抹平。
课件还介绍了两类 Sketch。Count-Min Sketch 使用多组哈希计数器估计某个值的频率,碰撞通常使估计偏大,取各组估计的最小值减少这种影响。HyperLogLog 则根据哈希值的位模式估计不同值数量,用较小空间换取可控的统计误差,两者回答的问题不同。
Sampling 可以在样本上计算谓词的命中比例,再推算原表。维护固定样本与按需读取真实表都有成本,样本代表性、稀有值和数据更新会影响效果。
单个条件的选择率
设 R 有 条记录,列 A 有 个不同值。假设非 NULL 值均匀分布,等值谓词的选择率约为 ,输出行数约为 。这只是均匀假设下的估计,已知高频值应使用实际频率摘要。
范围条件可以按直方图覆盖的桶估计,落在桶内部时还需要进一步假设桶内分布。唯一键等值查询通常至多匹配一行,但统计系统仍要区分“至多一行”与“该键确定存在”。
多个条件与相关性
在独立、二值逻辑等简化条件下,可以用概率规则组合选择率:
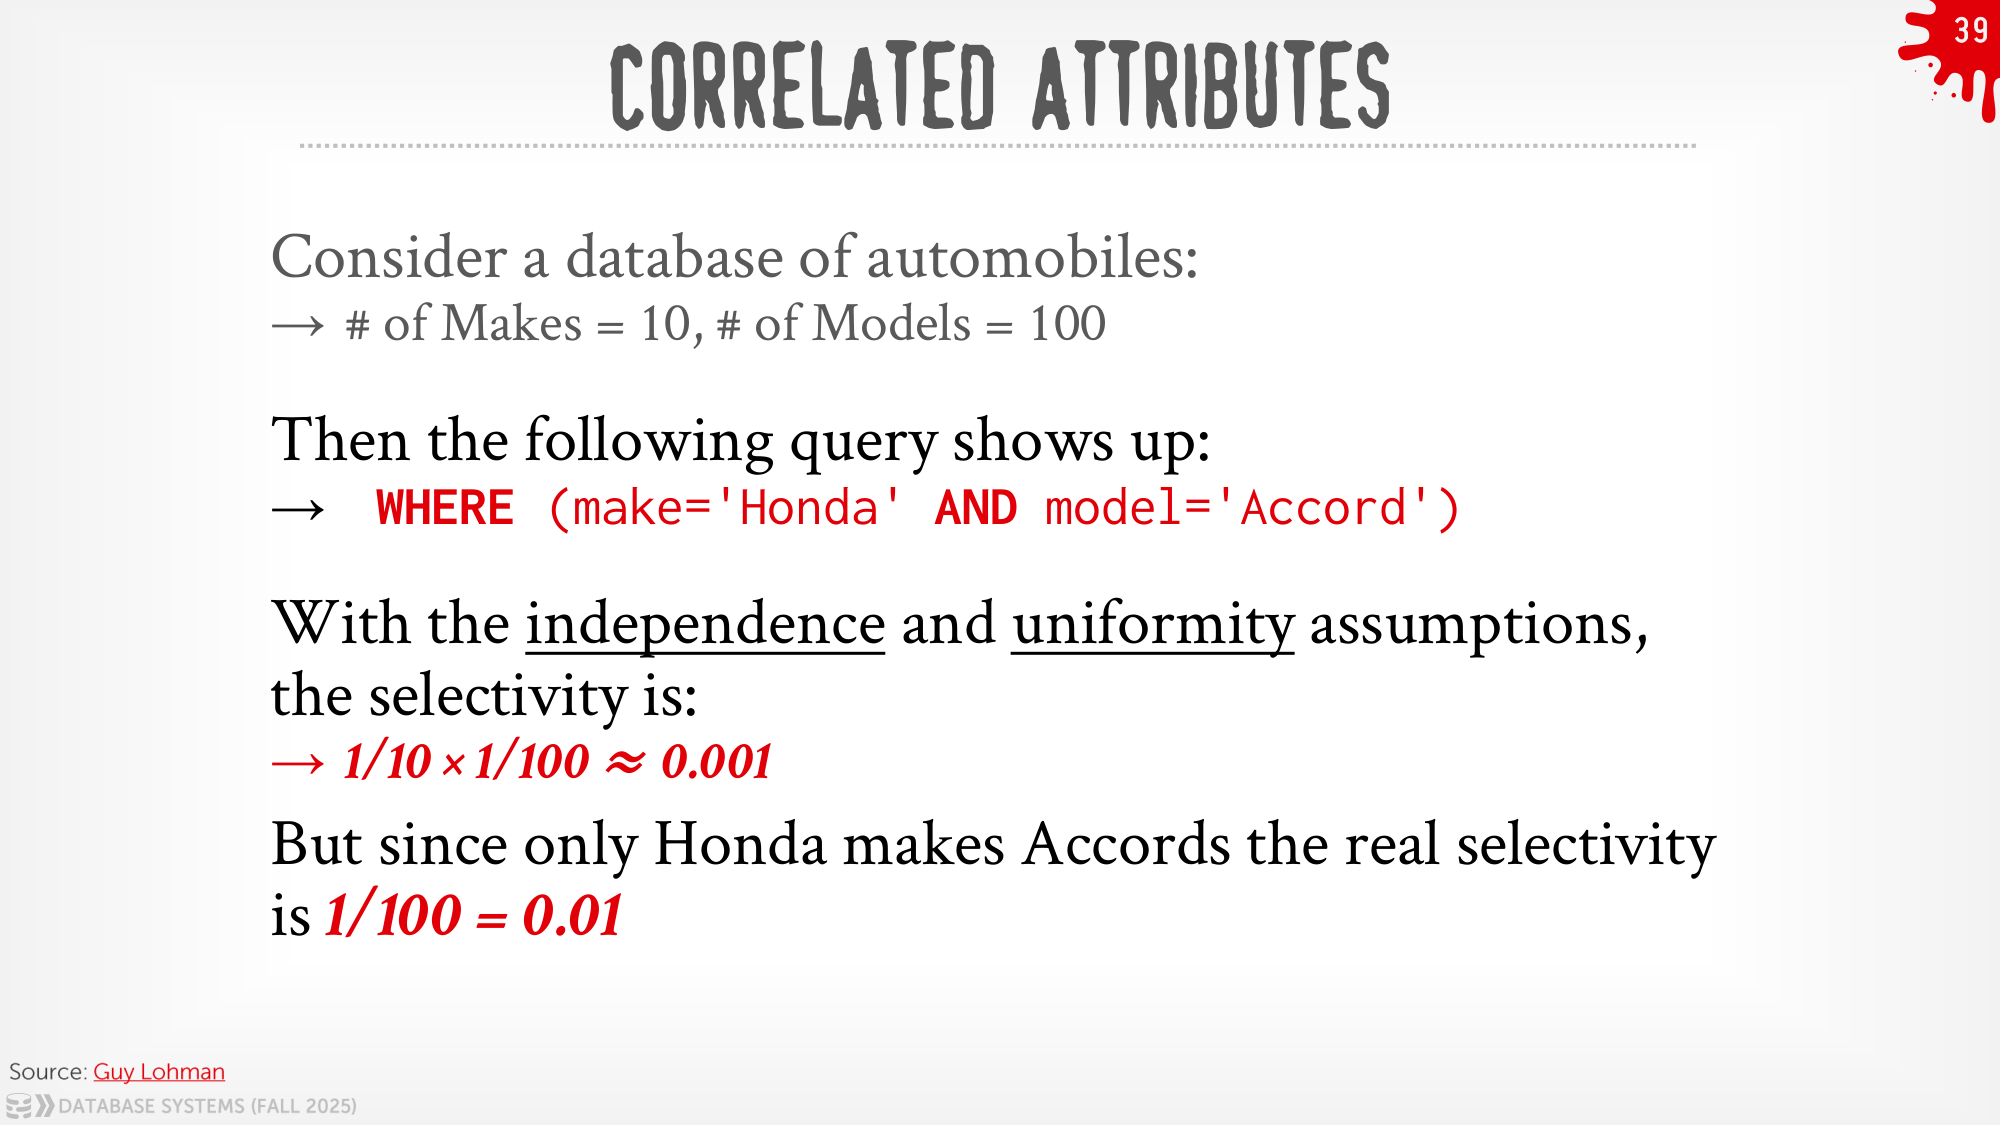
实际数据中,品牌与车型、城市与邮编等列可能高度相关,简单相乘会严重低估或高估结果。SQL 的 UNKNOWN 还意味着 NOT P 不能在有 NULL 时不加调整地按 1−sel(P) 处理。
课件给出 10 个品牌、100 个车型的例子。将 make = Honda 与 model = Accord 独立相乘得到 0.001,但 Accord 已经限定了品牌,在车型均匀的教学假设下应是 0.01。
连接基数与误差传播
对 R、S 在 A 上的等值连接,在均匀分布、值域包含等假设下,课程给出的常用估计为:
如果键来自主外键关系、存在大量重复值,或者两边值域只有部分重合,应利用相应约束和分布信息,不能把公式当成普遍精确结果。
较低层算子的行数估计误差会传给上层,连续连接还可能继续放大。优化器即使正确搜索了很多候选,也可能因为输入规模估错而选错算法。这说明统计维护、相关性建模与搜索算法同样影响最终计划。