课程视频
索引与过滤器
上一讲的 B+Tree 能够返回记录位置,本讲先介绍另一类结构:Filter 只回答数据是否可能存在,不能直接返回完整记录。它可以放在真正的数据访问之前,提前排除一定不存在的键。
Bloom Filter 使用位数组和多个哈希函数。插入一个键时,将各个哈希位置置为 1;查询时,只要有一个位置为 0,就能确定该键没有插入过。如果全部为 1,也可能是其他键共同设置的结果,因此还要访问原始数据确认。
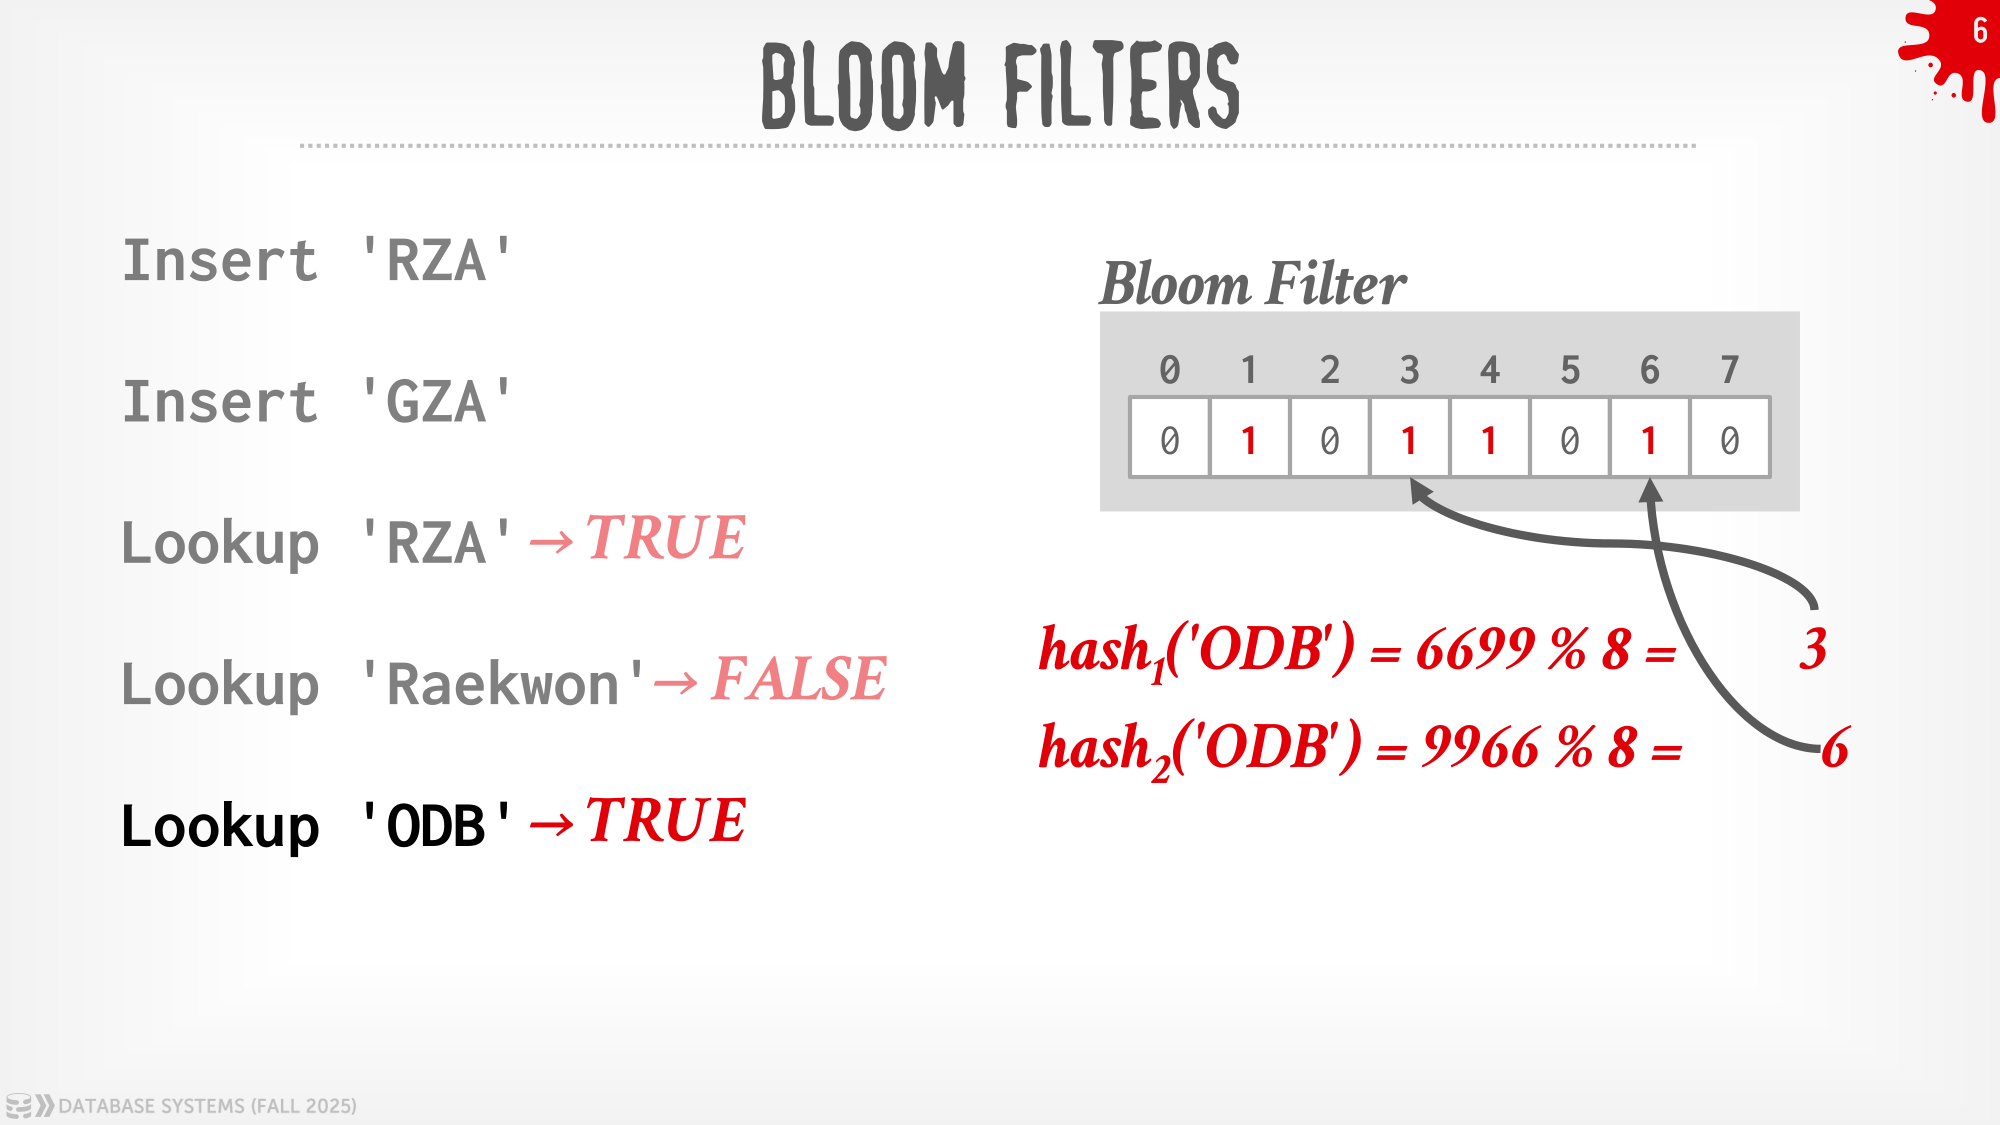
这里的保证以正确维护、没有错误删除的过滤器为前提:它允许假阳性,不允许假阴性。普通 Bloom Filter 不能直接通过清零相关位删除键,因为同一位可能被其他键共享。位数组大小、插入数量和哈希函数数量共同影响误判率;课件还列举了 Counting、Cuckoo、Quotient 等其他过滤器。
Skip List
Skip List 在有序链表之上增加多级跳转指针。底层保存所有键,上层只保留一部分节点。查询从高层向右前进,遇到超过目标的键就下降一层,直到在底层找到目标或确认不存在。
插入时先记录每一层的前驱节点,再随机决定新节点的高度并修改指针;删除则移除各层指向目标的链接。随机层高使搜索、插入和删除具有期望对数复杂度,但单次操作的最坏情况仍可能退化。与 B+Tree 相比,它不需要通过节点分裂维护页面占用率,不过指针访问和内存分配也有成本。
Trie 与 Radix Tree
Trie 按键的数字或字符片段逐层导航,树的形状由键内容决定。两个键共享前缀时,也共享搜索路径。这与依赖比较结果选择子树的 B+Tree 不同,查询的工作量主要与键长和每层处理的位数有关。
如果每层只处理少量位,树会很高;每层处理较多位,又可能产生大量空指针。Radix Tree 将只有一个孩子的连续路径压缩成一条边,减少节点和跳转次数。压缩后插入一个在中途分叉的键,需要拆开原有路径;删除后则可以重新合并。课件还介绍了 Patricia、Judy 和 Adaptive Radix Tree 等相关变体。
倒排索引
查询文本中是否包含某个词时,按整段文本建立 B+Tree 并不合适。倒排索引为每个词保存 Posting List,记录包含该词的文档或元组位置。多个词的 AND 查询可以对列表求交,OR 查询可以求并。
课程用 Lucene 和 PostgreSQL 的例子说明了分词、词项与记录之间的对应关系。词项还可以保存出现次数、位置信息,支持结果排序和短语查询;N-gram 则有助于构造模糊匹配及补全候选。搜索效果因此不只由索引结构决定,还取决于文本如何规范化、分词和评分。
向量索引
倒排索引依赖词项匹配。要查找语义接近、字面表达不同的内容,可以先将内容转换为向量,再按距离或相似度寻找近邻。课件强调这类检索需要考虑结果质量,并处理结构化条件在检索前过滤还是检索后过滤的问题。
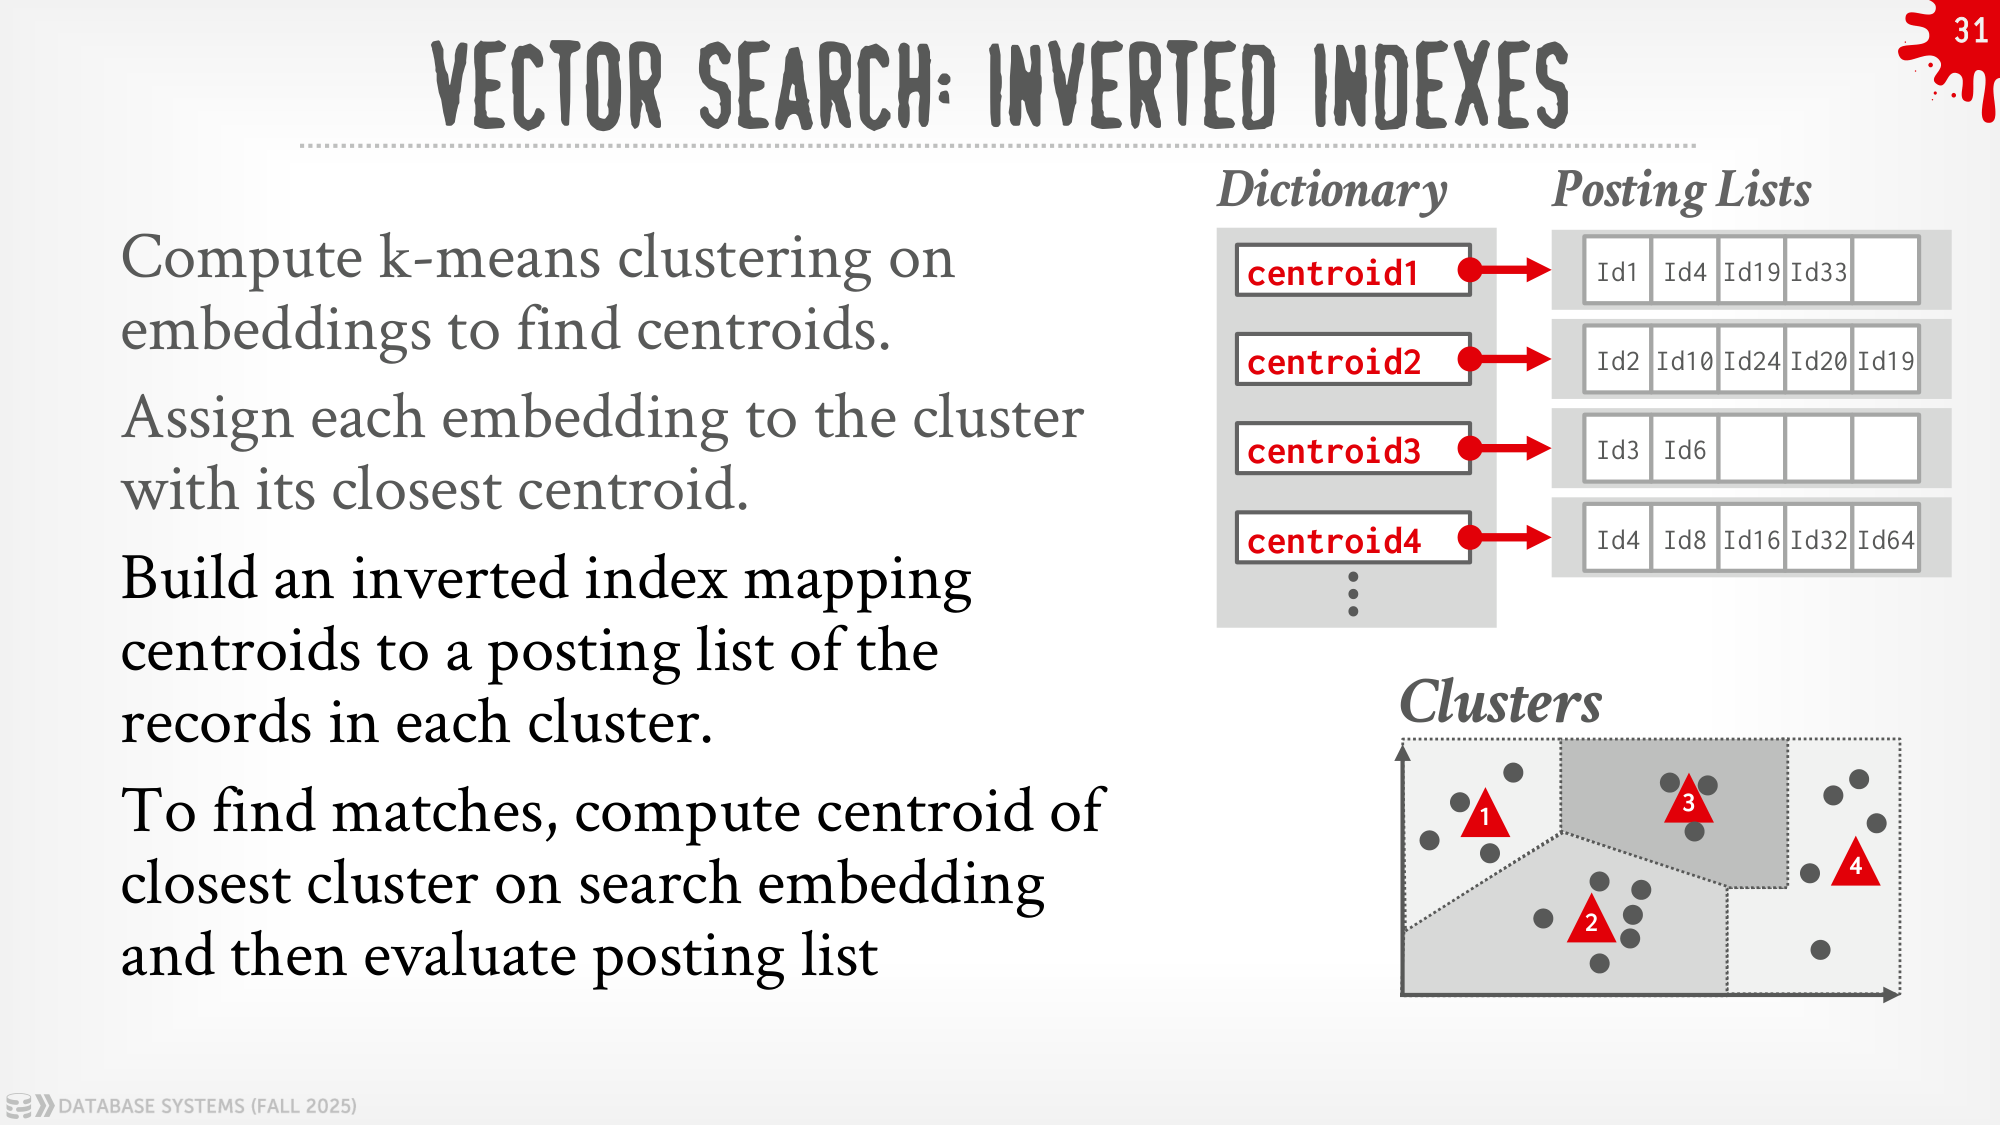
IVF 类索引先聚类,将向量分配给最近的中心,再建立“中心到向量列表”的映射。查询时选择若干邻近簇,只在对应列表内计算距离。扫描更多簇通常能提高召回率,也会增加工作量;只查一个簇可能漏掉位于簇边界另一侧的近邻。IVFFlat 保留候选向量用于距离计算,其他方案还可以引入量化压缩。
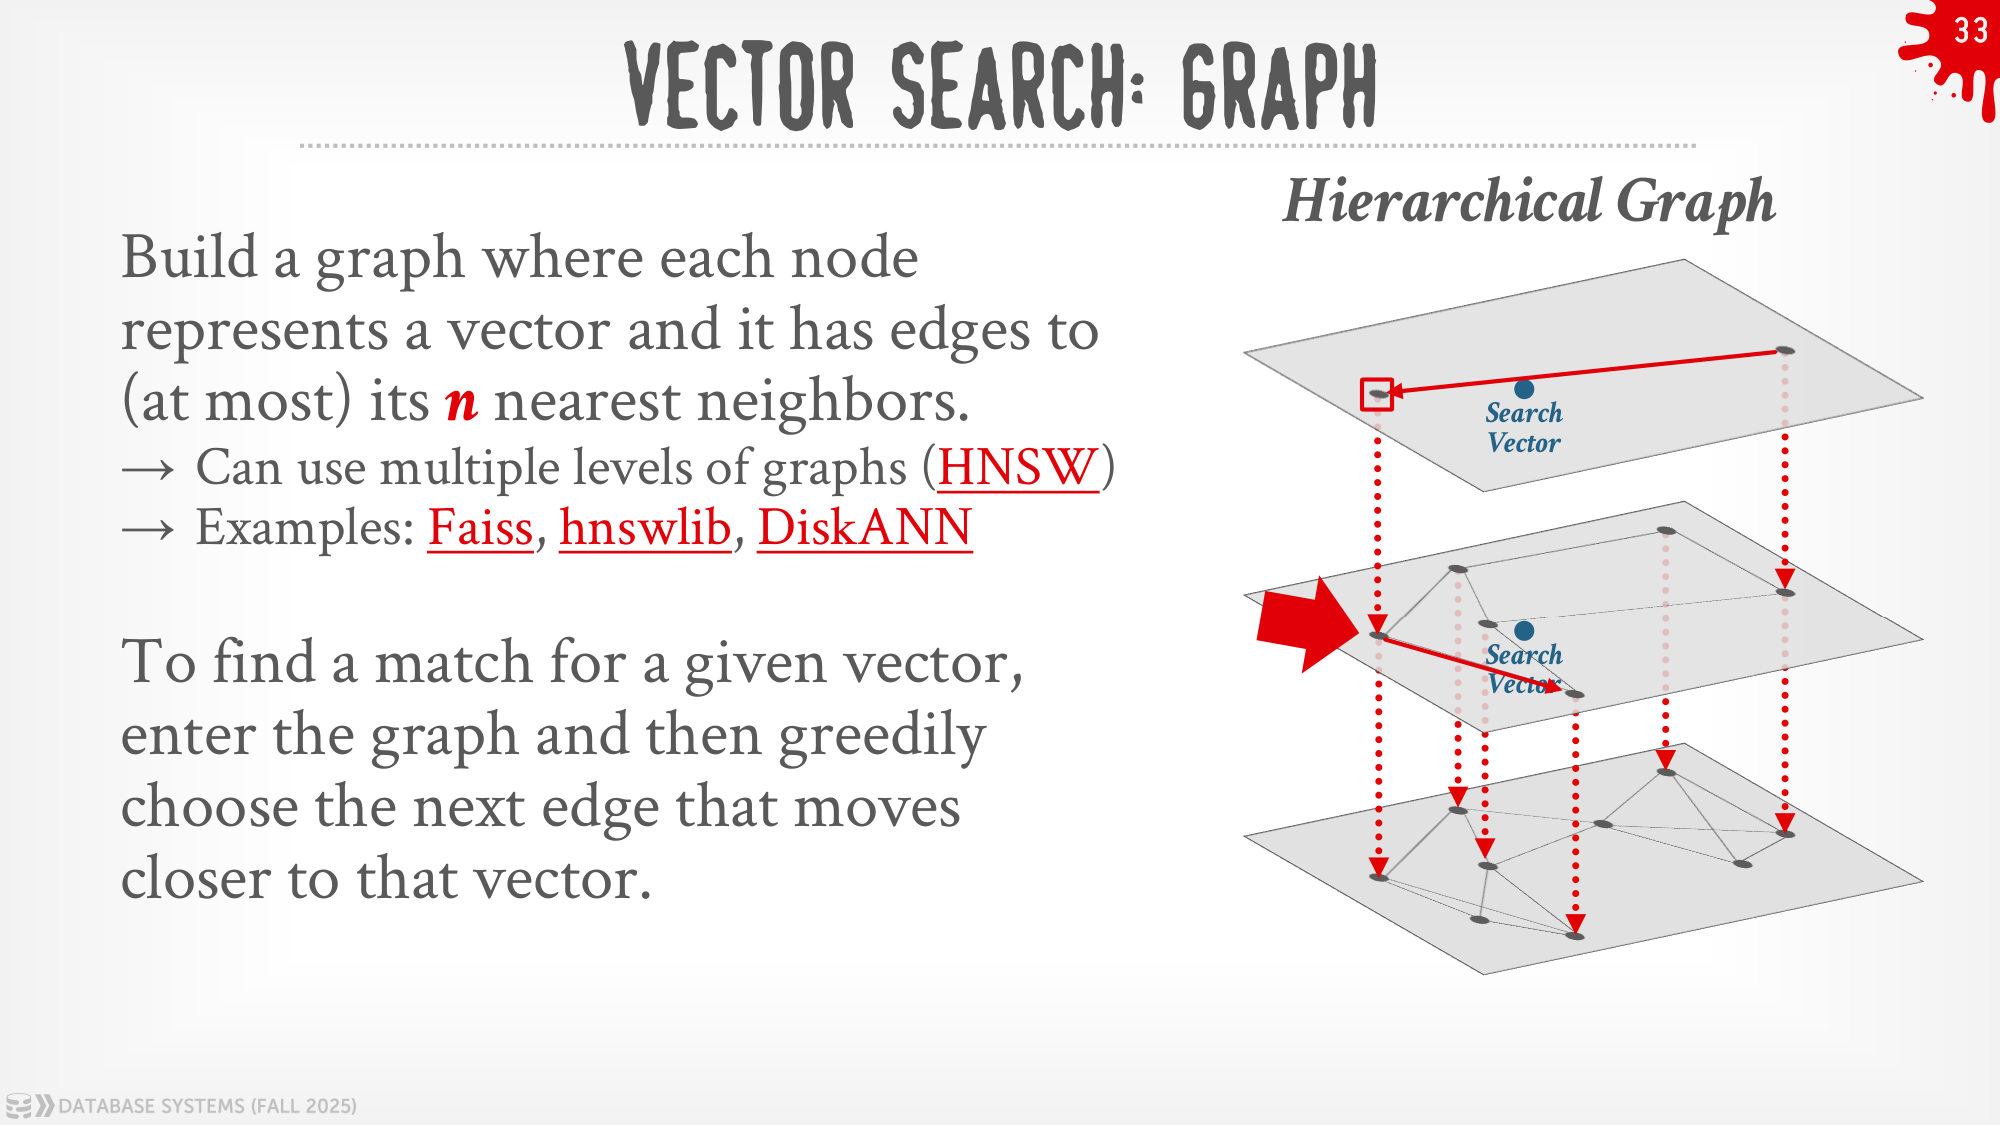
图索引则将向量表示为节点,以近邻关系建立边,搜索时沿着越来越接近查询向量的方向前进。HNSW 使用多层图,先在上层快速接近目标区域,再在下层细查。它与前面的 Skip List 都用到了层次化导航的思路,但维护对象和搜索条件不同。
课程最后回到部分索引和 Include Columns:前者减少需要维护的记录范围,后者让索引包含更多查询输出。这两项优化不改变索引的核心搜索规则,是否有效仍需结合查询谓词、输出列和更新成本判断。