课程视频
课程主线回顾
最后一讲先回顾考试范围,再快速介绍高级查询处理和实际系统。下面的系统描述对应本讲课件所介绍的版本与架构,用来联系课程概念,不将其作为这些产品当前功能的完整清单。
复习时可以沿一条查询串起前面的内容:SQL 被解析和绑定,优化器根据统计选择访问路径与 Join 顺序,执行器安排流水线和并行任务,缓冲池及索引提供数据,事务协议约束可见性和冲突,WAL 与恢复协议保证提交效果能够在故障后恢复。
课程再次区分了 Strict 2PL 与 Strong Strict 2PL:前者将排他锁保留到结束,后者将全部锁保留到结束。MVCC 中也要同时查看版本时间戳和事务状态,不能只比较一个数字就判断可见性。
SIMD 扫描与哈希探测
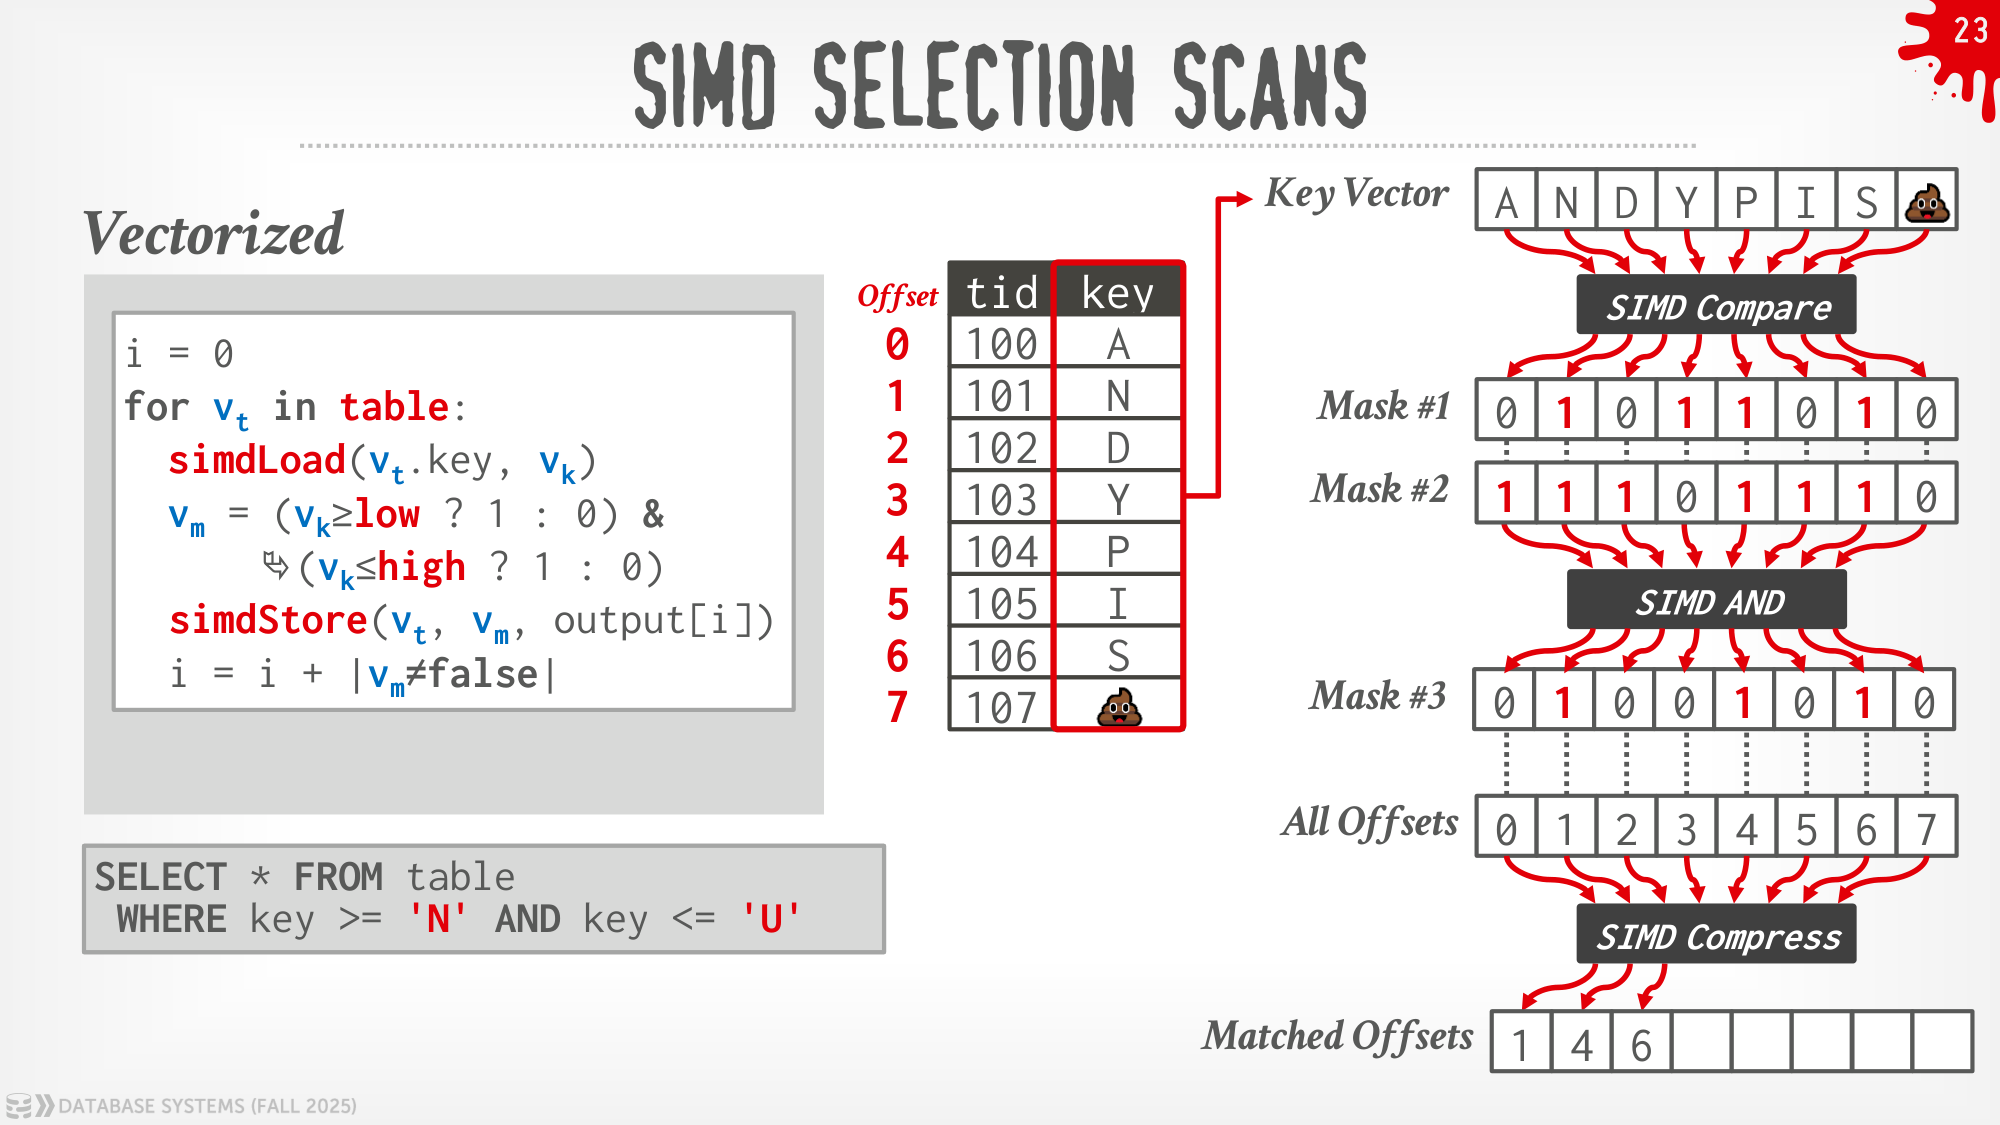
逐条扫描可以使用分支判断是否输出,也可以采用 Branchless 方式,通过计算匹配标记更新输出位置,减少不可预测分支。SIMD 则同时读取多个键,执行范围比较,合并结果掩码,再压缩或收集满足条件的位置。
哈希探测也可以批量比较。例如将一个桶内多个键连续保存,一条 SIMD 比较生成匹配掩码,再据此取得 Payload。一次处理多个不同探测键时,各键的碰撞路径可能不同,需要处理控制流分歧和未完成的探测任务。
过滤结果可以用 Selection Vector 保存通过的偏移,也可以用与输入对齐的 Bitmap 标记有效位置。稀疏选择、密集选择和不同算子的消费方式,会改变两种表示的成本。
代码生成与预编译原语
HIQUE 为查询计划生成专门的 C/C++ 代码,将谓词和类型处理嵌入程序,再编译和加载。它减少通用解释框架的开销,但需要付出编译时间并维护代码生成工具链。
Vectorwise 提前编译许多按类型区分的 Primitive,运行时将它们组合成计划。函数调用成本分摊到批次,基础循环也更容易向量化。课程由此展示了两条可以组合的路线:查询专门化与批量执行。
云分析系统如何组合这些技术
BigQuery 的例子强调存算分离、列式读取和分布式 Shuffle。中间结果可以在内存 Shuffle 层中交换,执行时根据实际分区大小进一步重新划分,缓解估计不足和数据倾斜。
Snowflake 的例子采用预编译的向量化算子,并根据执行统计决定是否启用下推聚合;Flexible Compute 可以为较重的计划片段临时增加计算资源。它说明优化不一定在开始执行前就全部固定。
Redshift 将编译工作交给独立服务,结合本地和更大范围的编译结果缓存,减少重复编译。讨论代码生成时,缓存粒度和数据库升级后如何重编译,也是运行时成本的一部分。
Yellowbrick、Photon 与 ClickHouse
Yellowbrick 的例子将行存、列存、查询编译与面向缓存的执行放在同一架构中。课件还介绍了按查询组织的内存分配、NUMA 与 Huge Page,以及用户态网络和设备访问。它们针对的是分配、复制和通信开销,不能仅凭某一项局部优化推导整体性能。
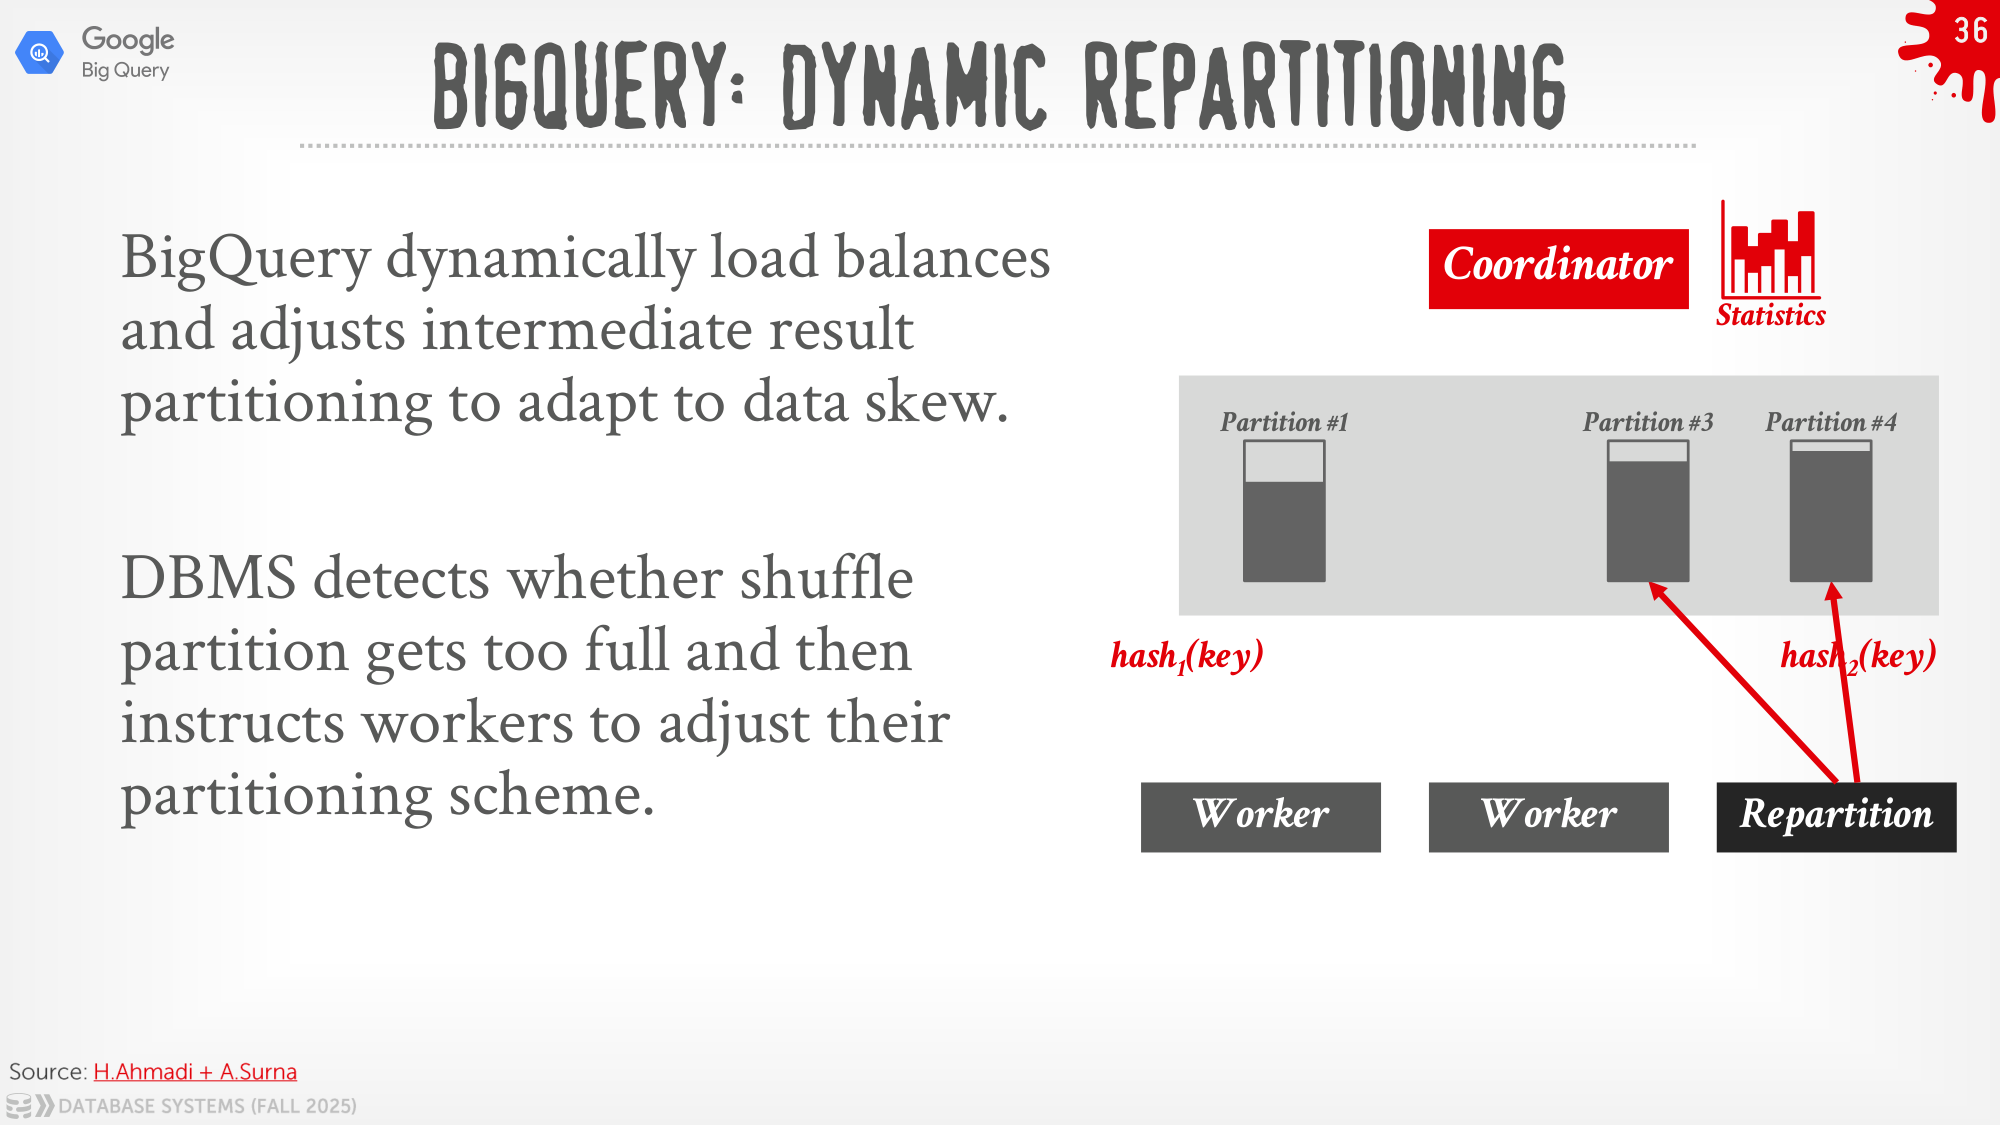
Photon 使用预编译的向量化内核,并通过 Expression Fusion 合并适合一起执行的表达式。课件将日期范围的两次比较合成一个循环,避免为两个过滤操作分别生成和读取中间选择结果。
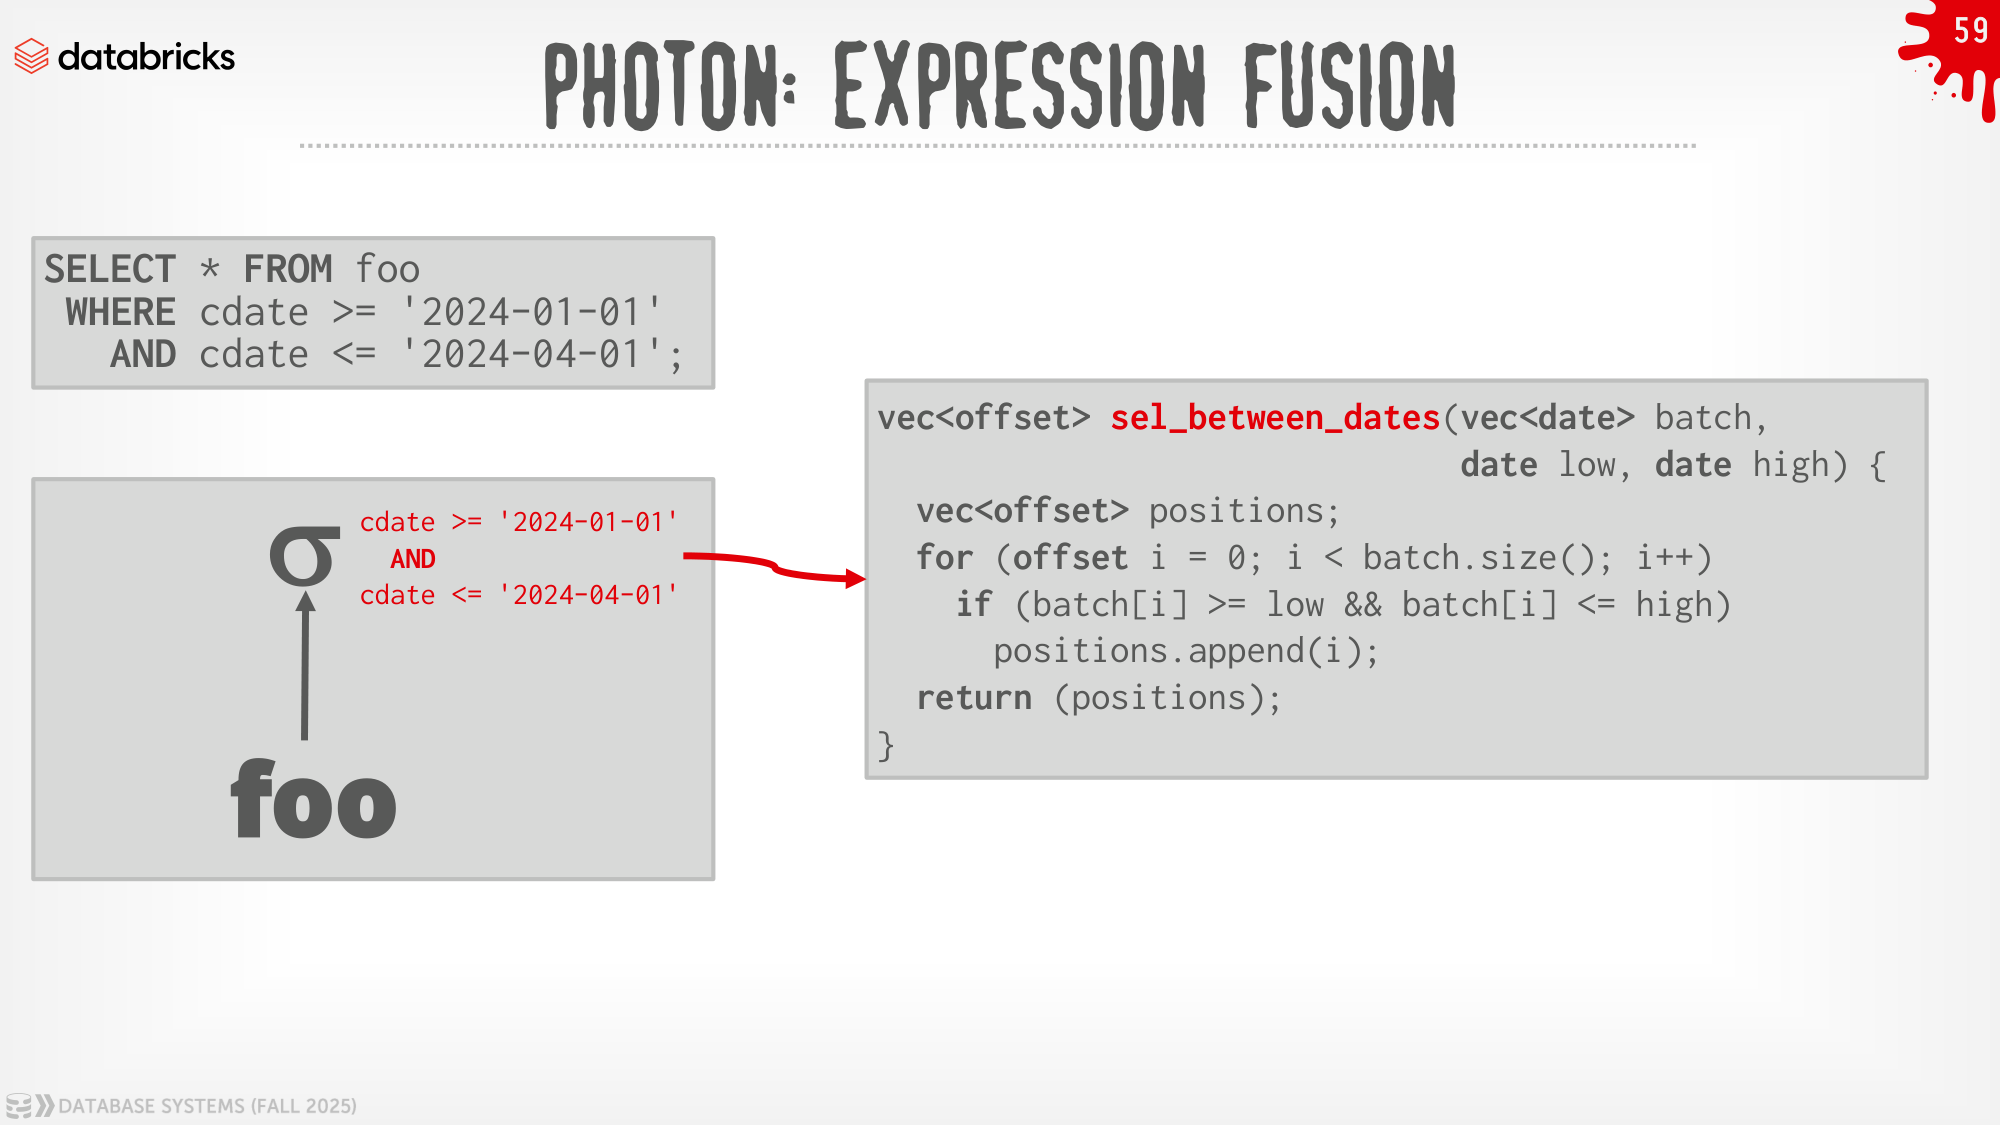
Spark 的 Partition Coalescing 在 Shuffle 后合并过小分区,减少后续任务开销,与 BigQuery 拆分过大分区形成对应。两者都根据运行时数据调整阶段边界上的工作分配。
ClickHouse 的例子结合不可变数据文件、向量化执行、表达式编译和按键类型选择的哈希表。字符串哈希表的比较实验提示我们,算法名称相同,内存布局和针对数据特征的实现仍可能带来明显差别;实验结论需要连同硬件、数据和任务范围一起理解。
继续学习时可以进入 CMU 15-721,进一步阅读内存、代码生成、连接算法以及这些分析系统的设计取舍。