课程视频
并行执行与 Worker
上一讲讨论一个执行者如何运行计划,本讲把工作分配给多个 Worker。Worker 可以是线程或进程,不应将它直接等同于一条客户端连接。
课程区分了资源紧密连接、通信通常较快的并行数据库,以及必须显式处理更高通信成本和局部故障的分布式数据库。本讲主要讨论单机或紧耦合环境中的执行安排,后续再展开跨节点事务。
进程、线程与嵌入式模型
Process per Worker 为不同 Worker 使用独立 OS 进程。它提供地址空间隔离,但共享缓冲池等状态需要共享内存或消息机制。进程隔离并不意味着任意 Worker 崩溃后都可以忽略对共享状态的影响。
Thread per Worker 在同一进程中运行多个线程,共享数据结构更直接,也更便于数据库安排任务,但内存错误可能影响整个进程。线程模型本身不能证明数据库已经支持单条查询的并行执行。
嵌入式数据库与应用位于同一地址空间,调度边界又有所不同。SQLite、DuckDB、RocksDB 都属于课程列出的嵌入式系统,但它们内部的并行能力和用途并不相同。
调度器需要决定任务何时运行、使用多少核、运行在哪些核上、把输出保存在哪里。这些决策与数据位置、缓存和内存预算有关,不能只按当前空闲线程数拆任务。
查询间与查询内并行
Inter-Query Parallelism 同时执行多个查询,主要提高系统吞吐量;并发更新还需要事务协调。Intra-Query Parallelism 将一条查询拆给多个 Worker,目标通常是缩短较长查询的延迟,但会增加任务协调成本。
课件先用并行 Grace Hash Join 说明共享数据结构与分区的选择:多个 Worker 可以协作构建共享表,也可以先将数据分区,让各 Worker 负责独立分区。负载倾斜会使某个分区成为尾部任务,即使其他核已经空闲也无法结束查询。
三种查询内并行方式
Intra-Operator Parallelism 将同一个算子的输入划分成互不重叠的子集,让多个 Worker 执行相同逻辑。例如每个扫描任务读取不同页面,再由上层汇总。
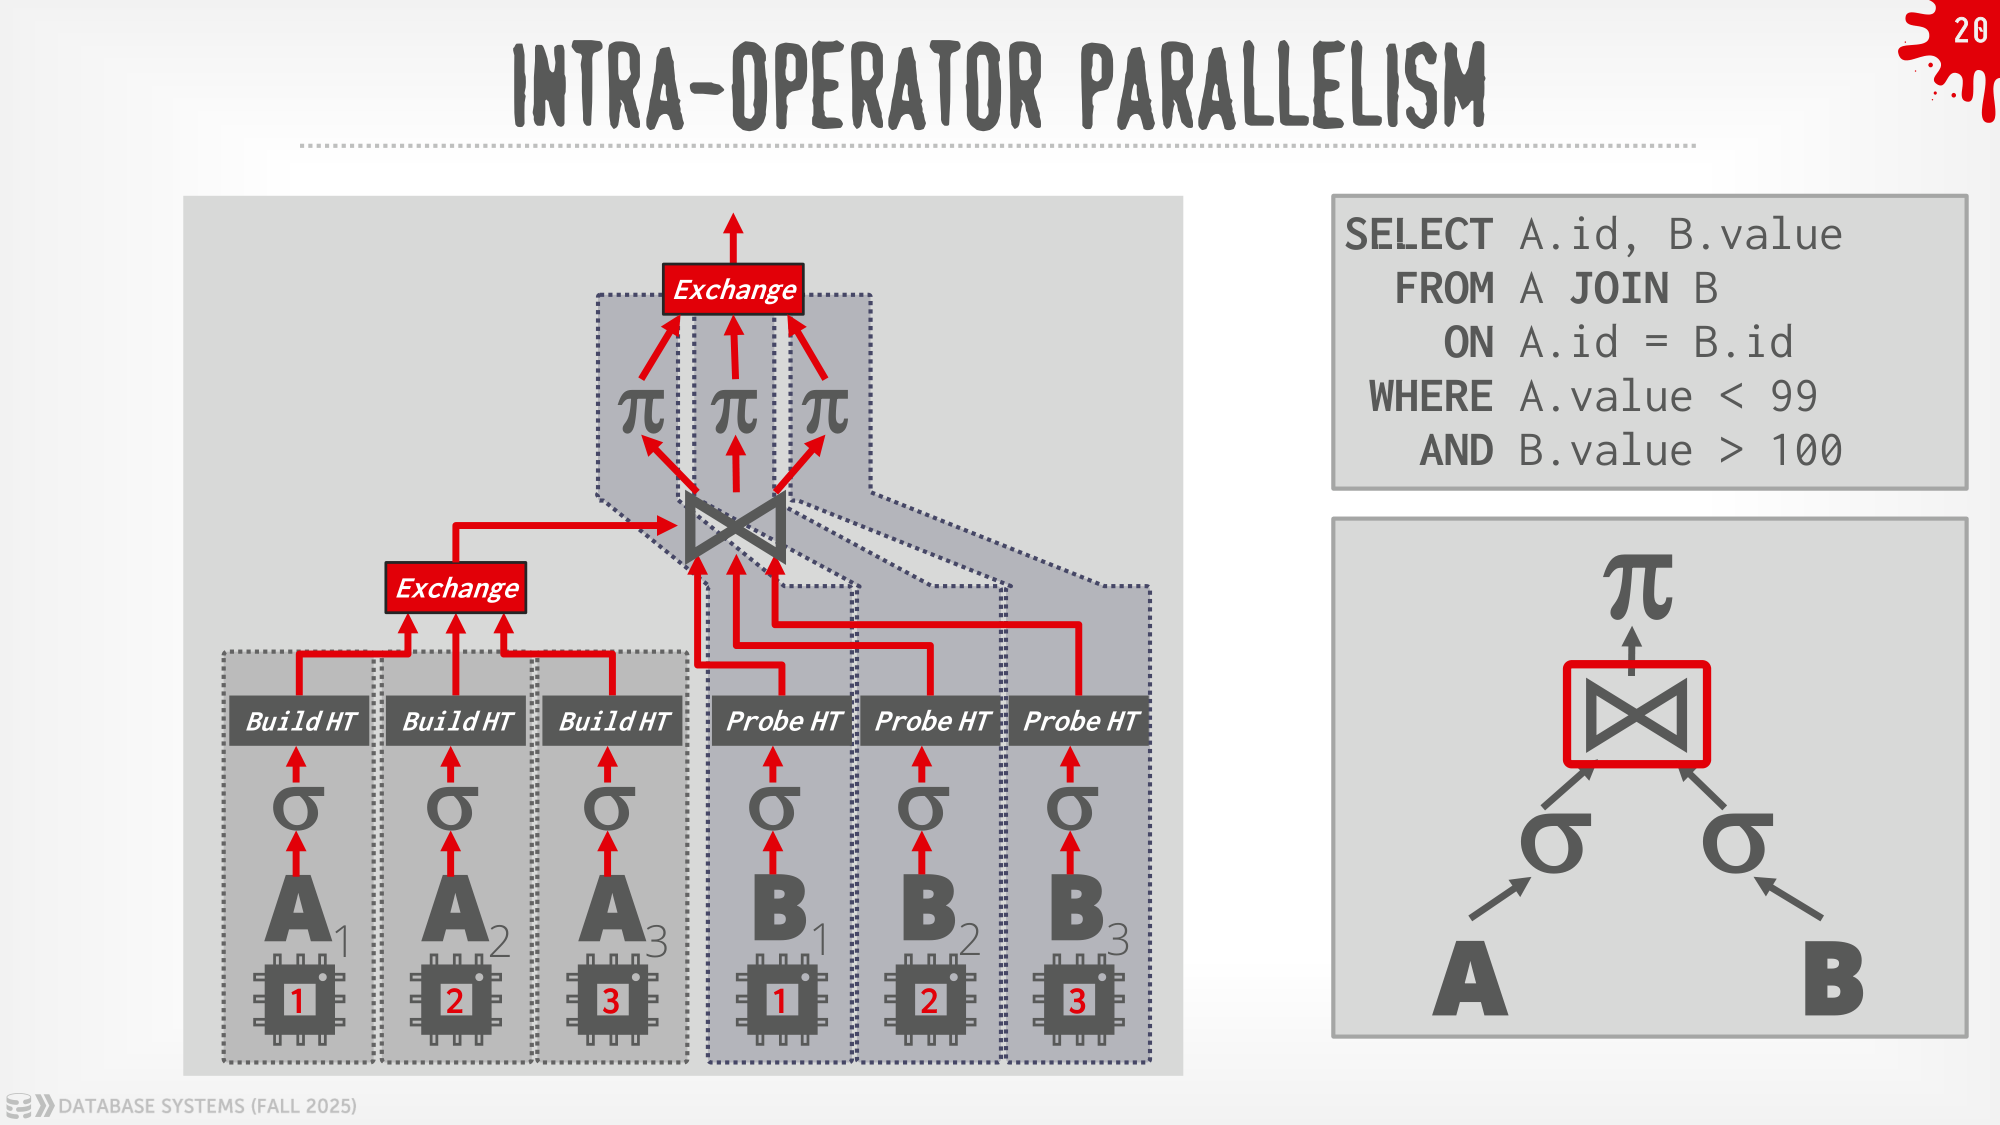
Exchange 运算符连接这些并行片段,课程介绍了三种数据组织方式:Gather 将多路输入汇成一路,Distribute 将一路分给多路,Repartition 则将多路输入重新分区到多路输出。Exchange 可以有缓冲和同步,但不是所有 Exchange 都必须等待全部输入结束后才能输出。
Inter-Operator Parallelism 让不同算子重叠运行,例如一个 Worker 执行连接,另一个同时消费已经产生的连接结果。此时要处理生产速度与消费速度不一致的问题,不能任由中间缓冲无限增长。
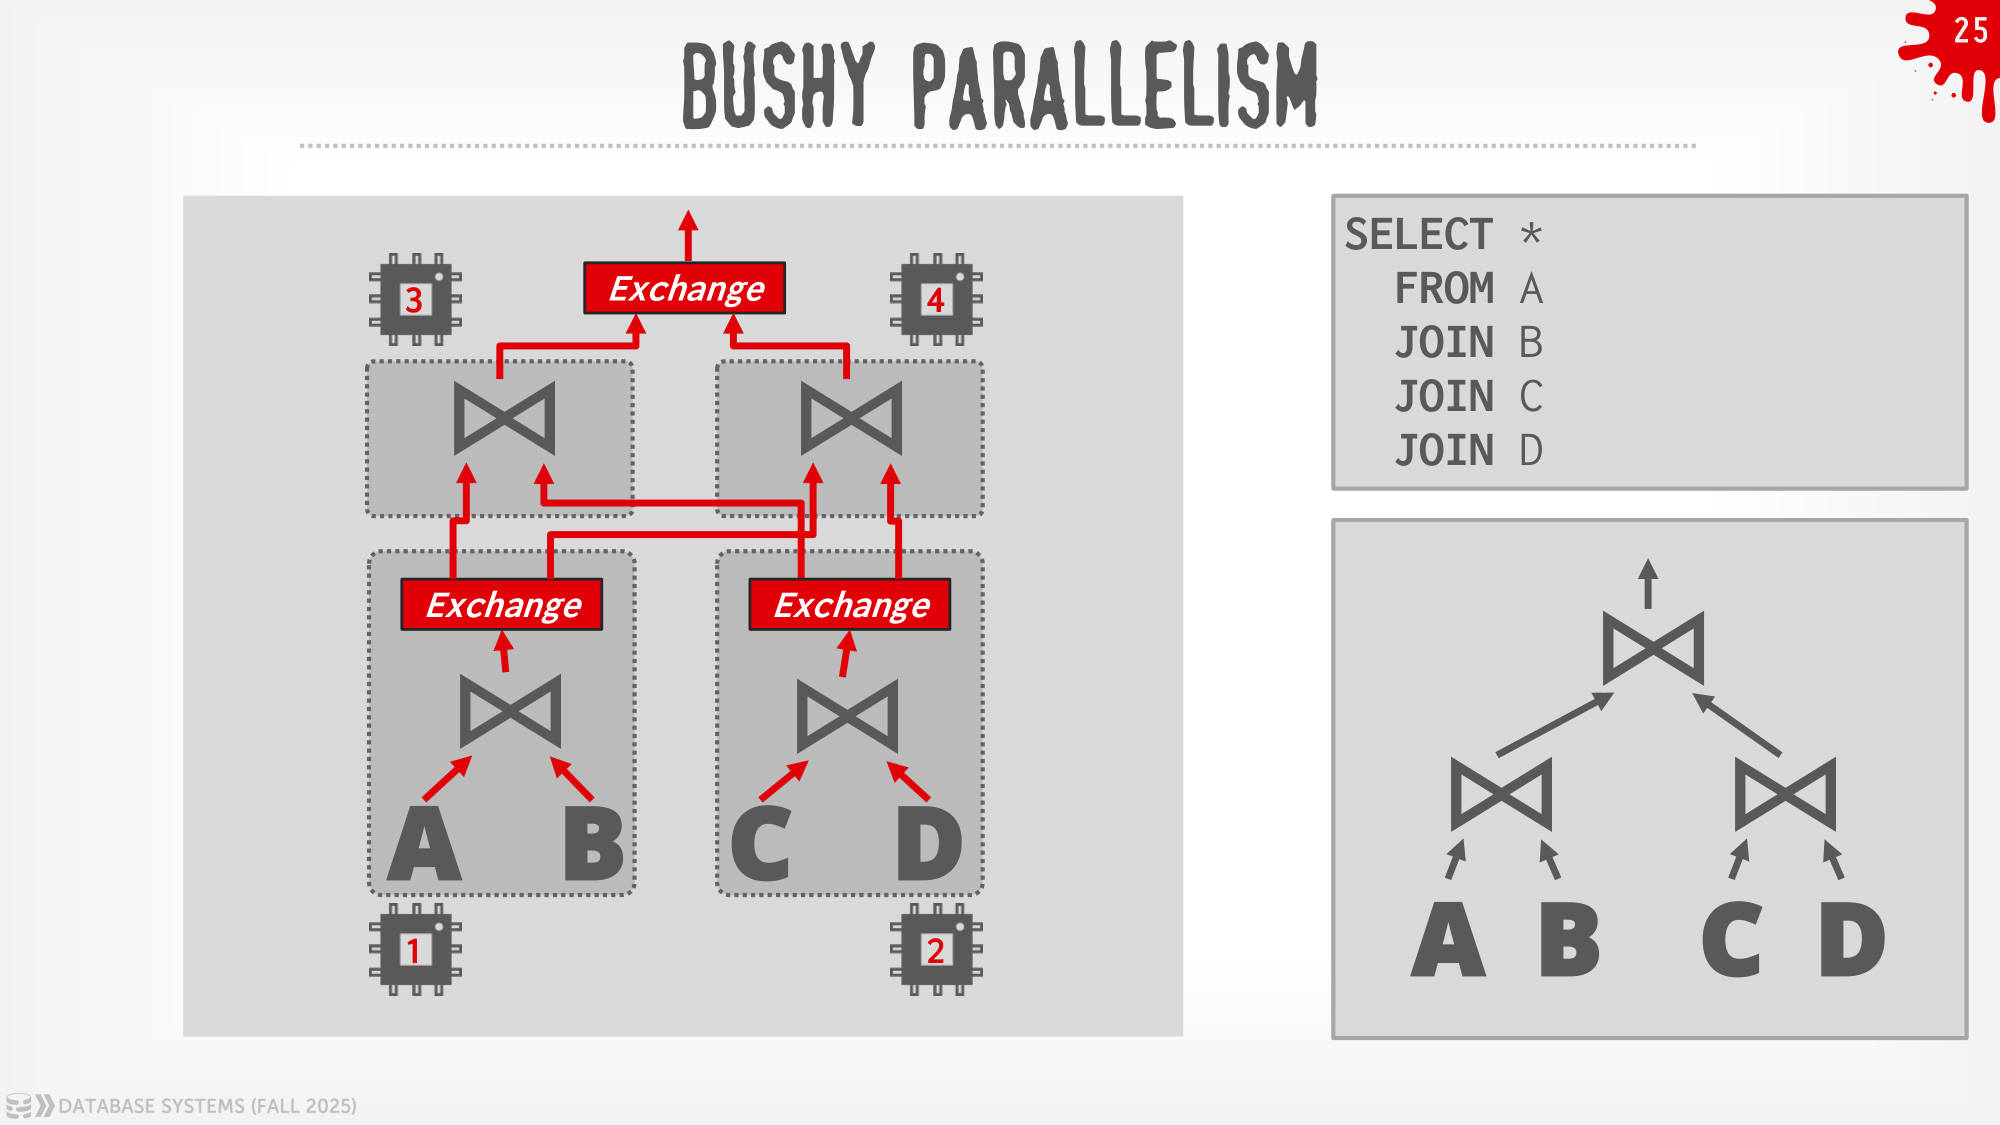
Bushy Parallelism 则让计划中相对独立的子树同时执行,再合并它们的结果。以上方式可以组合使用,实际并行度仍受到依赖关系、内存、可分任务数量和硬件带宽限制。
I/O 并行与数据划分
如果瓶颈一直是单块磁盘,多增加执行线程不能消除 I/O 限制。RAID 或存储设备可以在数据库下面提供多盘能力,但数据库未必知道具体页面位于哪个设备。
数据库也可以直接将不同数据库、表或表分区分配给不同设备。Logical Partitioning 把一张逻辑表拆成分别存储、管理的物理部分,对应用仍尽量呈现统一的表。划分方式会影响扫描、连接和更新的工作量,后续分布式部分还会讨论如何按查询负载选择分区键。