课程视频
通用执行器为什么会执行额外指令
通用查询执行器需要支持不同表结构、类型和表达式。逐条处理记录时,它可能反复查询属性偏移、判断类型、遍历表达式树,再通过虚函数调用下一个运算符。这些能力让代码容易复用,也把本可提前确定的信息留到了运行时。
代码专门化根据当前查询、模式和参数生成执行代码。属性类型已知,就可以使用对应的数据访问操作;谓词已知,就可以生成直接比较;连续的运算符可以合并进循环,减少分派和中间结果交接。
从源代码生成到 LLVM IR
HIQUE 为查询计划生成 C/C++ 程序,把谓词和类型转换写入代码,再调用常规编译器生成共享对象,加载到数据库进程执行。生成程序仍可调用数据库已有的索引、存储或事务函数,无需重新实现整个系统。
这种方法便于查看和调试生成代码,但常规编译器的启动与优化成本可能很高。执行时间缩短之后,编译时间可能反而成为短查询响应的主要部分。
HyPer 直接生成 LLVM IR,再编译成机器代码。IR 提供更直接的代码生成接口,但查询变大时,优化编译本身仍可能昂贵,不能把使用 JIT 等同于编译成本可以忽略。
以数据为中心划分执行流水线
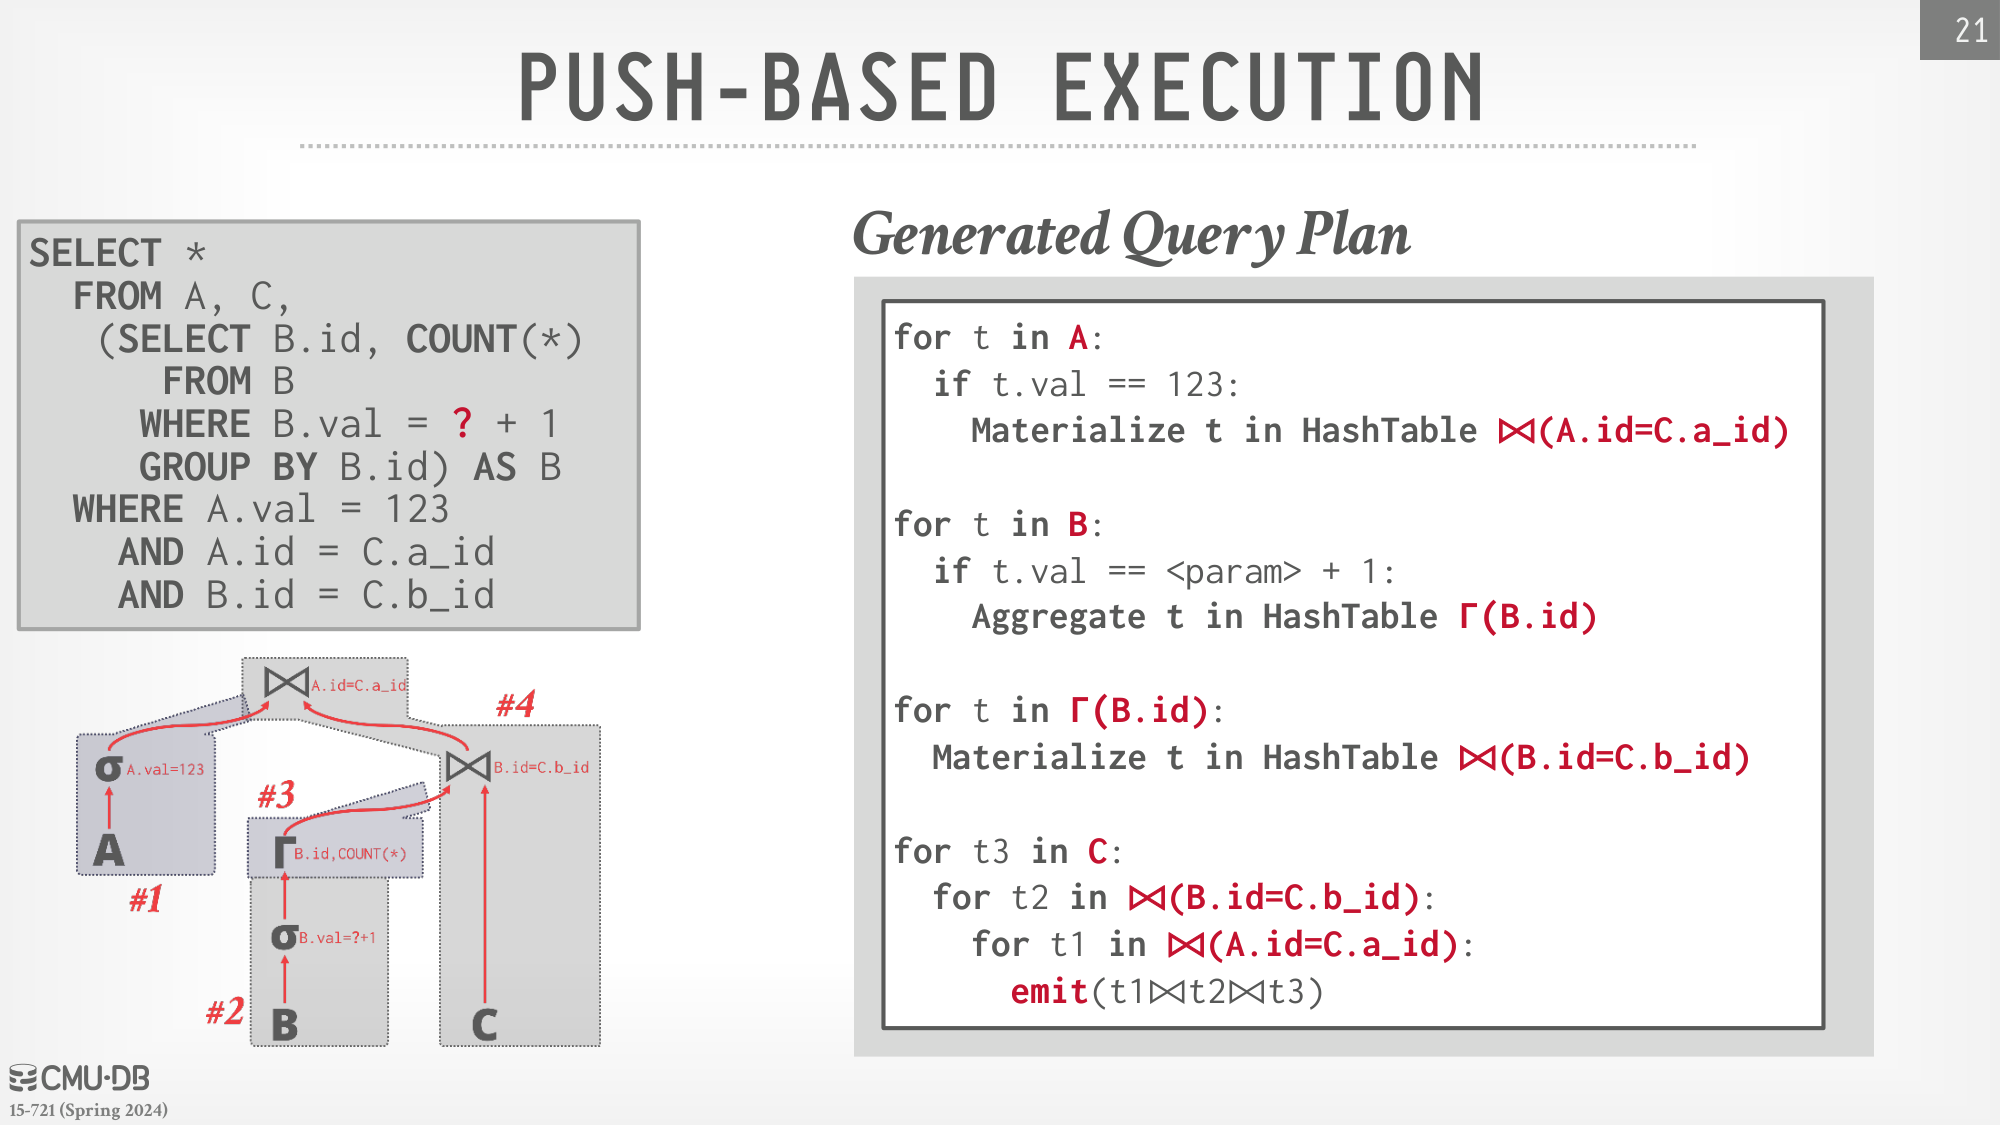
课件的查询包含过滤、分组聚合和两个连接。构建聚合状态、构建连接哈希表等步骤会形成流水线边界,其他操作则尽量融合:扫描一条记录后,直接过滤、计算并更新目标结构。
图中的实现依次扫描 A 构建一个连接哈希表,扫描 B 生成分组结果,再根据分组结果构建另一个哈希表,最后扫描 C 探测两个表并输出。原来的运算符树转成了少量循环和状态结构。
这里保留的是关系运算的语义,不要求生成代码仍然逐层调用原来的关系运算符。融合的目的,是让一条记录在 Pipeline 中停留于寄存器,直到遇到必须保存的状态或边界。
先开始执行,再支付优化编译成本
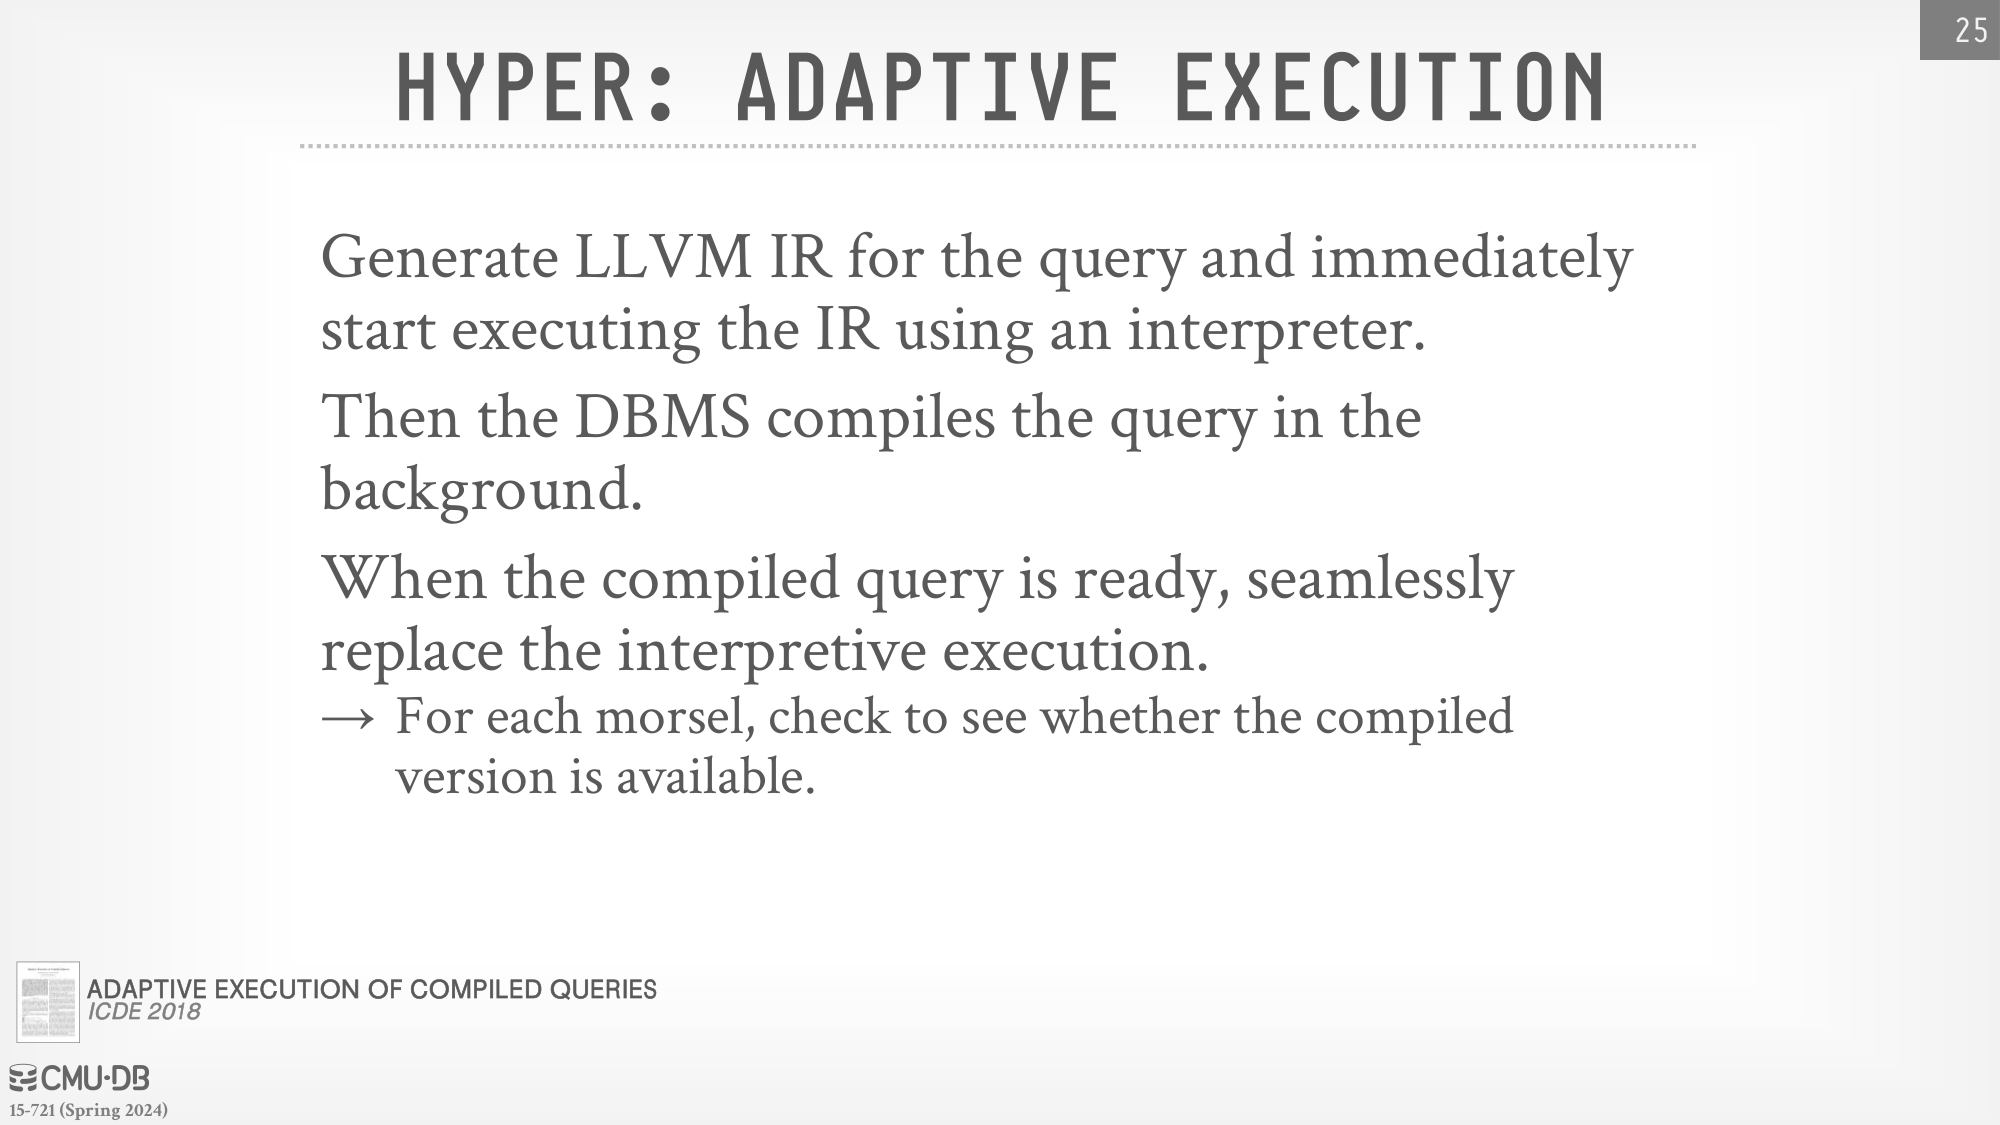
HyPer 的自适应执行先解释查询 IR,同时在后台编译;编译完成后,在 Morsel 边界检查是否可以切换到机器码。这让查询无需一直等待较慢的优化编译,同时保留长查询使用高效代码的机会。
切换需要双方共享相容的执行状态,不能重复处理已完成的数据,也不能跳过尚未执行的部分。Umbra 的 FlyingStart 进一步通过自定义 IR 快速生成初始机器码,再使用更充分的优化路径,降低启动成本。
不同系统选择不同的编译粒度
Vectorwise 提前编译大量类型化 Primitive,查询运行时组合调用,调用开销由批次摊薄。Redshift 生成并缓存查询片段代码;SQLite 把计划转换为虚拟机操作码;JVM 系统可以生成字节码;PostgreSQL 的 JIT 则集中在表达式与记录解码等热点。
SingleStore 在课件所述版本中,先把计划转换为命令式 DSL,再转换成自定义字节码,之后进入 LLVM IR 和机器码。NoisePage 同样使用数据库专用表示,并结合解释与后台编译。这些方案说明,代码生成可以只覆盖执行链中的一部分,不必一次编译整个查询。
向量化与编译怎样比较
课程使用 Tectorwise 与 Typer 对照两种执行组织:前者调用预编译 Primitive,并在 Primitive 之间物化批次;后者通过 JIT 融合流水线,尽量不物化中间结果。
两者在实验中都能达到较高效率。计算密集且缓存未命中少时,融合有助于减少指令;存在访问延迟时,批量处理更容易安排多个独立工作来隐藏等待。SIMD 与编译也可以组合,上一讲的 ROF 就在研究两者协作。
因此评估时要同时计算启动、编译和执行成本,并保留负载与硬件条件。对于只运行一次的短查询、重复查询和长扫描,同一种编译策略未必都最合适。