课程视频
查询执行的三个优化方向
前两讲主要减少扫描的数据量,这一讲开始研究数据进入 CPU 后发生什么。课程把执行优化归为三个方向:减少指令数量、降低每条指令的平均周期,以及并行执行。三者可以结合,但各自解决的瓶颈不同。
MonetDB/X100 的分析表明,数据已经位于内存中时,执行仍可能受到分支预测失败、数据依赖和解释开销影响。超标量 CPU 能同时推进独立指令;如果后面的计算依赖前面的结果,或者预测了错误分支,流水线就不能一直保持有效工作。
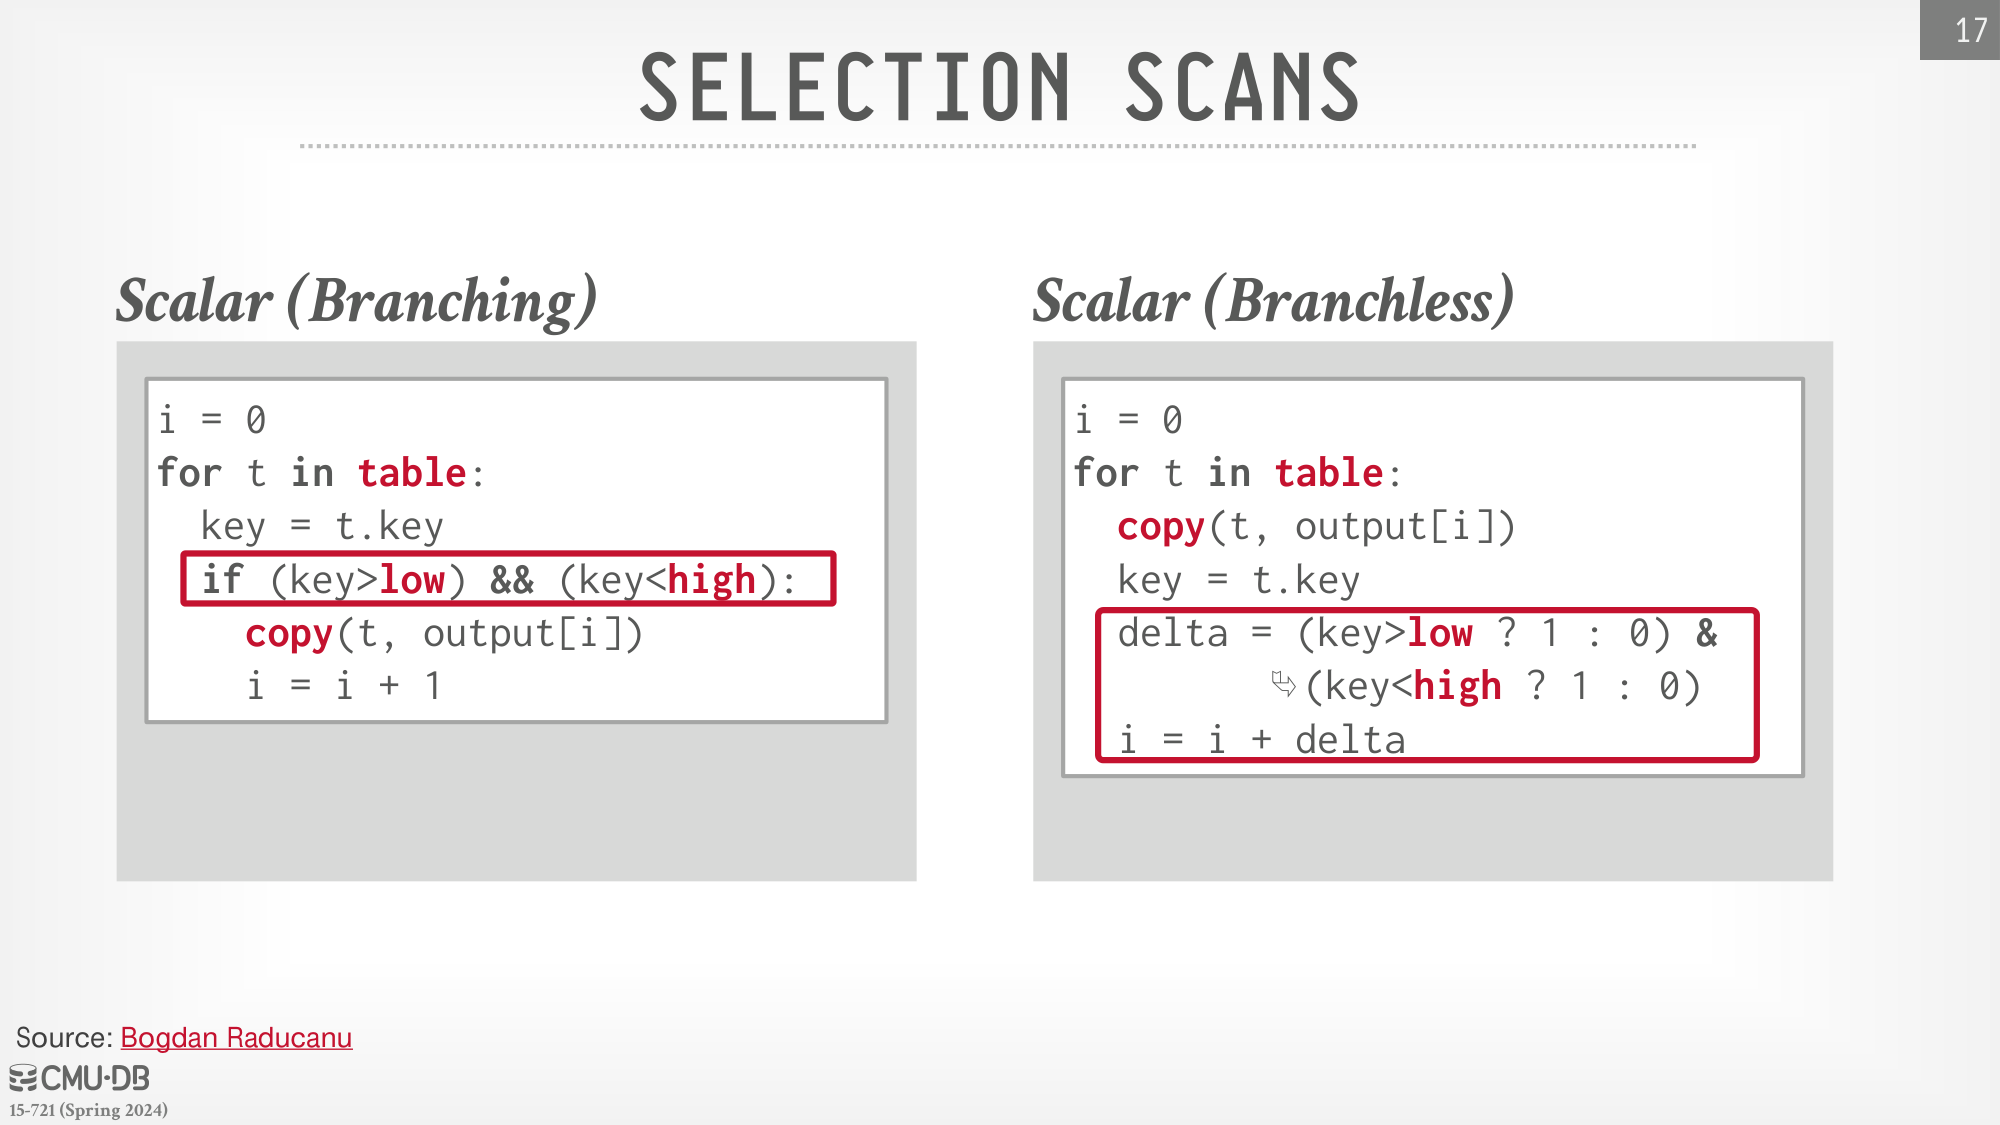
课件中的区间过滤先比较 key 是否位于上下界之间。带分支实现只在满足条件时复制记录;无分支实现先把记录写到当前输出位置,再通过布尔计算决定输出位置是否前进。后者可能增加无效写入,却减少难以预测的条件跳转。选择哪种方式,需要结合选择率和访问成本判断。
从计划到 Pipeline 与任务
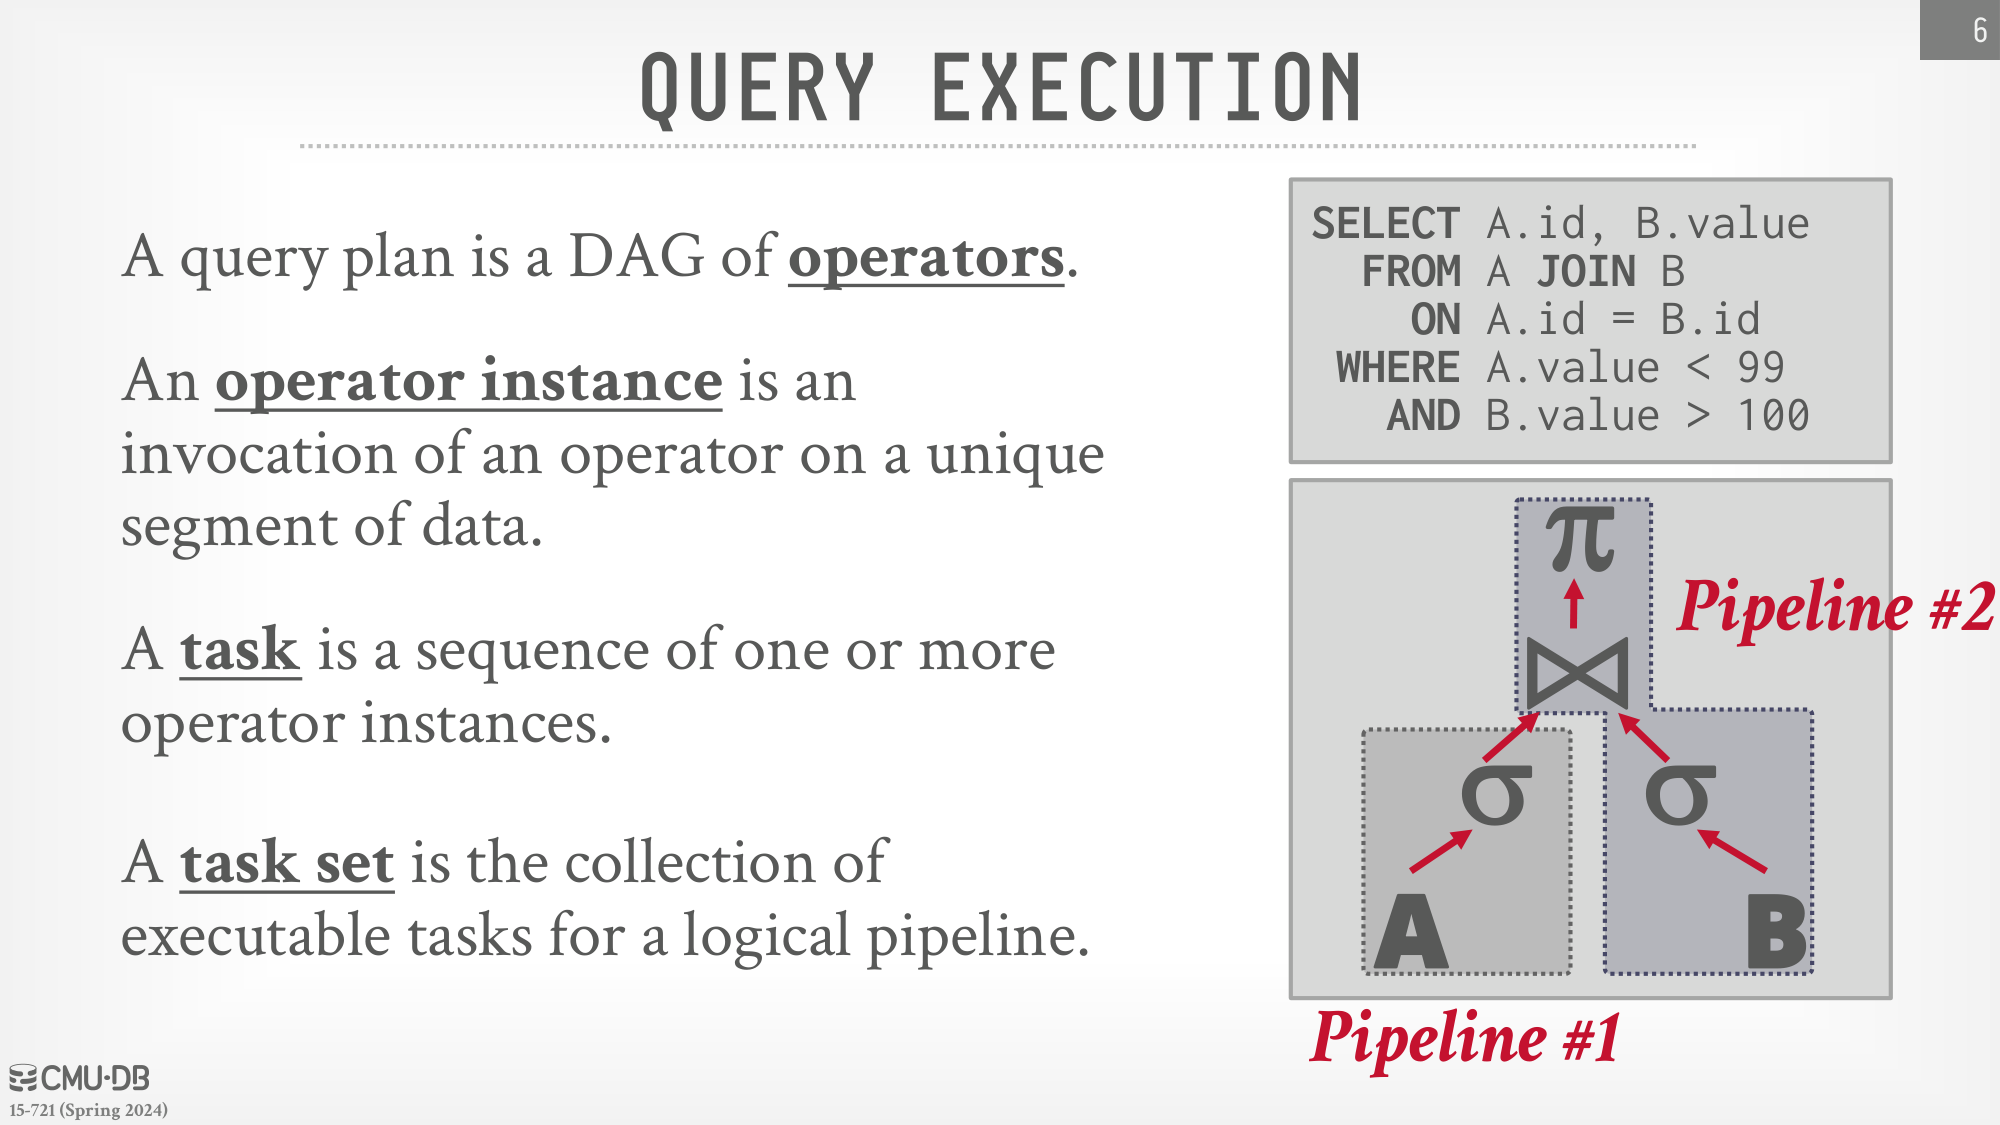
查询计划是运算符组成的 DAG。Operator Instance 表示运算符在某段数据上的一次实例化;Task 可以包含连续的多个运算符实例;Task Set 则是一条逻辑 Pipeline 中可执行任务的集合。
这几个概念的粒度不同。逻辑计划只有一个扫描节点,运行时却可以对不同数据段创建多个实例;而一次任务执行,也可以把过滤、投影等步骤连接起来,减少中间结果的反复交接。
三种处理模型
Iterator 模型为每个运算符提供 Next(),父节点反复向子节点请求一条记录。它容易组合、调试,也方便实现 LIMIT,但一条记录经过多个节点时,会反复发生函数调用和运行时分派。排序、哈希连接的构建阶段等操作还会打断流水线。
Materialization 模型一次处理输入,再把完整输出交给上层。它减少逐条交互,适合中间结果较小的场景;如果分析查询生成很大的中间结果,完整物化会增加内存流量和存储开销。
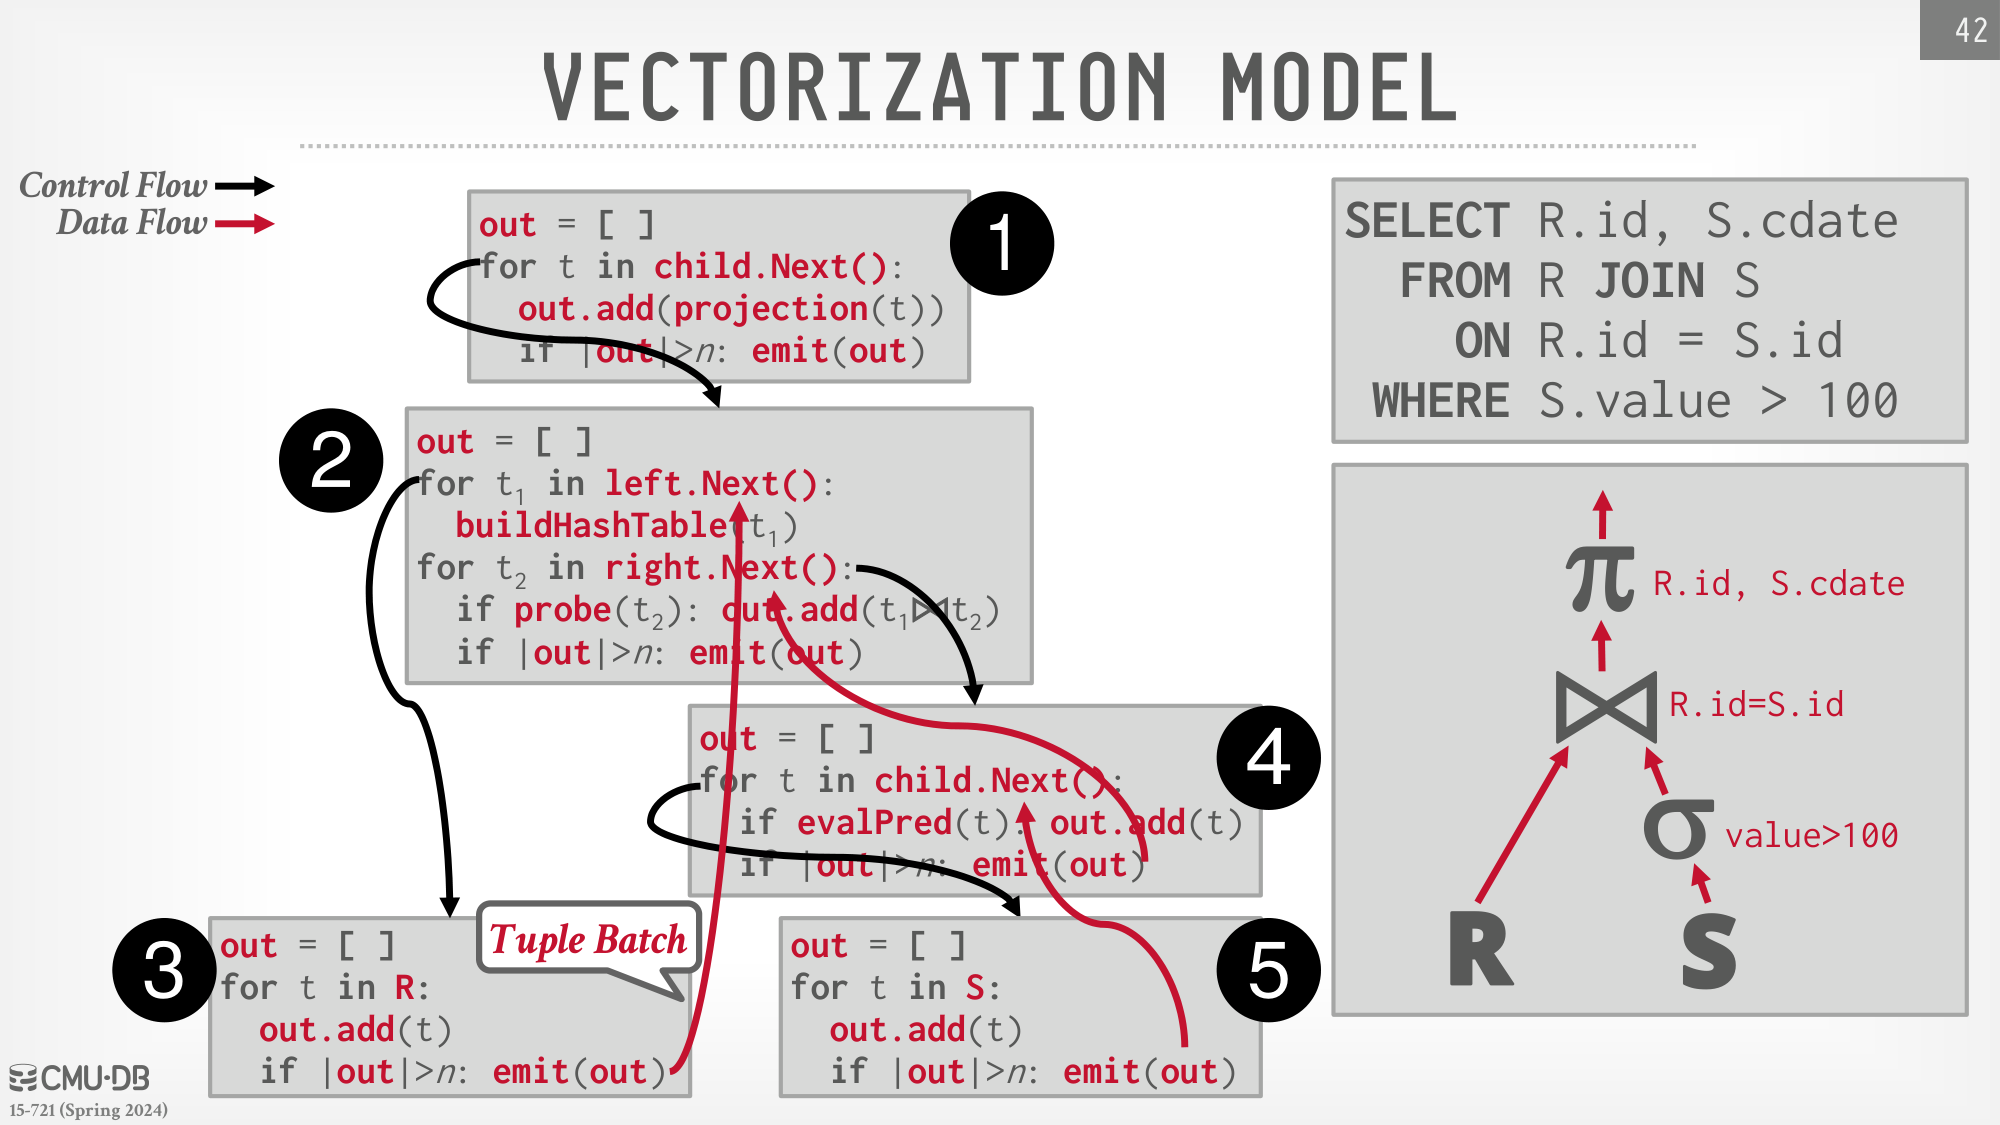
向量化或批处理模型保留批次之间的调用接口,但一次返回多条记录。运算符内部使用紧凑循环处理一批值,摊薄调用成本,也为 SIMD 留出空间。这里需要区分两个概念:一次处理一批记录是执行模型,是否使用 SIMD 指令则是批次内部的实现选择。
Pull 与 Push 是另一组选择
Pull 从根节点向下请求数据,再把结果返回给父节点。Push 从叶子节点开始,把处理后的记录送到后续运算符,更容易把同一条 Pipeline 的工作融合到循环中,让中间值停留在寄存器或缓存。
处理方向与处理粒度并不是同一个维度。逐条或批量的运算符都可以讨论 Push/Pull;Push 也不会自动消除排序、构建哈希表等阻塞点。课程同时指出,Push 对中间结果规模的精确控制,以及某些运算符的实现,会更复杂。
过滤之后怎样保留有效位置
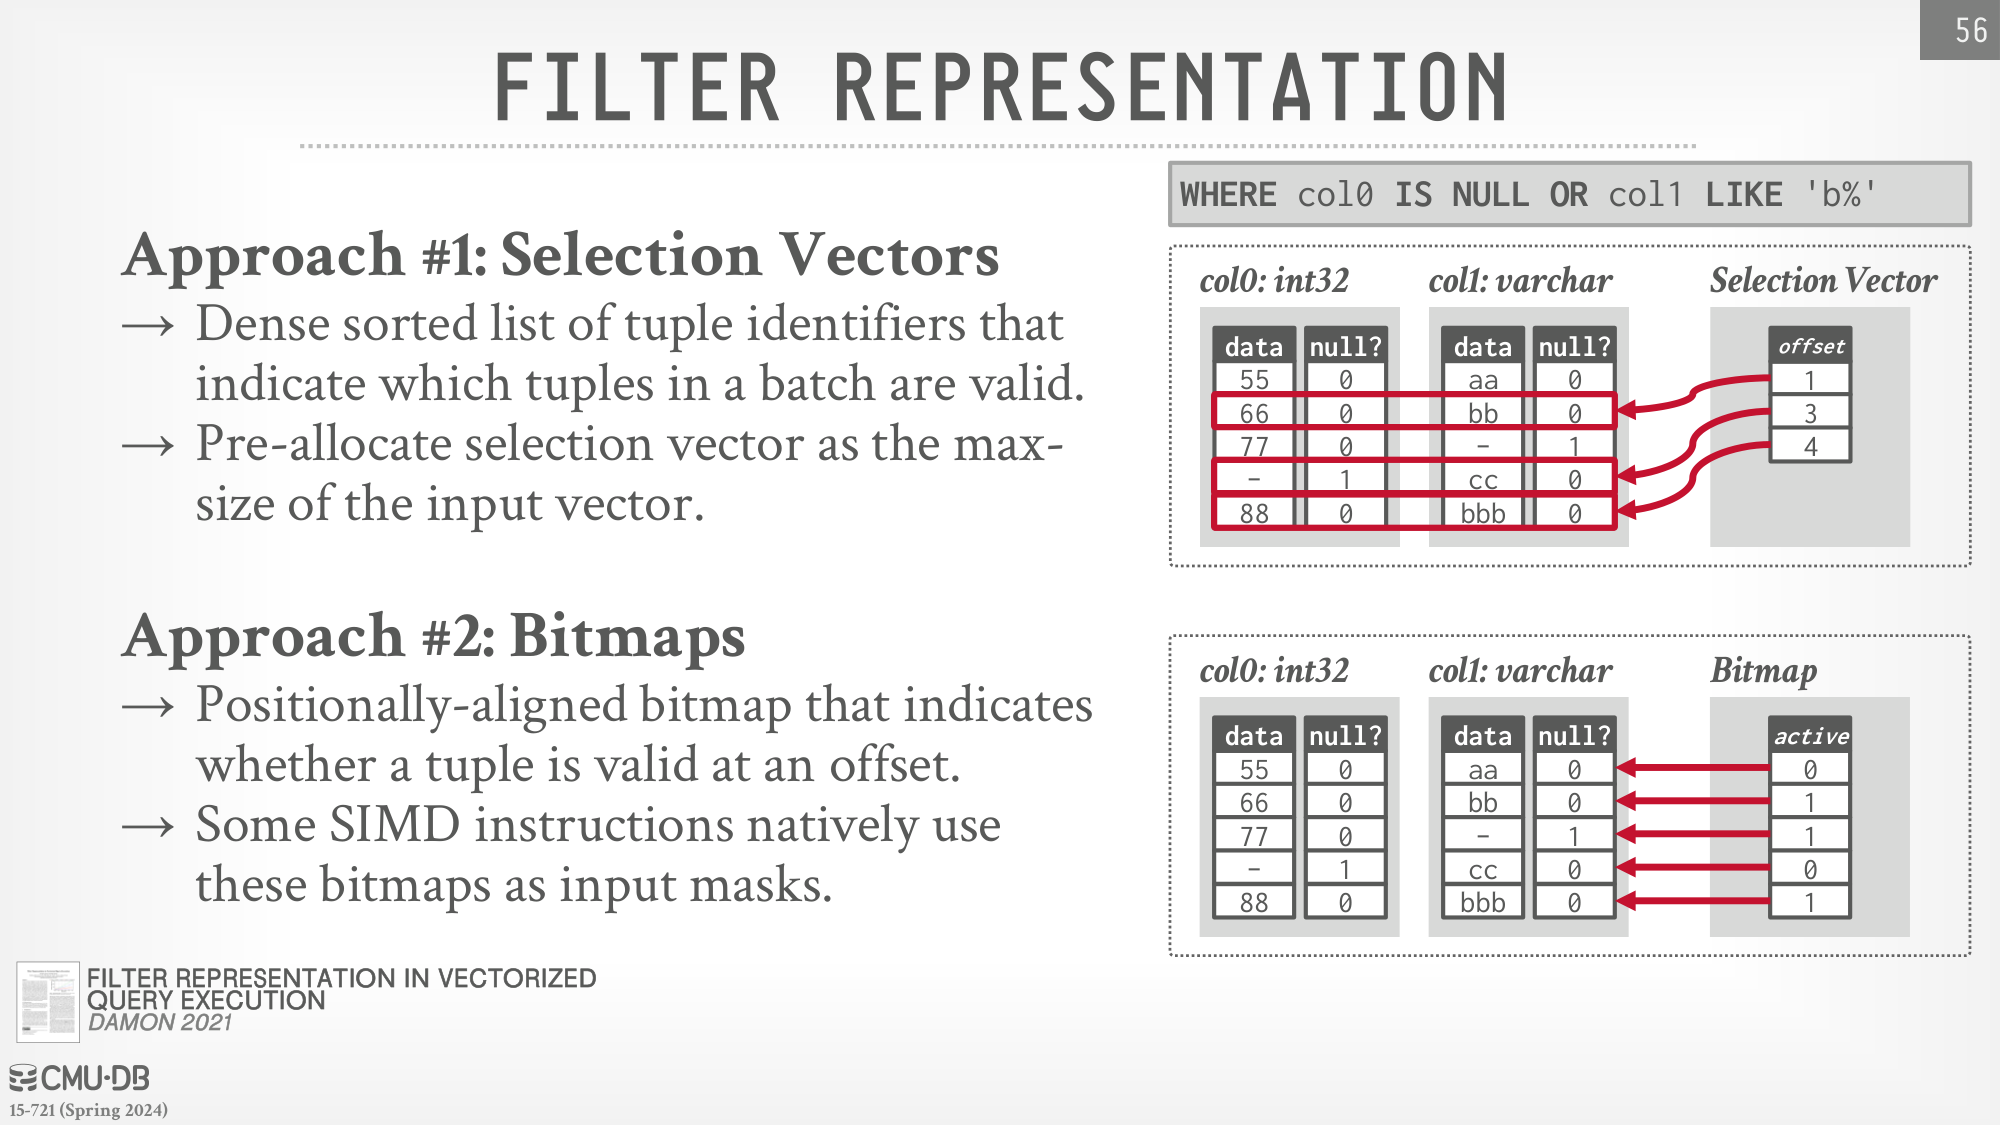
一个批次经过过滤后,不一定立即把保留值复制到新数组。Selection Vector 保存有效记录在批次中的位置;Bitmap 则让每一位对应一个位置,标识该记录是否仍有效。
位置数组适合直接枚举留下的记录;位图便于组合多个过滤结果,也能作为部分 SIMD 指令的掩码。Selection Vector 可以预分配到输入批次的最大大小,避免过滤过程中不断扩容。后续运算符必须正确传播这些有效性信息,否则被过滤的值可能重新参与计算。