课程视频
从数据库基础走向系统实现
15-721 的重点是现代分析型数据库的内部实现。课程默认我们已经学过 15-445/645 或同等内容,理解 SQL、关系代数、存储模型、内存管理和基本数据结构。在这个基础上,继续研究同一个查询在现代硬件上为什么会有不同的执行效率,以及怎样把论文中的算法实现成可靠的系统组件。
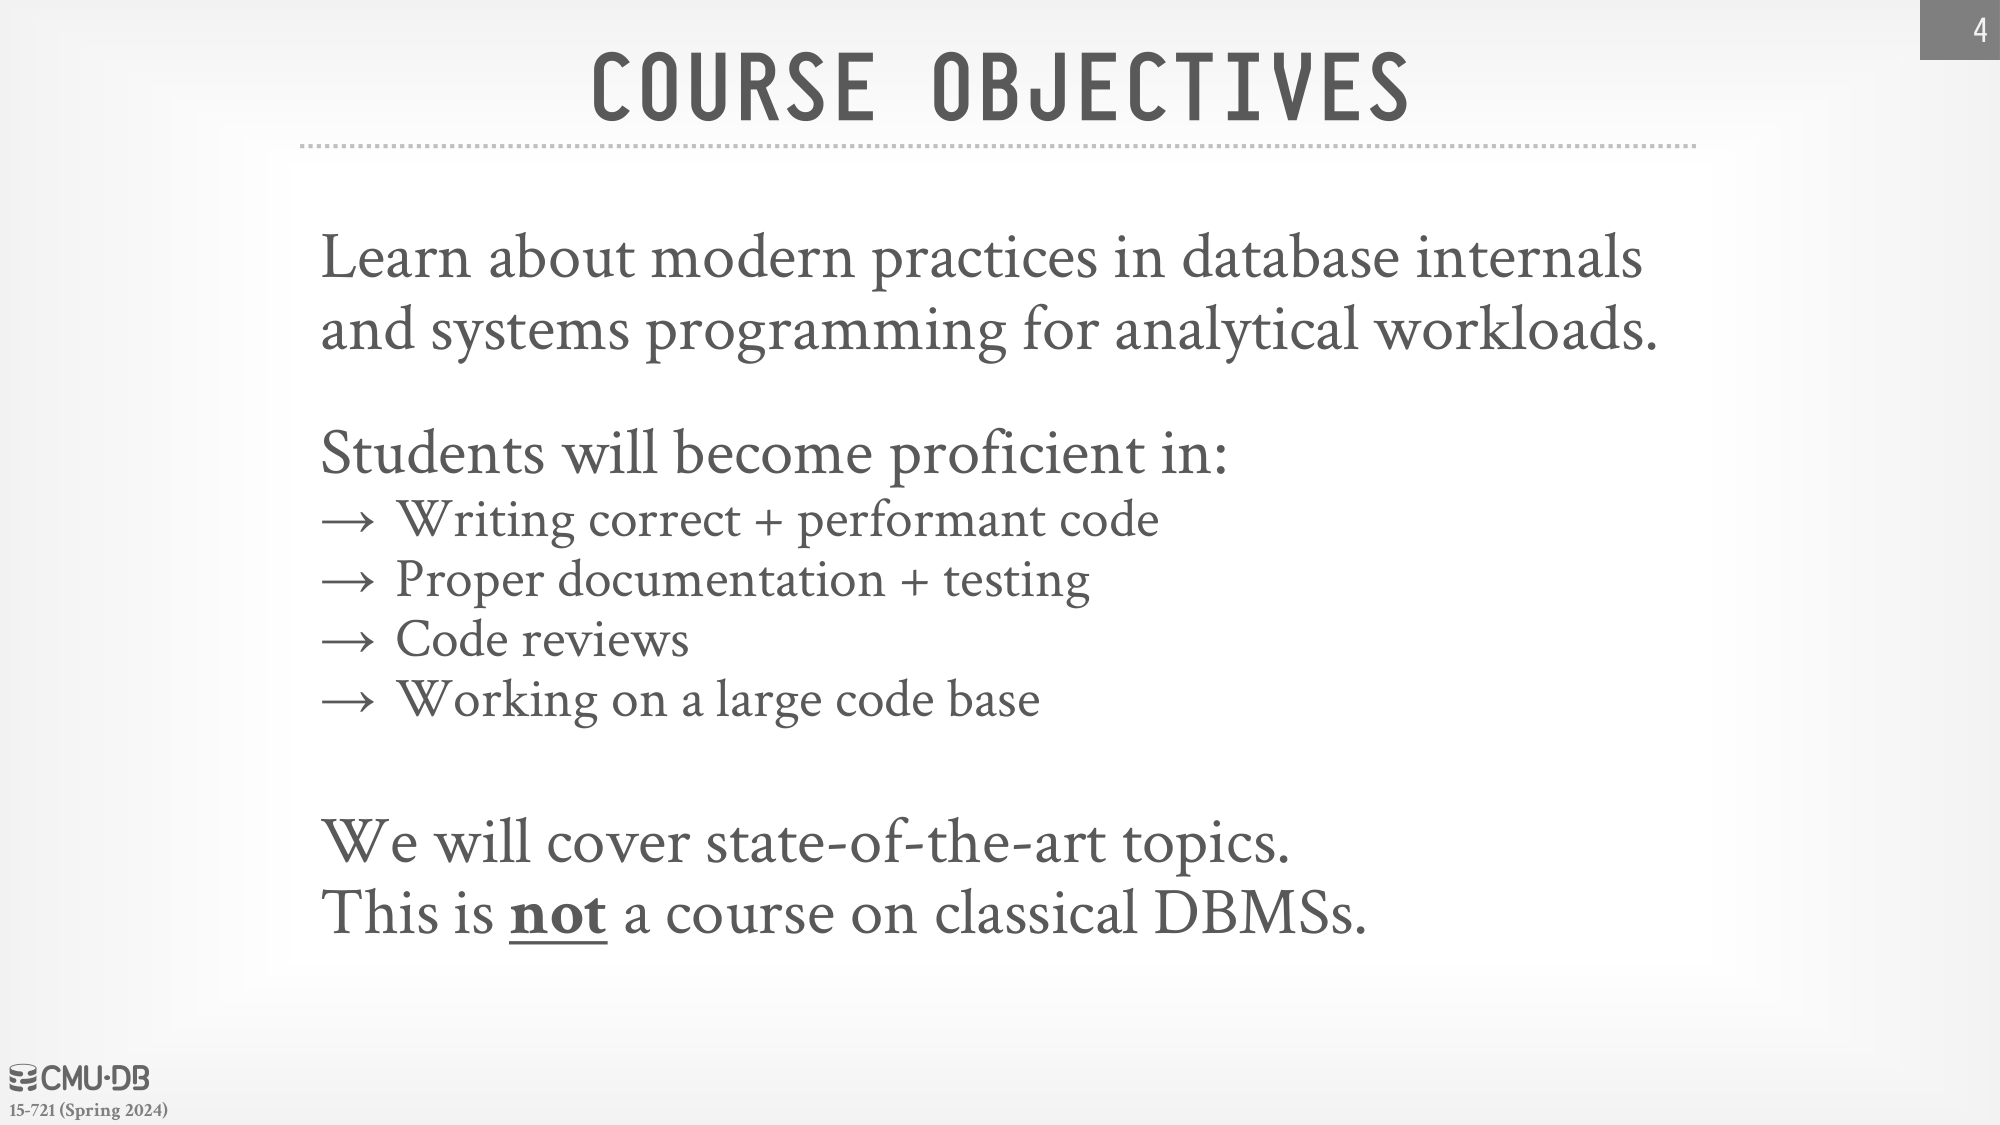
课程希望训练的能力包括编写正确且高效的代码、完善文档与测试、开展代码评审,以及在大型代码库中协作。这里的“高效”需要实验支撑:修改一个数据结构之后,既要说明它为什么更快,也要检查收益来自哪种数据分布、硬件条件和负载。
课程围绕哪些组件展开
前半部分从数据格式、编码和压缩进入执行引擎,再讨论向量化、代码生成、查询调度、并行连接与网络协议。之后进入优化器实现和代价模型,最后分析 BigQuery、Databricks、Snowflake、DuckDB、Yellowbrick 与 Redshift。
这条顺序便于把组件之间的关系串起来:编码决定执行器读到什么数据,执行模型决定运算符怎样协作,调度器决定任务落在哪些计算资源上,优化器则需要在这些实现提供的选择中寻找执行计划。
阅读论文与记录课程内容
2024 年课程的成绩由论文阅读报告(15%)、课堂笔记(10%)、期末考试(15%)和学期项目(60%)组成。每次课有一篇必读论文,选读论文用于补充相关方案。
阅读报告需要说明论文的主要思想、关键发现、系统如何修改,以及评估使用的工作负载。按照这个顺序阅读,可以避免只记下某张性能图中的倍数,却没有记下作者解决的问题和实验条件。
课程对阅读报告和课堂笔记作了不同规定:阅读报告必须独立撰写,不能由 AI 生成;课堂笔记允许 AI 辅助,但需要说明所用工具,并由提交者负责内容准确性。课件也明确允许课堂笔记使用课程 slide 中的图片。这些是当年课程作业的要求,自学时仍可以借用其检查材料的方法。
学期项目:共同搭建分析型数据库
项目要求三人一组,用 Rust 实现云原生 OLAP 数据库的一个组件,整体设计主题是自适应。课程希望后续把这些组件连接起来,形成一个可以工作的数据库原型。
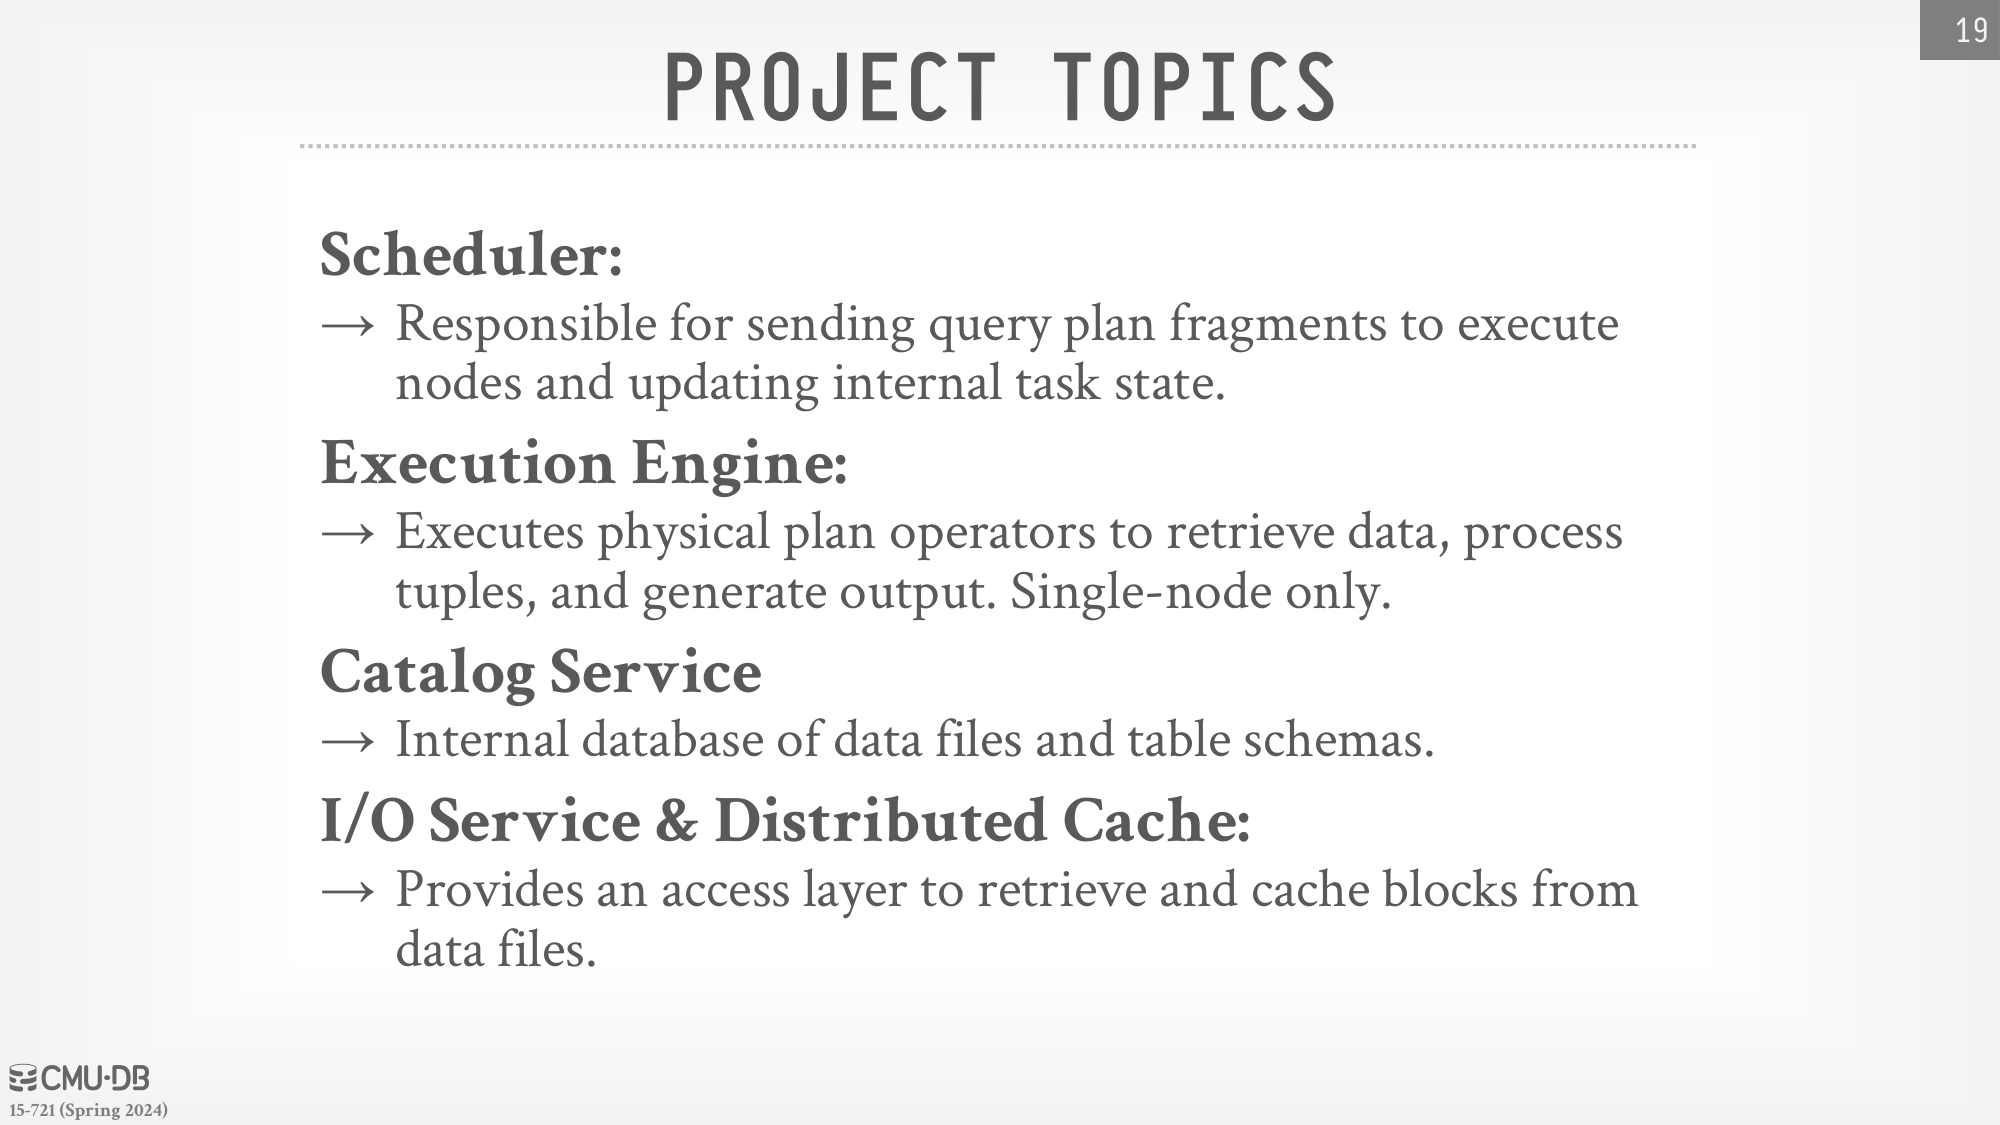
项目包括调度器、执行引擎、目录服务、I/O 服务与分布式缓存,以及查询优化器。调度器分发执行片段并维护任务状态;单机执行引擎负责运行物理运算符;目录记录数据文件和表结构;I/O 服务获取和缓存数据块;优化器结合规则与代价搜索生成物理计划。
同一主题通常安排两个小组,既要协作制定接口,也要比较实现效果;优化器的两个小组则在已有原型上负责不同问题。除优化器外,其他组件要求从头实现,可以参考已有系统的设计。
项目计划需要写清架构、正确性测试和评估负载,还要明确接口支持的操作、输入输出编码、状态码与错误处理。把接口留到最后才讨论,会导致各组件都能单独运行,却无法组合执行查询。
怎样证明实现有效
项目评估需要同时回答两个问题:结果是否正确,性能是否达到预期。正确性测试要覆盖组件的正常路径与边界条件;性能实验则需要给出可重复的负载和对照,说明瓶颈究竟在计算、内存访问还是 I/O。
对自学而言,可以沿课程逐个建立这种对应关系:读懂一个实现方案,定位它在数据库中的位置,再找出能够验证它的实验。后续笔记也沿这个顺序记录原课概念、图示与取舍。