课程视频
调度器决定在哪里、何时执行任务
查询计划描述要执行哪些运算符,调度器还要决定创建多少任务、使用哪些 Worker、任务落在哪些核心上,以及完成后把输出交给谁。数据库知道 Pipeline 依赖和数据位置,可以据此做操作系统难以独立完成的判断。
课程中的目标包括提高吞吐、降低调度开销、减少尾延迟,并保持公平性。短查询需要及时完成,长查询也不能一直得不到计算资源。
Worker、任务与数据位置
进程模型可以为每个 Worker 使用独立进程、使用进程池,或在单个进程中维护多个工作线程。线程共享地址空间,通信方便,但共享状态需要同步;独立进程则需要显式的进程间通信或共享内存设计。
一个核心可以绑定一个 Worker,减少线程争抢和迁移;也可以准备多个 Worker,在某个线程阻塞时运行其他任务。任务分配还分为 Dispatcher 主动推送,以及 Worker 从队列主动获取。任务的 Push/Pull 与运算符处理数据的 Push/Pull 是不同层次的选择。
分区决定怎样把数据拆成子集,放置决定这些子集落在哪里。NUMA 机器中,远端内存访问通常比本地访问昂贵,因此调度不只要看哪个核心空闲,还要看数据属于哪个内存节点。
从静态分配到 Morsel-Driven Scheduling
静态调度在查询开始前决定任务和线程数量,执行期间不再调整。即使各任务输入行数相同,过滤率、连接结果和数据倾斜仍可能造成工作量不均衡,最后只剩少数 Worker 忙碌。
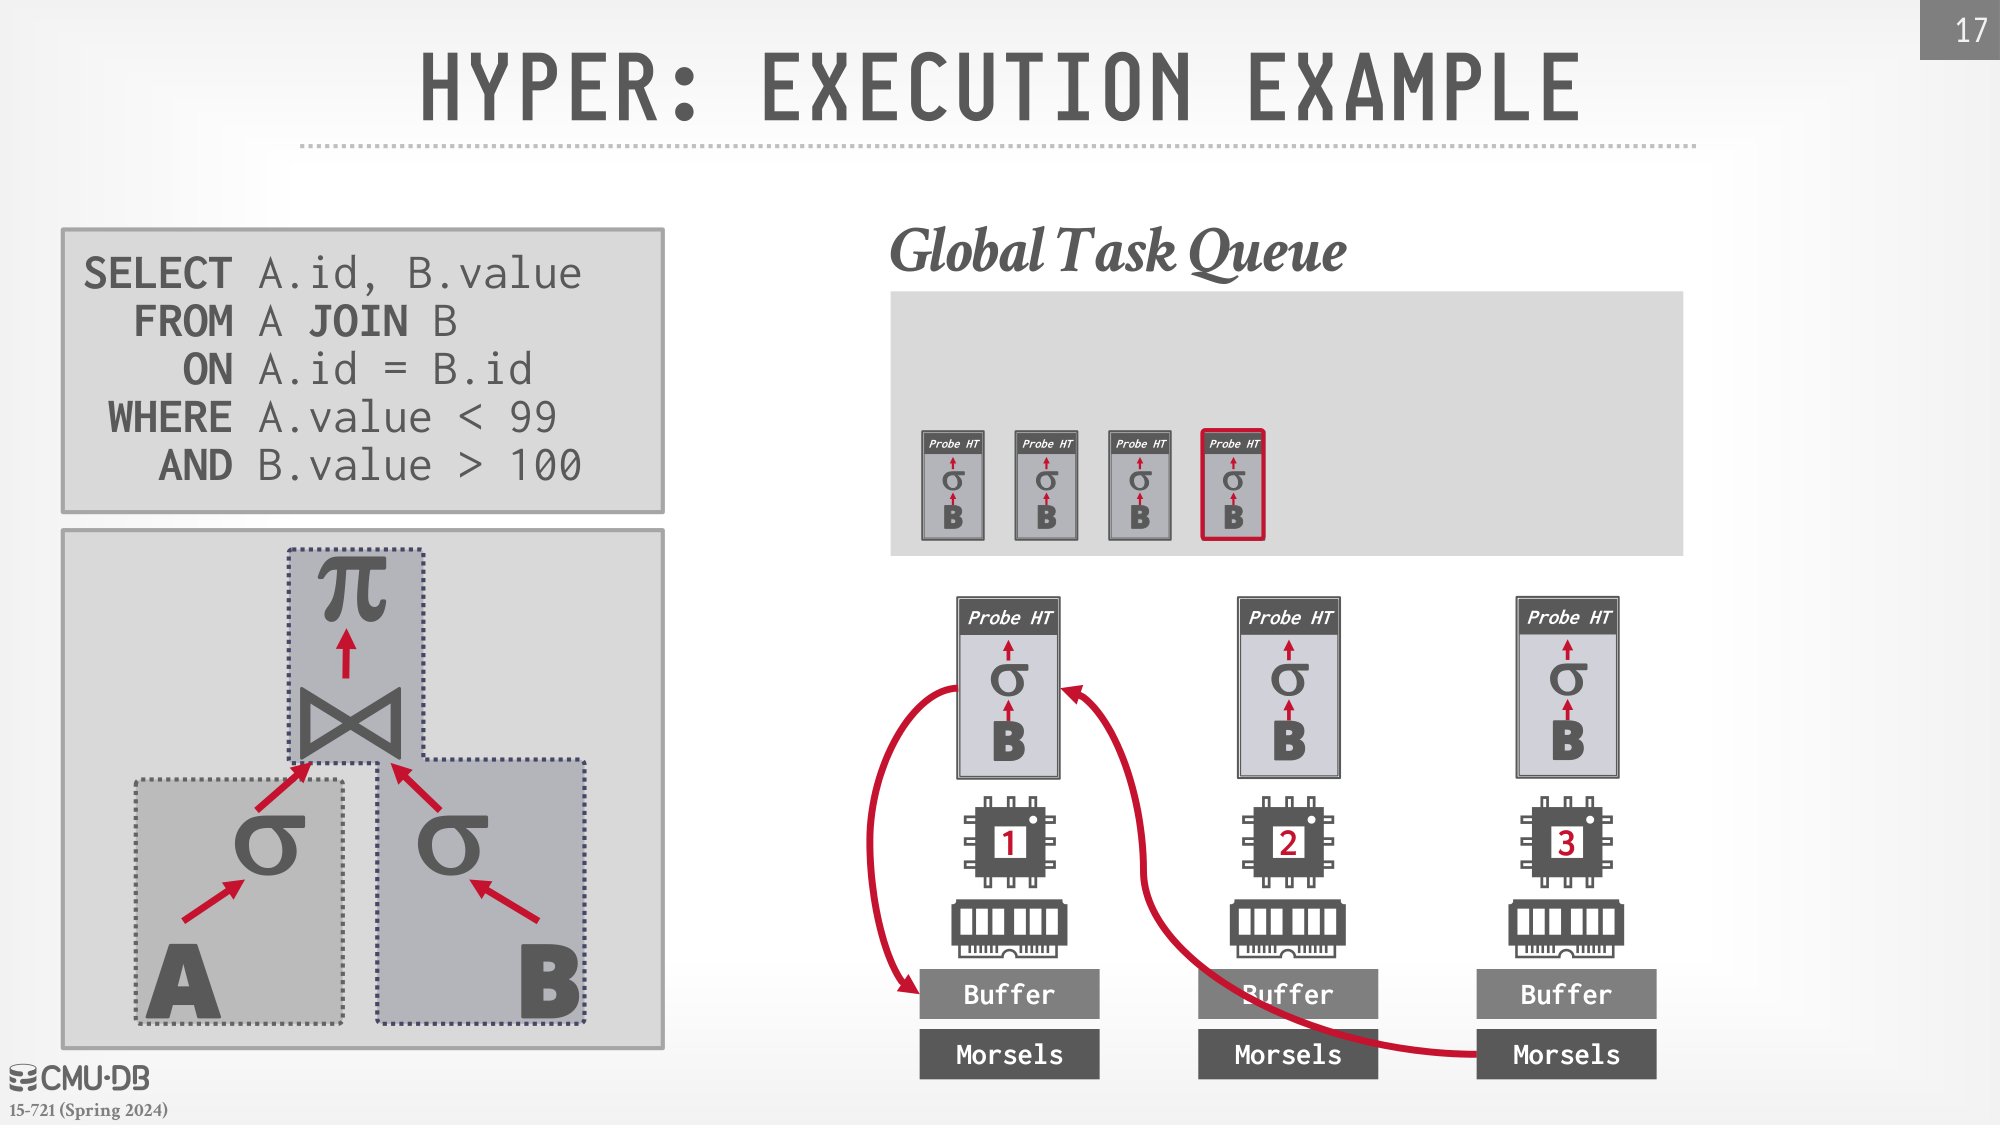
HyPer 把输入划成较小的水平数据段 Morsel,Worker 处理完一段再领取下一段。原论文通过实验选取约十万条记录的粒度,使调度开销可以被计算摊薄,同时保留负载调整空间。
Worker 优先选择本地数据上的任务,本地没有可用任务时再获取其他工作。这样可以缓解慢任务拖住整个查询的问题,但跨 NUMA 节点取任务也可能增加数据移动与缓存成本。
Umbra:用时间调整任务粒度
固定行数不保证固定处理时间。Umbra 根据测得的执行耗时调整 Morsel 大小,把单个任务朝约 1 毫秒的目标组织,并使用优先级衰减平衡不同查询。
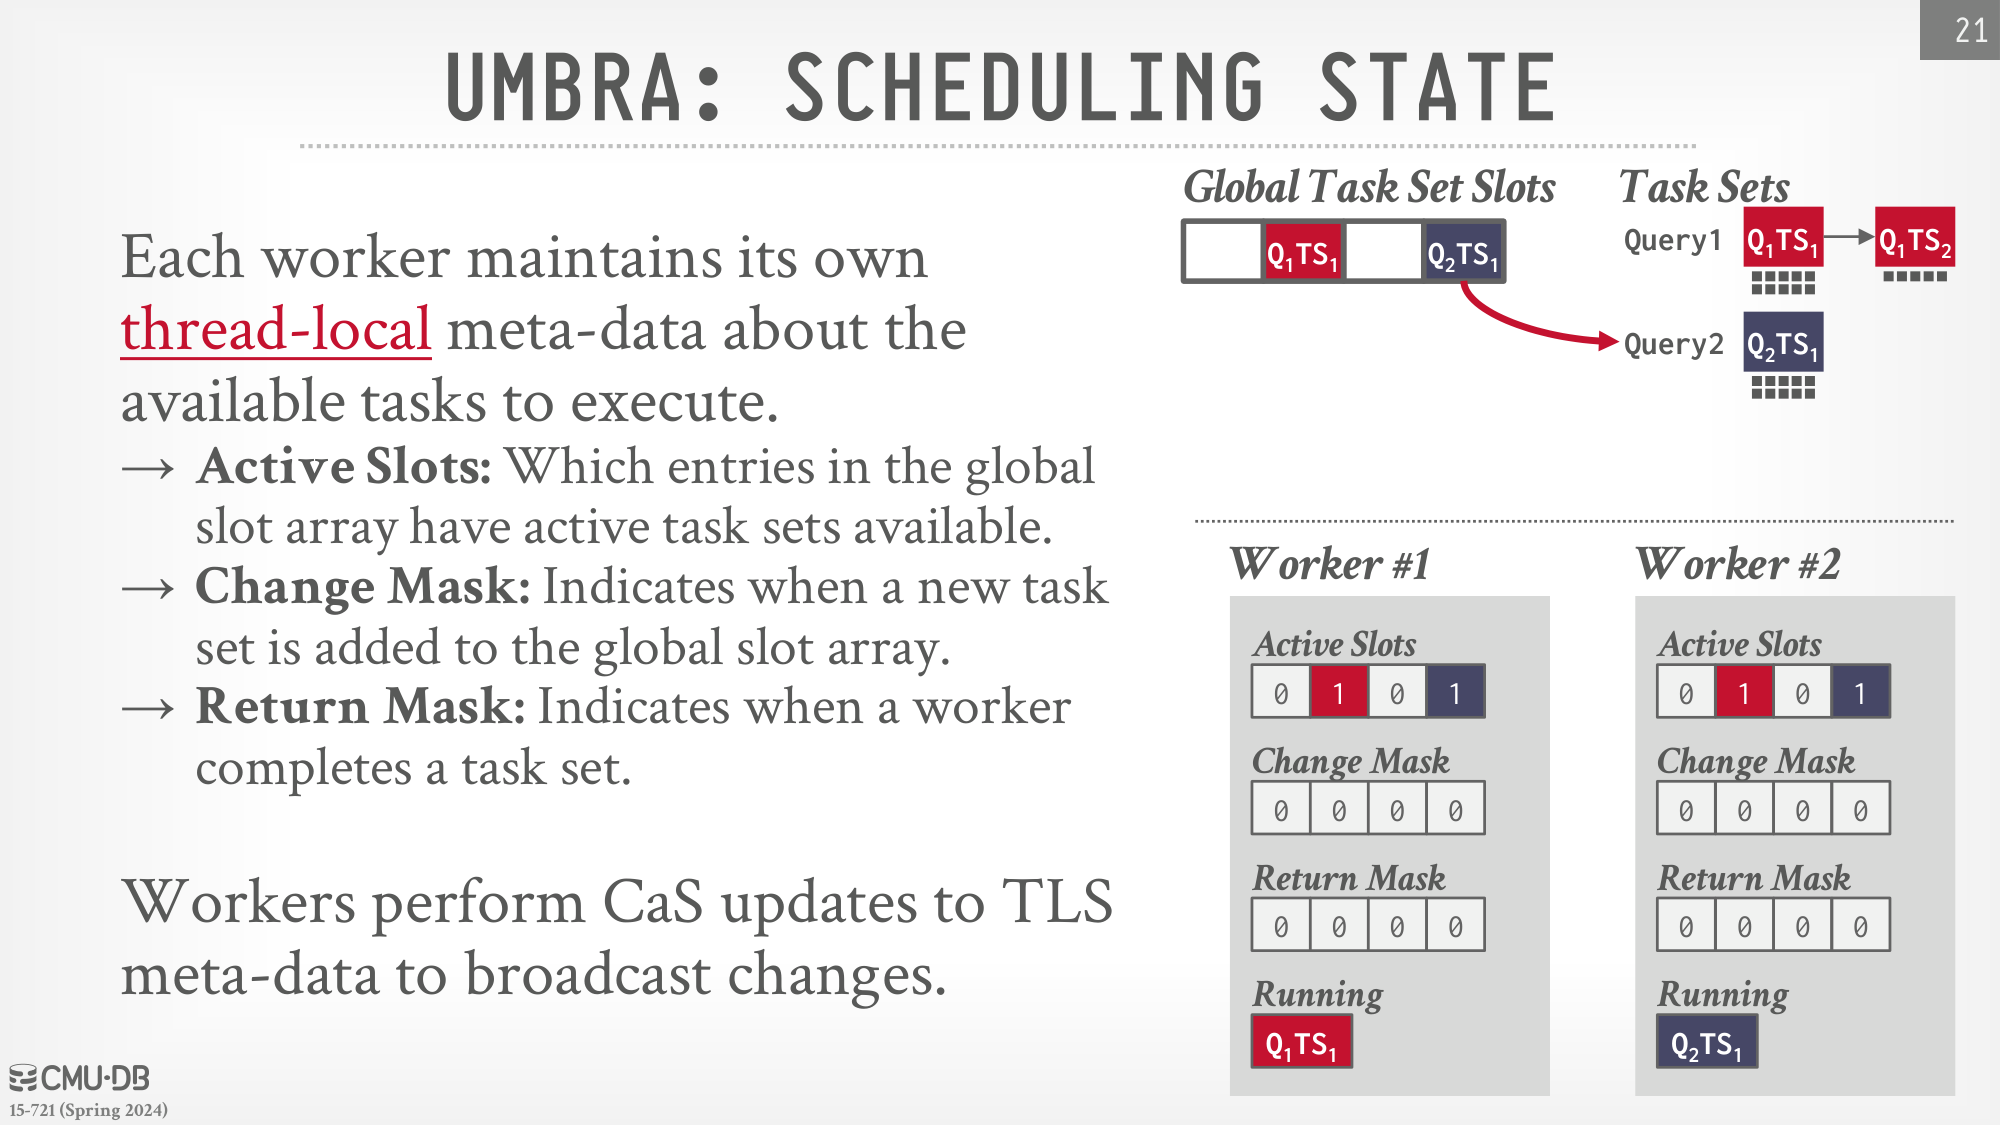
Worker 维护本地任务状态,位掩码记录活动任务集合、新增任务与完成通知,避免每次领取工作都扫描和争用同一个全局结构。优先级状态再反映查询已经消耗的时间,让短任务有机会快速完成,同时维持长任务进展。
这里的约 1 毫秒是论文方案的调度目标,并不是数据库任务必须遵守的通用常数。更小任务提高响应能力,也可能增加领取和更新状态的成本。
HANA 与 SQLOS 的不同做法
SAP HANA 把 Worker 组织成线程组,维护软、硬优先级队列,允许线程从其他组的软队列窃取任务,并由 Watchdog 观察饱和情况。线程还区分正在工作、因同步阻塞、短暂空闲和停驻等状态。
SQL Server 的 SQLOS 在数据库内部提供资源抽象和协作式调度。任务通过代码中的 Yield 点主动交出执行权,因此实现需要保证长时间运行的代码也会适时让出资源。
从单机调度扩展到分布式协调
前面的方案假定可以低延迟访问 Worker 状态。分布式环境还要跟踪节点和任务依赖,协调内存、网络与临时磁盘资源,不能只分配 CPU 时间。
查询超出预期时,可以在执行前配置更多 Worker,也可以让空闲 Worker 接手其他节点的任务。动态扩容与工作窃取分别改变资源容量和现有资源的使用方式,都需要考虑数据位置、任务状态和转移成本。
同样的思想也适用于维护工作:后台任务可以以较低优先级参与调度,而不是完全游离在查询的资源预算之外。