课程视频
Group 与 Multi-Expression 怎样压缩搜索空间
Cascades 把产生相同逻辑结果的表达式组织进 Group。例如,同一组关系的不同连接顺序,以及实现这些逻辑结果的哈希连接、嵌套循环连接,都可以作为候选保存在相关 Group 中。
Multi-Expression 的子节点引用其他 Group,不直接固定某棵子树。父表达式因而可以隐式表示多个组合,只有搜索需要时才继续展开。
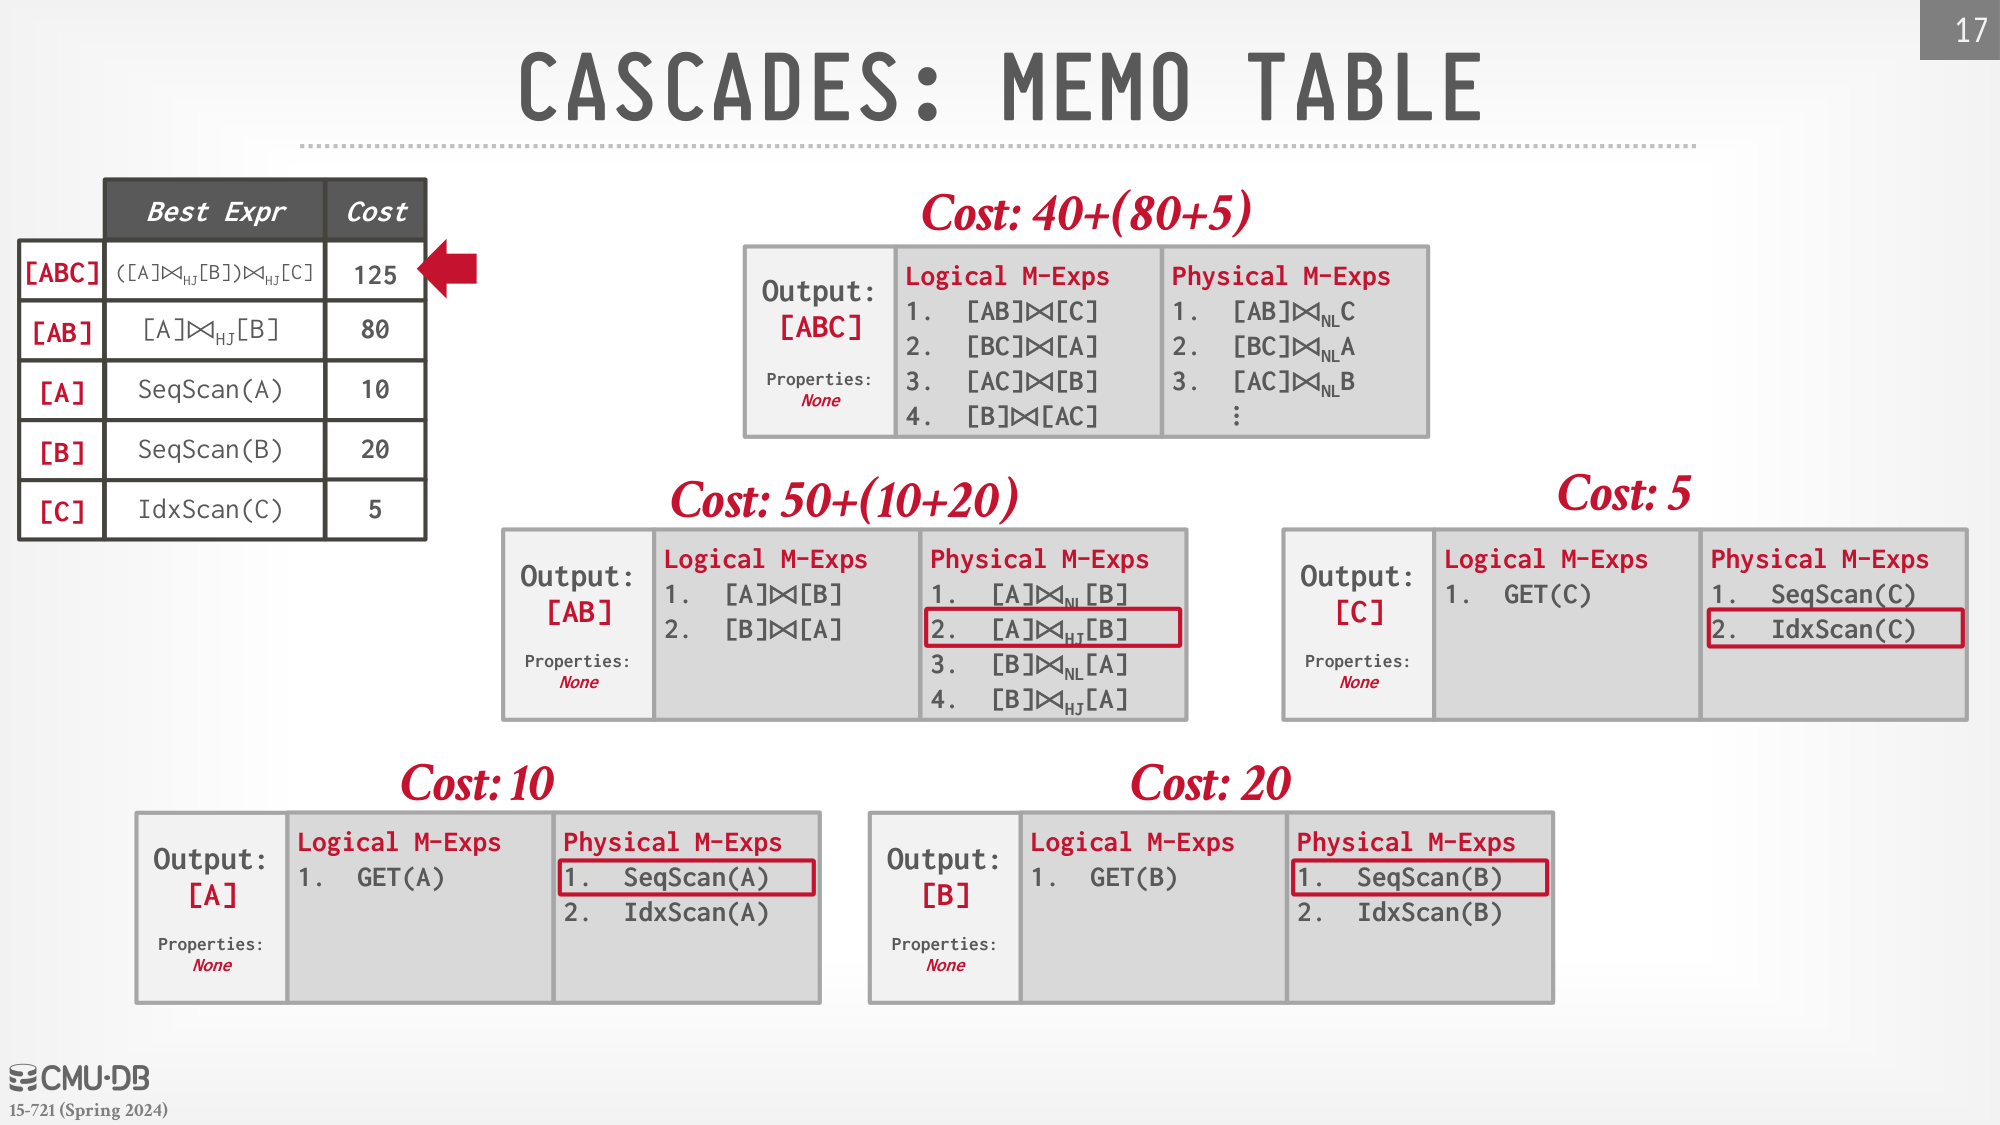
Memo 保存已探索的表达式、分组、属性与代价,并辅助消除重复。最优子结构需要在相同逻辑结果与物理属性要求下比较;一个无序子计划更便宜,并不能证明它优于后续需要有序输入的另一候选。
规则、任务与搜索预算
Transformation Rule 把逻辑表达式变成等价的逻辑表达式,Implementation Rule 提供物理实现。规则包含匹配 Pattern 与 Substitute,匹配到相应结构后再生成替代方案。
任务结构决定何时匹配、应用规则、优化子 Group 和比较代价。高潜力规则可以优先执行,其他转换延后,配合分支限界减少无望候选。搜索仍需要预算或终止条件,否则等价变换的数量很容易膨胀。
课程随后回到随机搜索:模拟退火允许以一定概率接受暂时更贵的候选,尝试离开局部最优;遗传搜索通过候选组合继续探索连接顺序。它们改变搜索覆盖方式,并不取消物理属性与正确性约束。
真实系统还需要哪些工程能力
SQL Server 使用 Cascades 风格的任务与规则组织;Calcite 提供可插拔语言、规则和代价模型,其物理属性通过 Trait 表达;Orca 通过接口接收目录、统计与逻辑计划,生成物理计划;CockroachDB 使用 OptGen 描述规则并生成实现代码。
Orca 的工程设计还包括优化器状态转储,使开发者能够用输入和上下文重放失败案例。优化器不能只验证“能够返回计划”,还要检查改写后的结果正确、估计与运行表现合理,并能定位回归来源。
无关子查询与相关子查询
无关子查询不引用外层属性,通常可以独立计算并复用结果。相关子查询则需要外层值作为参数,逻辑上可以理解为针对每条外层记录求值。
1 | SELECT name, major |
课件用这个查询找出各专业中分数最高的学生。直接逐行求内部最大值会重复处理相同专业的数据;去关联后,可以尝试把按专业计算的结果与外层学生关联。
从模式规则到 Dependent Join
启发式方法识别特定子查询形状,再改写成连接。规则容易逐步增加,但嵌套层数、聚合、空值与重复语义会产生大量组合,小的 SQL 变化也可能让某条规则失配。
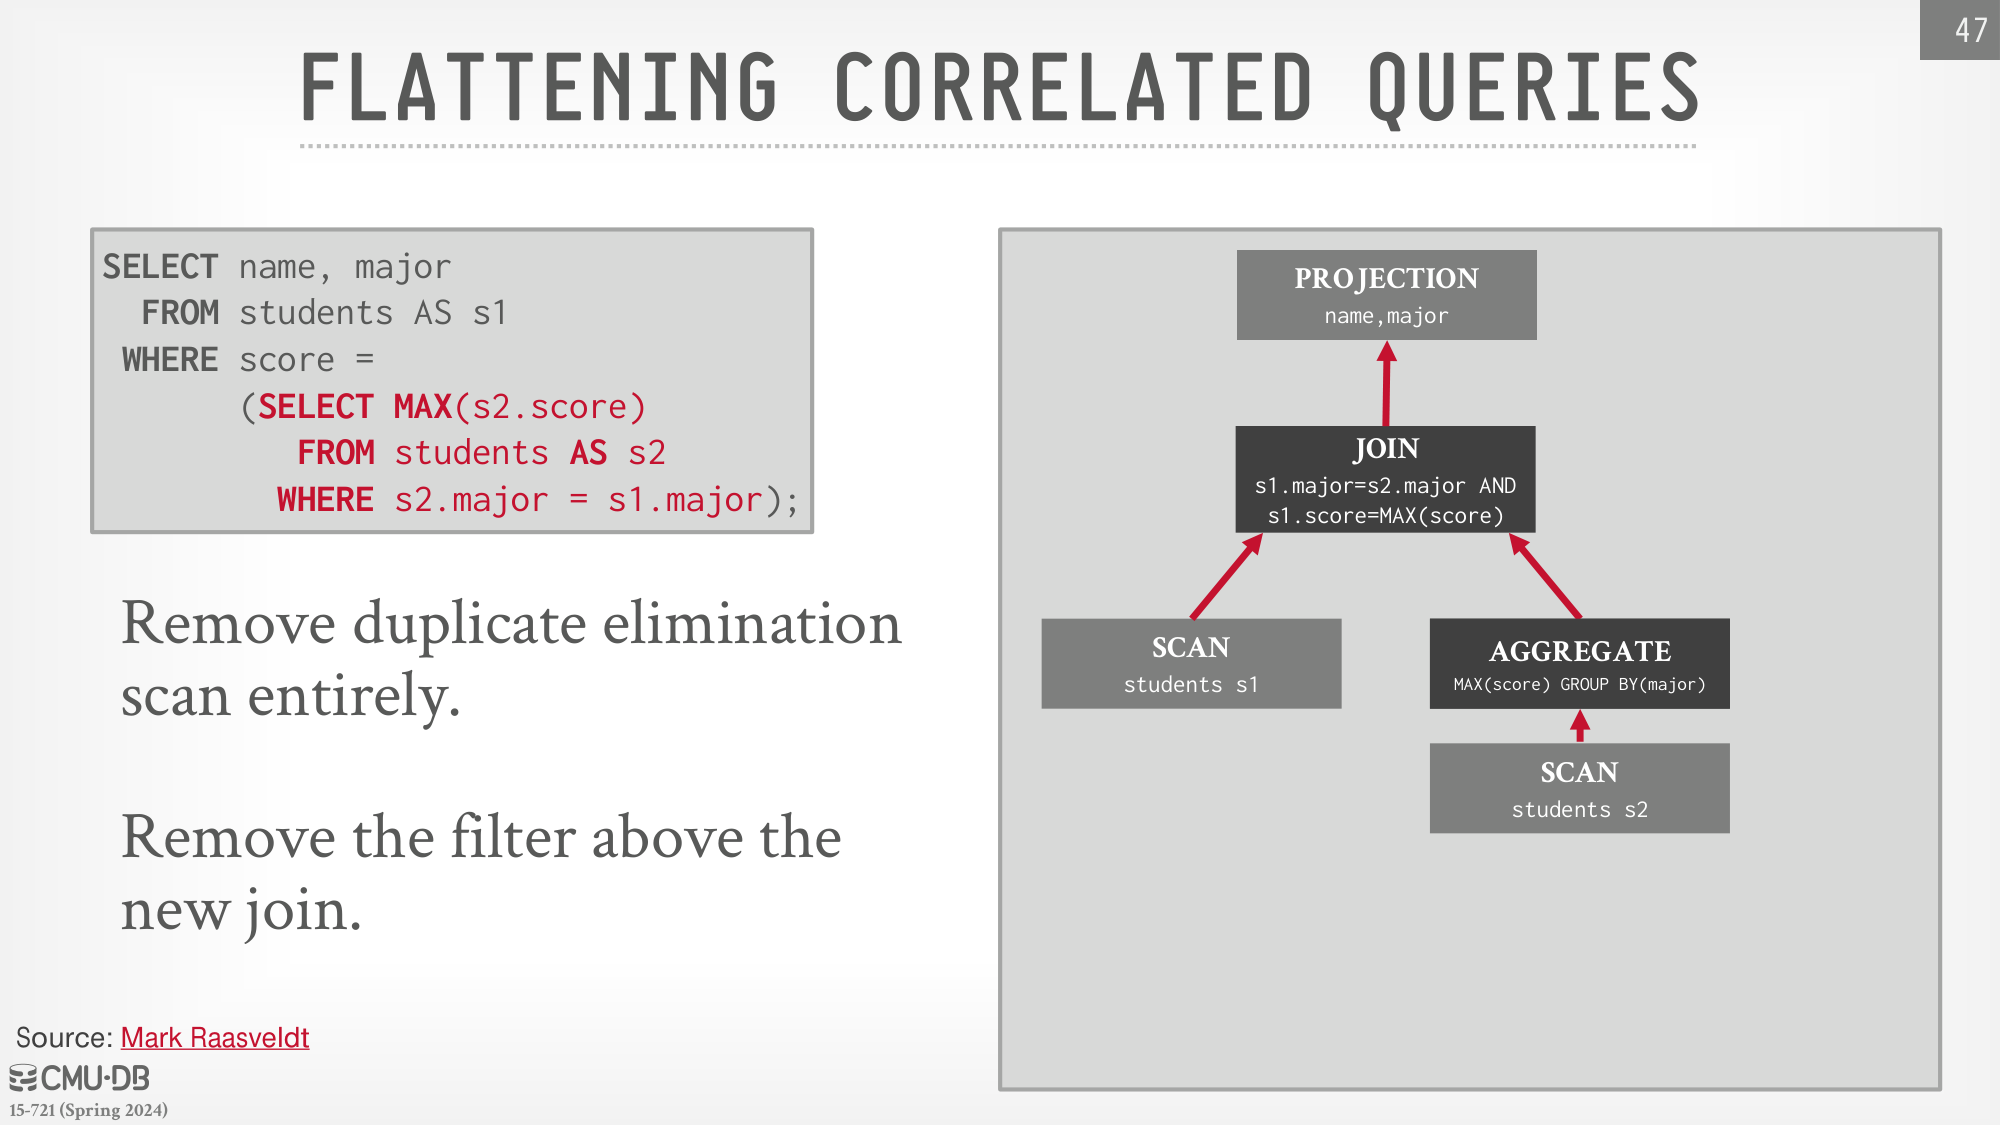
课程介绍的系统化去嵌套把相关关系表示为 Dependent Join,再把它逐步推入右侧计划。对相关参数组合进行去重,减少相同参数的重复计算;当右侧不再依赖左侧时,依赖连接可以转换成普通关系运算,再清理多余结构。
去重只针对需要复用计算的参数域,最终仍须恢复原查询的重复行与空值行为。这里的转换不是简单把所有子查询替换成普通内连接,标量子查询、聚合和不存在匹配行时都需要维护各自语义。
下一讲继续讨论另一种不确定性:即使搜索与改写都正确,运行时发现数据规模与估计相差很大,系统还能怎样修正计划。