课程视频
分析查询为什么重视顺序扫描
OLAP 查询通常在只读数据上扫描较大的范围,并且只访问表中的部分列。OLTP 查询则更常通过索引定位个别记录,还需要支持增量更新。两类负载对布局的要求不同,不能仅根据“索引比扫描快”来决定分析系统的访问方式。
课程列举的扫描优化包括编码压缩、并行化、聚簇排序、延迟物化、数据跳过、向量化和代码专门化。这一讲先解决最底层的问题:数据以什么布局保存,读取时又怎样知道其中的内容。
NSM、DSM 与 PAX
NSM(N-ary Storage Model)把一条记录的大部分属性连续放在同一页,适合按实体读取和插入。DSM(Decomposition Storage Model)把同一列的值连续组织起来,查询只读少数列时,可以减少无关数据的访问。
列式布局还需要恢复记录之间的对应关系。固定长度数组可以通过偏移定位某一行;另一种方法给每个值附带 Tuple ID,但要增加定位结构。变长字符串直接补齐到固定长度会浪费空间,字典编码可以把重复字符串转换成较小的定长编号。
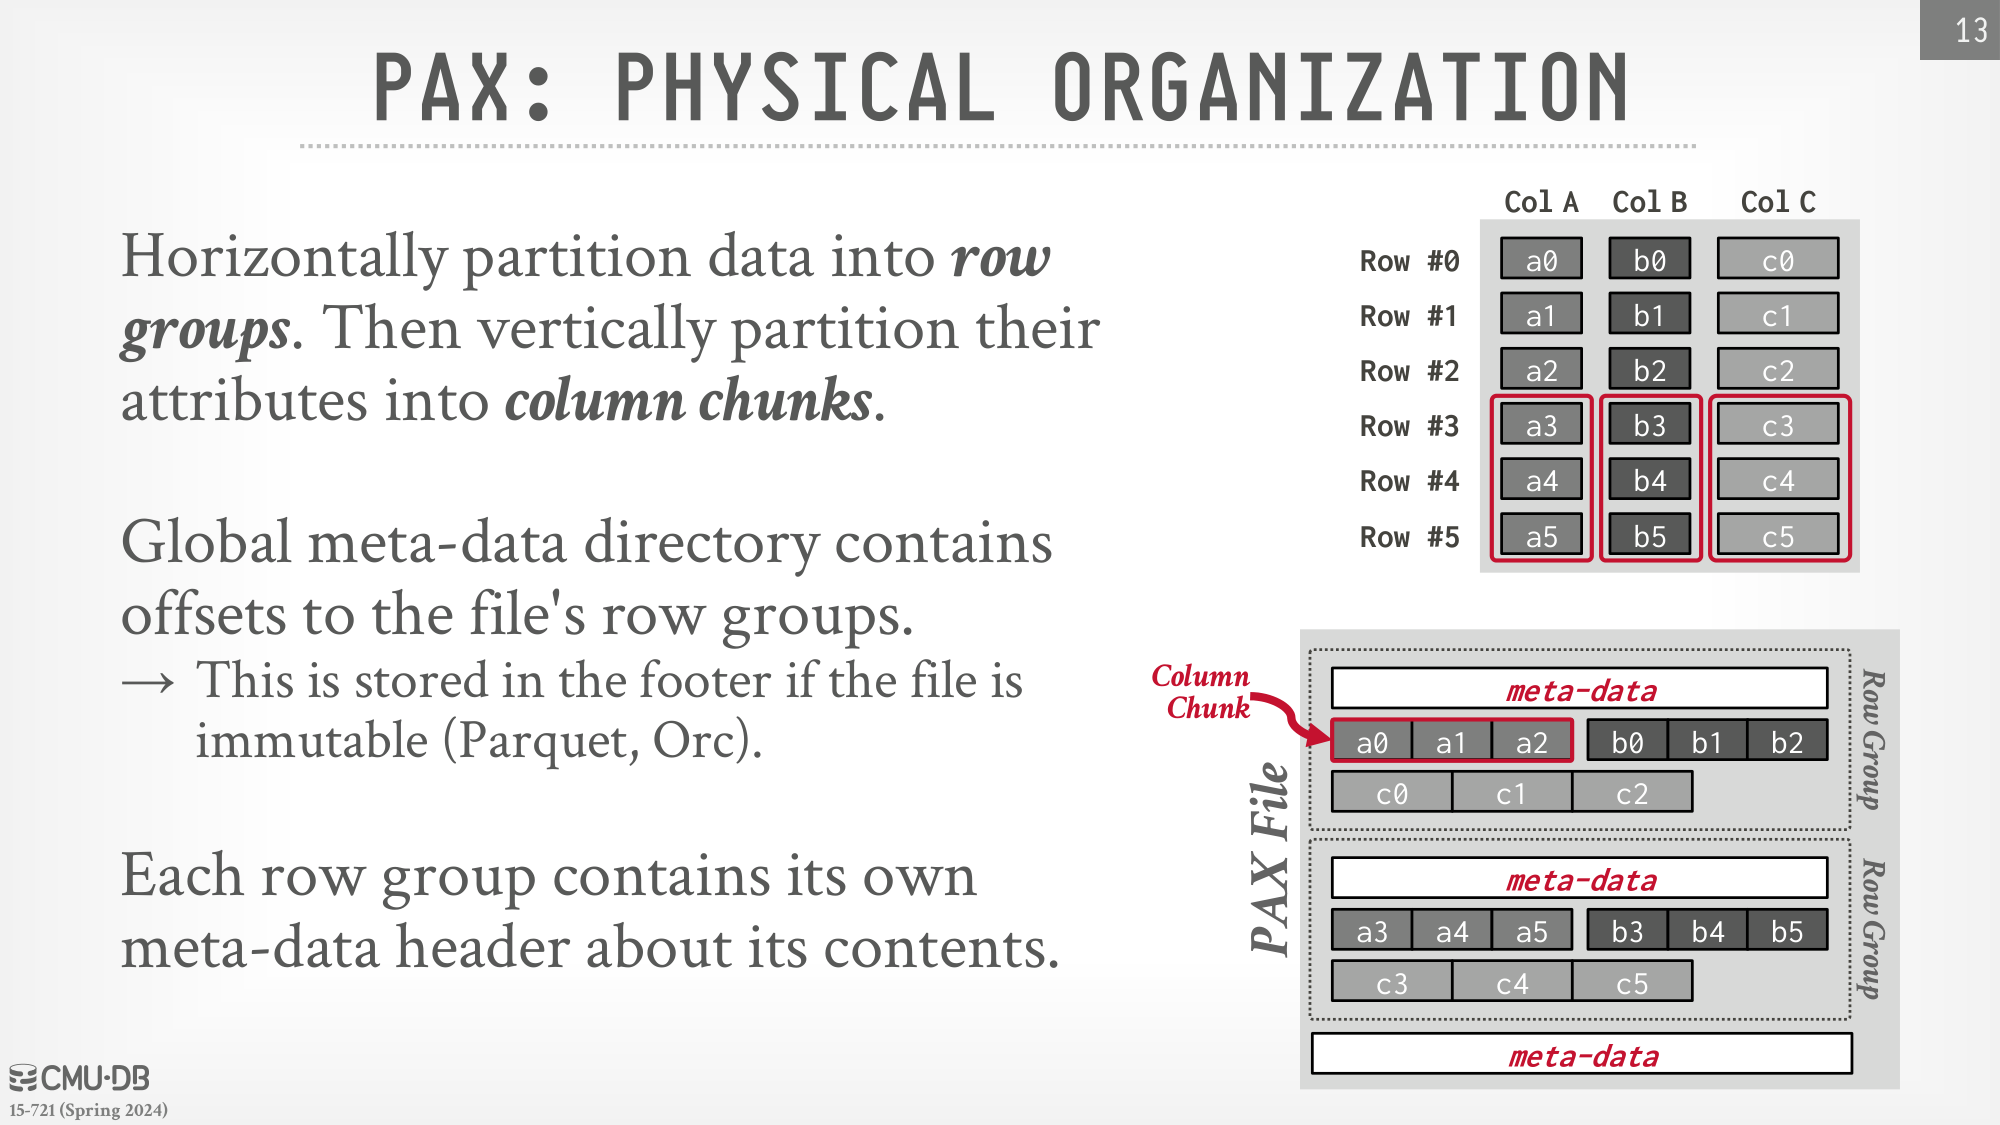
PAX(Partition Attributes Across)先把记录横向划分成行组,再把组内各列分开存放。它保留列式扫描的优势,同时让同一批记录的不同列在物理位置上较接近,降低重新拼接记录时的访问距离。Parquet 与 ORC 都可以从这种分组列式布局理解。
文件需要自带哪些信息
开放文件格式使多个系统能够直接共享二进制数据,减少 CSV、JSON 等中间转换。为了让文件可独立解释,文件元数据通常包含表结构、行组位置、记录数量和统计信息;不可变文件可以把全局目录放到尾部。
评价格式时,需要同时看布局、类型系统、编码、块压缩、过滤结构与嵌套数据表示。行组越大,顺序访问与压缩可能越有利,但读取粒度、内存占用和跳过效果也随之变化。不同实现的行组大小定义未必相同,不能只比较一个配置数字。
编码与块压缩各解决什么问题
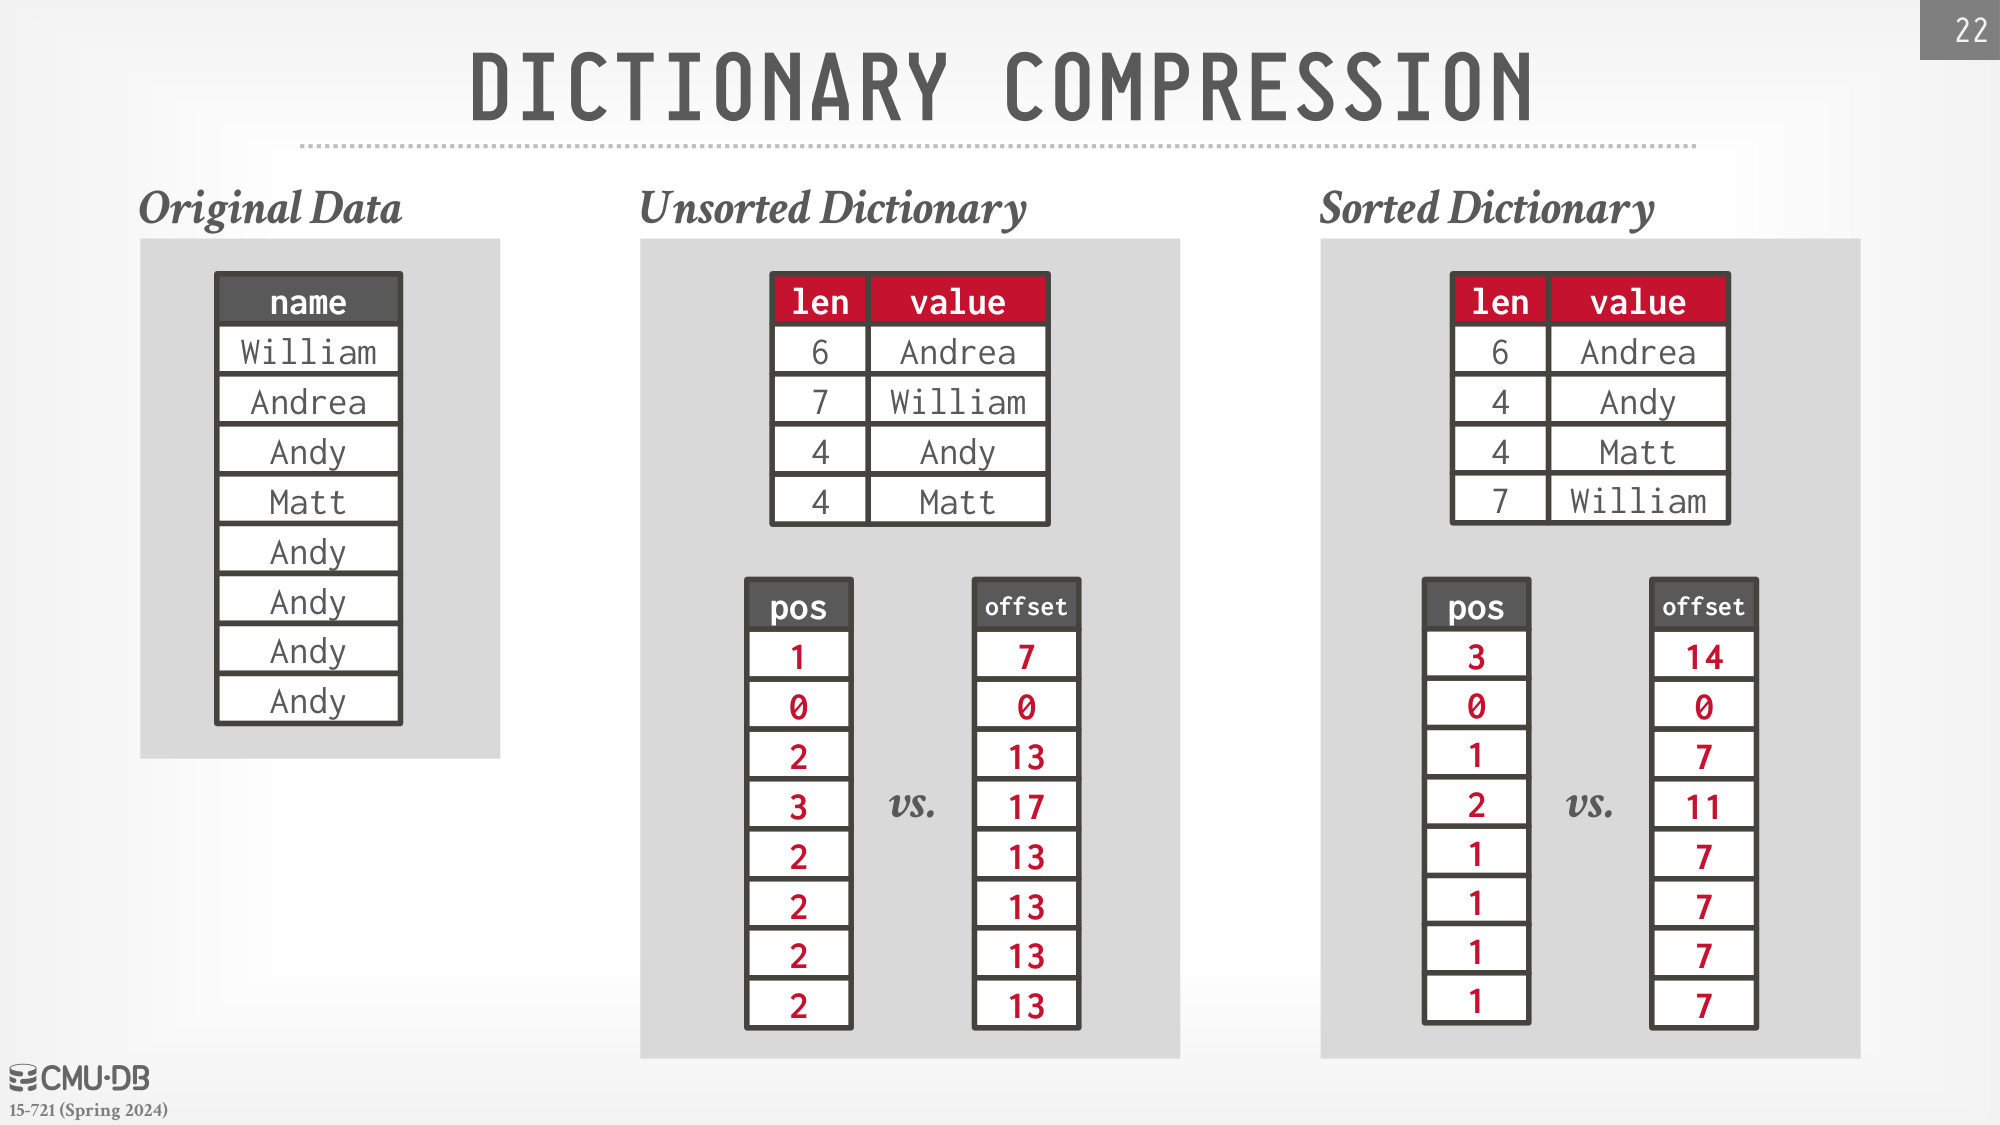
字典编码把重复值替换成编号,并维护编号到原始值的映射。字典可以按值排序,也可以使用位置或字节偏移作为编码。列中的不同值太多时,字典本身可能变得昂贵,因此格式需要规定何时停用字典或回退到其他编码。
RLE 合并连续重复值,Bitpacking 按实际位宽打包整数,Delta 保存相邻值的差,Frame-of-Reference 则以一个基准值表示偏移。这些方法可以叠加使用,例如先生成字典编号,再压缩编号序列。
块压缩使用 LZ4、Snappy、Zstd 等通用算法处理整块字节。它不理解列值的语义,读取某个值之前可能必须先解开整块。因此评价压缩时,不只看文件缩小了多少,还要看解码计算量和访问粒度。
过滤结构与嵌套数据
Zone Map 保存文件或行组中一列的最小值与最大值。如果查询区间与这个范围不相交,就可以跳过整个范围。Bloom Filter 则辅助判断某个值是否可能出现;它不能用来证明“这个值一定存在”。
嵌套对象还需要保留结构。Record Shredding 把叶子路径拆成列,并记录 Definition Level 与 Repetition Level;Length+Presence 通过附加列记录各层元素个数和字段是否存在。仅保存叶子值,会丢失空集合、缺失字段以及父子元素的对应关系。
压缩率相近,读取速度也可能不同
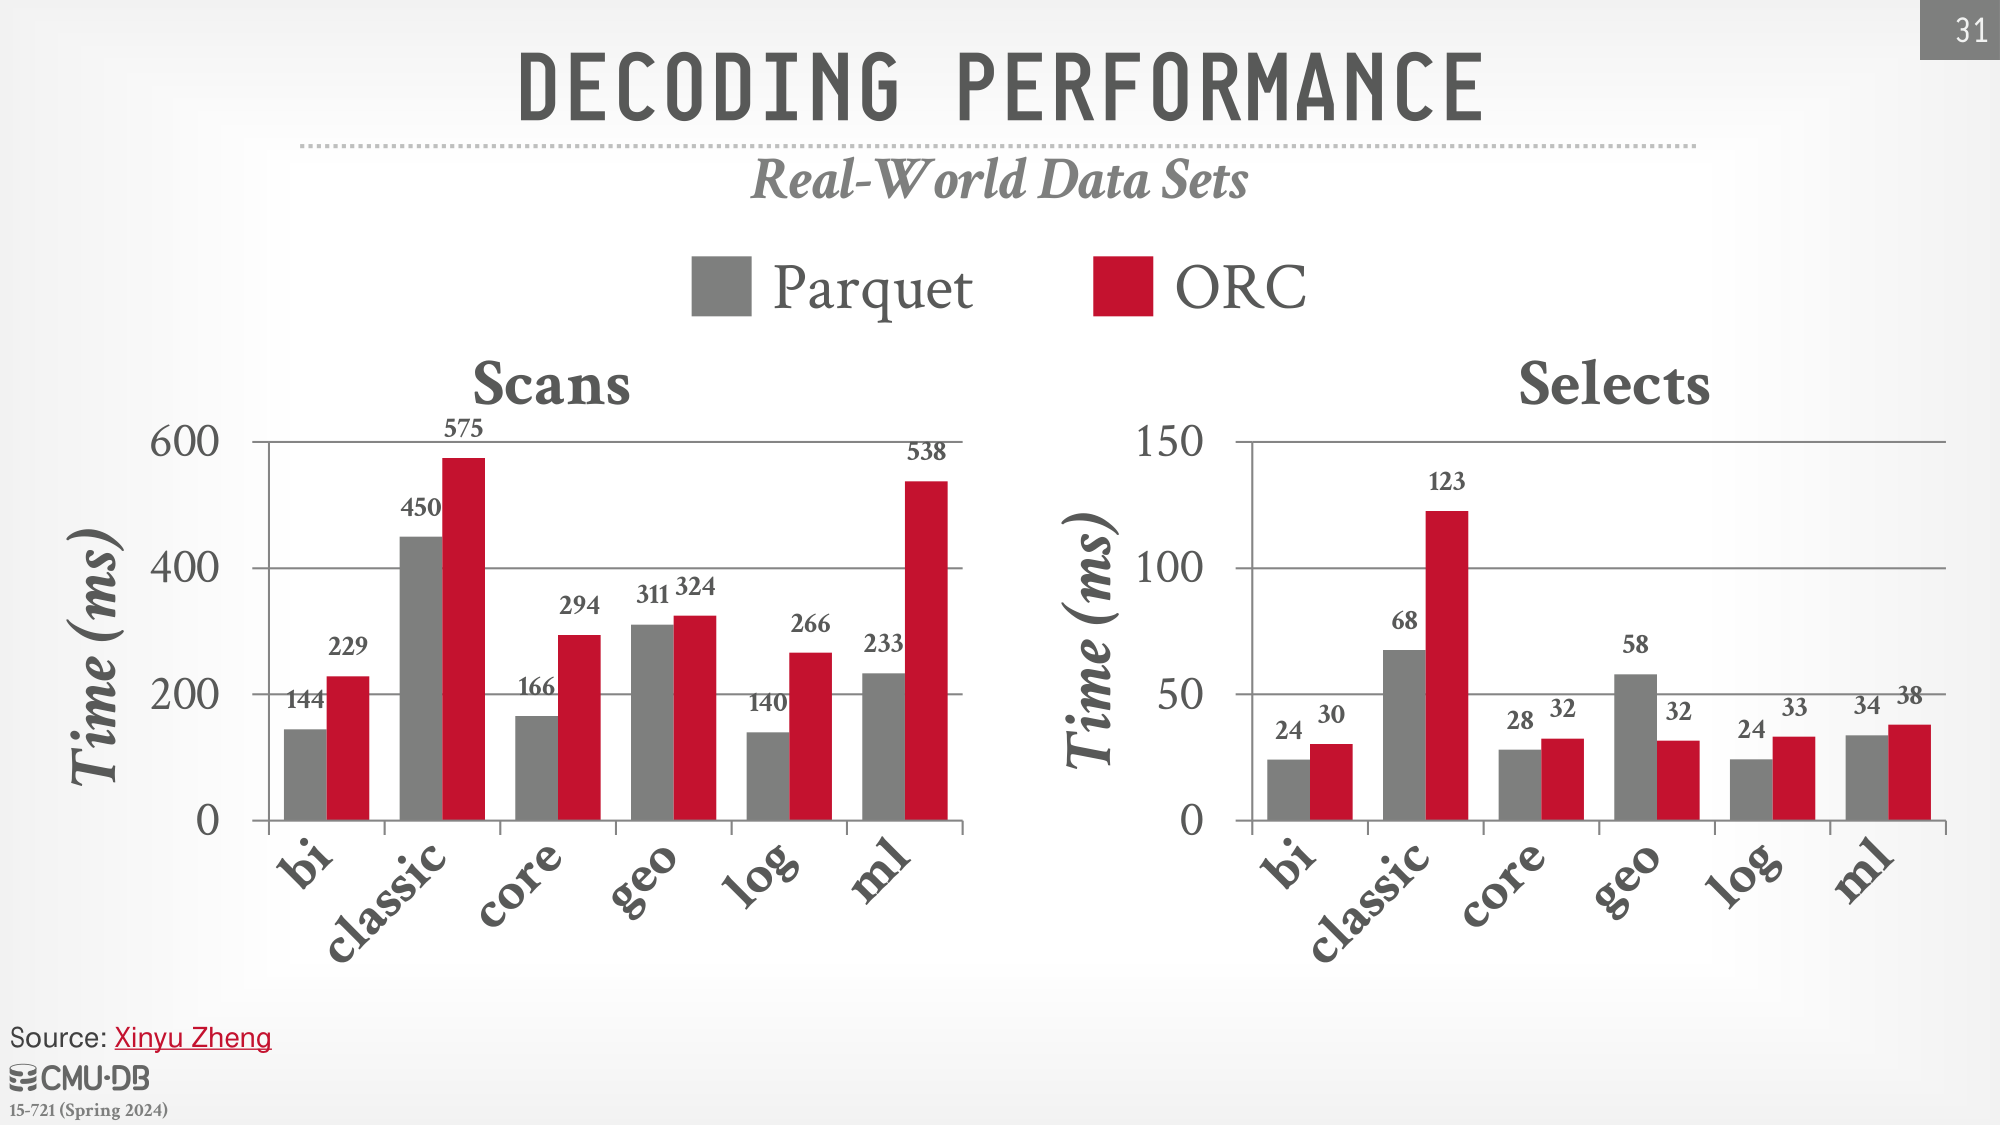
课件比较了不同真实数据集上的文件大小、扫描与选择耗时,两个格式的优势会随数据集和操作变化。实验还受到访问库实现完整度与优化程度影响,因此不能把图中的某一次比较推成永久的格式排名。
课程从这些结果引出后续方向:字典不只适用于字符串;现代 CPU 上,较简单的编码有机会降低分支和解码开销;是否使用通用块压缩,需要结合当前瓶颈判断。下一讲继续研究怎样把压缩布局与实际执行方式一起设计。