课程视频
从 Spark 到 Photon
Spark 通过 RDD 支持分布式数据处理和迭代计算,Shark 尝试把 Hive SQL 转换成 Spark 程序,之后 Spark SQL 将 SQL 与 DataFrame 等接口连接起来,并通过 Catalyst 优化关系计算。
JVM 提供成熟的运行环境,但对象表示、垃圾回收、运行时编译与硬件指令控制也带来取舍。Photon 选择在已有 Spark/Databricks 运行时中加入 C++ 向量化执行引擎,复用上层调度和查询基础设施。
预编译 Primitive 与表达式融合
Photon 为不同类型和操作提前编译执行 Primitive,运行时根据输入批次选择实现。它采用向量化处理,减少逐行解释和函数调用开销,并对合适循环使用 SIMD。
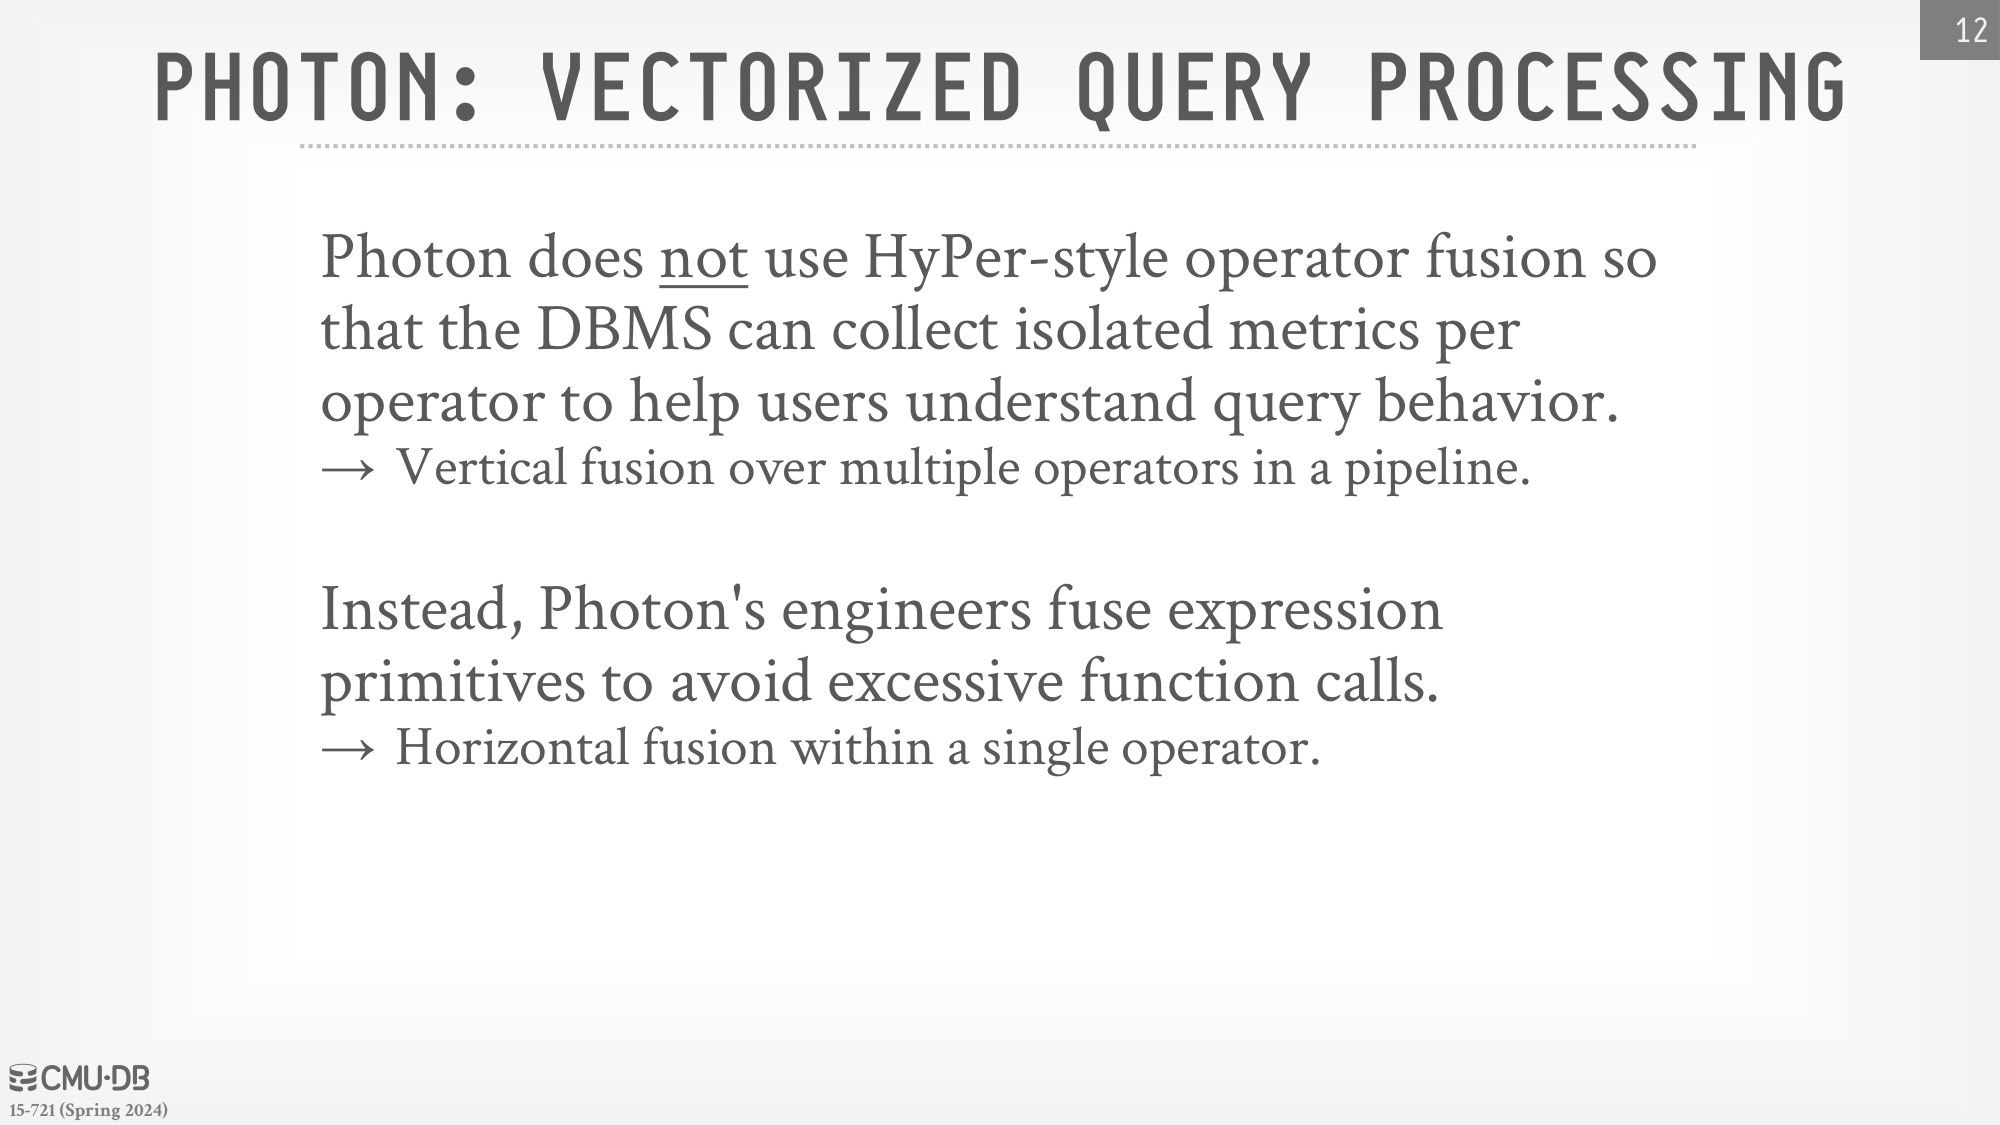
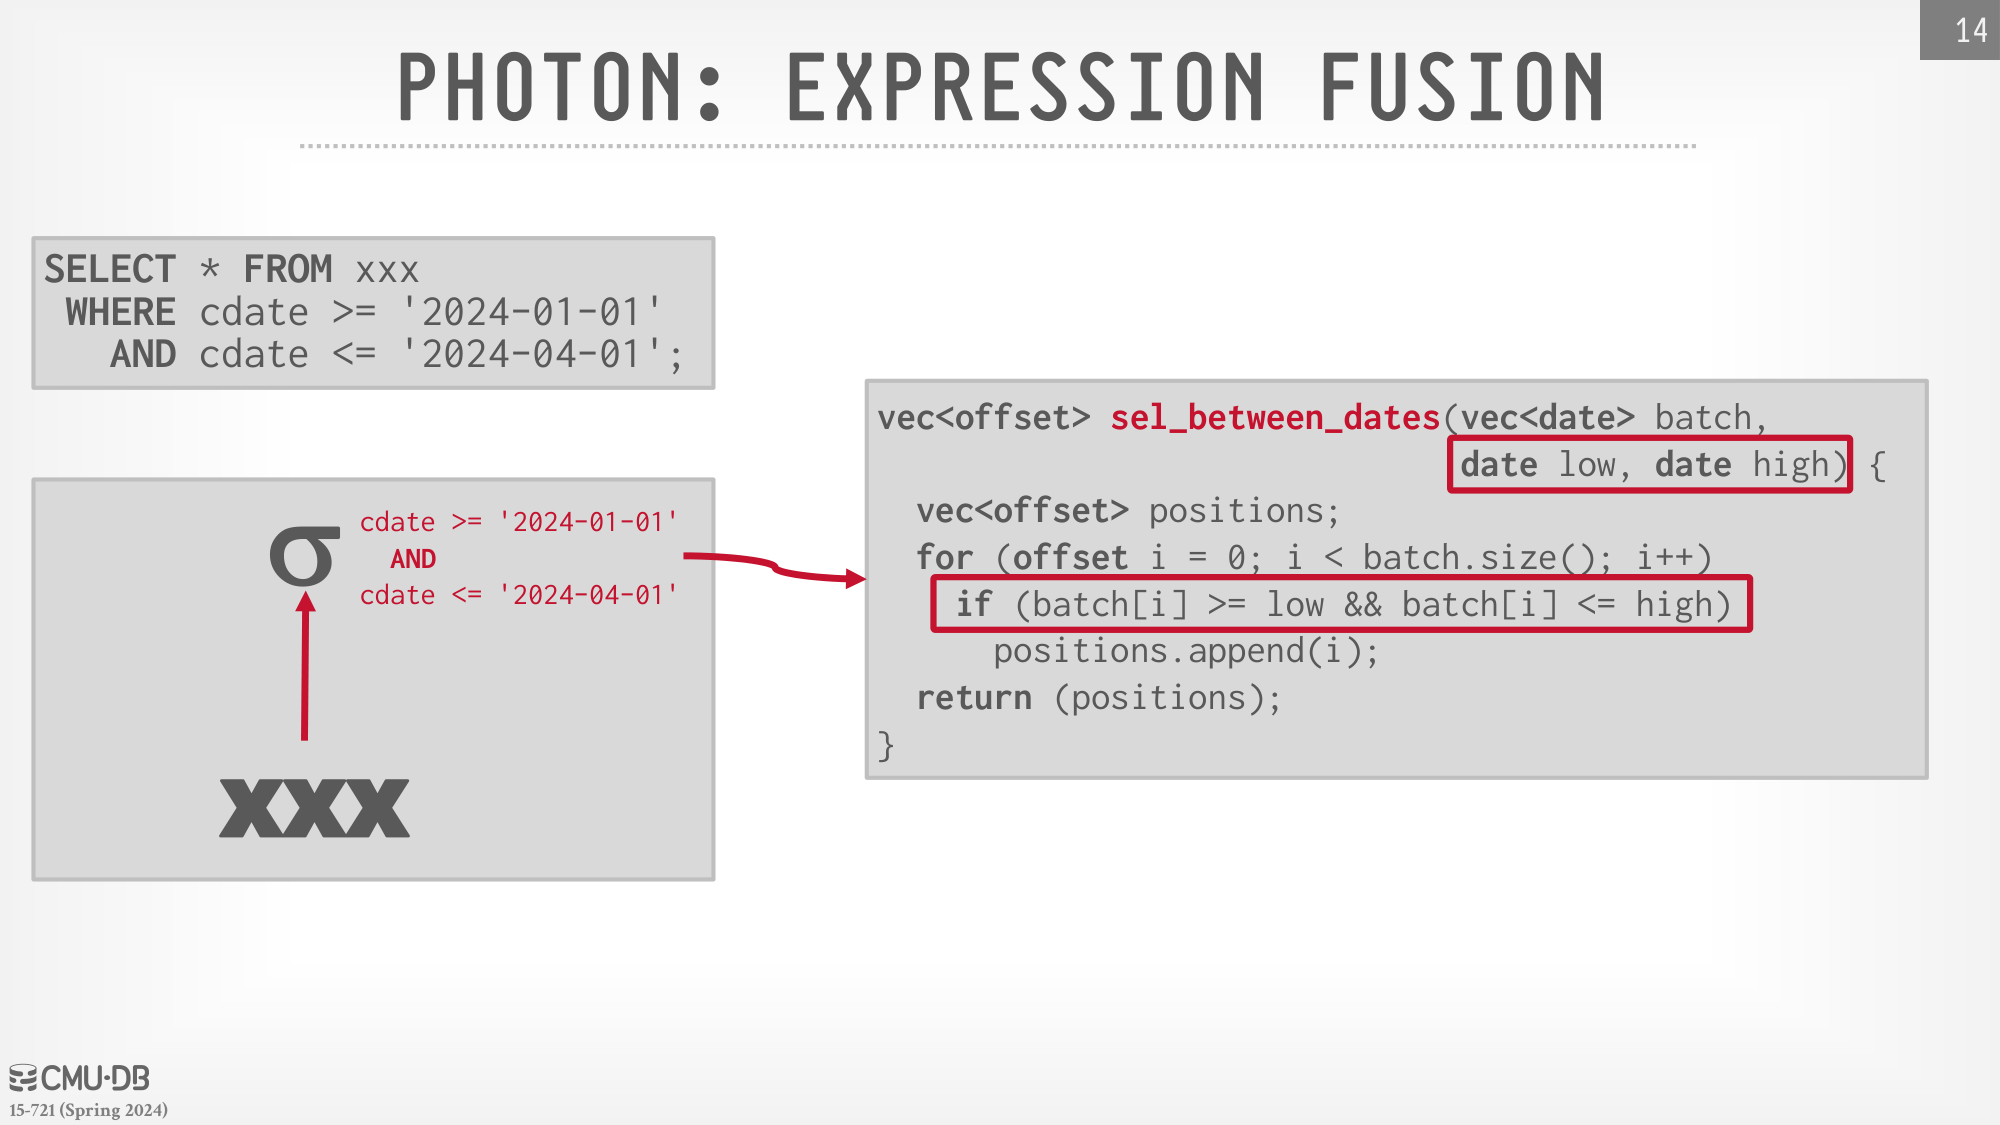
如果多个 Primitive 在同一运算符中连续使用,可以进一步融合表达式,减少中间向量的写入与读取。课程将这种运算符内部的横向融合,与 HyPer 跨运算符的流水线融合区分开。
怎样与原有 JVM 执行器协作
并非每个表达式与运算符都能交给新引擎。物理计划转换需要判断可支持的子树,插入相应执行节点,并控制 JVM 与原生执行路径之间的切换次数。细碎切换可能增加格式转换和交接成本。
内存管理也要统一考虑。运算符向管理器申请内存,管理器结合当前分配决定哪些状态需要释放或溢写,避免各算子在局部耗尽时独立作出互相冲突的决定。
宏观与微观两种自适应
查询级自适应利用 Shuffle 阶段完成后的统计,调整后续连接方式、分区组织与倾斜处理。它改变的是计划或任务结构,与上一讲 Dremel 的阶段间反馈相呼应。
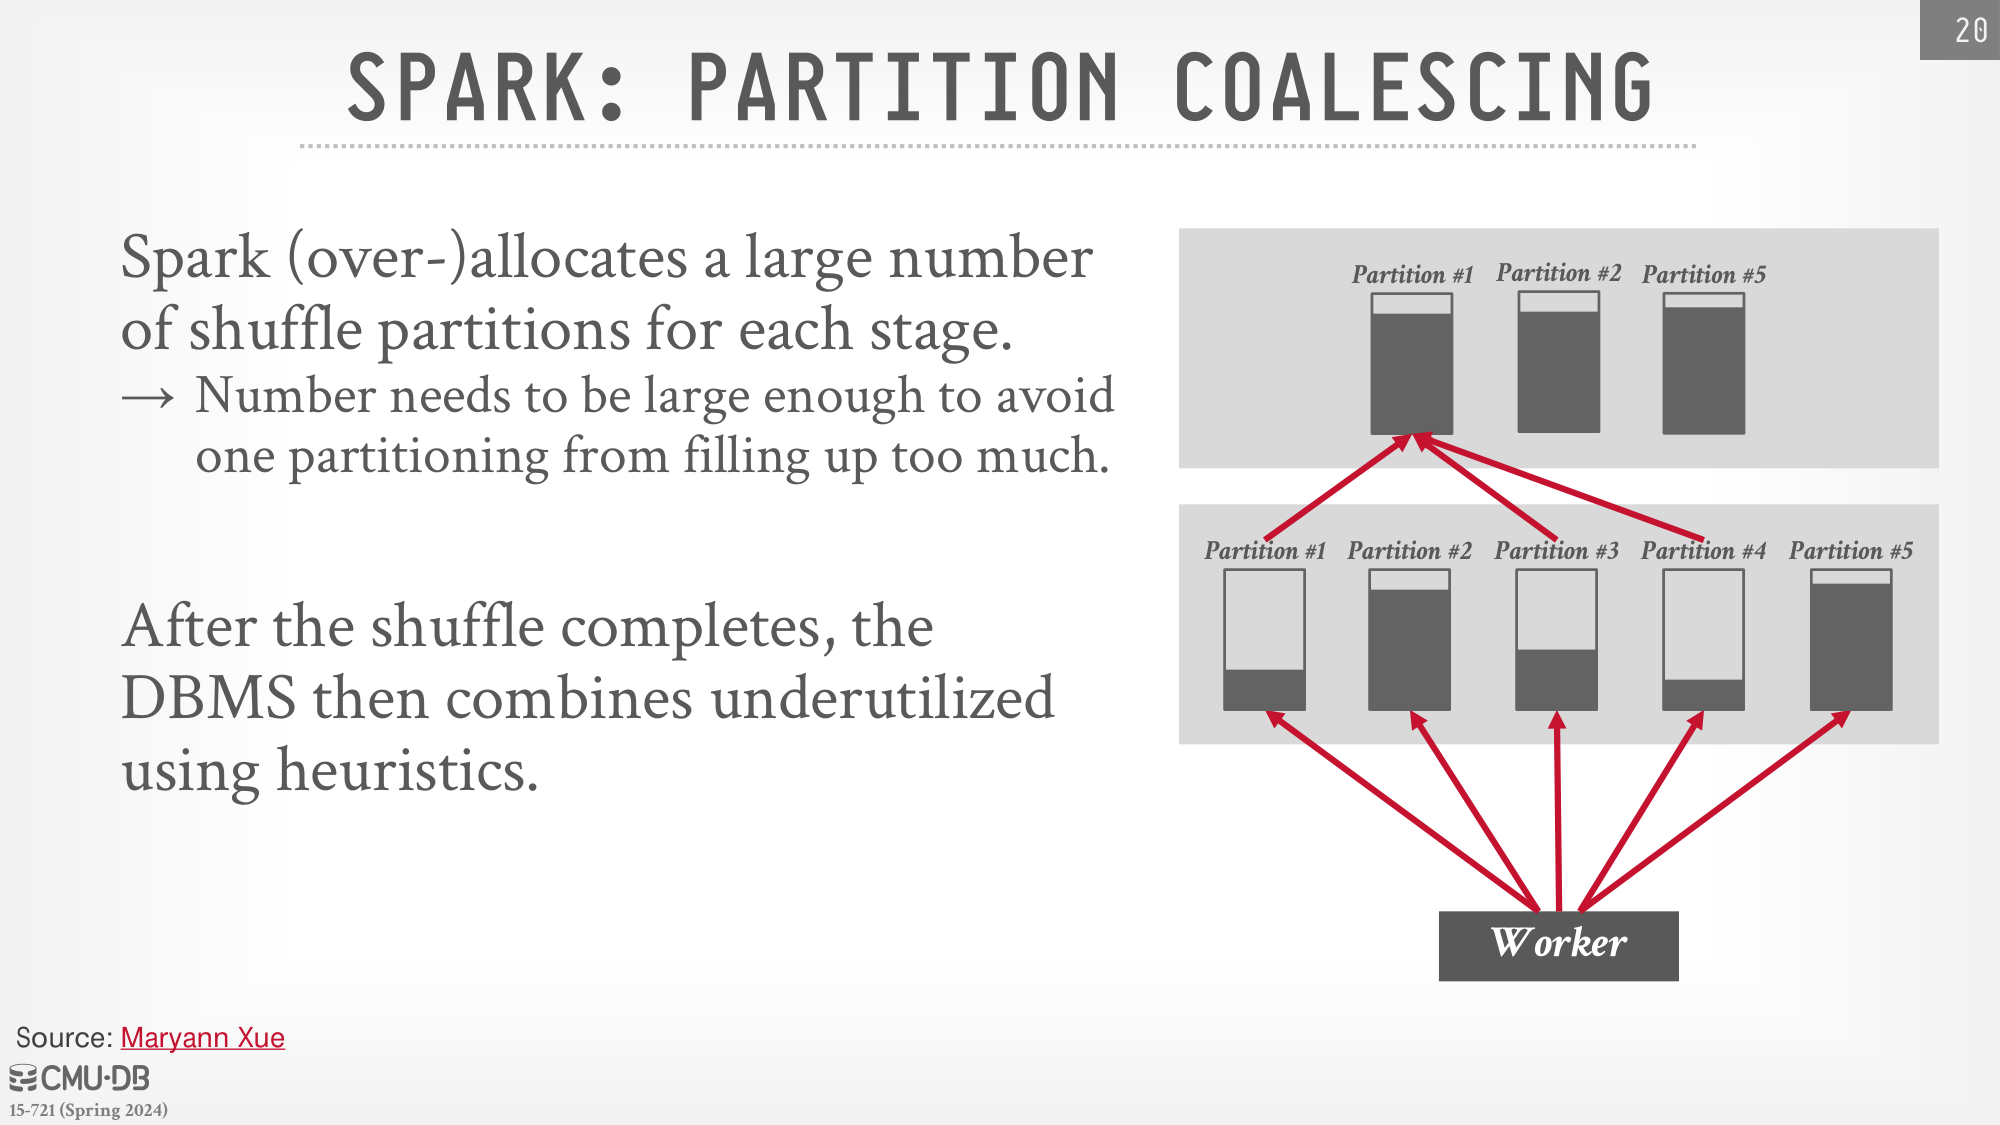
课件讨论的 Partition Coalescing 先保留较多 Shuffle 分区,再把过小分区合并,降低不必要的任务开销。分区太大带来不均衡,分区太小则增加调度与启动成本,因此要依据实际规模继续调整。
批次级自适应由 Photon 在算子内部进行:确认数据全部为 ASCII 时选择对应字符串实现;没有空值时省去空值分支;所有行都有效时省去间接位置访问;探测哈希表前压紧稀疏向量,提高 Lane 利用率。
两类自适应依赖的信息和触发位置不同。局部数据特征有助于选择更快的内核,但不能代替查询级连接顺序和数据交换方式的判断。
数据湖的事务与统计层
课程最后回到数据来源。Delta Lake 在对象存储上管理表版本、事务日志与数据文件;Kudu 为分析与增量更新提供存储层;Hudi 管理摄取、版本与后台维护;Iceberg 通过表元数据跟踪快照和数据文件。
这些系统的职责各有不同,并非简单更换一种压缩格式。共同问题是如何知道哪些文件属于当前表版本,哪些数据可以跳过,以及数据变化后怎样维护统计。
因此,Photon 的执行效率需要与上层计划、阶段反馈和底层文件管理一起理解。只把它描述成“把 Java 换成 C++”,会遗漏 Primitive 设计、表示转换和运行时适配这些影响性能的部分。