课程视频
查询之间与查询内部的并行
上一讲讨论了一条执行流水线怎样处理记录,这一讲把多个任务放到一起。Inter-Query Parallelism 同时运行多个查询,主要改善整体吞吐;Intra-Query Parallelism 把同一个查询拆给多个执行任务,主要缩短该查询的响应时间。
查询内又可以分成水平与垂直两个方向。Intra-Operator Parallelism 让同一运算符的多个实例处理不同的数据分区;Inter-Operator Parallelism 则让不同运算符或不同阶段重叠工作。实际系统可以同时使用这两种方式。
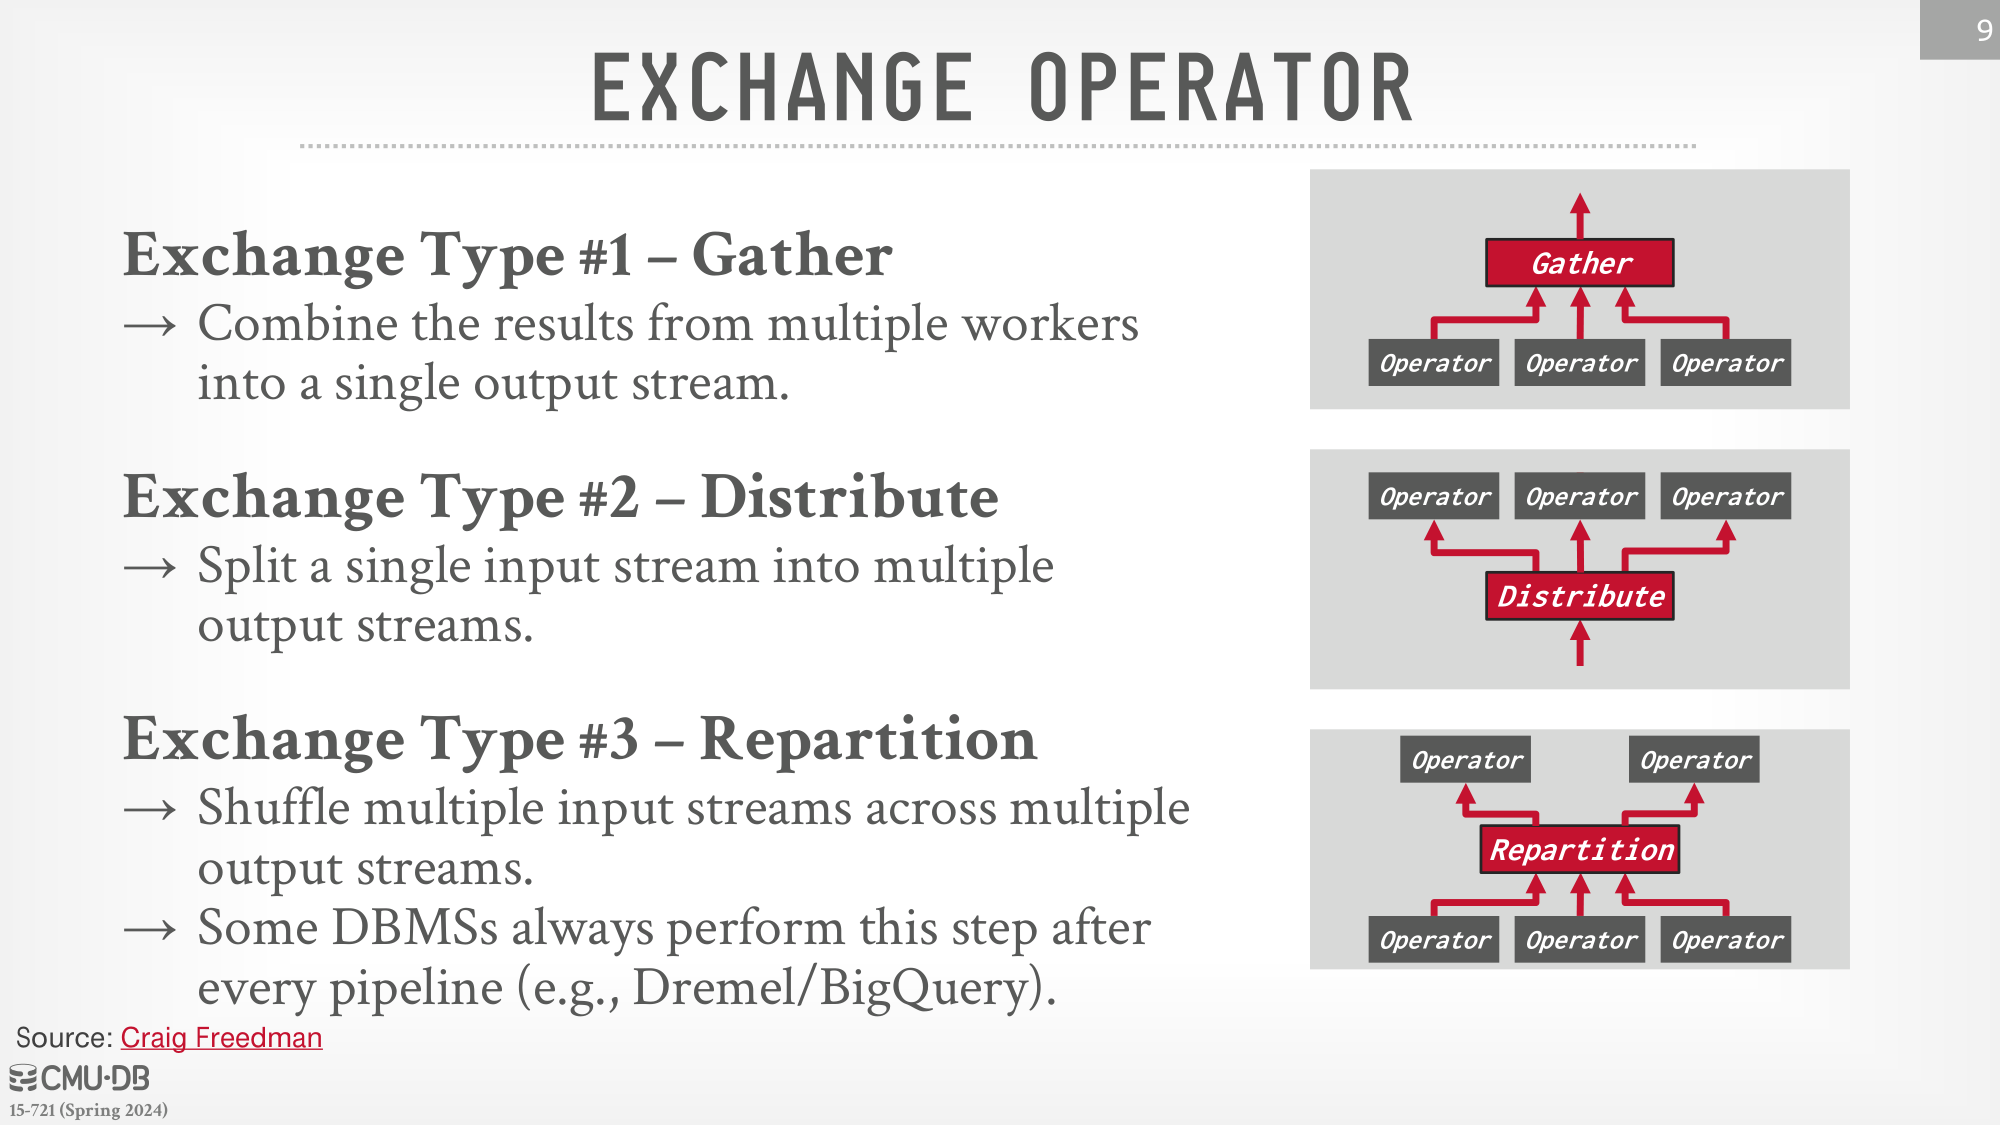
Exchange 把执行任务之间的数据交换显式放进计划。Gather 从多个输入汇聚到一个输出,Distribute 把一个输入分给多个输出,Repartition/Shuffle 则在多输入、多输出之间按照分区规则重新分发。连接的两边需要让相同键到达相容的分区,不能只把扫描任务平均分配就认为连接已经并行化。
Velox 在数据库中负责哪一层
Velox 是用于高性能单机查询执行的 C++ 库,提供运算符、表达式引擎、类型系统、函数接口、数据表示、资源管理和存储连接器。它接收物理计划,负责运行计划中的计算。
它并不直接提供完整数据库所需的 SQL 解析器、元数据目录和优化器,也不独占持久化文件格式。上层系统可以通过连接器读取 Parquet、ORC 等数据,把查询执行部分交给 Velox。组件化减少重复实现,但上层仍需要完成计划、类型和资源语义的对接。
连接结果立即复制,还是保留位置
早物化在连接找到匹配记录后,立即把两侧需要的属性复制成新的输出记录。延迟物化则先保存连接键与行位置等信息,等真正需要其他列时再取值。
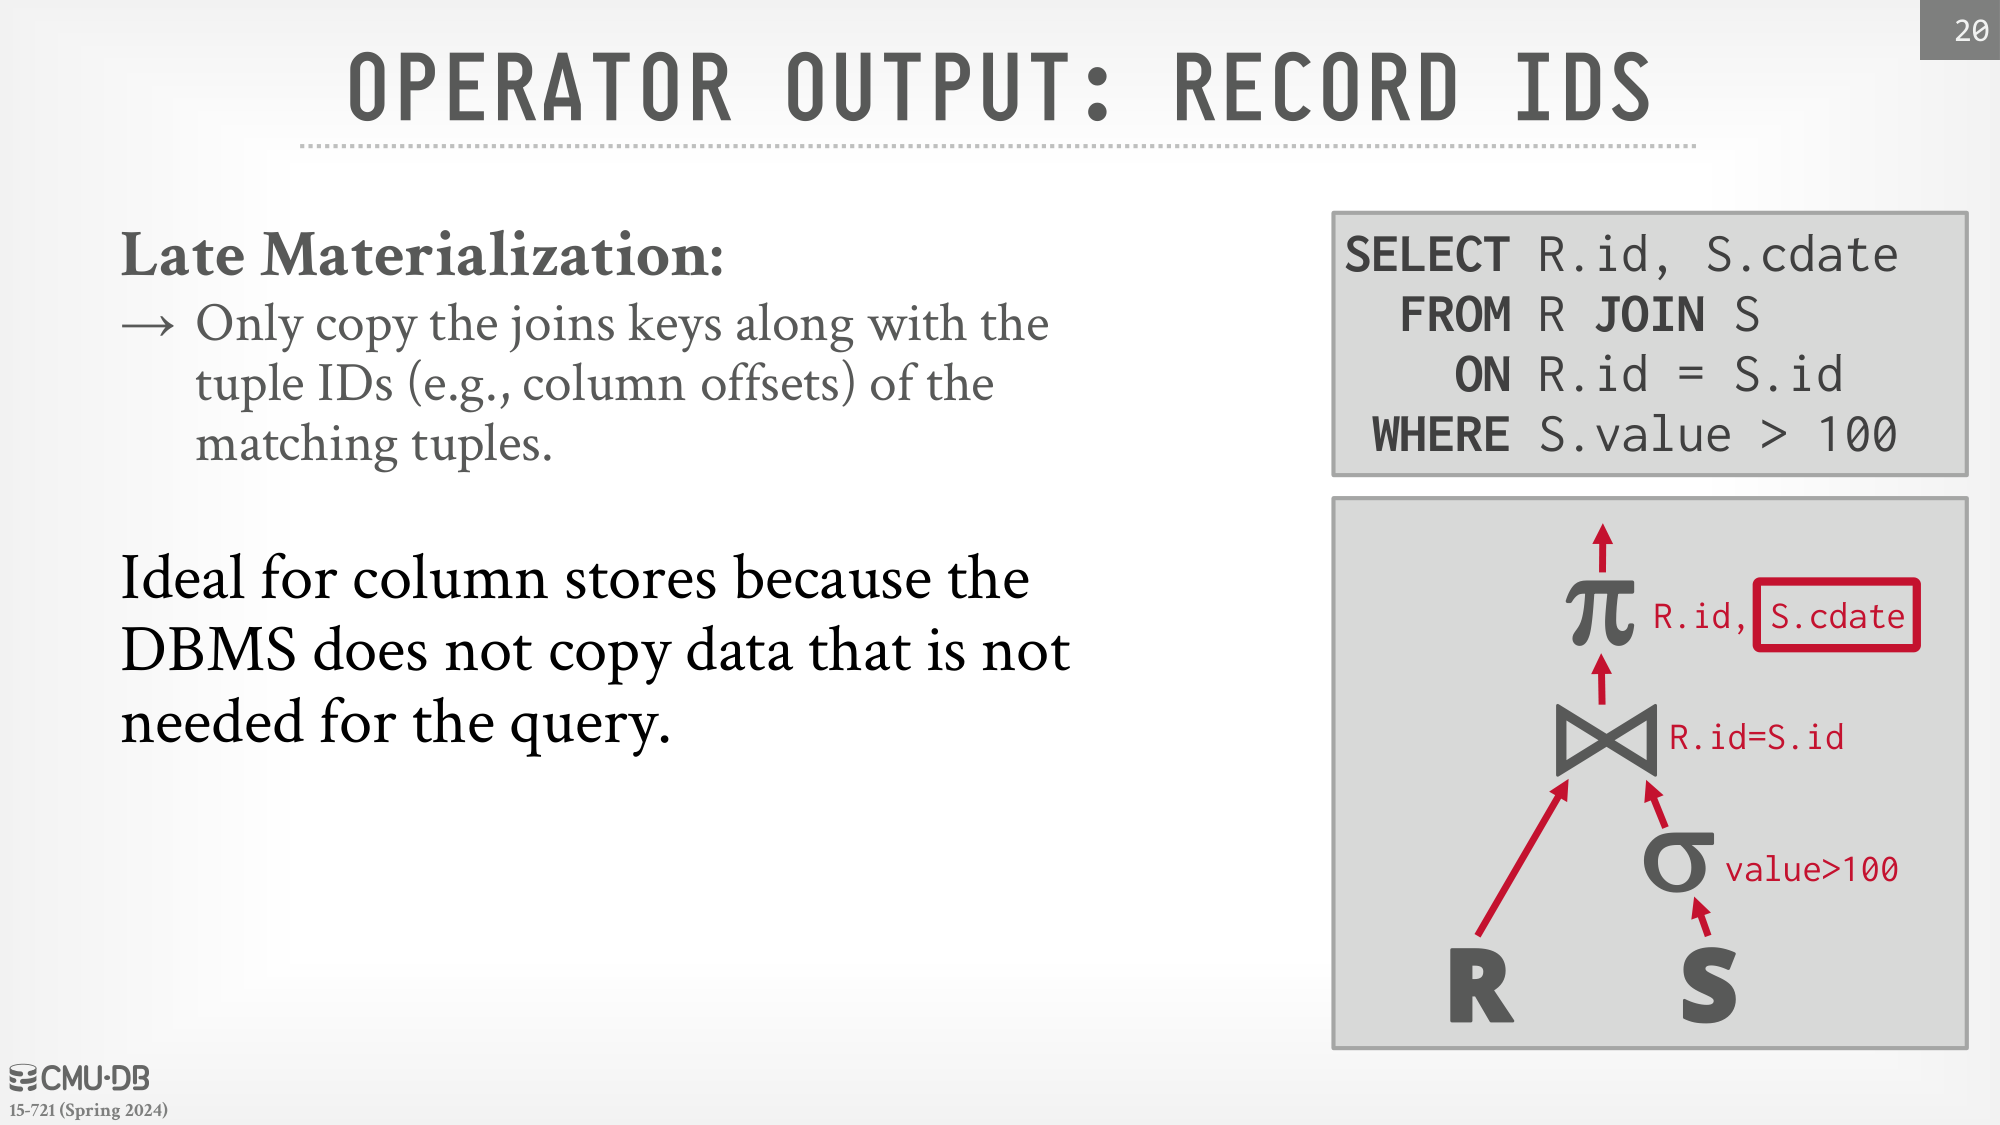
延迟物化减少了后续可能被丢弃的列值复制,尤其适合按列组织的数据。不过,执行器要维护位置与源数据的对应关系,还要考虑最终读取其他列时的访问局部性。早物化的好处是表示直接,后续运算符拿到的就是完整记录。
内存中的中间表示
持久化文件格式各不相同,执行器通常先转换成统一的内存表示,再交给运算符。理想情况下,同一进程的任务之间只需共享引用,就能交接批次,减少重复序列化与深拷贝;跨进程、跨机器时仍需考虑传输与所有权。
Apache Arrow 提供跨语言的内存列式格式,配合有效性位图、值缓冲区与变长数据偏移组织批次。它与 Parquet 的职责不同:前者侧重内存中的计算与交换,后者侧重持久化文件。
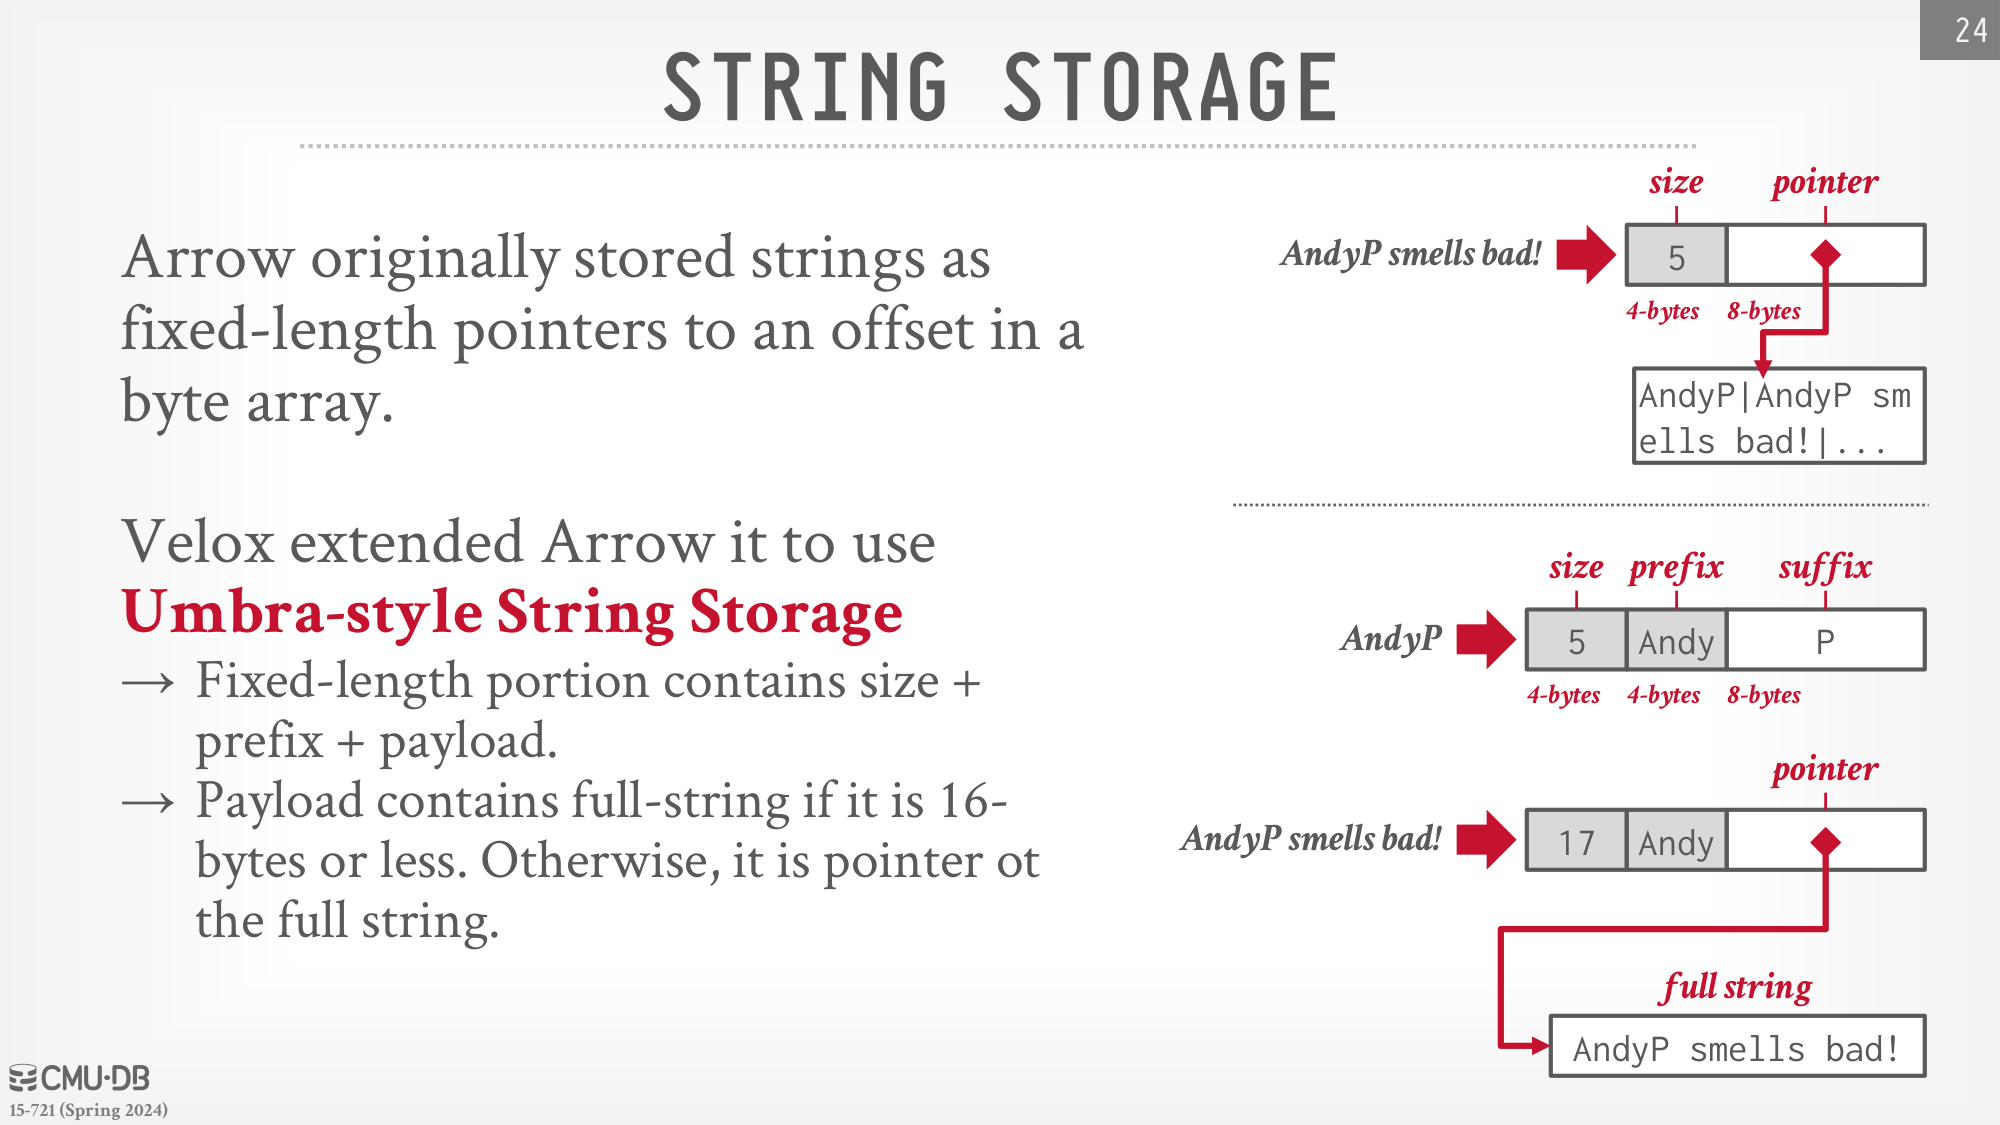
课件还介绍了 Velox 借鉴 Umbra 的字符串表示:在固定大小描述符中保存长度和前缀,较短字符串直接内联,长字符串再引用外部数据。很多比较可以先看长度或前缀,避免立即跟随指针访问完整字符串。
Substrait 则描述关系代数查询计划,解决的是计划交换;DataFusion 是基于 Arrow 的 Rust 查询执行库。数据交换格式、计划表示和执行库处在不同层次,组合它们时需要分别确定边界。
表达式计算与运行时调整
逐条遍历表达式树会产生类型判断、分支和函数分派。Velox 将表达式转换成更适合批量执行的表示,再进行常量折叠与公共子表达式消除。例如,UPPER('wutang') 不必对每一行重新计算。
执行时获得的信息还能继续减少工作:根据谓词的成本与过滤效果调整顺序;预取后续需要的列;确认批次没有空值后使用无空值快速路径;确认字符串是 ASCII 后使用相应实现;复用可用的缓冲区。
这些优化有各自的前提。运行时观察可以帮助选择实现路径,但不能随意改变表达式的语义、错误行为或函数副作用。执行器也无法单靠局部优化挽救所有不合理的连接顺序,后面的优化器仍然重要。