课程视频
把逻辑放进数据库有什么收益
应用程序如果先查询一部分数据、在客户端计算,再把结果用于下一次查询,会产生多次网络往返。把逻辑移入数据库,可以减少数据传输,也便于复用相同的业务计算。
课程讨论的形式包括 UDF、存储过程、触发器、自定义类型和自定义聚合。UDF 可以接收标量参数,返回标量或表;不同系统对语言、访问数据和副作用的支持不同。复用逻辑的便利,并不自动意味着执行效率更高。
UDF 为什么容易变慢
优化器常把 UDF 看成黑盒,无法看到里面的查询、计算量和过滤效果。逐行执行时,同一段函数逻辑被调用很多次,函数内部若继续查询表,就会形成优化器看不到的重复关联。
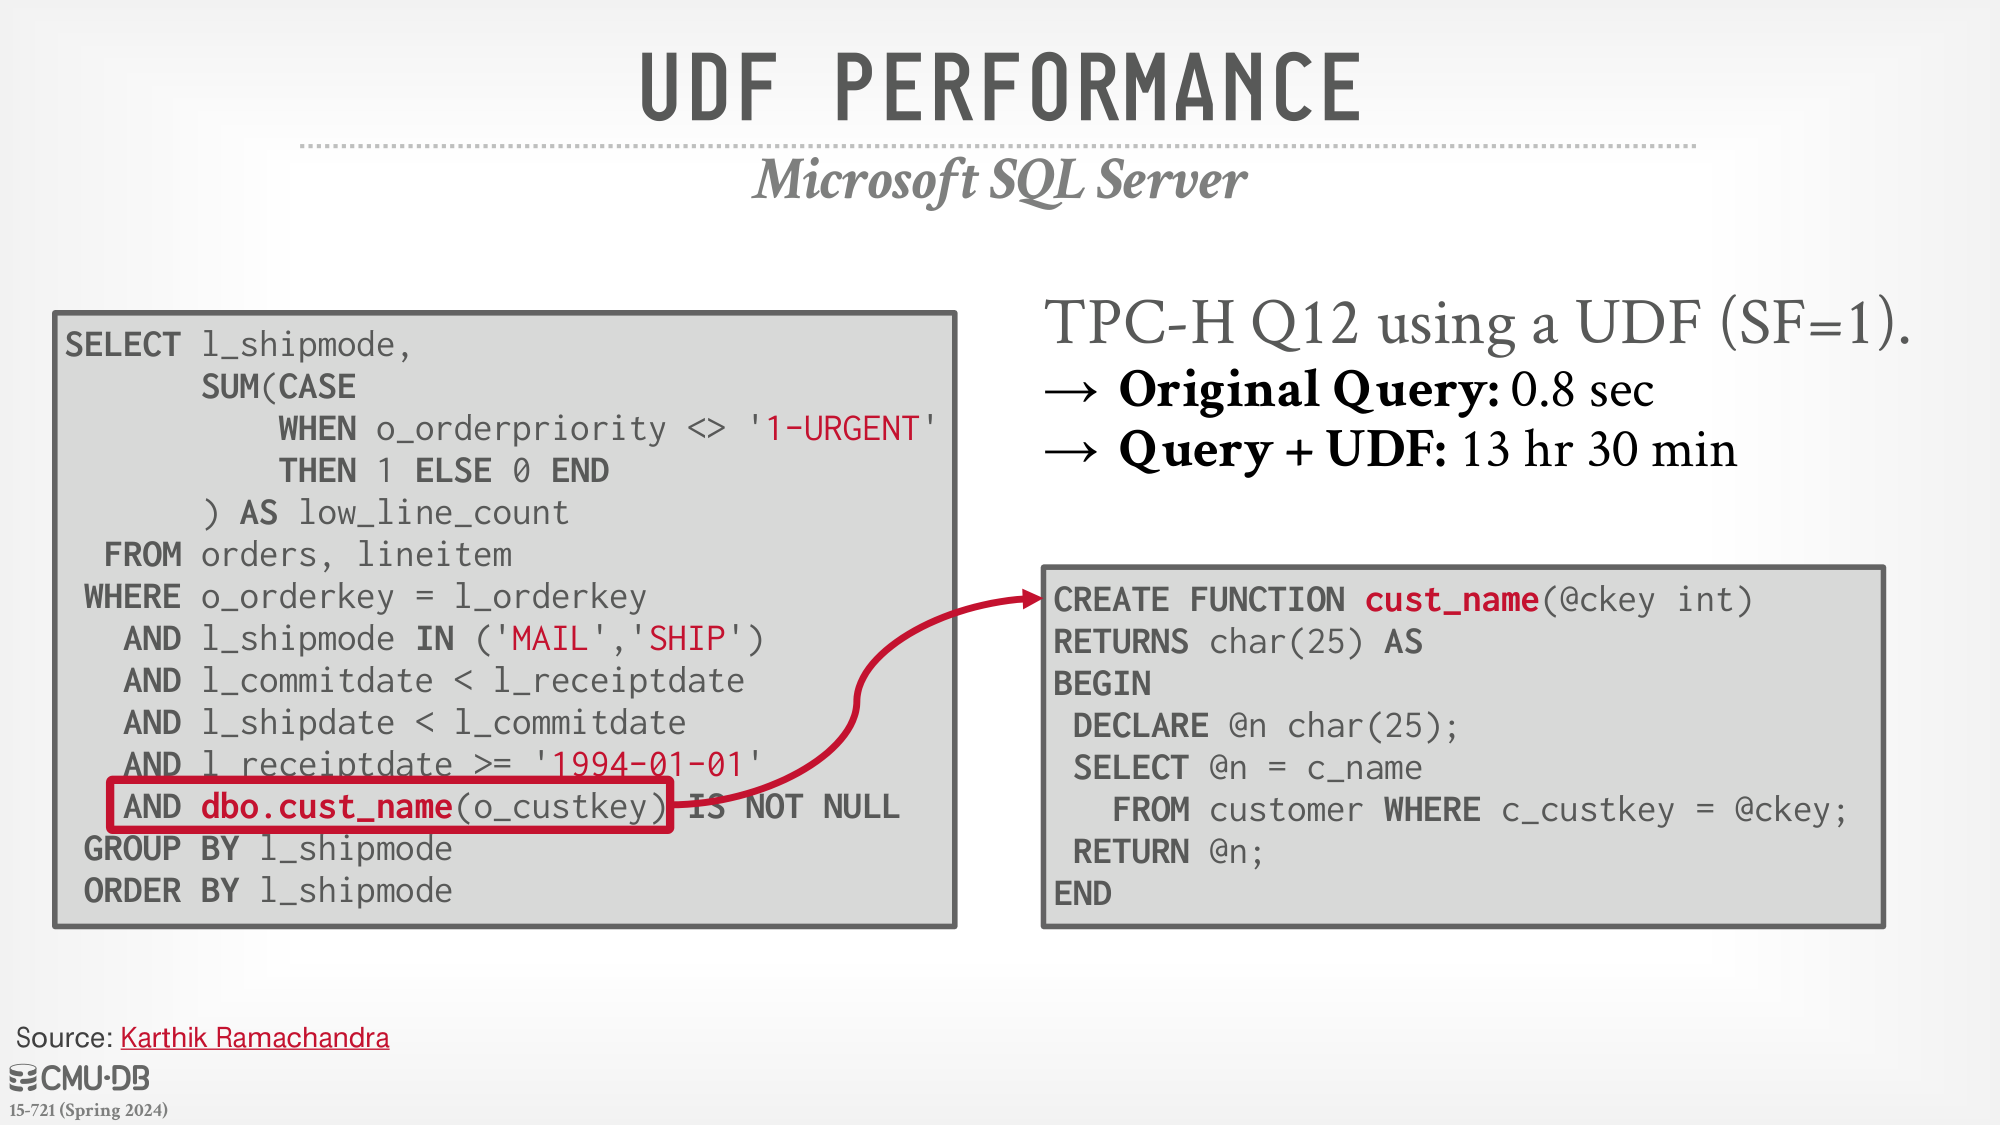
命令式语句按顺序解释,还可能阻碍跨语句优化和并行化。课程列出编译、并行化、内联与批处理几类加速方法:编译降低解释成本;内联和批处理则尝试改变优化器与执行器看到的计算形式。
Froid:把命令式函数转成关系表达式
Froid 在查询重写阶段将受支持的 UDF 转换为关系表达式,再把表达式内联到调用查询中。原有优化器因此有机会一起处理函数和外层查询,不必专门为每种命令式语句实现另一套代价搜索。
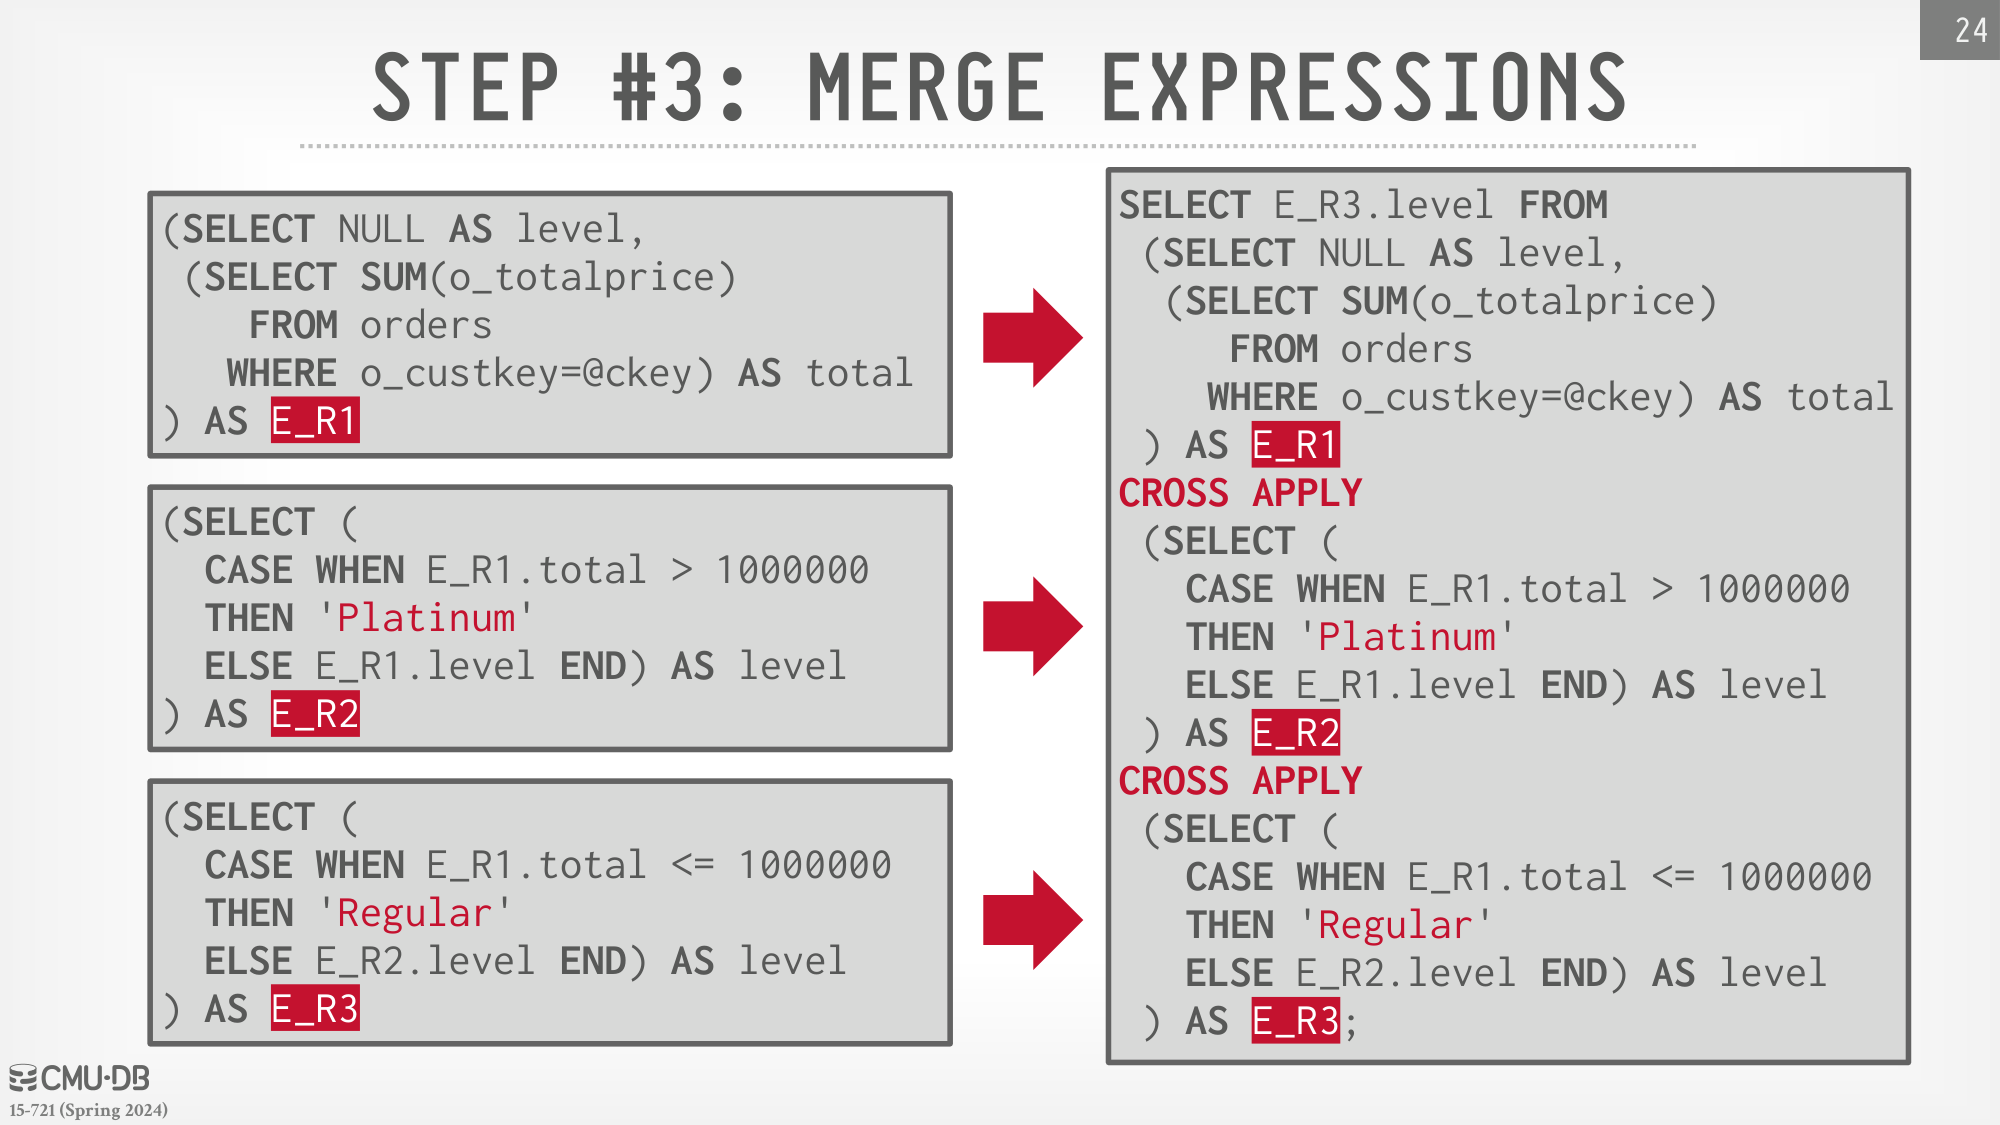
转换先为赋值、条件等语句建立关系表示,再按控制流划分 Region,最后使用 Apply/Lateral 等关联方式组合表达式。Lateral 允许内层表达式引用左侧输入的值,因而能够表达原函数对参数或已有变量的依赖。
组合后的表达式替换函数调用,再交给常量传播、死代码消除、子查询去关联等优化。某些原本需要逐条执行的步骤,可以被合并、下推或完全消除。
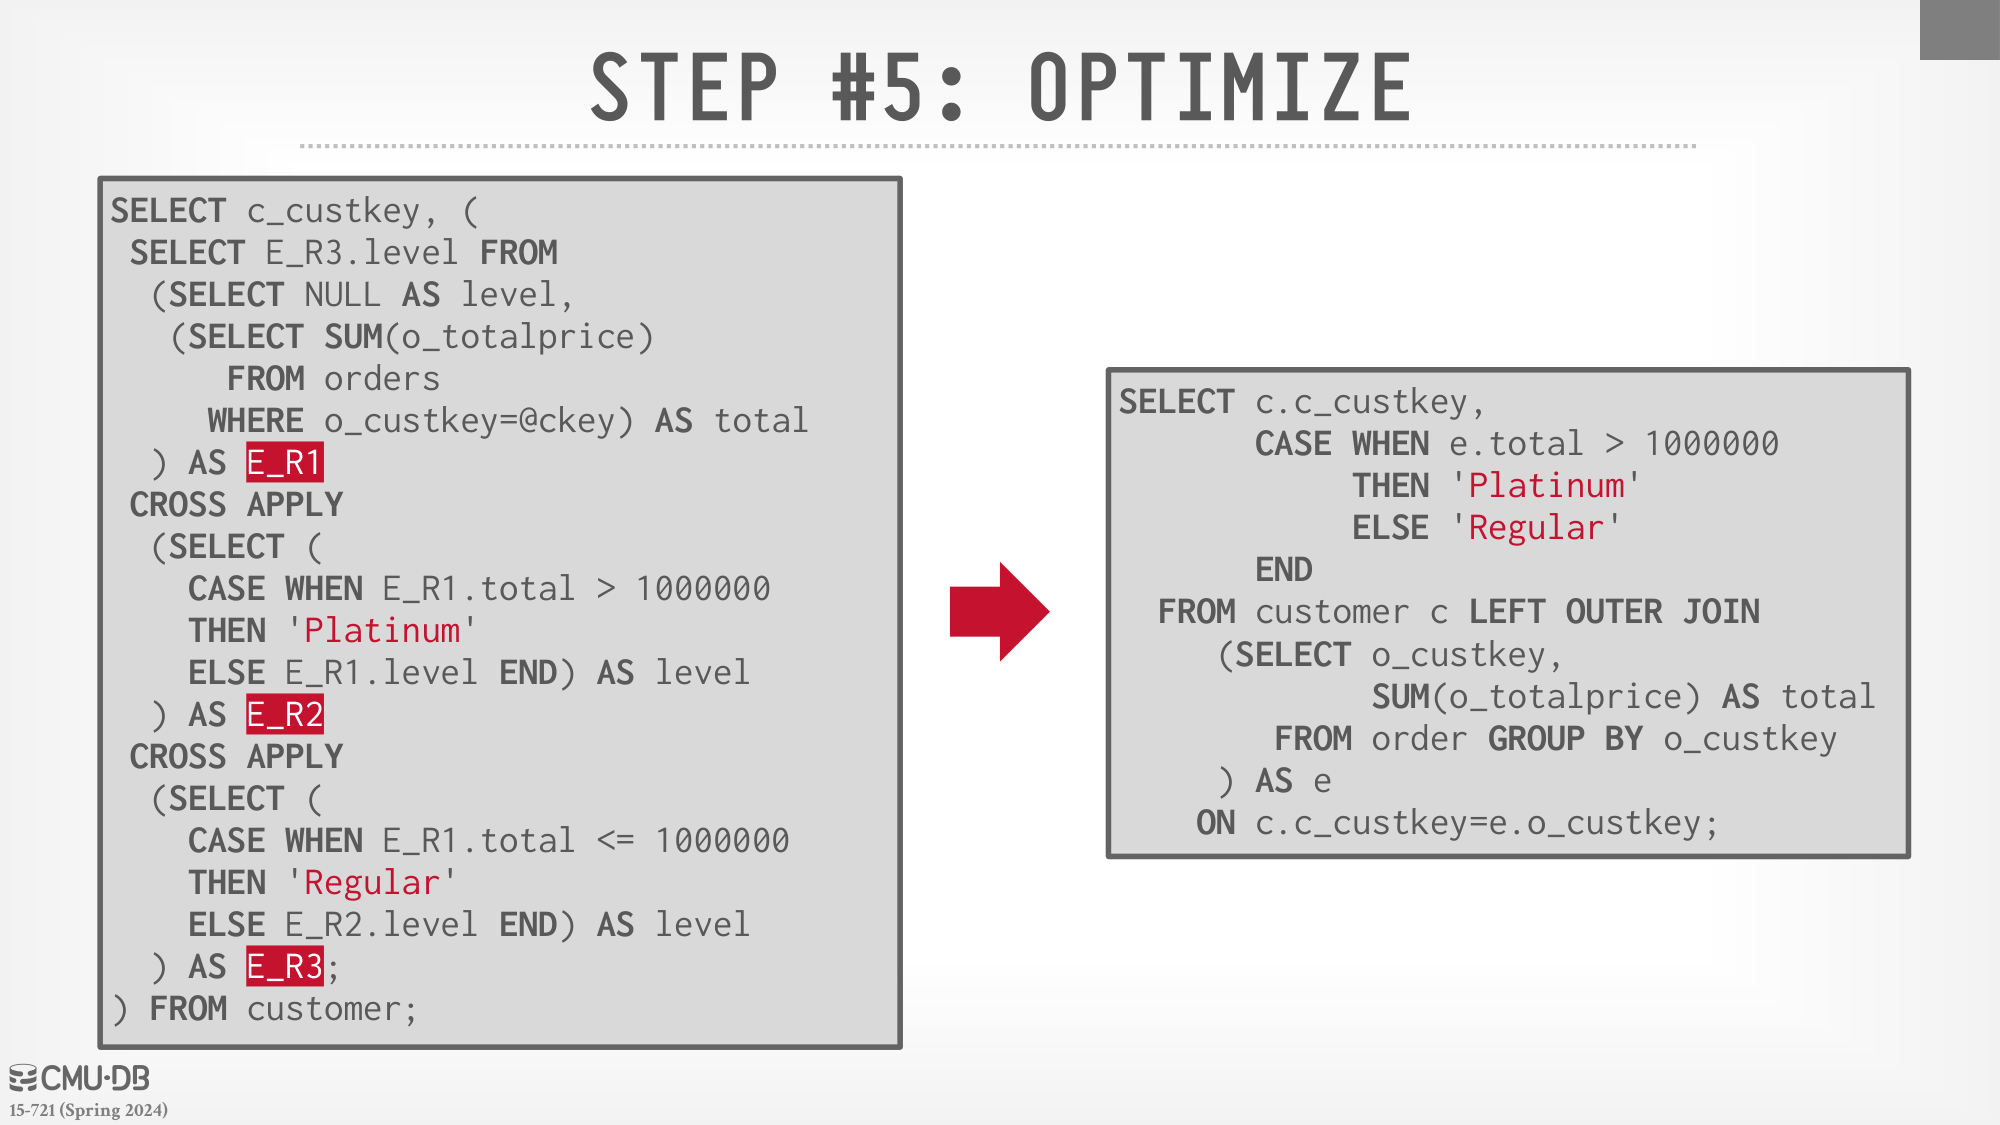
这些转换需要维护原始控制流和求值语义。2019 年论文与实现支持的语句范围有限,不能把该方法理解为任意语言的任意函数都能透明转换。
APFEL:用递归 CTE 表达循环
Froid 之外,APFEL 尝试把过程式程序转换成普通 SQL,并通过递归 CTE 表达循环。转换过程依次使用静态单赋值形式、Administrative Normal Form、递归形式整理,再映射到 WITH RECURSIVE。
这样可以把过程式逻辑交给支持递归 CTE 的数据库执行,而不要求数据库内部直接增加同样的过程语言优化器。生成 SQL 的大小、递归执行能力和后续去关联效果,都会影响最终性能。
Batching:让一批函数调用一起推进
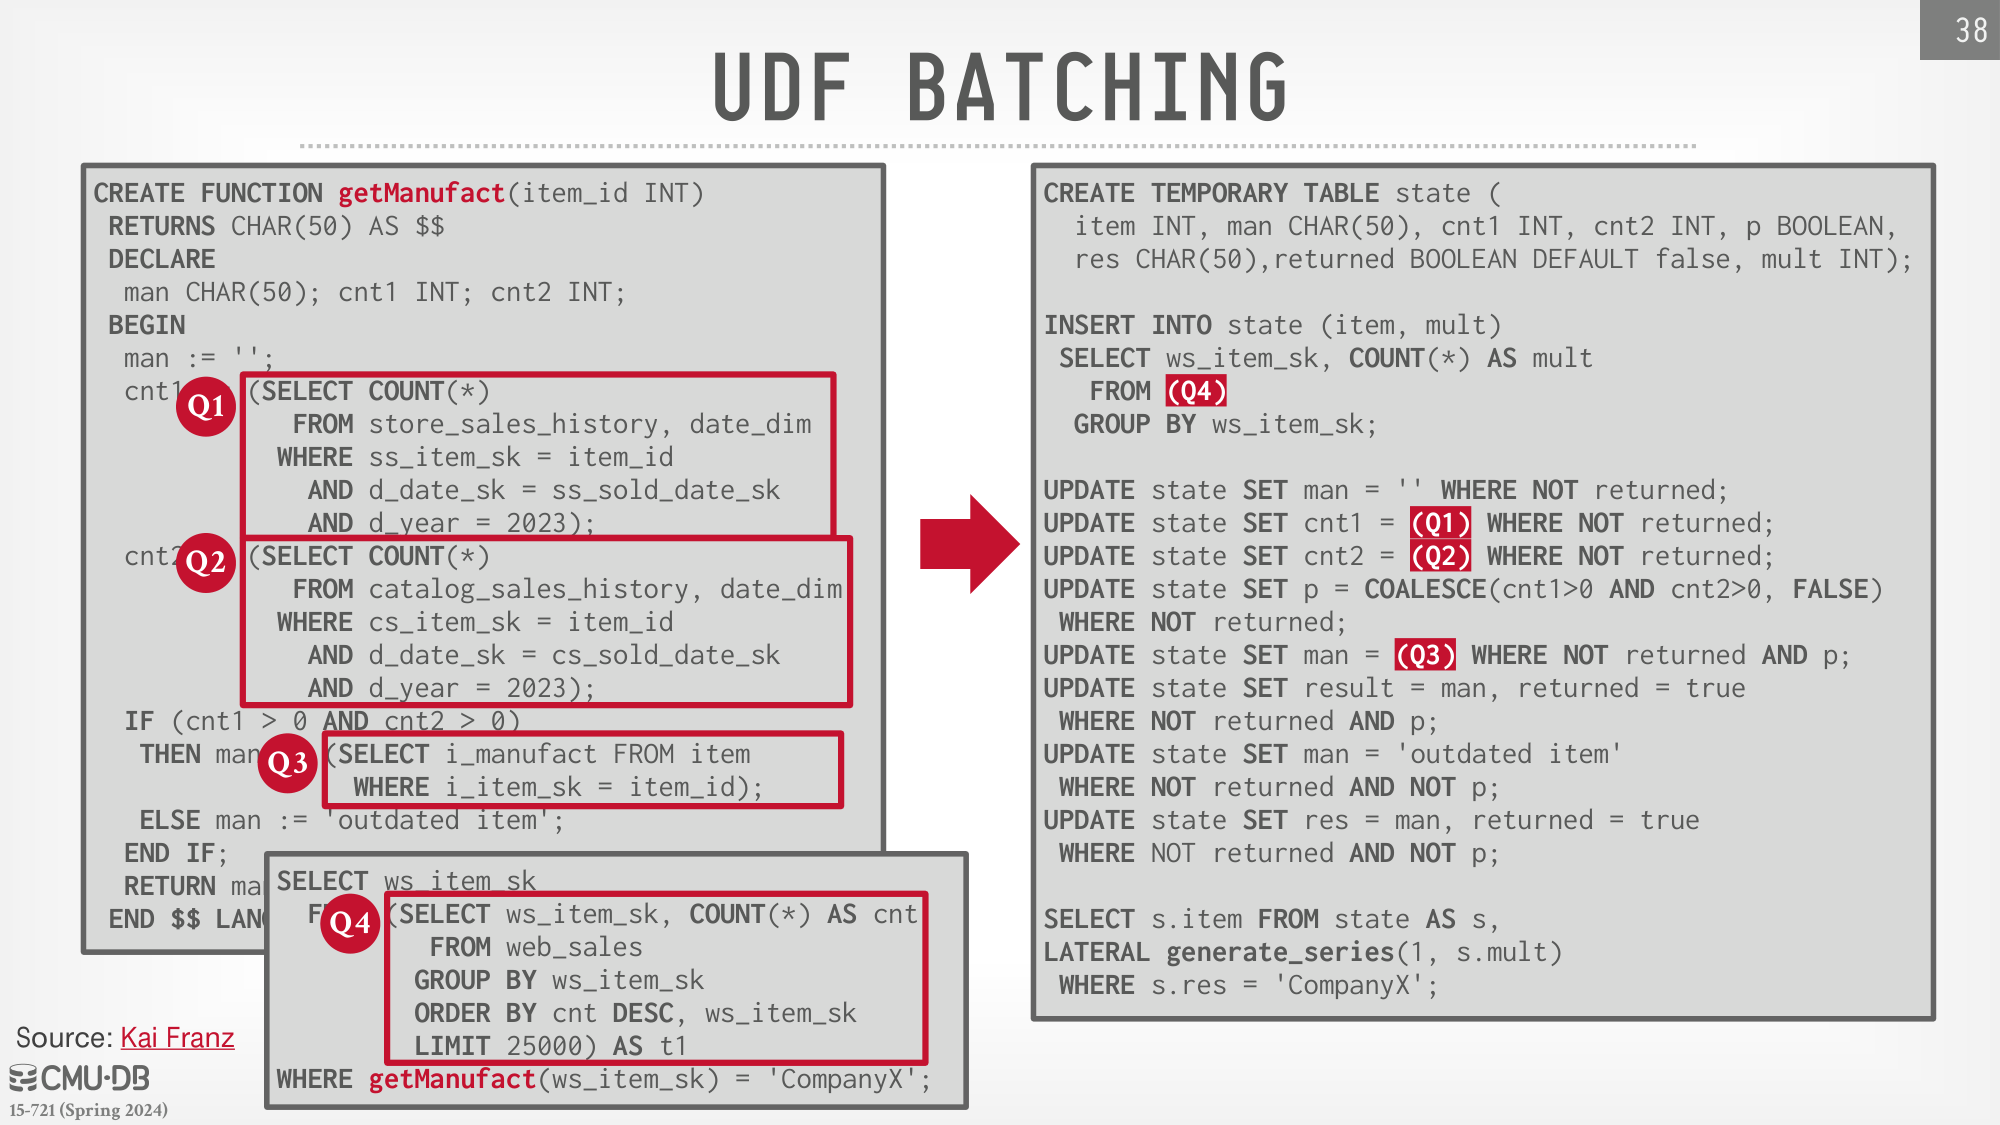
批处理把多次函数调用的变量状态组织成临时表,让一条关系操作同时推进多行状态。与对每个外层输入独立运行整段函数相比,它给连接、过滤与批量计算提供了更大的处理范围。
课件讨论的 ProcBench 研究比较了内联与批处理。内联可能生成庞大、复杂的关系表达式,后续优化器未必能有效去关联;批处理则可能减少重复工作,但也引入临时状态维护。
因此不能只问“函数是否被内联”。更应该查看改写后的计划:内部查询执行多少次,哪些相关条件仍然存在,中间结果有多大,以及批次状态的写入是否抵消了计算收益。课程最后比较不同去关联能力,也说明了同一改写在不同数据库上可能产生不同结果。