代价模型需要估计什么
代价模型根据当前数据库状态比较物理计划,包括中间结果大小、访问路径、算法实现、CPU/I/O/网络消耗、数据倾斜、顺序与位置,以及其他并发任务的影响。搜索策略决定检查哪些候选,代价模型决定怎样比较它们。
课程把模型信息分为三类:物理代价预测周期、I/O 和缓存行为;逻辑代价关注运算符处理与产生多少记录;算法代价描述具体实现的复杂度。这些信息可以结合,但精细硬件公式无法弥补严重错误的输入规模。
选择率信息从哪里来
选择率表示条件保留下来的数据比例。域约束和 Zone Map 可以提供范围信息,直方图以有限桶记录分布,Sketch 以较小空间维护近似统计,采样则直接在部分数据上执行条件。
采样可以维护定期刷新的副本,也可以访问当前表;前者存在陈旧问题,后者要考虑并发更新与采样的一致性。学习型估计尝试发现难以手工描述的相关关系,但也需要维护训练数据、更新和推断成本。
基数估计的简化假设
单输入过滤的输出基数可以由输入基数乘选择率得到。多条件与连接还需要判断不同值域和谓词之间的关系。常见简化包括均匀分布、谓词独立,以及连接键域具有一定包含关系。
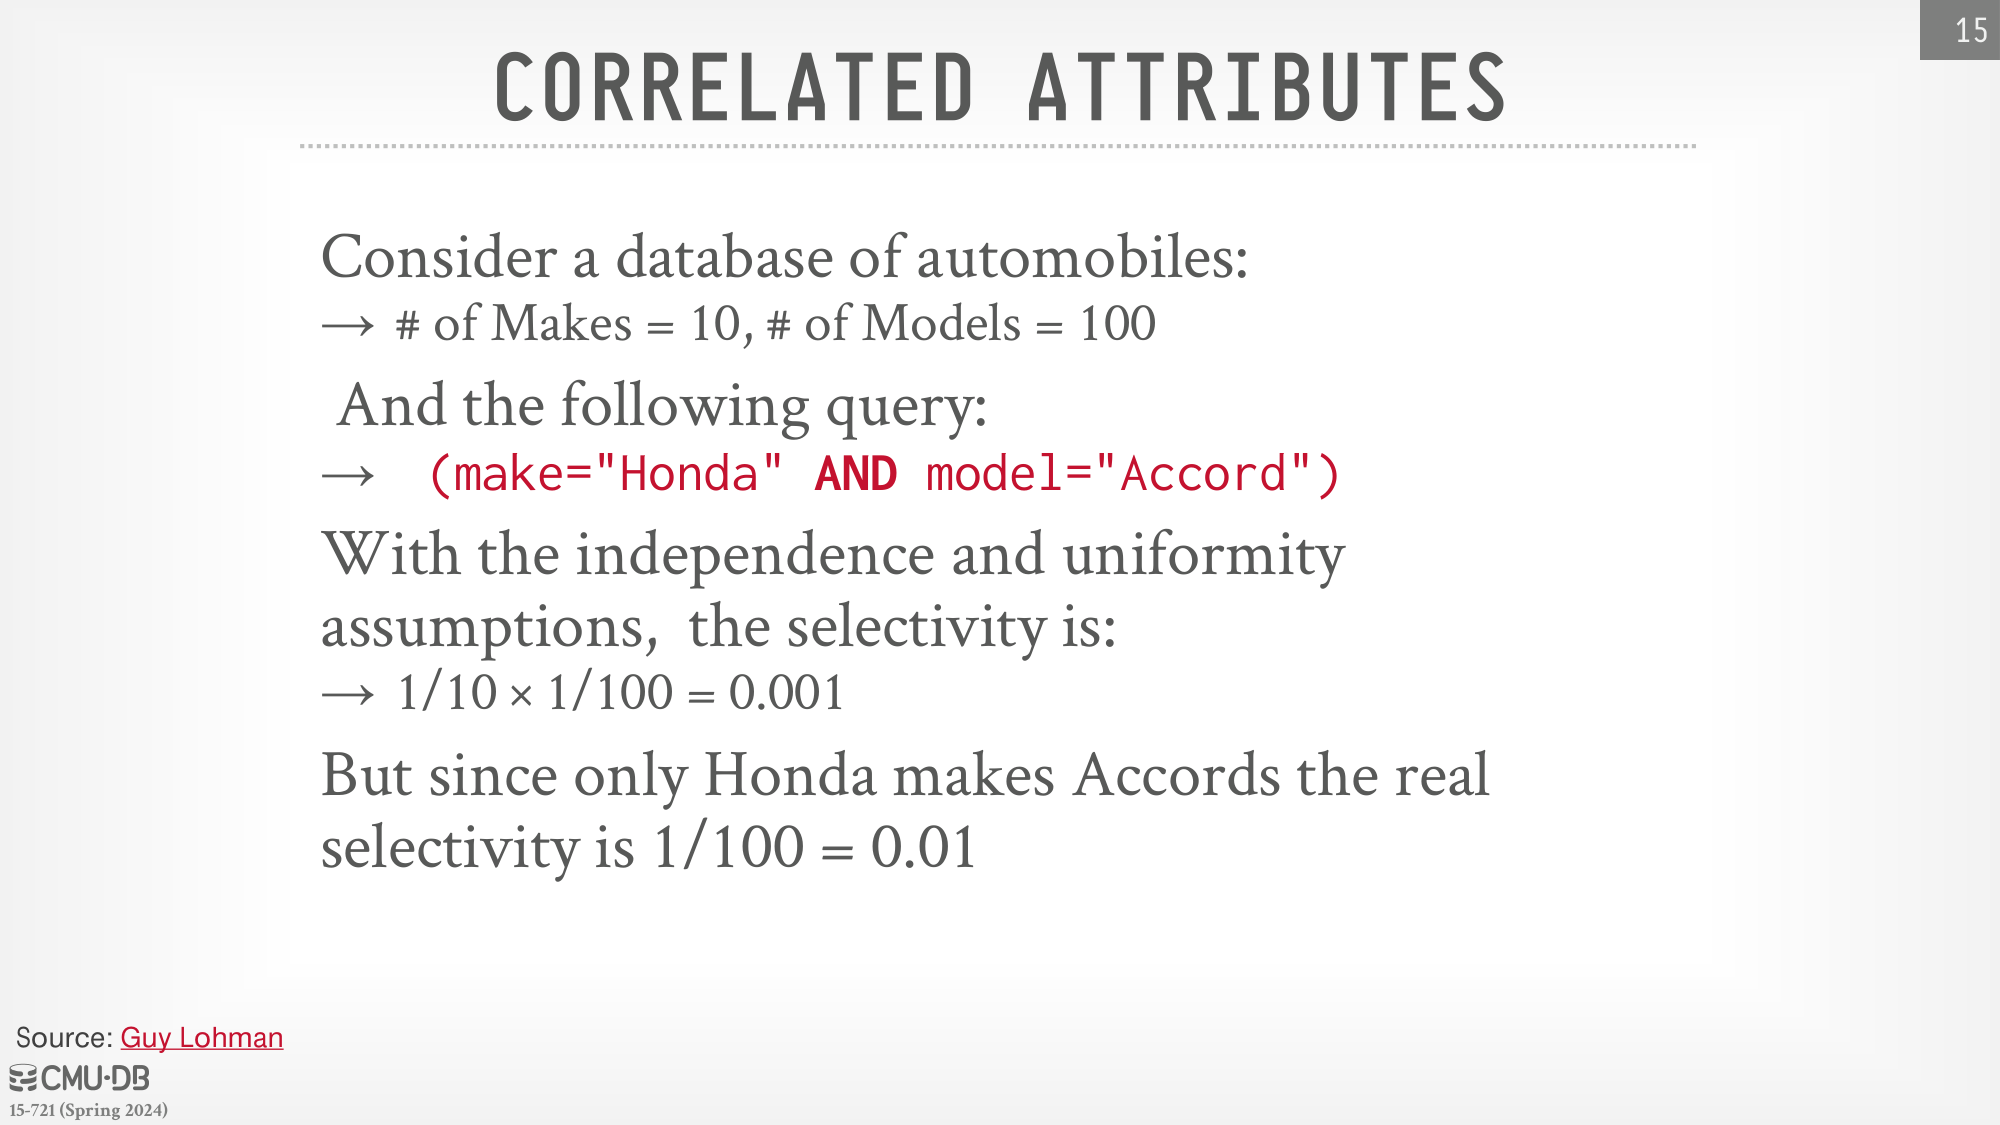
课件假设有 10 个品牌和 100 种车型,查询条件是品牌为 Honda、车型为 Accord。若按均匀分布与独立性估计,选择率是 1/10 × 1/100 = 0.001;但 Accord 属于 Honda,因此例子中的真实选择率是 1/100 = 0.01。把两个条件直接当成独立事件,会低估两者同时成立的比例。多列统计可以保存部分相关性,但属性组合很多,不能无代价地为所有组合建立完整分布。
JOB 实验暴露了什么
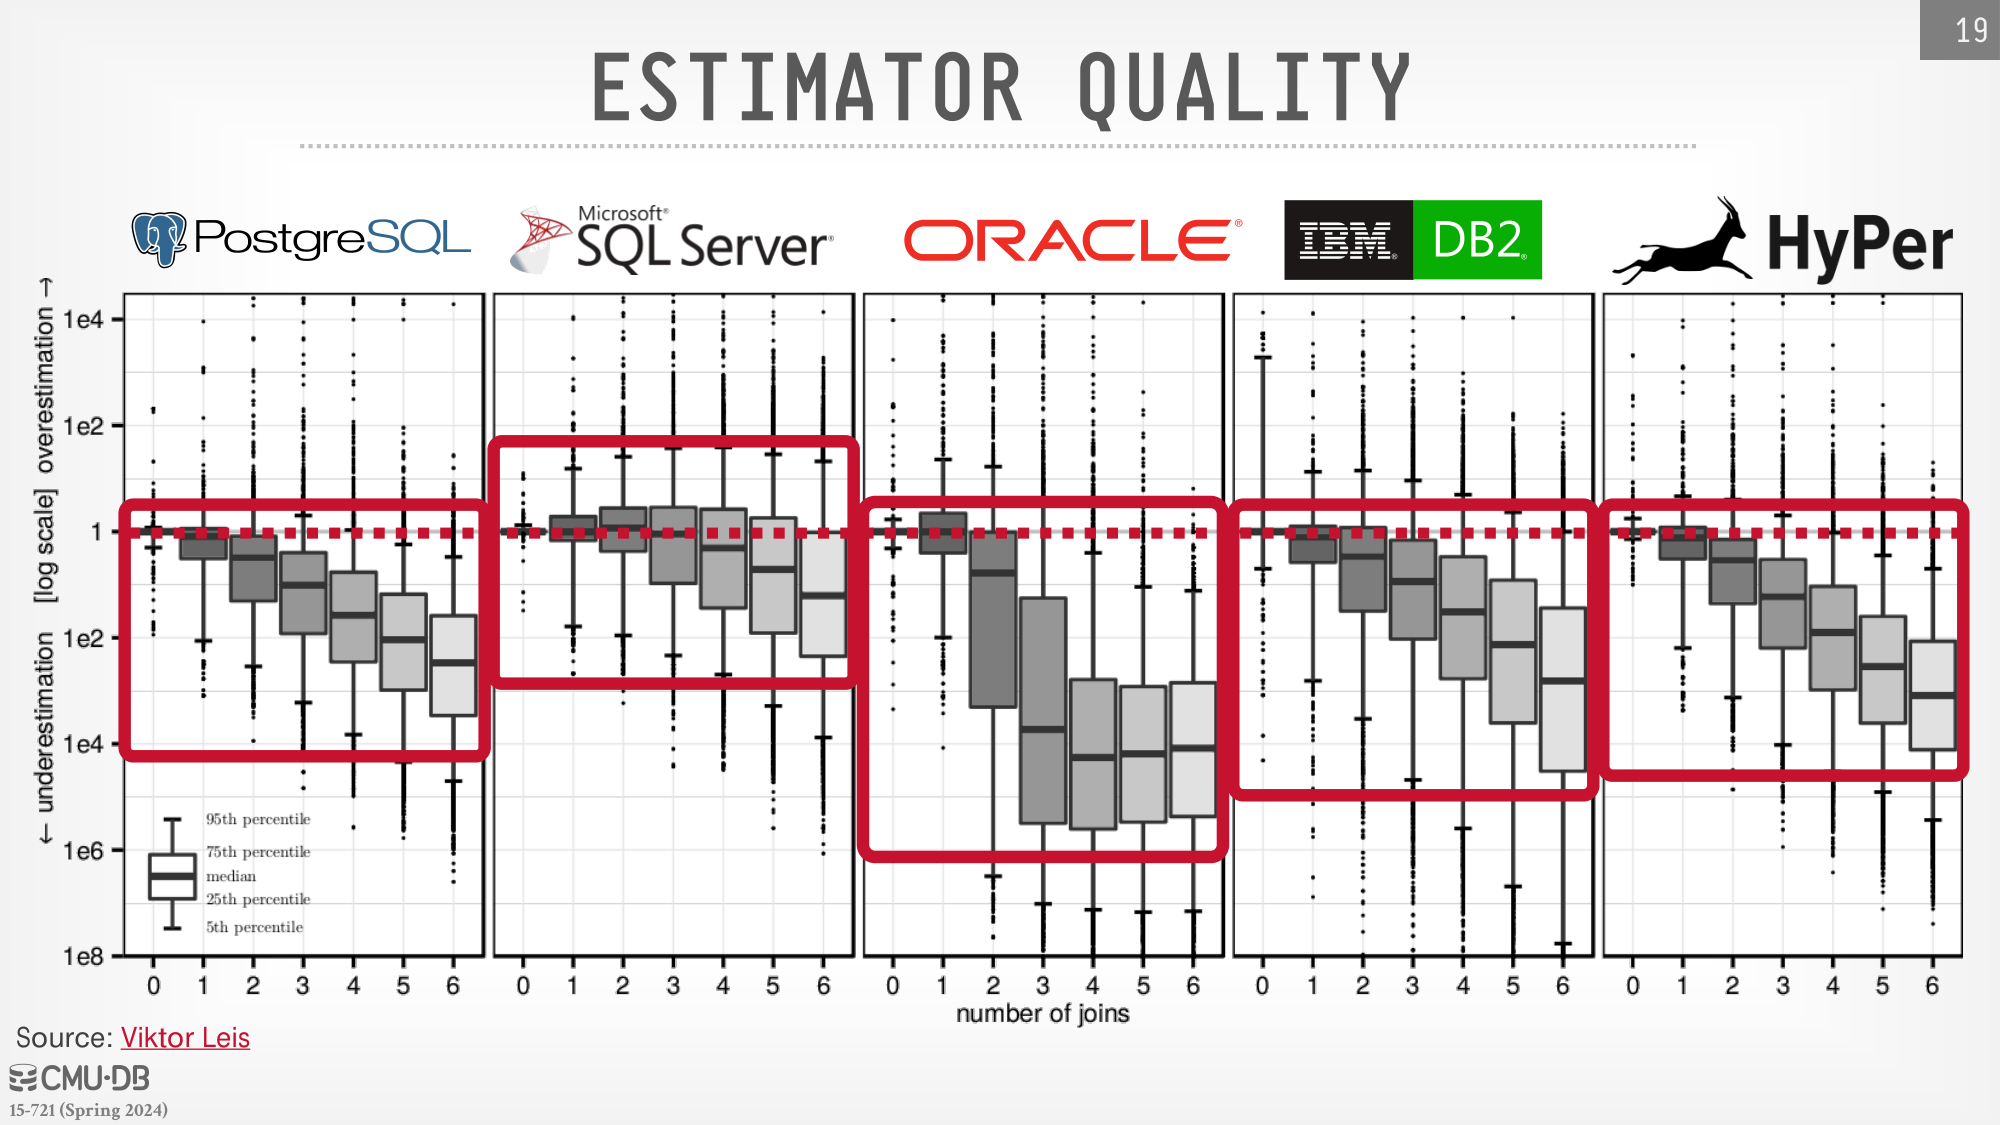
JOB 使用 IMDB 数据和多表连接查询检验优化器。课件中的结果表明,连接增加后,基数估计可能出现数量级误差,并且低估会误导连接顺序与算子选择。
研究由此强调两件事:要认真处理基数信息,也要让执行方式对误差更稳健。顺序扫描与哈希连接在相应实验中较稳健,而更多索引虽然提供了更快路径,也扩大了估计失误时可能选中的高风险方案。
这些是具体研究负载中的观察。它们支持把优化精力从微调物理常数转向基数与鲁棒性,并不意味着准确的代价建模在任何系统中都没有价值。
系统怎样落地这些模型
PostgreSQL 将 CPU 和 I/O 项乘以可配置权重,默认常数体现一定硬件假设。课件用顺序与随机 I/O 权重说明这些数字需要解释;它们不是现代存储设备固定的速度比例。
DB2 在系统目录中维护硬件、存储、带宽、内存与并发环境信息;Smallbase 先识别执行 Primitive,再用微基准测量成本,组合成算子模型。
DuckDB 面对第一次读取的外部文件时,未必已有完整统计。课程讨论的研究使用不同值数量等信息构造保守连接估计,并在缺少信息时回退到经验选择率。这些行为应放在课件与对应论文的版本背景下理解。
代价模型的目标是帮助系统作出较好的选择。复习时可以沿着一条计划追踪:原始统计如何进入选择率,选择率怎样进入基数,基数如何改变连接与访问路径,最后哪些运行反馈能够纠正它。