课程视频
并行哈希连接在优化什么
本讲讨论 OLAP 场景下、主要数据能够放进内存的两表等值连接。设计目标是让多个核心持续工作,同时减少同步、随机内存访问和跨 NUMA 节点的数据移动。
缓存友好与无锁并不是两项孤立优化。为了减少锁,可以让线程维护私有结构;为了让数据进入缓存,可以先分区;但私有结构最终可能要合并,分区也需要额外扫描和写入。算法需要比较这些成本与节省下来的缓存未命中开销。
Partition、Build 与 Probe
哈希连接包含三个阶段:可选的分区、构建哈希表和探测。构建侧 R 按连接键进入哈希结构,探测侧 S 再按键寻找匹配,最后输出连接结果。
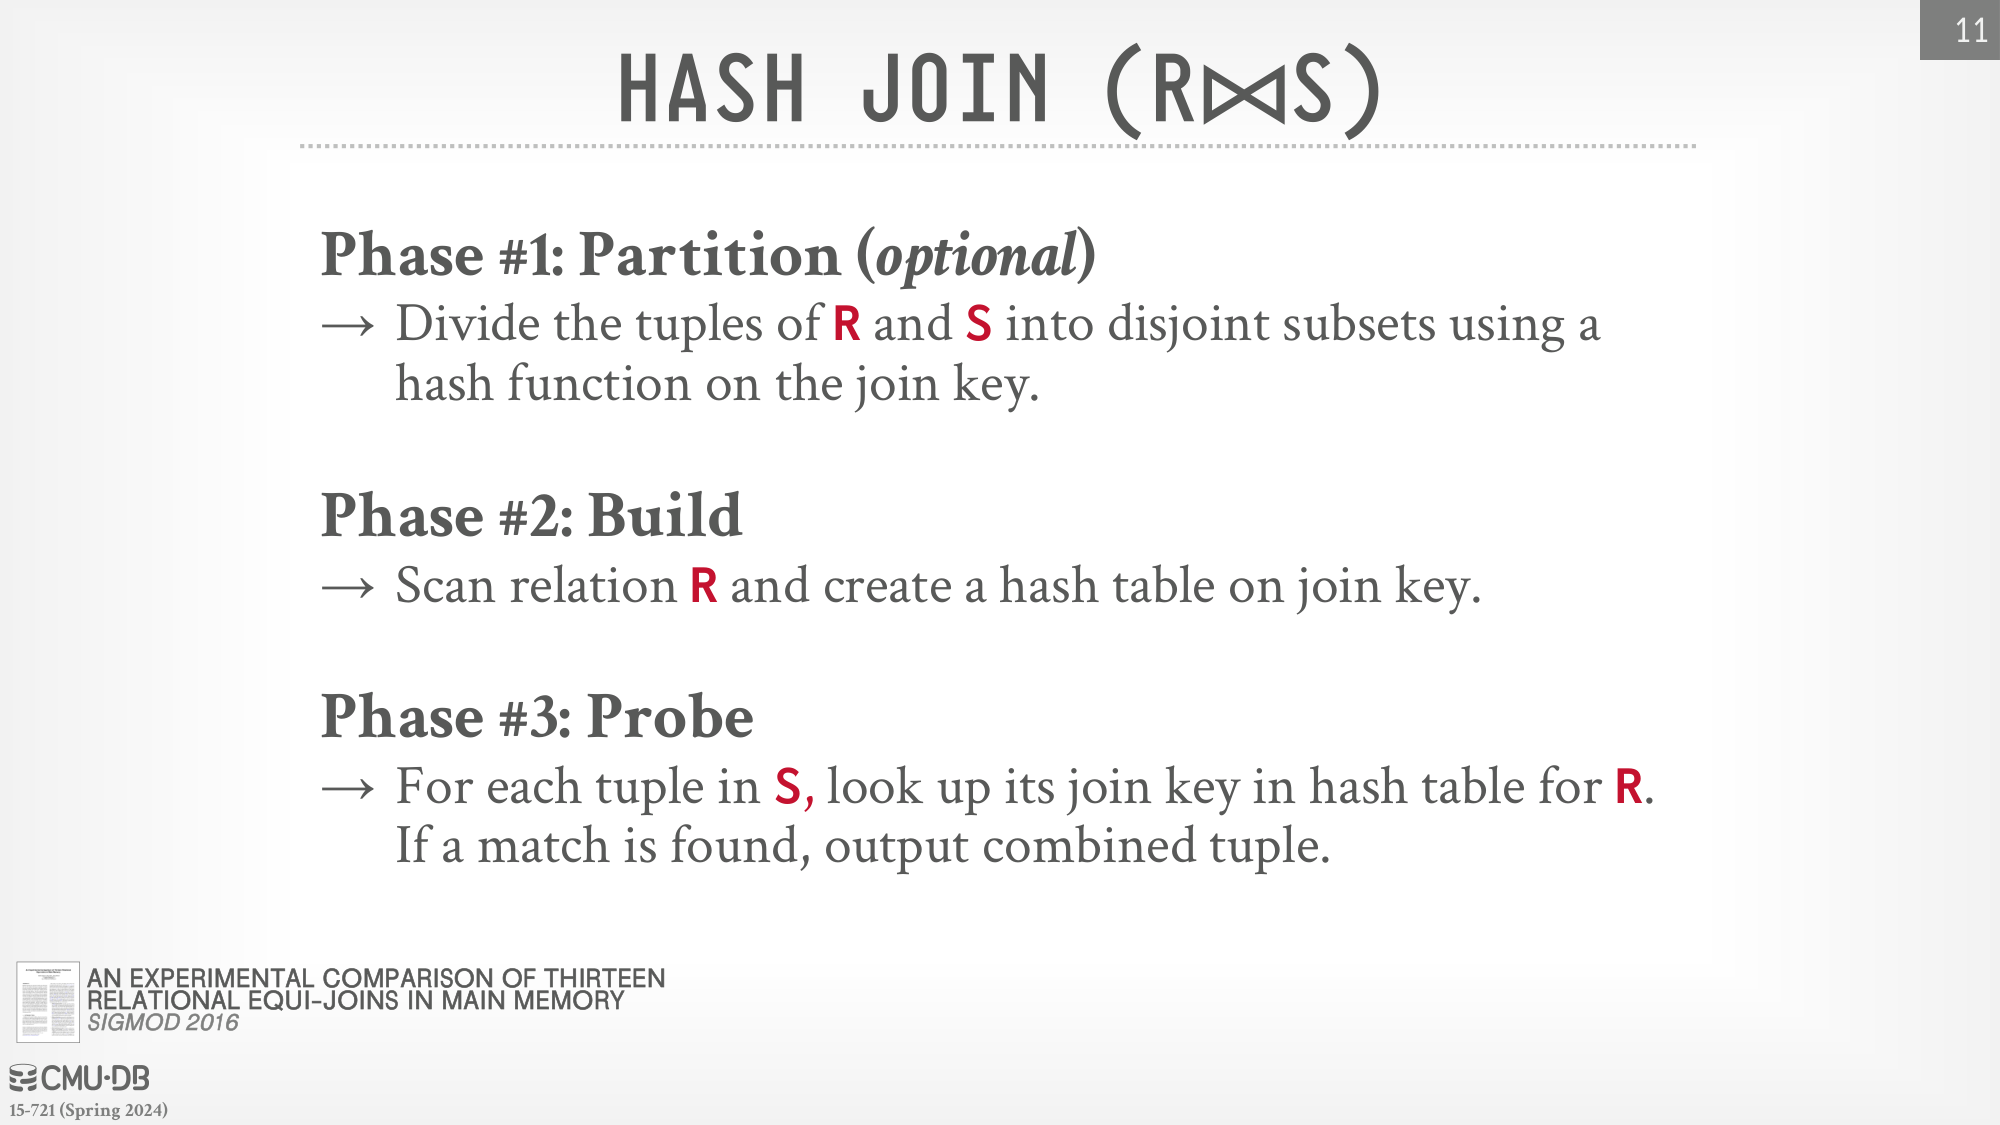
不分区方案省去前置数据重排,但多个线程构建共享哈希表时需要处理冲突与同步,较大的表也可能超出缓存。分区方案先把相同键送到相容分区,让 Worker 在更小的局部结构上工作。
把较小输入作为构建侧通常有助于减少状态,但行宽、重复键与输出量也会影响实际成本。连接正确性要求保留同键的全部匹配,不能像普通键值映射那样只保留一个值。
单遍分区与 Radix 分区
单遍分区可以增量输出。共享分区让所有线程写入同一组缓冲区,需要协调写位置;私有分区为各线程准备自己的输出,减少争抢,但之后要合并或管理多份数据。
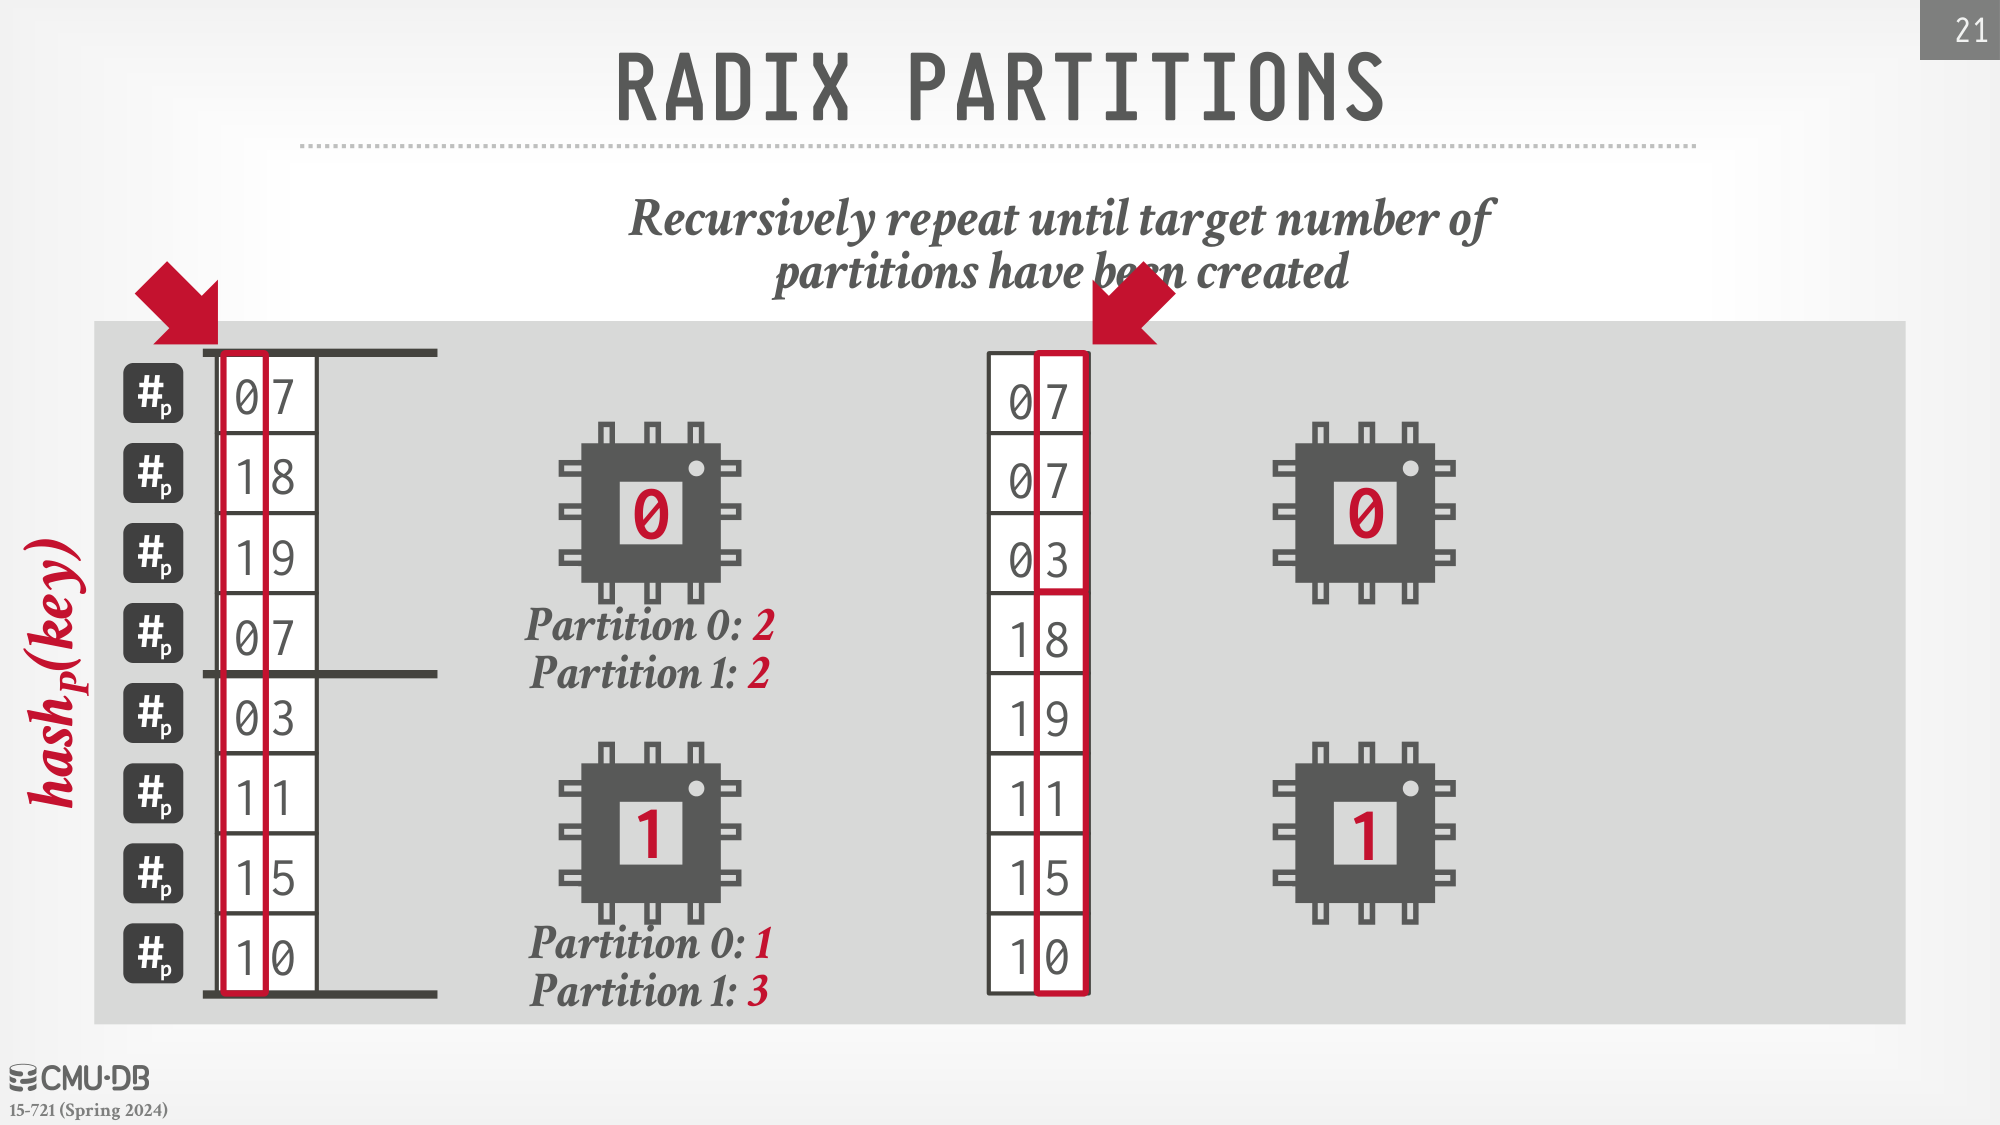
Radix 分区先统计哈希值某些位对应的分区大小,再通过前缀和确定写入区间,最后扫描并写入目标位置。线程知道自己的写入范围后,可以减少输出阶段的锁竞争。
分区数过少,局部哈希表仍可能太大;分区数过多,又会增加缓冲区、TLB 压力与写入成本。可以使用多轮分区,但每一轮都意味着额外的数据访问,不能只看分区后探测阶段的速度。
哈希表中的设计选择
哈希函数需要在计算开销和分布质量之间权衡。不同数据类型与分布可能适合不同实现;较差的哈希分布会放大冲突,影响后续所有阶段。
冲突处理包括链式结构、开放寻址,以及 Robin Hood、Hopscotch、Cuckoo 等变体。链式结构可以继续追加匹配项,但追逐指针会增加随机访问;开放寻址保持较紧凑的数组布局,装载率升高后却可能需要更多次探测。
哈希条目可以保存键、缓存的哈希值、实际载荷或行位置。额外保存哈希值需要空间,却能在比较变长键之前先排除明显不匹配;保存位置减少复制,但输出时还要回到源数据读取其他列。
探测、Bloom Filter 与输出物化
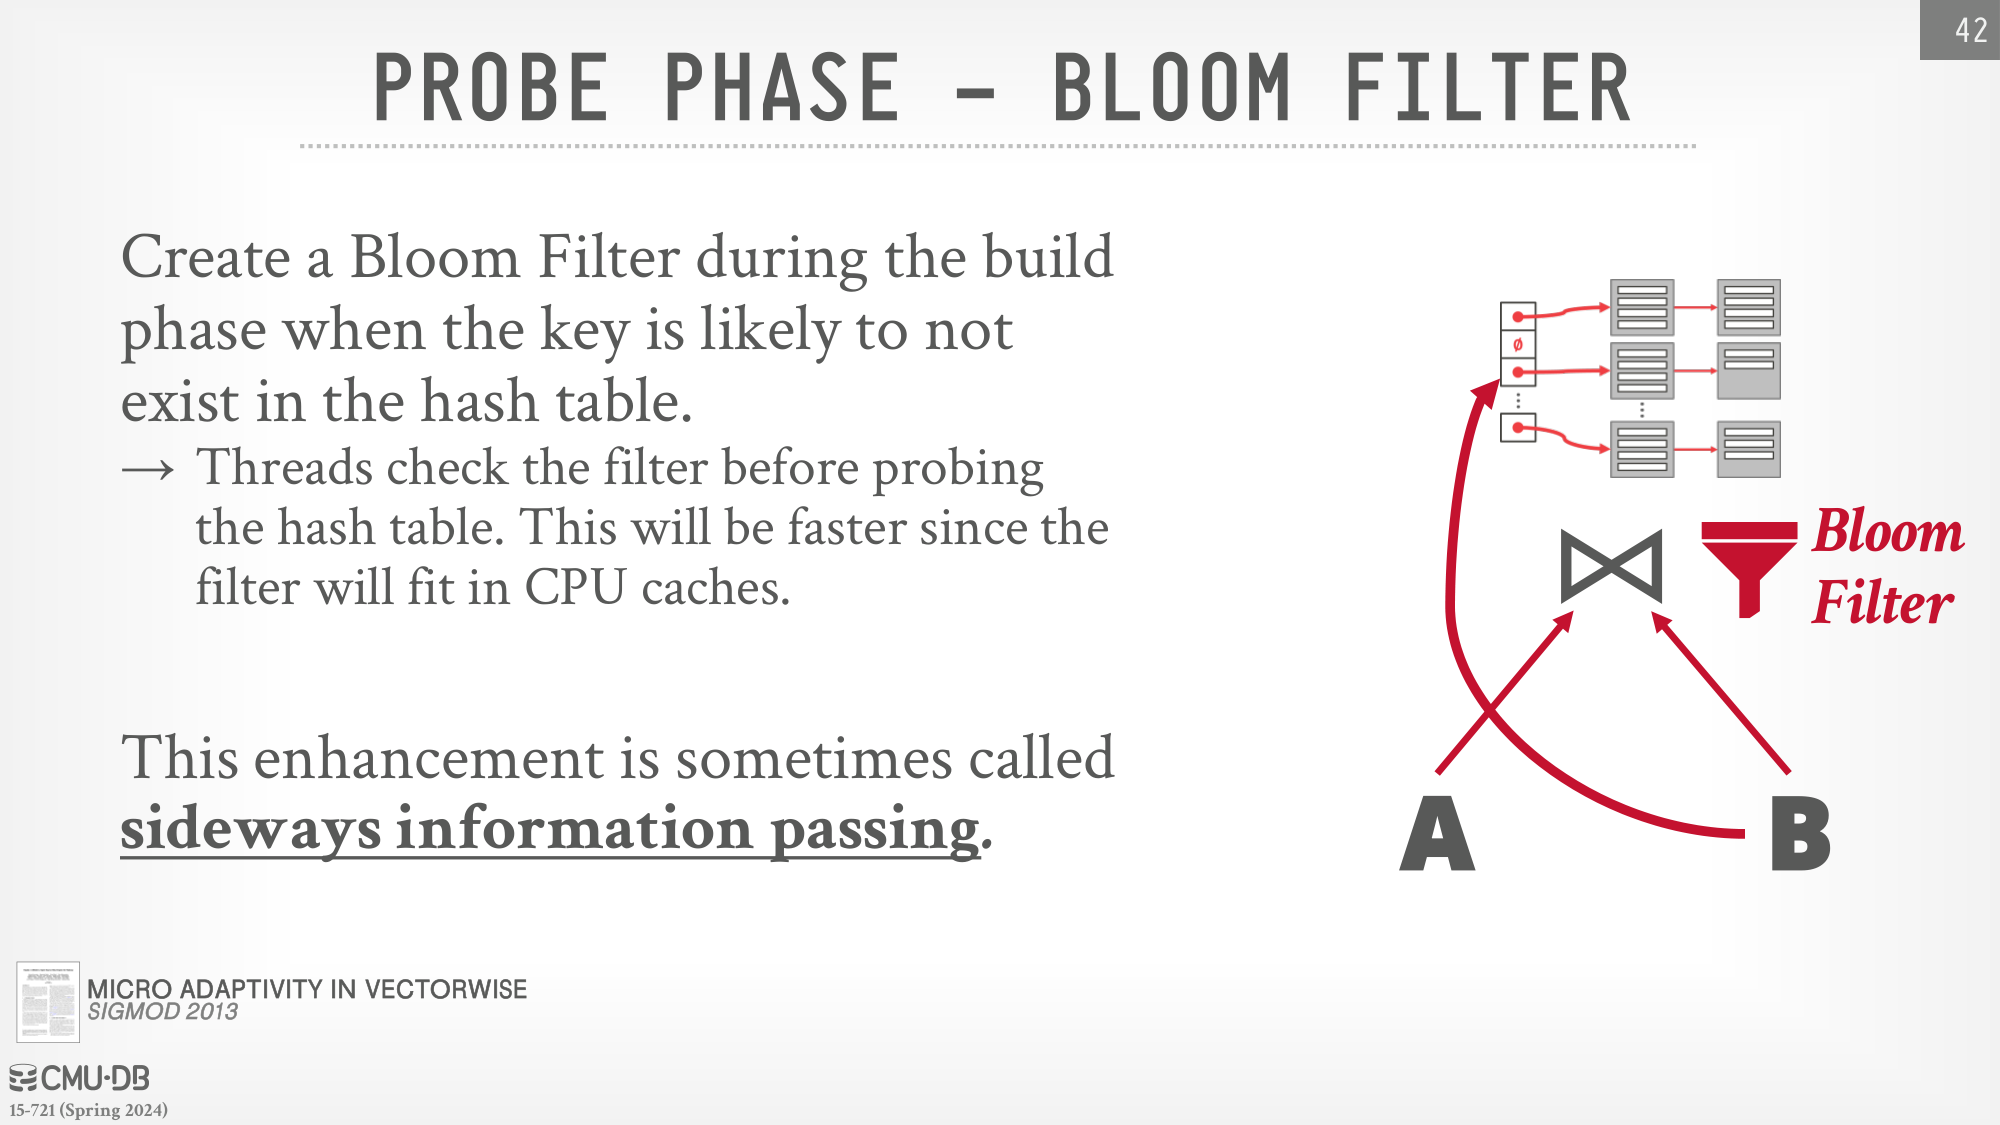
构建期间可以同时生成 Bloom Filter。探测键先检查较小的过滤器,如果确定不存在,就不必访问较大的哈希表;过滤器判断“可能存在”时仍需执行真实探测。
这类 Sideways Information Passing 把一个运算符得到的信息提供给其他执行步骤,减少没有收益的工作。过滤器本身的构建、读取和假阳性也有成本,匹配率很高时未必划算。
连接结果的拼接和物化同样需要计时。只统计找到匹配键的速度、忽略输出列复制,会使实验偏离真实数据库中的连接开销。
怎样阅读连接算法实验
课件比较了不同输入大小、键分布、线程数、缓存和硬件条件。分区方案在不少设置下表现较好,但合适参数并不容易选择,也不能据此推出某个固定算法永远胜出。
评估时应把分区、构建、探测和输出一起统计,分别观察均匀与倾斜数据,并说明状态是否进入缓存、数据放在哪个 NUMA 节点。一个阶段节省的时间,可能被另一个阶段的数据重排抵消。