课程视频
Redshift 的演进背景
Redshift 从 ParAccel 的并行分析型架构发展而来,逐步增加存算分离、外部数据访问与托管资源能力。本讲使用《Amazon Redshift Re-Invented》分析这些改进,关注如何在已有系统上持续替换组件。
课程也区分 Redshift、Spectrum 与 Athena:托管仓库组织自己的存储与计算,Spectrum 扩展对对象存储文件的查询,Athena 则是另一条基于数据湖的查询服务路径。它们都属于 AWS 分析服务,但执行与管理边界不同。
执行、存储与管理服务
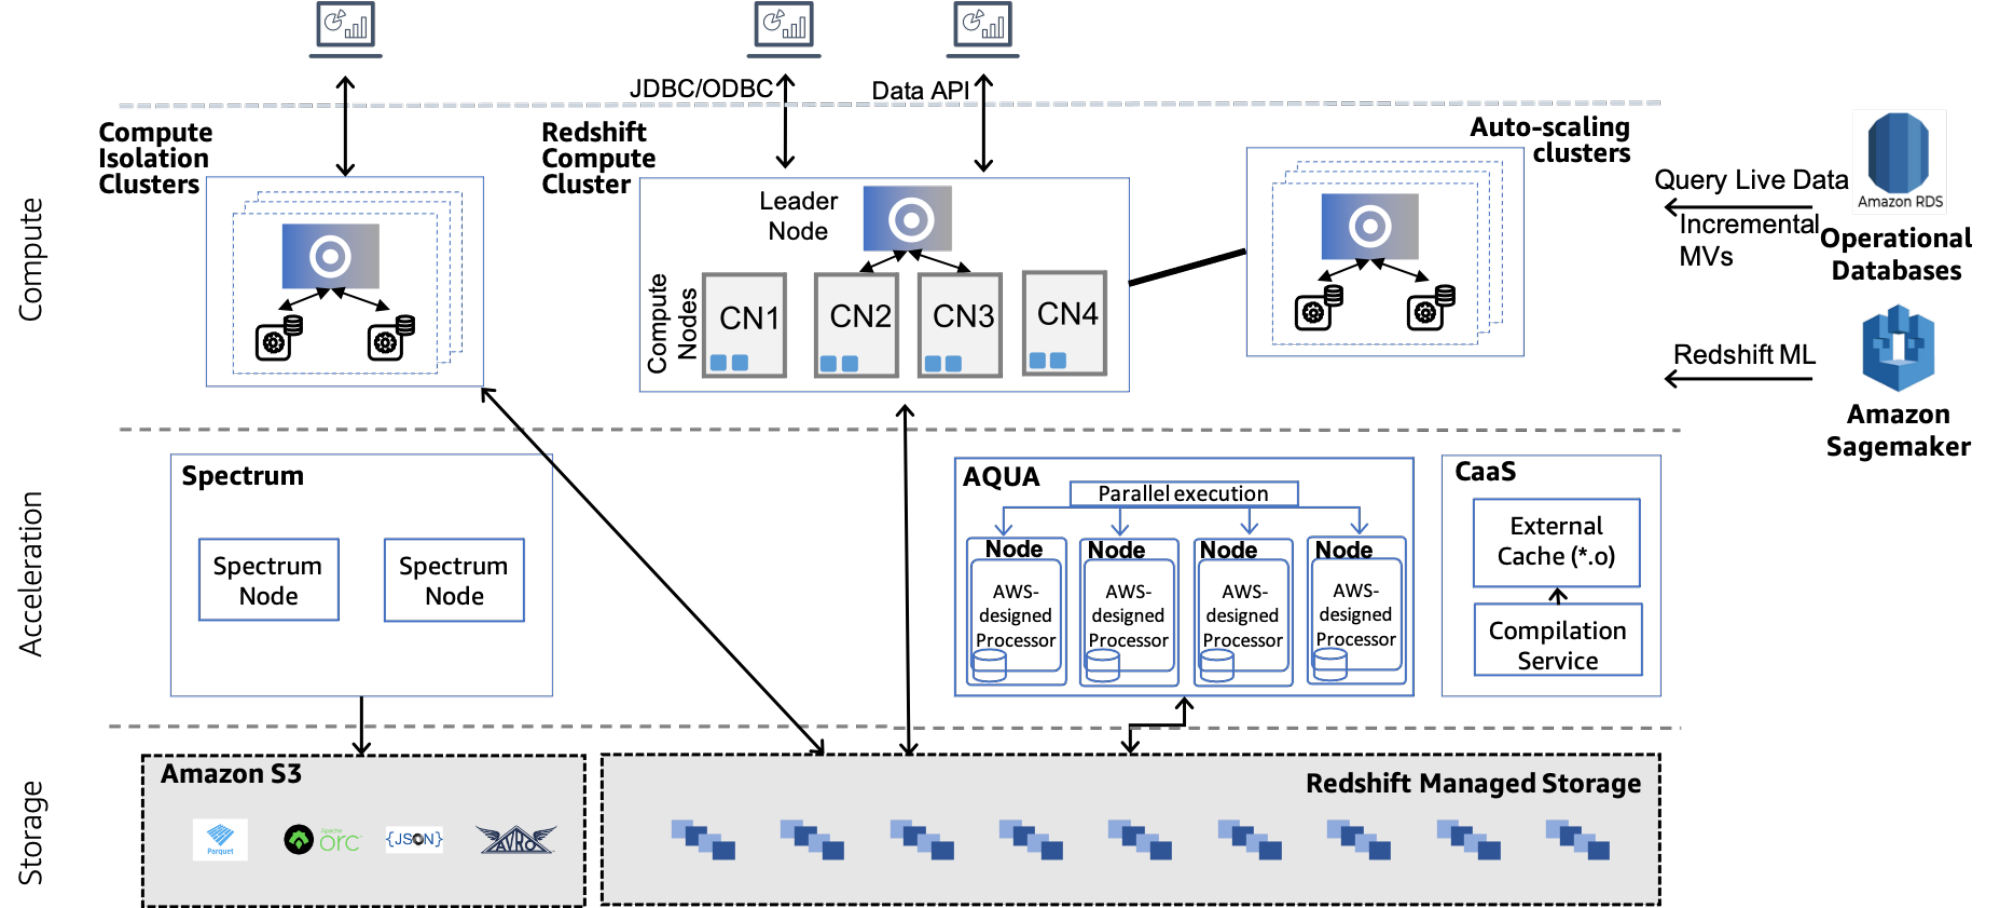
架构将查询入口、计算资源和托管存储连接起来,并通过缓存降低重复访问远端数据的成本。外部文件路径还需要解释文件元数据、列编码和可下推条件。
执行器采用 Push-Based 向量化与延迟物化,结合预编译 Primitive 和查询片段代码生成。软件预取把后续需要的数据提前送入缓存,SIMD 用于合适的扫描与表达式操作。
这里的“混合”不只是同时存在两套代码:运行时需要决定哪些计算直接复用已有内核,哪些值得专门生成代码,并让它们共享相容的数据表示。
独立编译服务减少启动成本
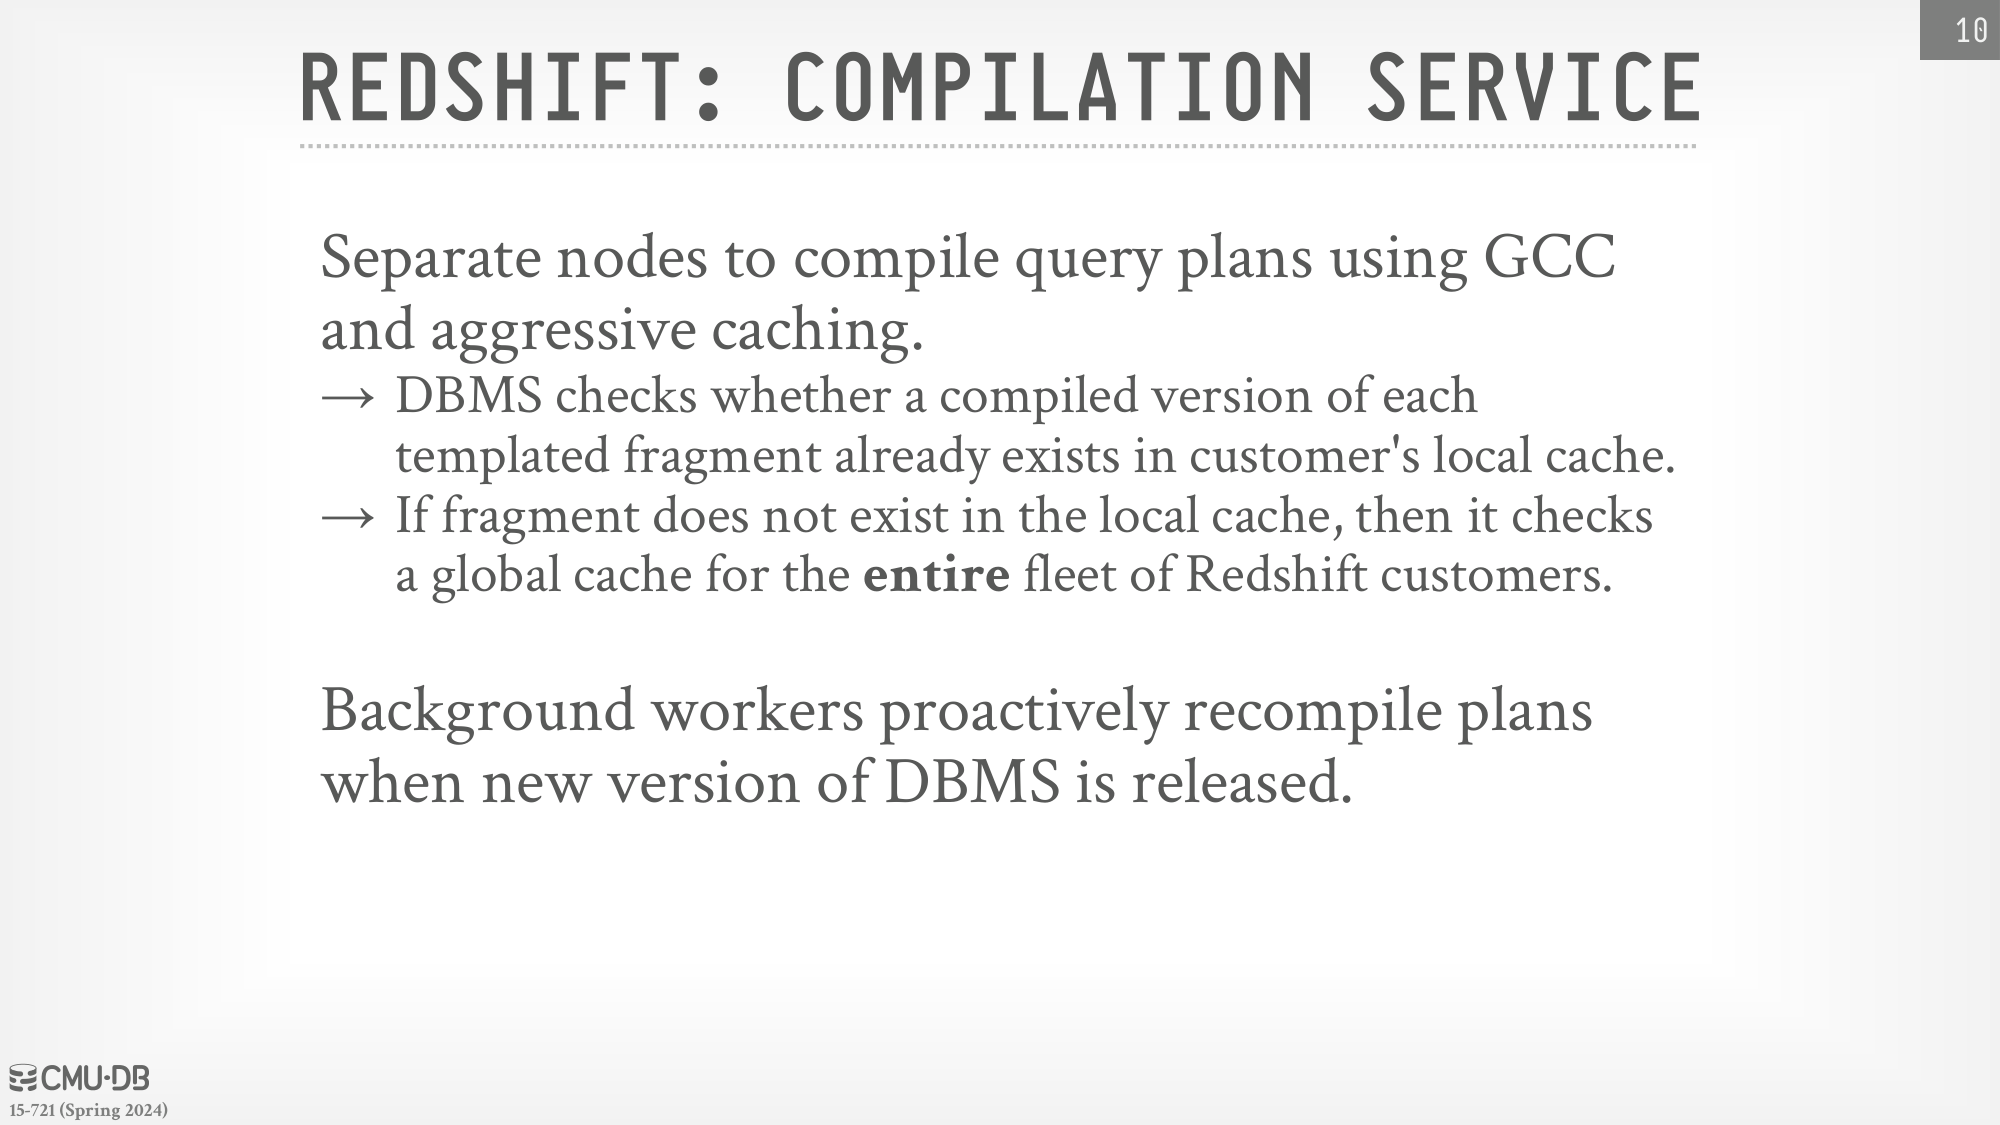
编译服务先检查客户本地缓存,再检查跨部署复用的全局缓存,未命中时才编译相应模板片段。新引擎版本发布时,还可以后台提前重编译,减少用户第一次运行时的等待。
片段缓存需要维护参数化、版本与依赖。相同 SQL 文本不保证生成代码可以无条件复用;反过来,不同常量参数的查询也可能共享相同模板。
优化器、统计与存储编码
课程中的优化器先进行规则重写,再开展代价搜索。Query Rewriting Framework 为计划转换提供组织方式;读取外部 Parquet/ORC 时,可以利用范围统计和文件信息下推过滤。
存储结合列编码与压缩,课件列出字典、Delta、RLE 和 AZ64 等方案。编码减少持久化体积,也改变扫描、解码与随机访问的成本,因此选择需要和执行方式一起考虑。
本讲还回顾 AQUA 等硬件加速路径,说明计算不一定只发生在传统查询 Worker 上。硬件、托管存储与产品能力会持续演进,这里记录的是课程采用论文与课件时的设计。
怎样理解托管系统的性能比较
课件分别展示默认配置与调优后的 TPC-DS 比较。配置、资源量、负载和调优过程都会影响图中的结果,因此应保留实验语境,而不是把相对柱高当成独立于版本的数据库排名。
从 Dremel 到 Redshift,课程反复回到几个组合:计算与数据分离、计算侧缓存、列式批处理、编译复用,以及缺少统计时的适应能力。复习时可以用相同问题比较各系统:数据放在哪里,中间结果由谁保存,Worker 怎样领任务,优化器何时能得到新信息,以及失败后重做多大范围。