课程视频
从数据立方体到湖仓系统
分析型数据库通过已有数据发现新的信息。课程先回顾 OLAP 系统的变化:20 世纪 90 年代的数据立方体提前维护多维聚合,查询可以直接读取预计算结果,但管理员需要预先决定聚合维度,并周期性刷新数据。
到了 2000 年代,数据仓库更强调列式存储和 Shared-Nothing 架构。业务数据库经过抽取、转换和加载,把数据放入专门处理分析查询的系统。数据格式通常由数据库自行管理,系统间共享数据需要额外转换。
2010 年代之后,一类系统把持久化数据交给外部对象存储,计算节点通过网络读取数据;湖仓系统进一步在数据湖上增加模式管理、版本和事务操作。课程关注的是这些系统的查询处理组件,湖仓事务层的实现并不是本课程的展开重点。
这种变化与三个需求有关:用户希望在同一份数据上运行 SQL 以外的程序;存储与数据库解耦可以降低数据进出系统的障碍;实际数据包含大量半结构化与非结构化内容。
一个查询会经过哪些组件
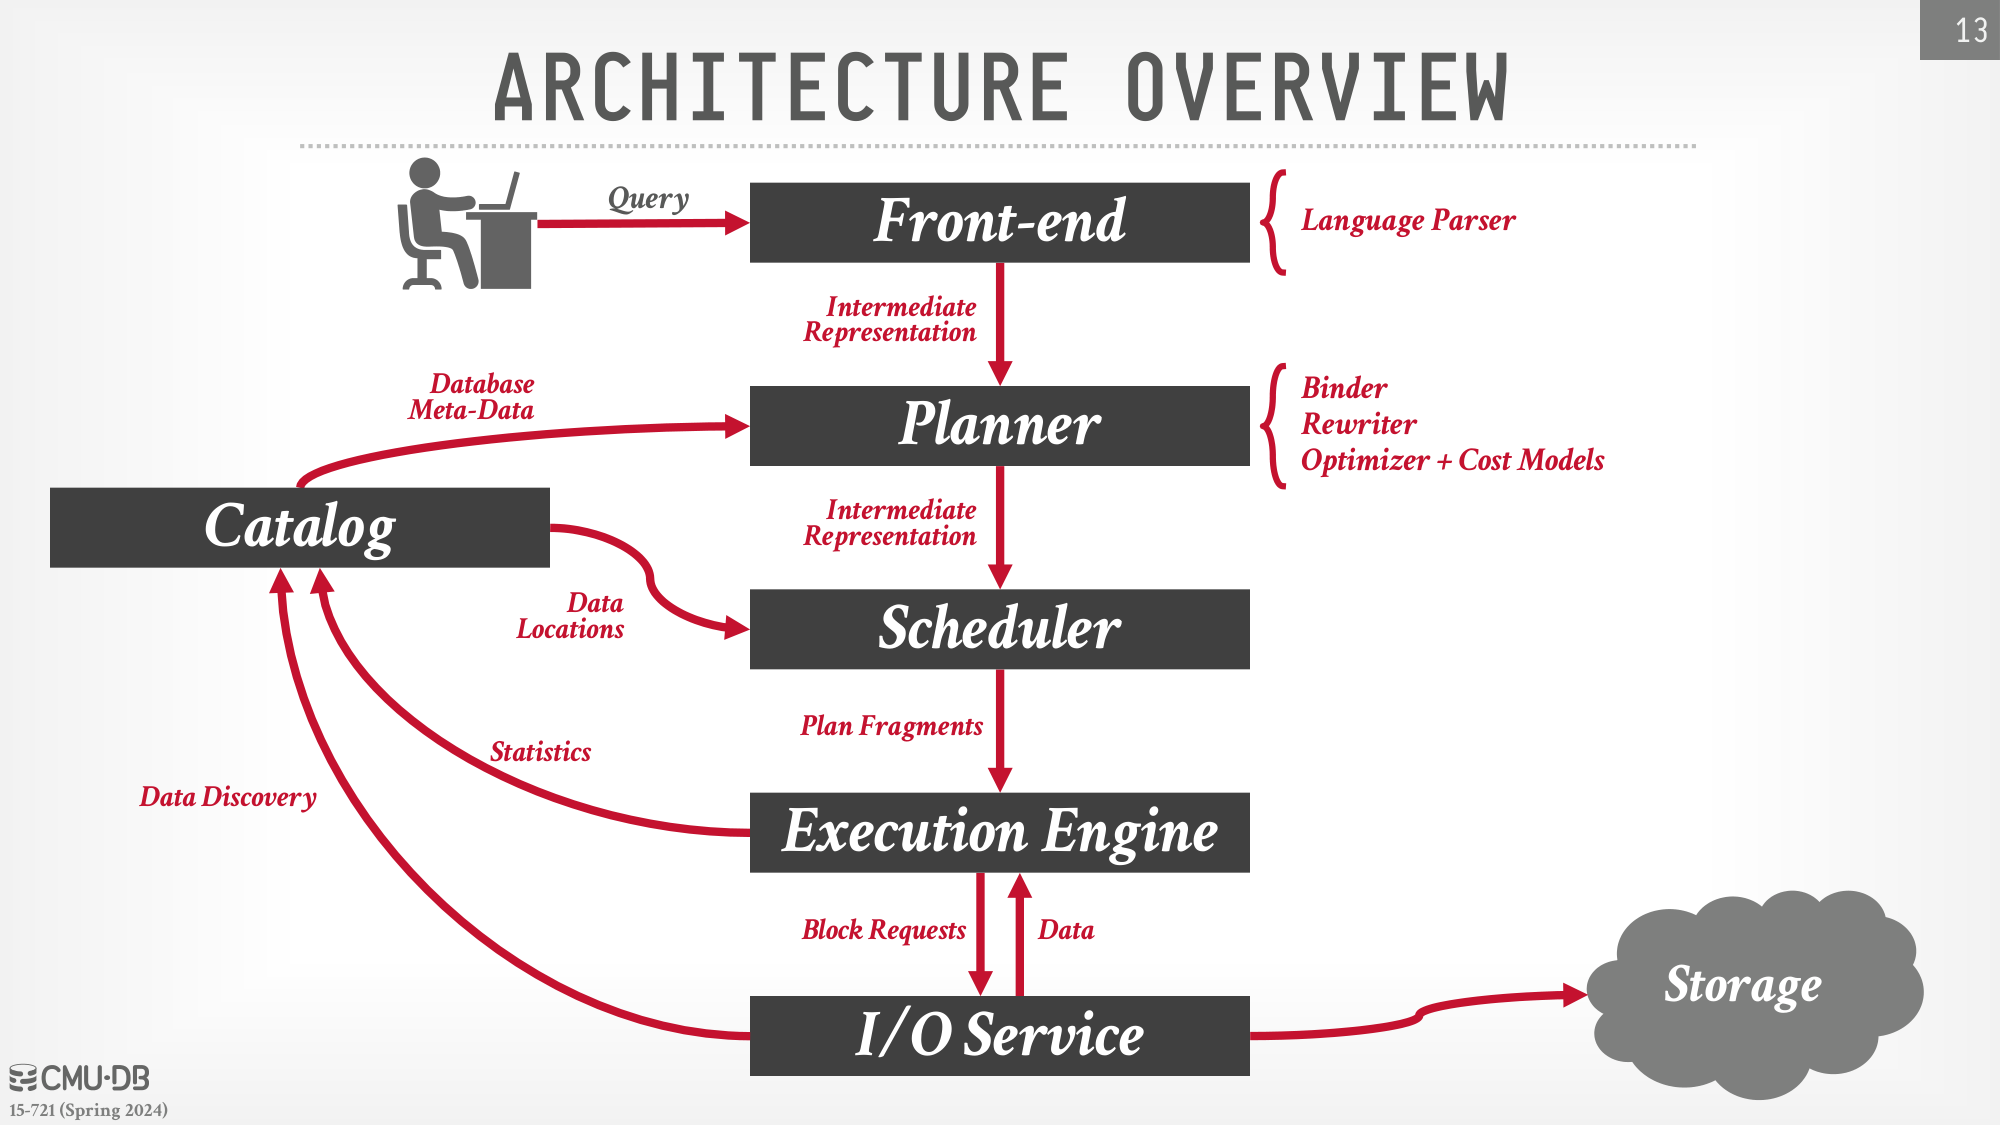
查询首先经过解析器和绑定器,把文本中的表、列与目录中的对象对应起来。重写器和规划器生成计划,优化器结合统计信息与代价模型选择执行方式。调度器再把计划拆成执行片段,交给执行引擎运行;底层 I/O 服务根据数据位置获取实际的数据块。
图中的目录不只提供表结构,还可能保存文件位置、统计信息与数据发现所需的信息。各组件之间需要交换中间表示,因此“把组件做成独立库”并不等于它们自然就能互操作:类型系统、计划表达、错误语义和数据编码都需要协商。
持久化数据与中间数据
分布式查询同样由物理运算符构成,只是每个运算符还要决定输入来自哪里、输出交给谁。扫描读取数据文件,连接和聚合可能需要重新分发数据,最终结果再返回协调节点。
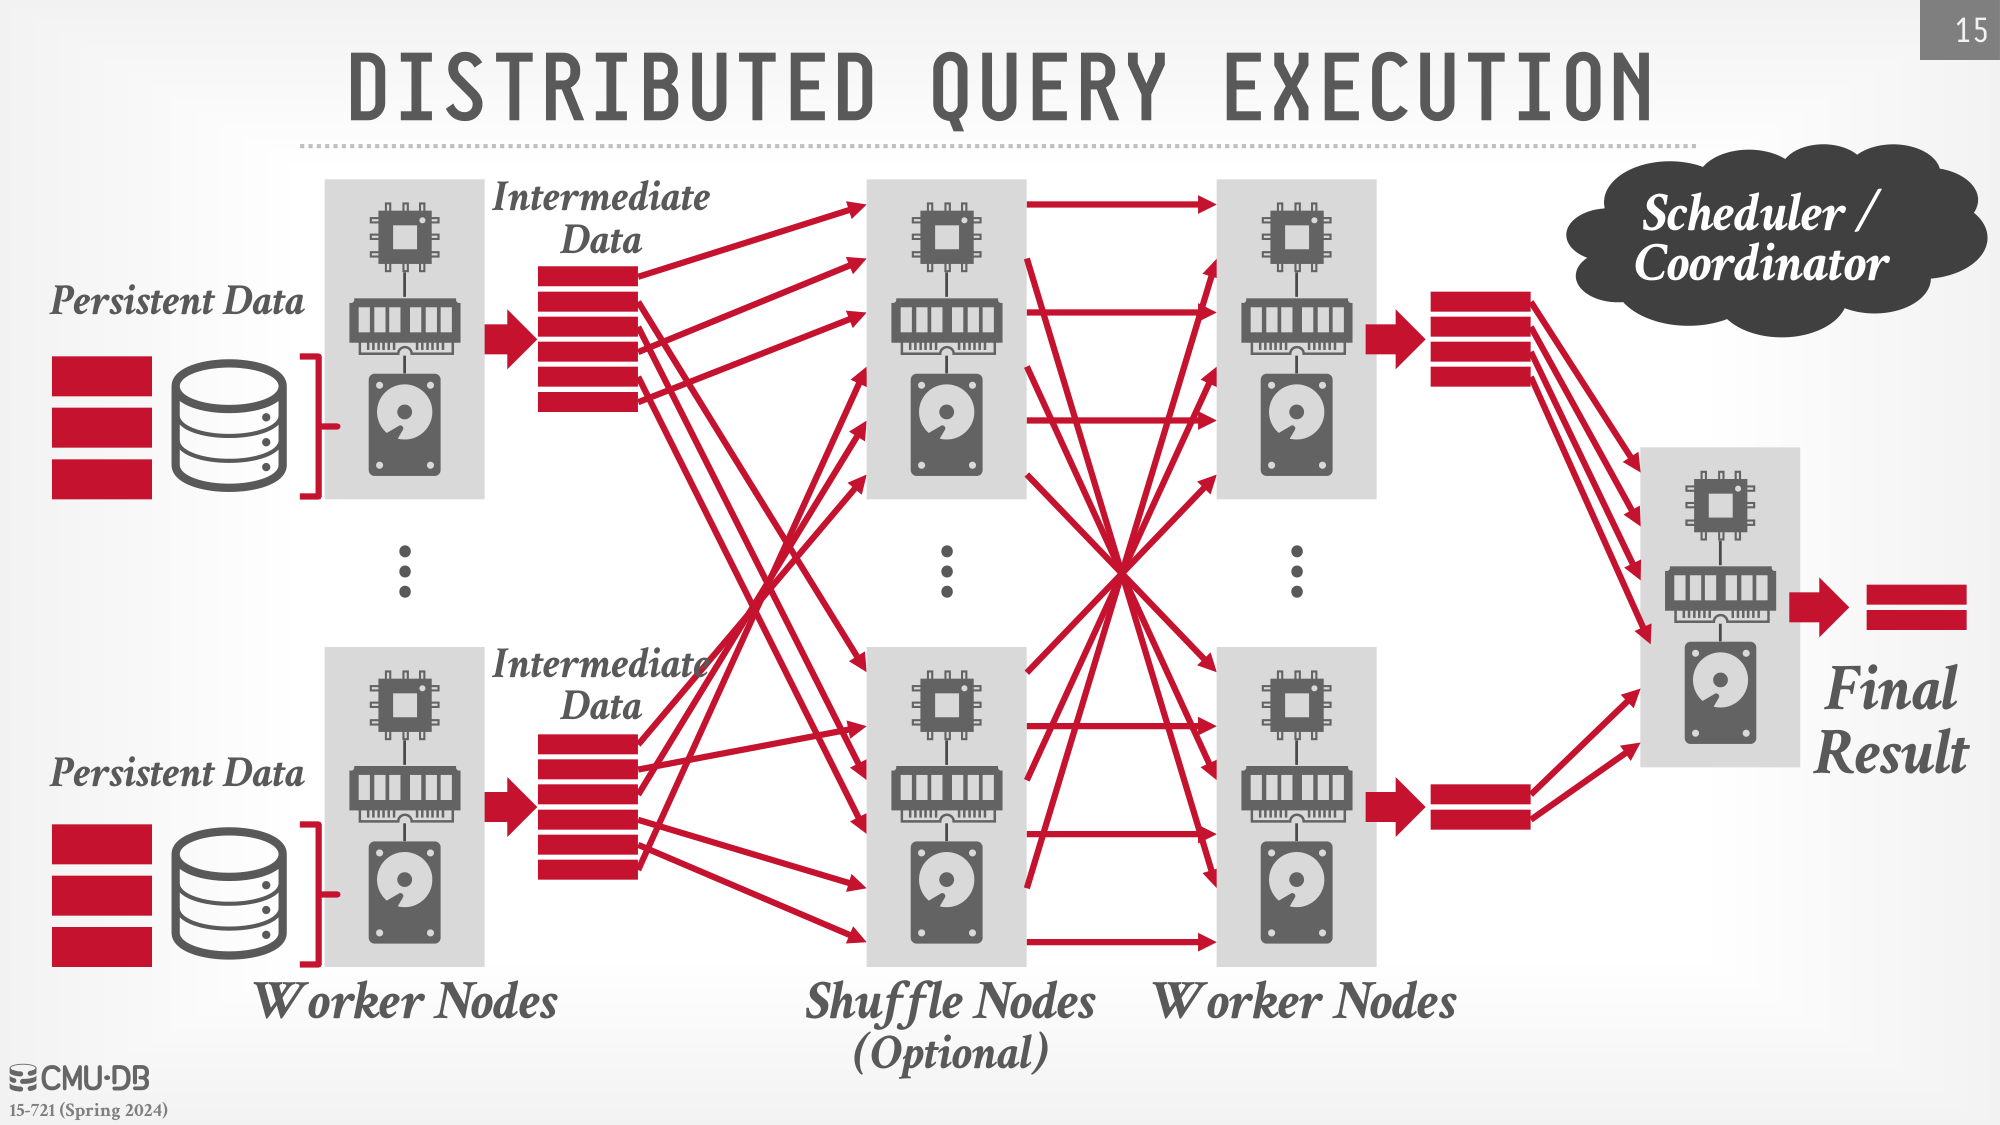
持久化数据是数据库的事实来源,例如表对应的数据文件。现代分析系统常把文件视为不可变对象,通过重写文件支持更新。中间数据则是查询执行期间产生、由其他运算符消费的短期结果。
扫描的数据量不能直接决定中间数据量。 连接可能放大记录数,聚合可能快速缩小结果,因此中间数据规模与原始文件大小、查询时长之间都不能简单画等号。设计缓存、Shuffle 和容错机制时,需要分别考虑这两类数据。
把查询送到数据旁,还是把数据取过来
Push Query to Data 将查询或部分计划发送到持有数据的节点,尽量先过滤再传输。Pull Data to Query 则把数据取到执行查询的节点;当持久化存储端没有可用计算资源时,就必须采用这种方式。两种方式可以在同一个系统中结合使用。
Shared-Nothing 中,每个实例拥有自己的 CPU、内存和本地磁盘,数据分区分布在节点上。本地处理减少了网络读取,但增加节点时通常需要搬迁数据,因此容量扩展与计算扩展相互牵连。
Shared-Disk 中,计算节点有各自的内存和临时存储,共享一个逻辑持久化存储层。计算和存储可以分别扩缩容,空闲计算节点也容易关闭;代价是未命中缓存的数据必须通过网络拉取,节点间还需要交换状态信息。
对象存储怎样影响扫描
课程讨论的典型做法,是把表拆成较大的不可变文件,文件内部采用分组列式布局。元数据记录列偏移、编码、索引与 Zone Map,执行器先读取这些信息,再决定需要请求哪些字节区间。
因此,一次扫描可以依次缩小范围:先根据元数据排除文件或行组,再只读取查询需要的列和数据块。后面几讲的文件格式、压缩与执行方式,都是围绕这个访问过程继续优化。