课程视频
把前面的组件放回完整系统
从这一讲开始,课程分析真实数据库怎样组合存储、执行、调度与优化。Dremel 的目标是在大规模数据上提供交互式分析,BigQuery 则将相关能力提供为托管服务。这里按课程采用的 2020 年 Dremel 回顾论文理解其架构。
Dremel 可以直接分析分布式存储中的数据,不要求先把所有文件复制进一个封闭数据库。计算、持久化存储和中间数据资源可以分开管理,减少扩展某一种资源时对其他资源的捆绑。
列式存储怎样保留嵌套结构
Dremel 把半结构化记录的叶子路径组织成列,通过 Definition Level 和 Repetition Level 保存可选与重复层级。读取某个叶子字段时,不必先读取全部祖先和兄弟字段。
这与前面 Parquet、Shredding 的讨论直接相连:列式布局降低不需要字段的访问量,层级信息保证部分读取之后仍能恢复所需记录结构。文件自描述则让引擎能够依据文件中的模式与元数据解释外部数据。
从执行树到独立 Shuffle 层
早期 Dremel 通过多层执行树传递和聚合结果,后续设计使用集中协调与独立 Shuffle 层。协调器把查询组织成 Stage DAG,再把每个 Stage 划成并行任务交给 Worker。
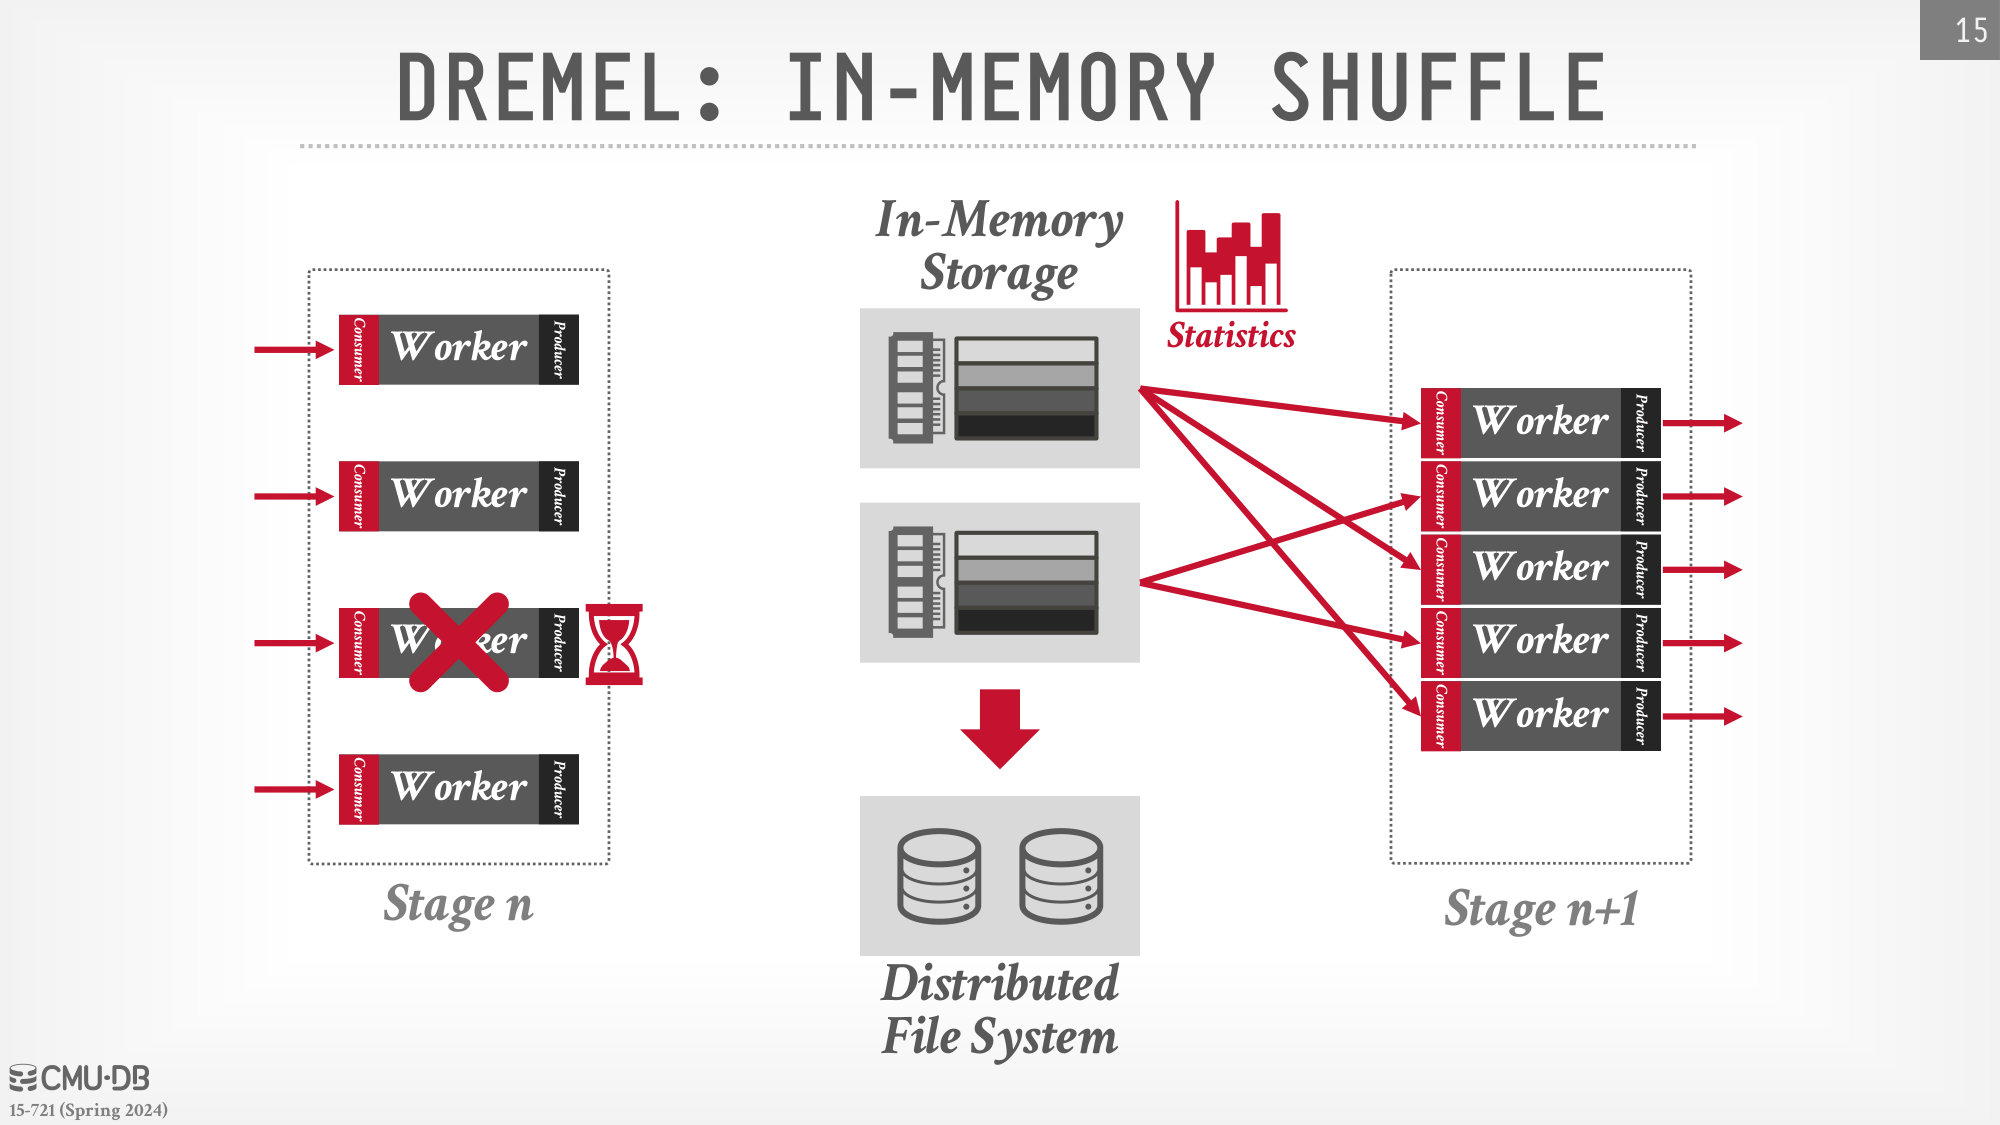
Worker 读取持久化文件、执行本地片段,再把输出写到 Shuffle 节点。后续 Stage 从对应分区读取输入,中间结果可以优先保存在内存,必要时溢写。计算 Worker 与中间结果存储因此不必具有相同的生命周期。
协调器预先获取并分发执行需要的元数据,可以避免大量 Worker 同时向存储层索取相同信息。最终结果再保存或返回给调用方。
失败、慢任务与动态分配
任务需要具备可重试的输入和明确的结果语义。检测到失败或慢任务时,系统可以重新安排执行,或启动冗余任务降低尾延迟;重复执行的输出必须被协调,不能把相同逻辑结果累计两遍。
独立 Shuffle 层保存阶段间数据,为重新执行和调整资源提供边界。协调器可以依据当前工作量增加或减少 Worker,而不必把后续阶段永久绑定到原来处理输入的节点。
在 Stage 边界修正计划
外部文件未必提供完整统计,初始优化需要结合规则和已有统计进行。执行到一个阶段边界时,系统已经知道实际输入规模,可以重新决定后续 Worker 数量、物理算子或连接策略。
例如,一侧结果足够小时,可以考虑 Broadcast,省去另一种重新分区方式;输入规模较大时则需要分区连接。选择需要计算广播复制量和接收端内存,而不只是判断表在逻辑上是不是维表。
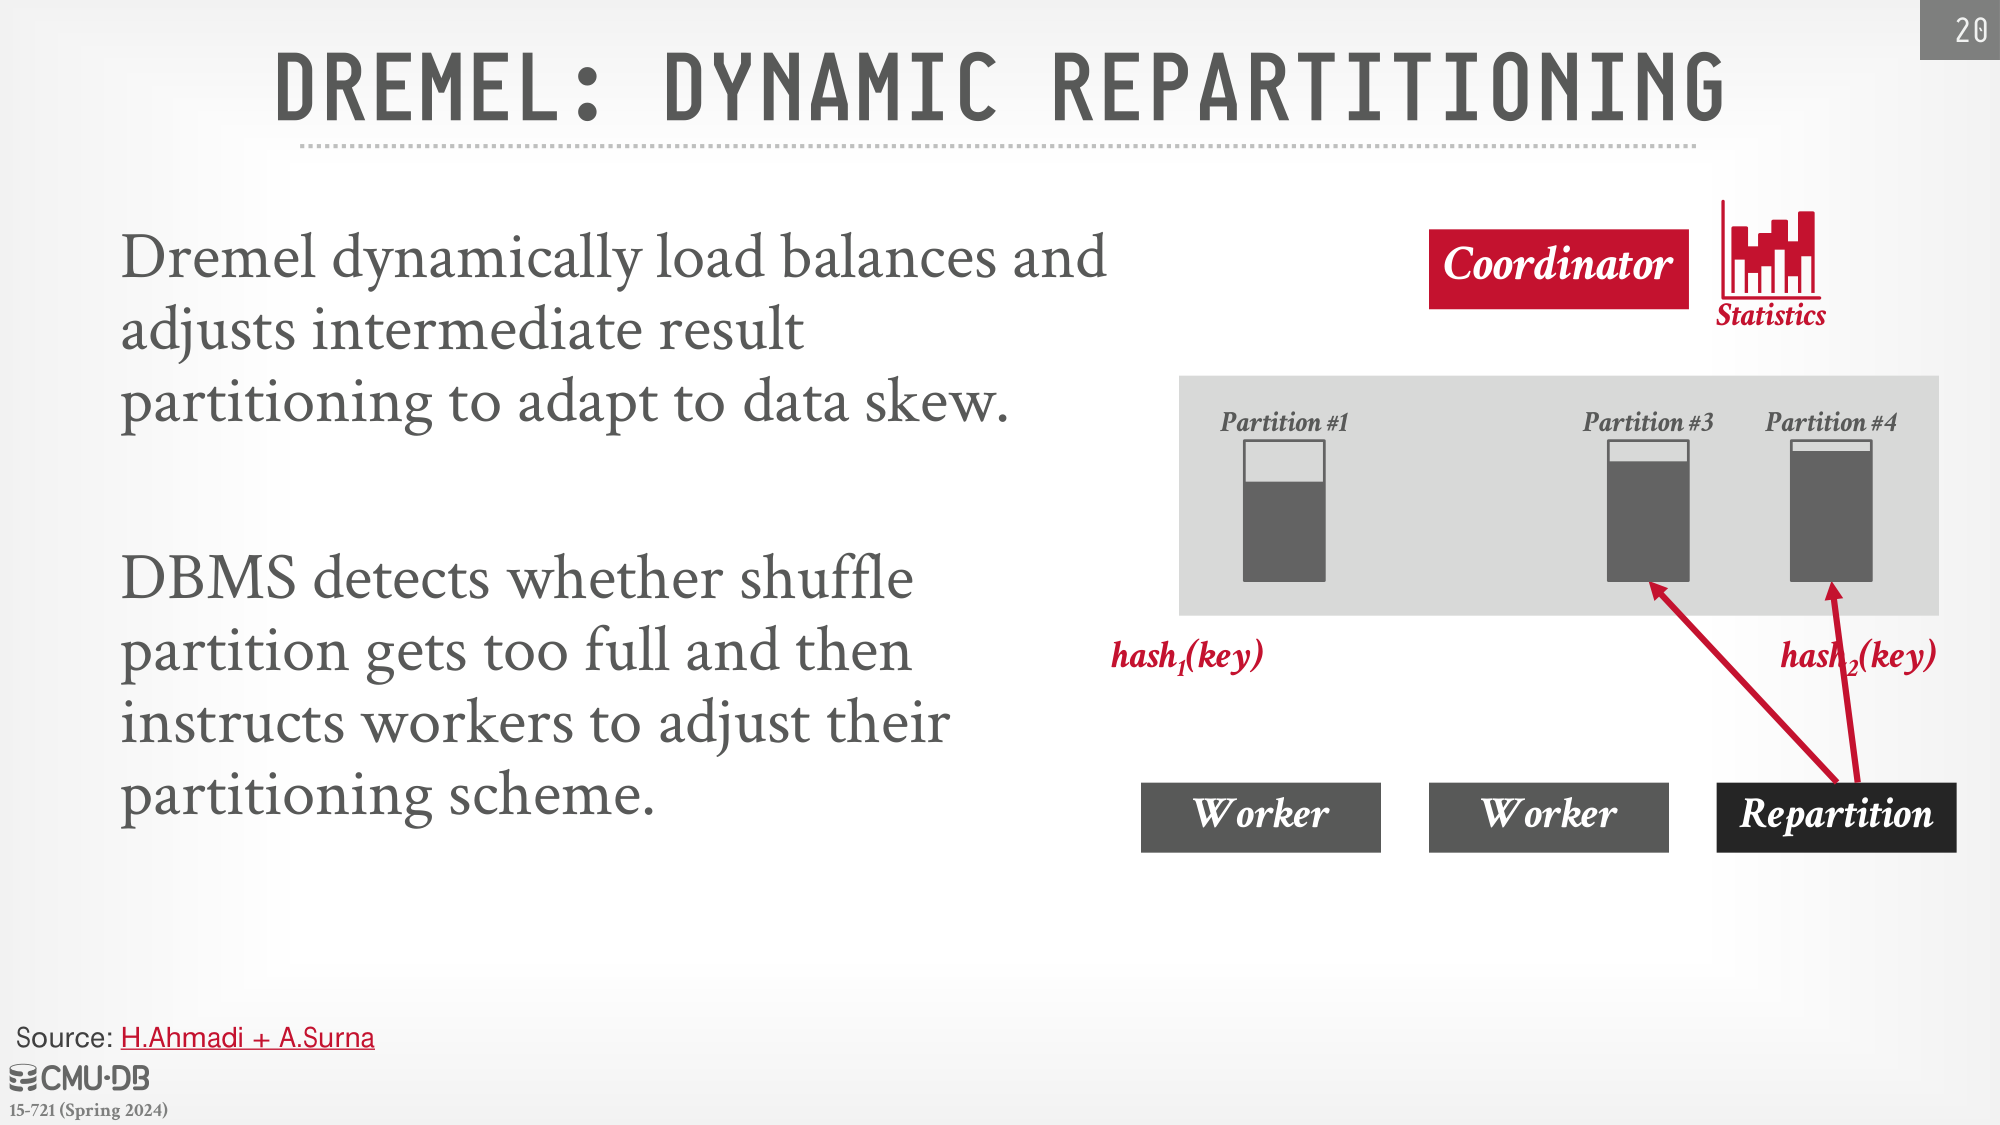
数据倾斜还可能让某些分区过大。动态重分区将其继续拆开,避免一个分区决定整个 Stage 的完成时间。这与前面 Morsel 调度一样,都在用更细的可调任务缓解不均衡,但跨网络调整还要支付传输与状态管理成本。
与其他系统的联系
课程继续讨论 Drill、Presto、Impala、Dremio 和 Celeborn 等相关系统。它们在执行位置、内存表示、缓存与 Shuffle 服务上各有选择,不能因为都支持数据湖查询,就假定内部使用相同架构。
Dremel 的例子把几个反复出现的主题连接起来:开放数据与不完整统计要求自适应;独立资源层提供弹性;阶段与中间结果边界则为调度、失败恢复和重新优化提供实施位置。