课程视频
把分析引擎放到应用进程中
DuckDB 面向数据分析提供嵌入式 SQL 引擎,在应用进程内运行。课程从 MonetDBLite 的经验进入:数据科学程序并不总需要单独部署一个服务,通过网络搬运数据的成本也可能高于本地计算。
进程内执行让应用和数据库更容易共享数据表示。DuckDB 可以通过 Arrow 等接口交换结果,也可以读取多种外部文件;“嵌入式”描述部署与调用方式,并不意味着执行只能使用一个线程。
为什么从 Pull 转向 Push
课程介绍,DuckDB 早期使用 Pull-Based 批量执行,之后为更复杂的并行和调度需求转向 Push-Based。运算符按自身能力决定能否并行,流水线之间保留明确的依赖与状态。
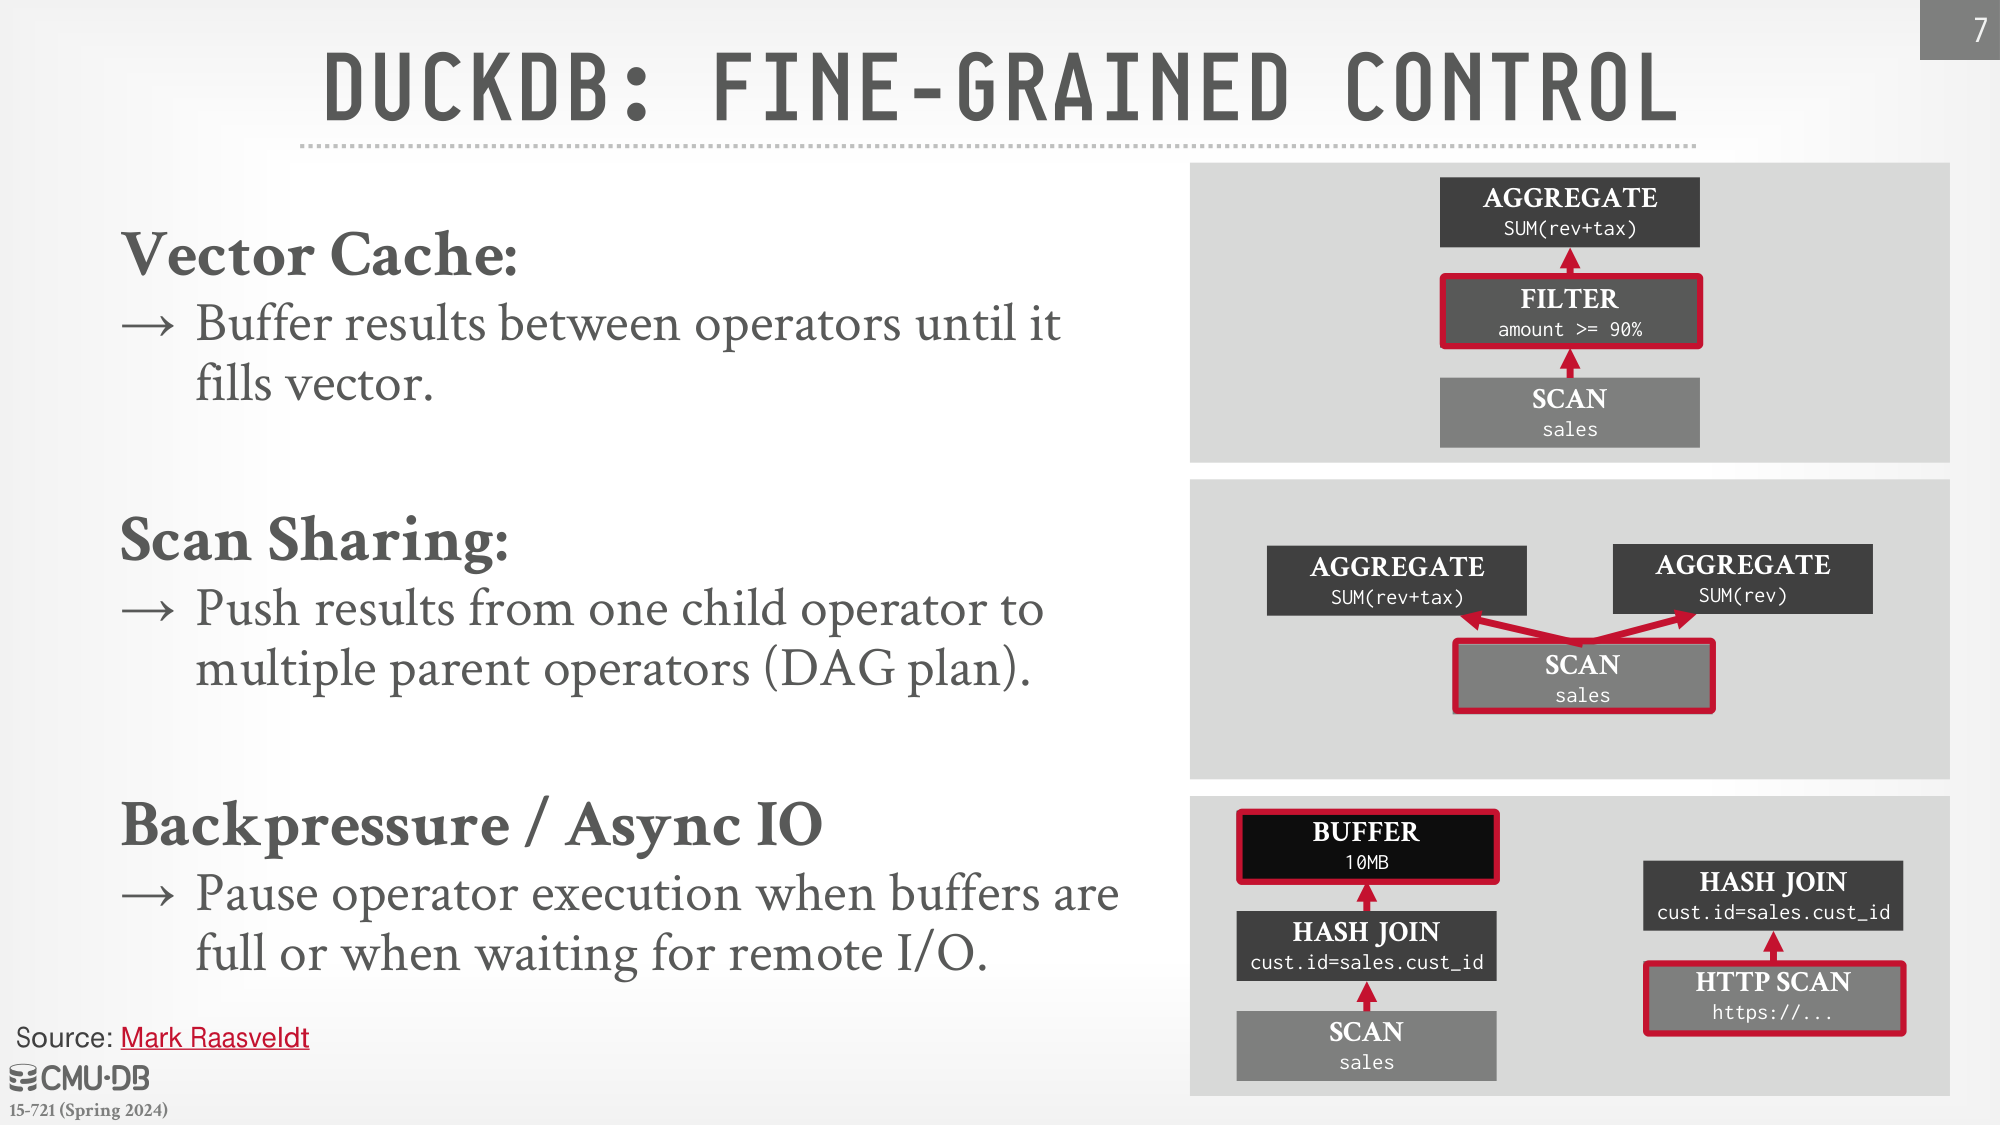
执行器可以缓存过滤后留下的记录,积累成较满的向量;同一份扫描结果可以交给多个父节点;下游缓冲已满或等待远程 I/O 时,上游可以暂停。Push 的价值在于提供这些控制位置,而不只改变函数调用方向。
不同向量表示怎样共用运算符
普通数组、常量列、字典引用等数据,不必都先展开成完整数组再计算。不同表示可以保留各自节省空间或复制的方式,再通过统一访问接口提供给算子。
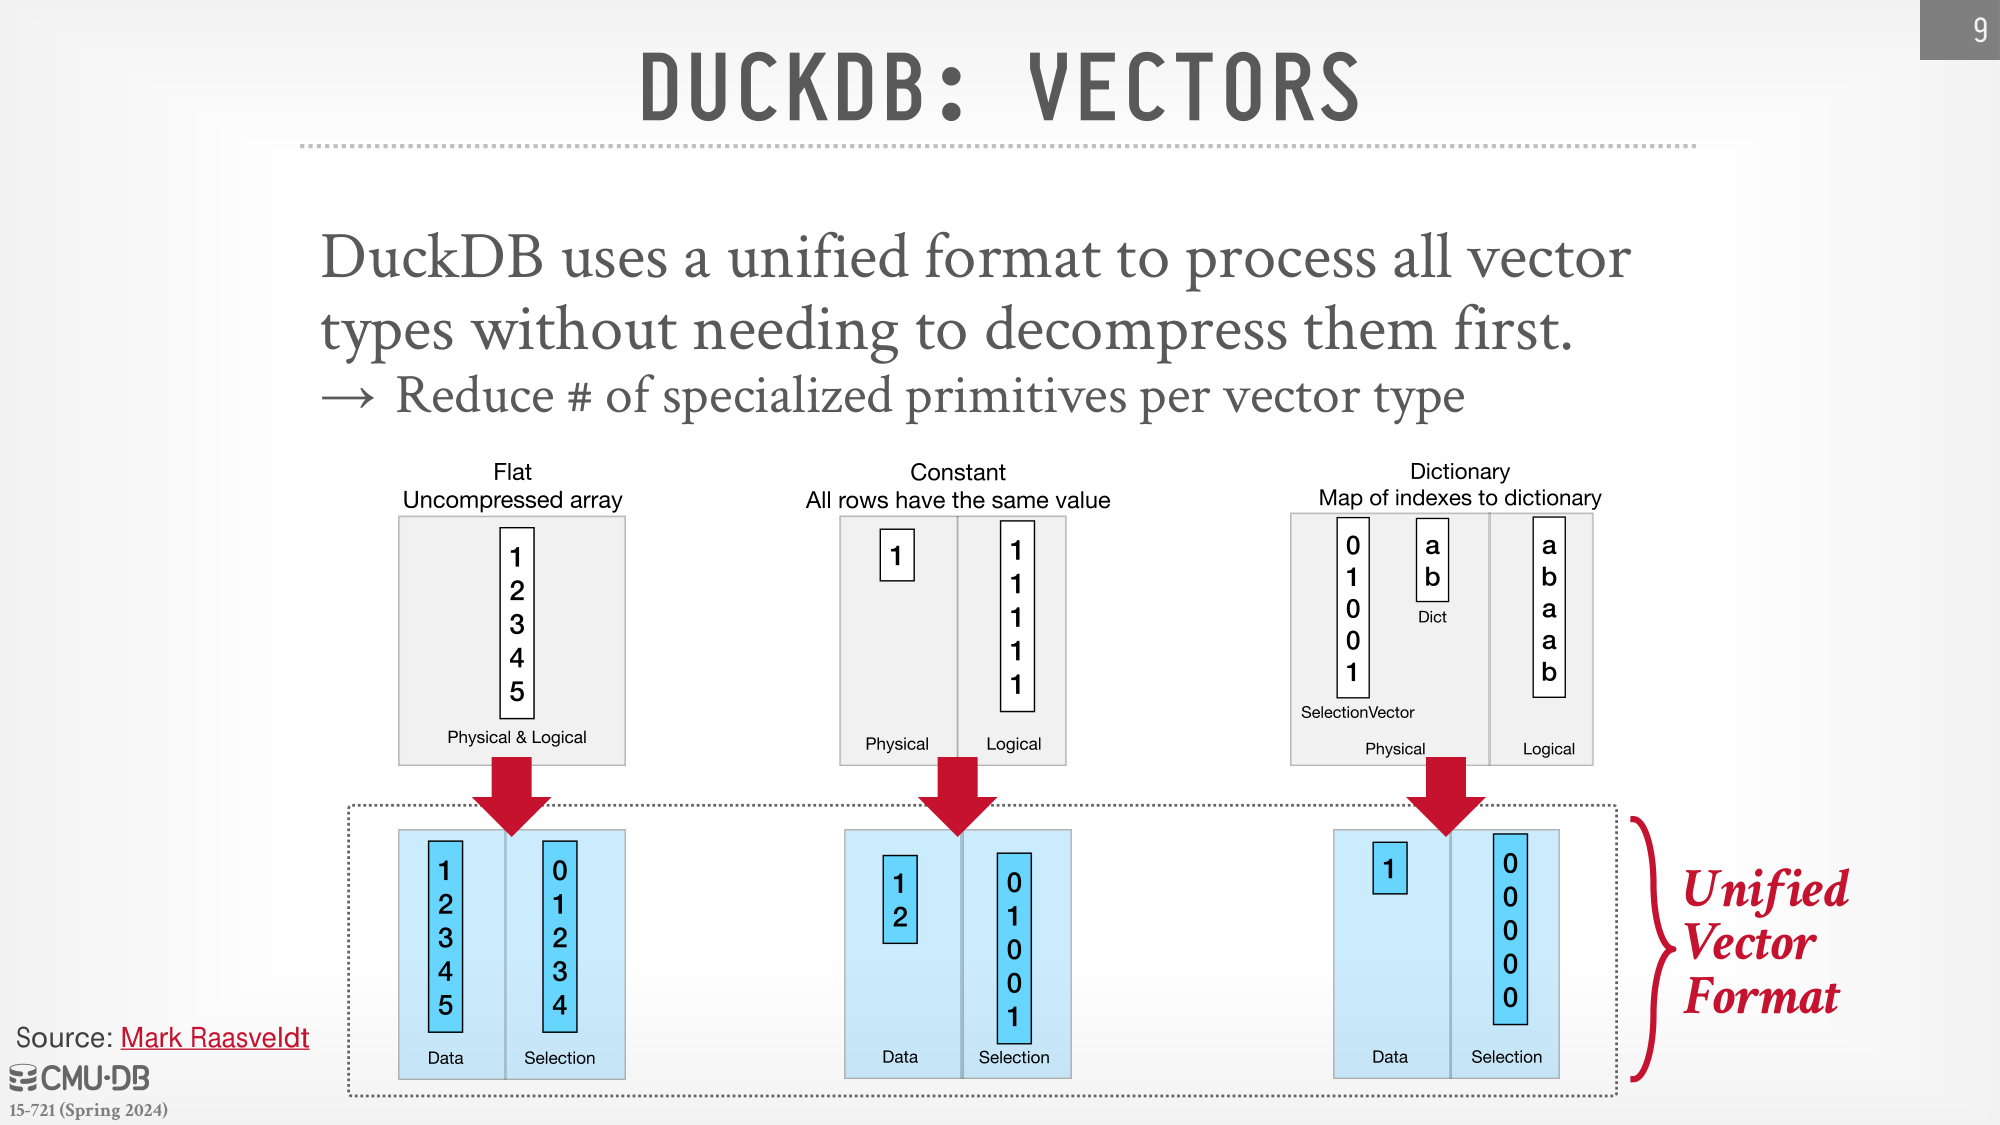
统一表示帮助减少“每一种物理向量乘以每一种操作”的内核组合数量。代价是运算符需要正确处理位置映射与有效性信息,不能忽略字典引用对应的源向量。
内部文件与外部数据
课程讨论的内部数据库文件采用 PAX 风格的行组,持久化编码与内存表示分开设计。压缩先采样分析数据特征,再选择合适编码并写入文件。
外部访问通过扩展支持 Parquet、JSON、SQLite 等来源,也可从 HTTP 和对象存储读取。一个文件可以第一次被查询,未必事先存在完整目录统计,因此优化与执行需要容忍信息缺失。
DataFrame 接口还可以直接构造逻辑计划,经优化后进入物理执行,省去把所有调用先转换为 SQL 文本的要求。数据入口不同,后面的关系优化与执行组件仍可复用。
MotherDuck 怎样连接本地与云端
MotherDuck 将远程目录和云端 DuckDB 实例接入本地使用方式。优化器依据数据位置和成本判断哪些操作留在本地、哪些交给远端。
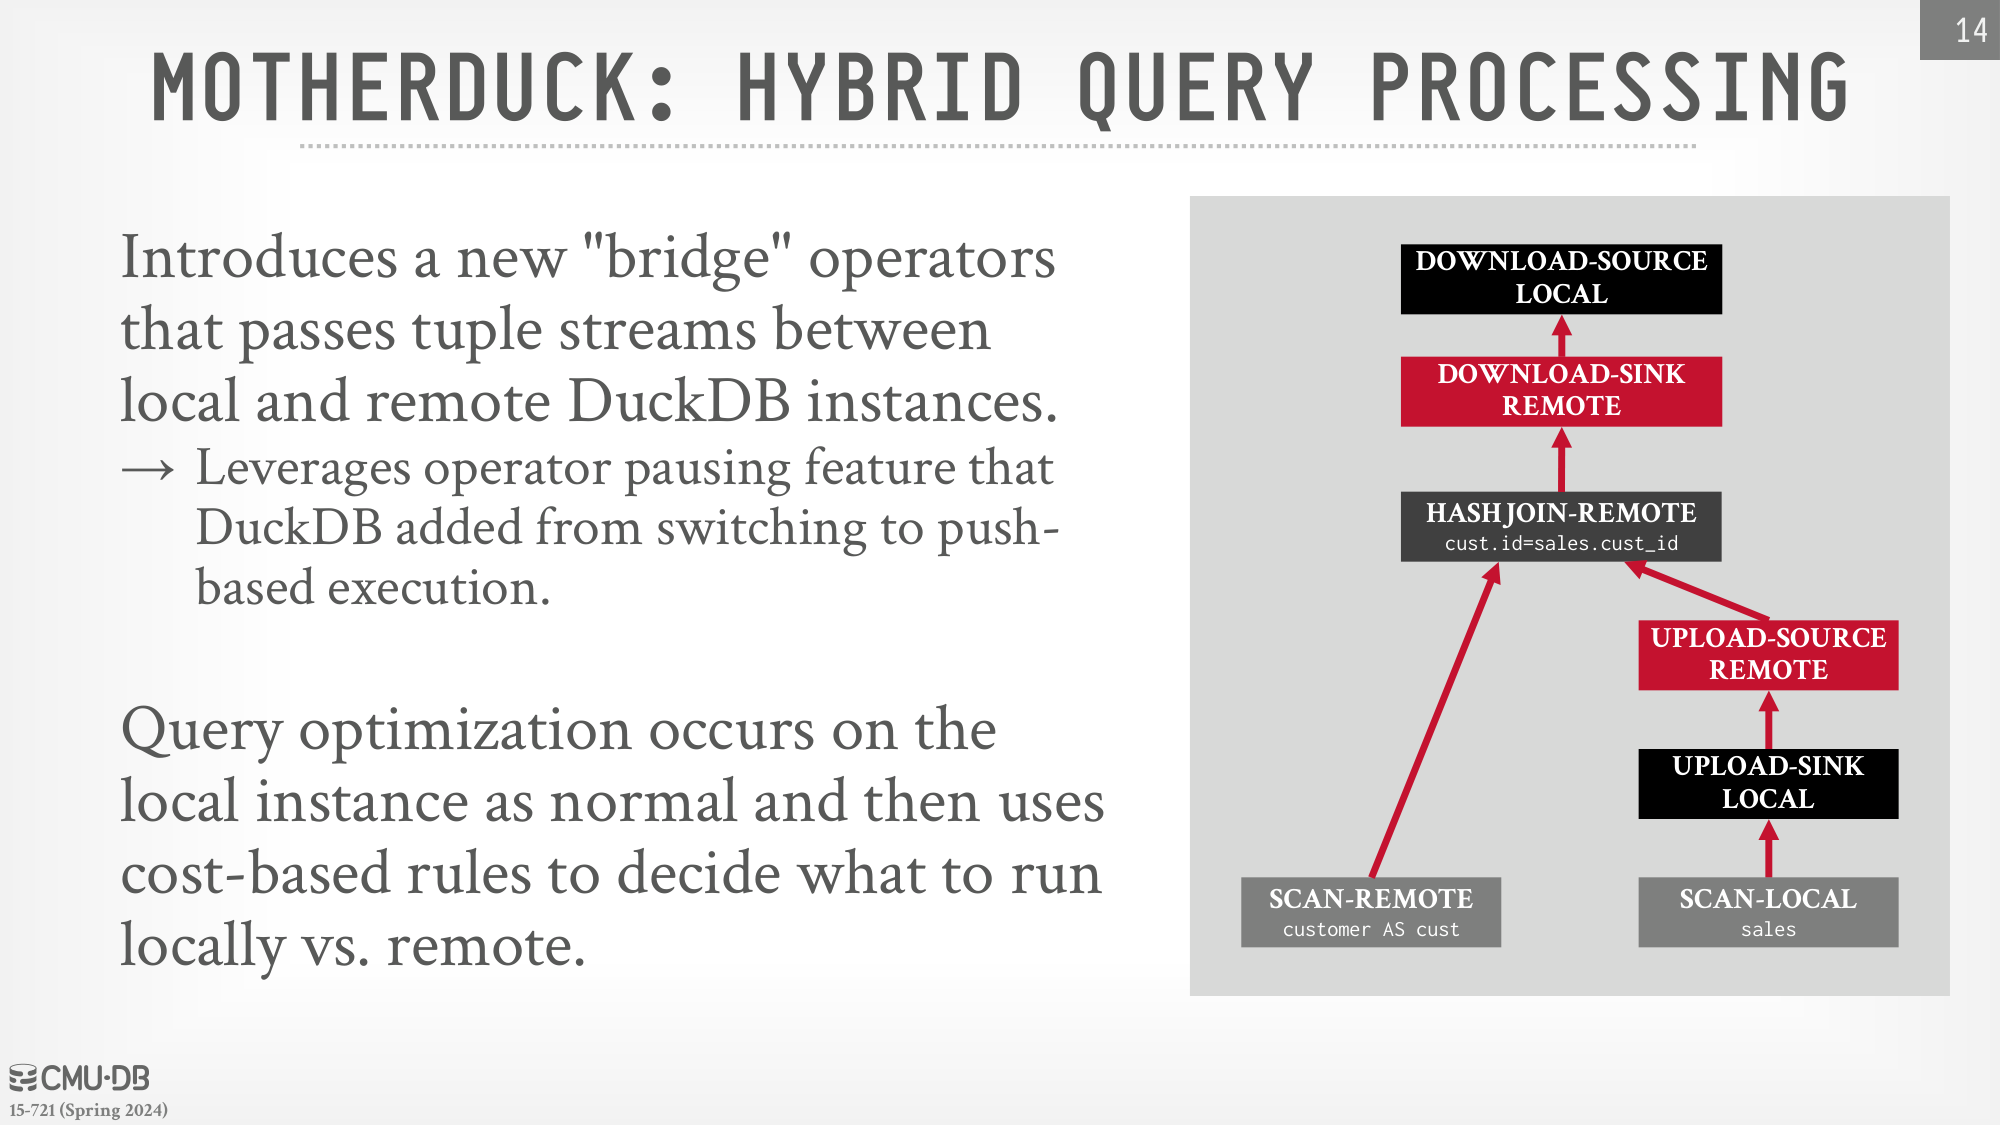
Bridge 中的上传、下载 Source/Sink 把两侧记录流连接起来。图中本地表与远程表参与同一个查询,计划需要决定移动数据还是移动计算;执行器的暂停与反压能力则帮助协调两边速度。
因此,本地分析与云端分析可以形成连续的执行路径。理解这个设计时,需要同时看数据驻留位置、跨网络流量与本地资源,不能把进程内执行的低成本直接套用到所有远程操作。