课程视频
两表连接的局部最优仍可能产生大结果
上一讲把两个输入连接得更快,这一讲先提出另一个问题:如果任意两个输入连接后都会生成很大的中间结果,而第三个输入又能排除其中大部分数据,继续优化两表连接是否足够?
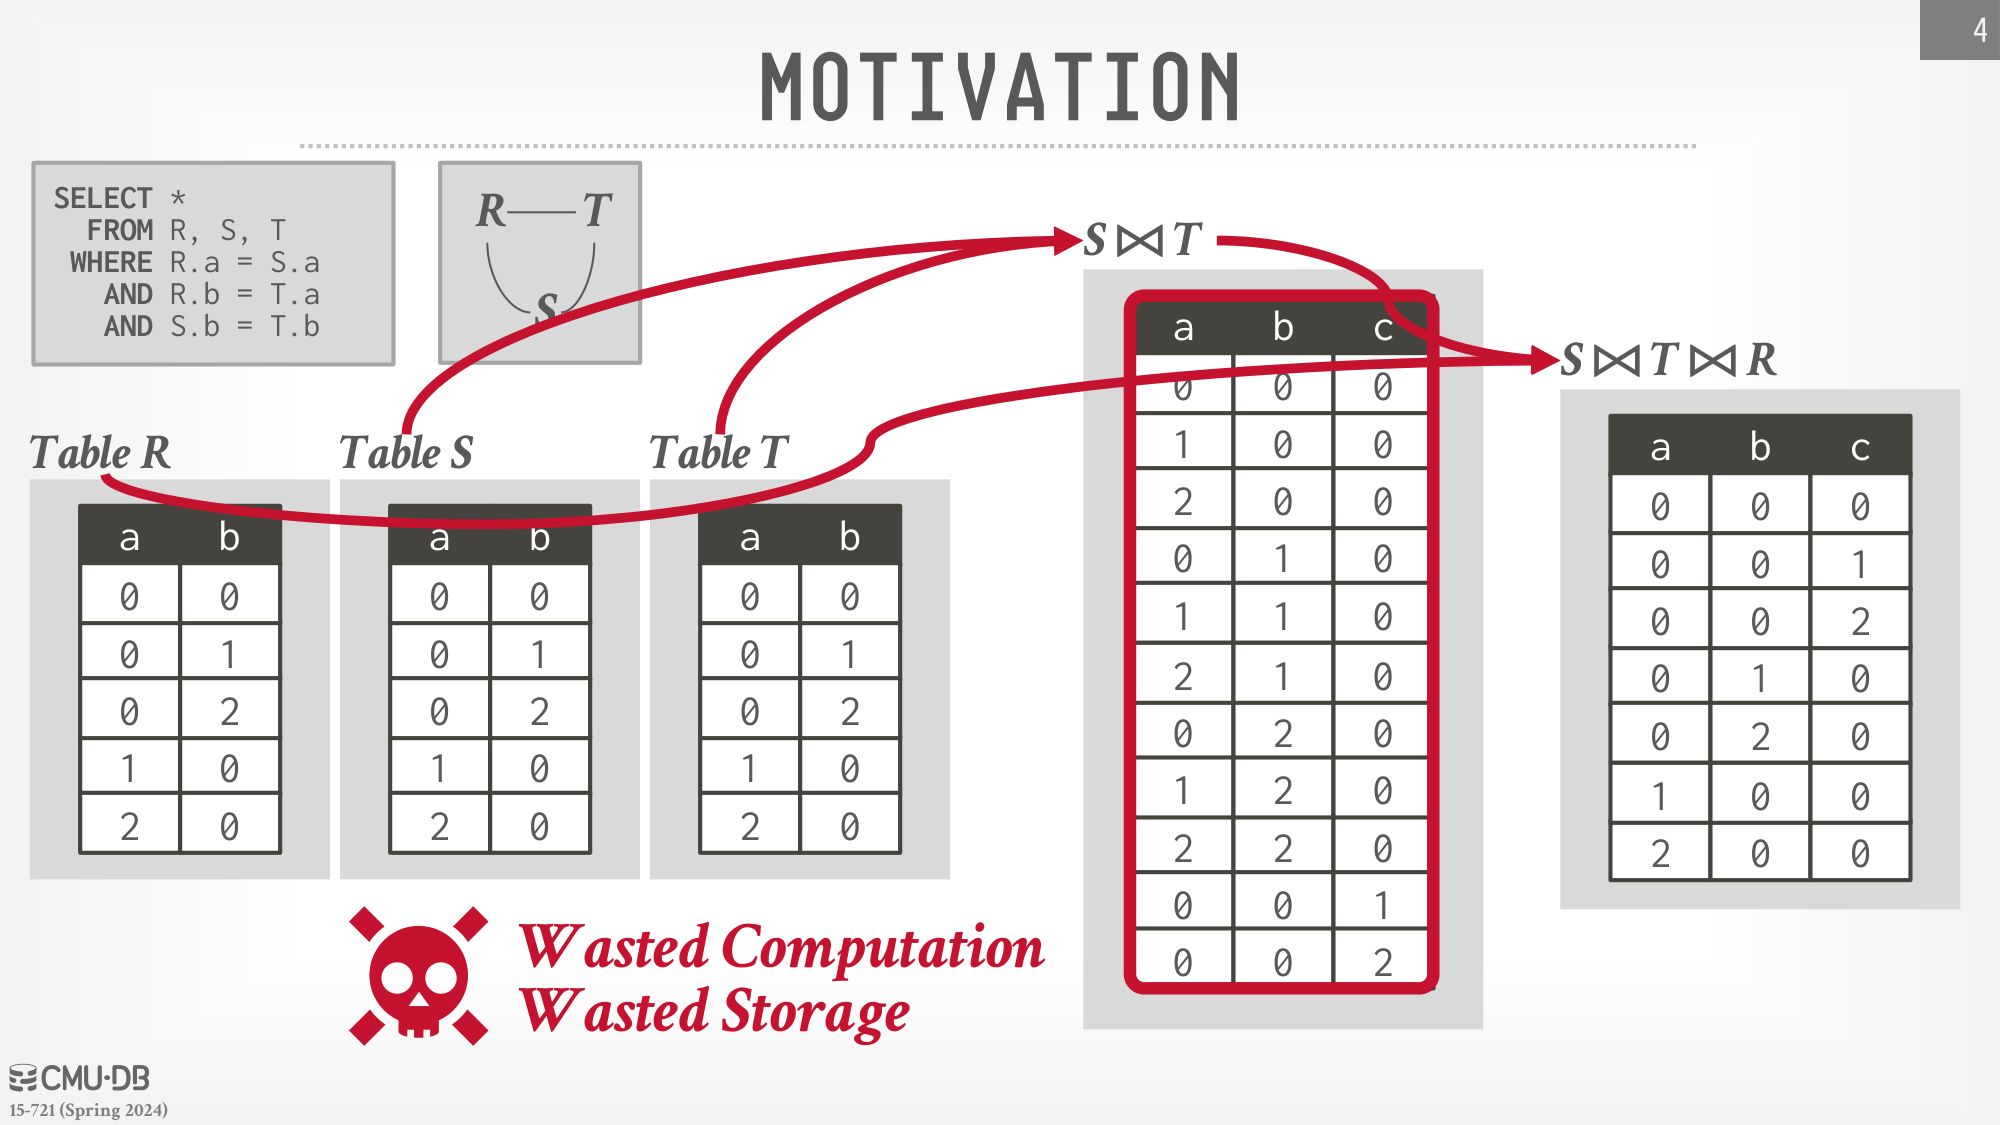
课件用三张两列关系构成环状约束。按任意一个两表顺序先执行,都可能生成最终结果不需要的组合。多路连接把多个关系一起考虑,尽早用其他关系约束候选值,避免先完整构造这些组合。
“最坏情况最优”指什么
WCOJ(Worst-Case Optimal Join)按变量而不是按整张关系逐步求交。先选择第一个连接变量的共同取值,再在已有前缀下寻找下一个变量,直到得到满足全部约束的记录。
这里的最优性讨论有明确理论范围。补充说明:它针对给定输入规模约束下的最坏情况界;Leapfrog Triejoin 的论文给出相差对数因子的最坏情况最优保证。不能把它理解为每个数据集都比所有二元连接快,也不能把运行时间简单等同于当前实例实际输出的行数。
Leapfrog 怎样找到共同取值
多个有序迭代器从各自当前值出发,让较小的迭代器跳到不小于当前最大值的位置。课件的示例中,各迭代器不断追赶,最终都停到 8,于是找到一个共同值,再继续寻找下一个。
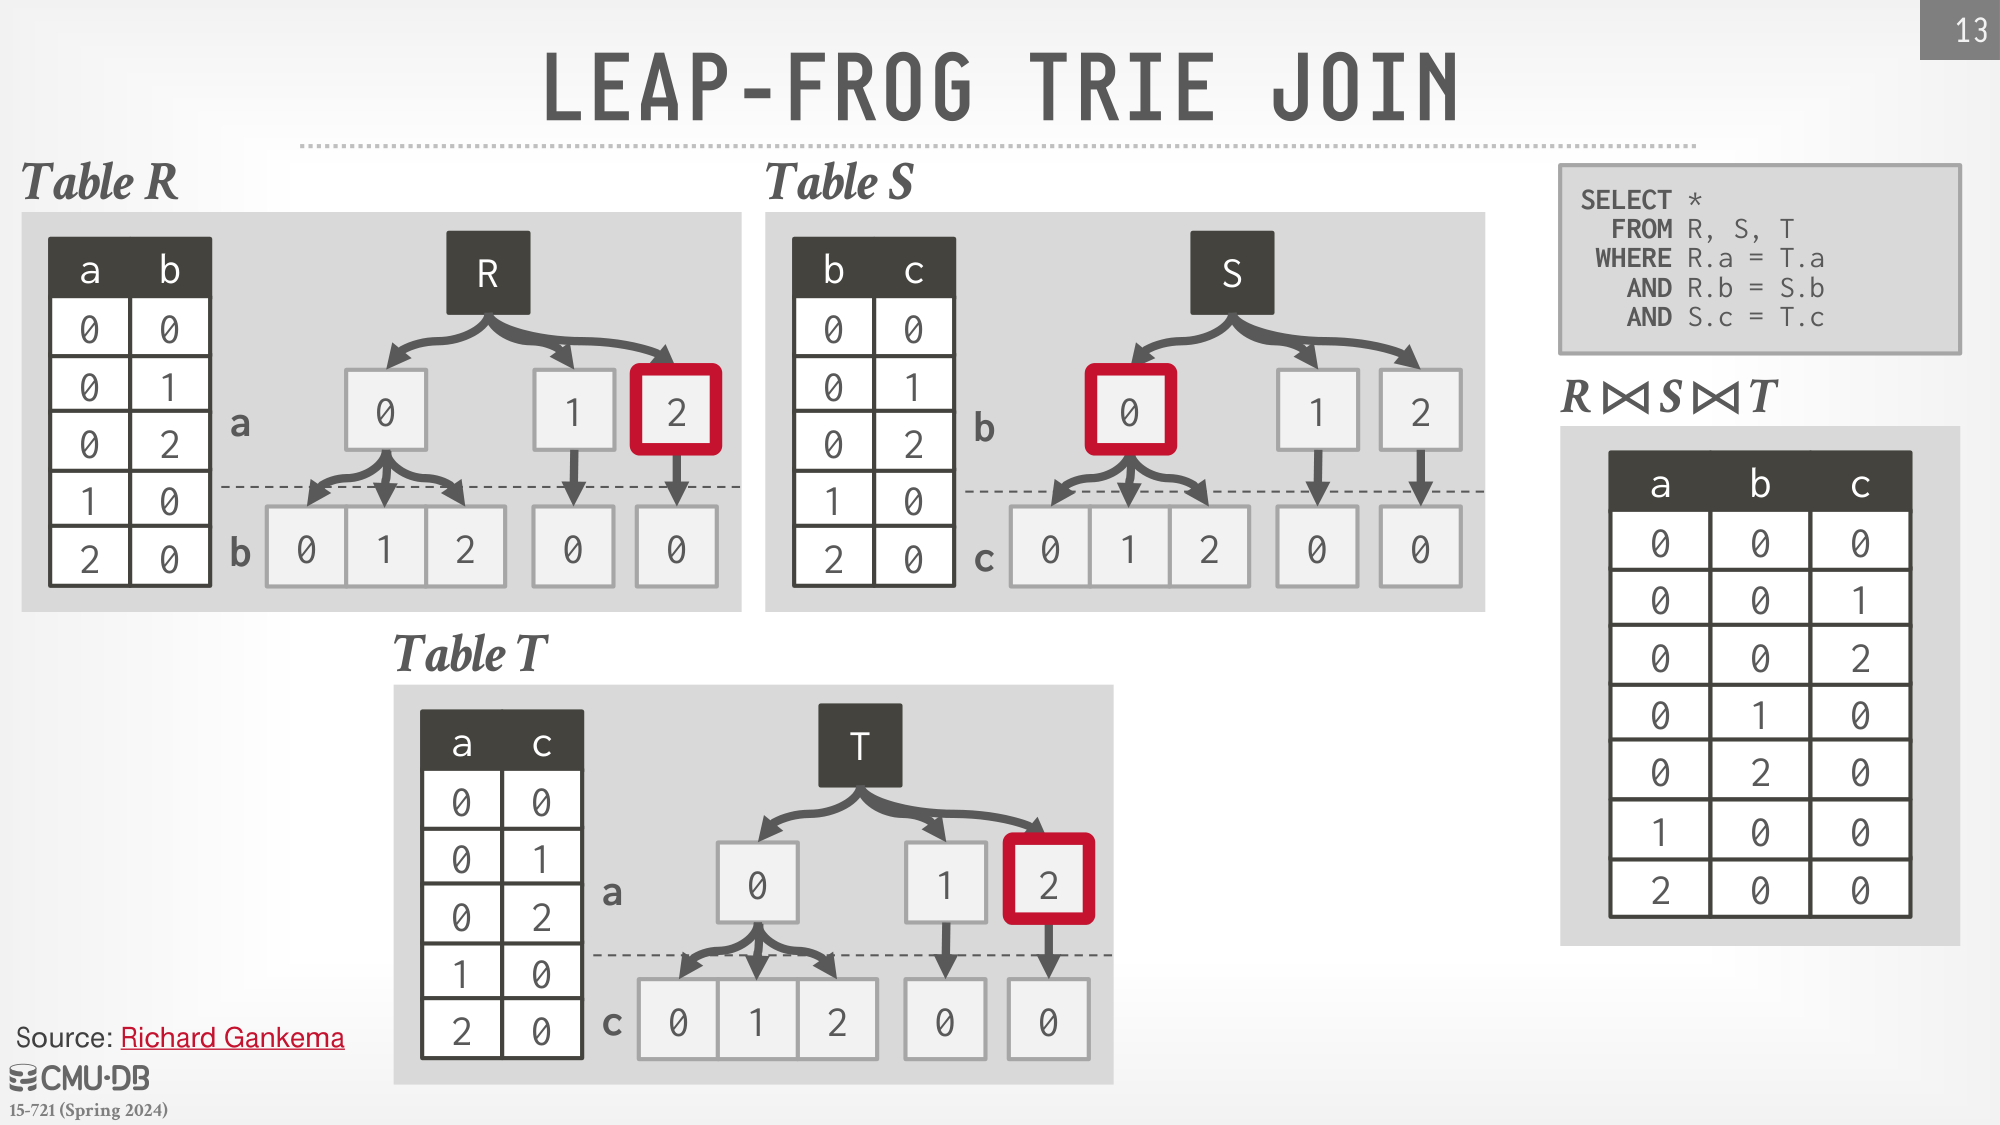
Trie 把每个连接属性放在不同层。对于 R(a,b)、S(b,c) 和 T(a,c),可以先在含 a 的关系之间确定 a,再根据这个前缀寻找 b,最后寻找 c。不同关系的 Trie 必须遵循相容的全局变量顺序。
这种结构让执行器在前缀层面排除不可能的组合,但建树本身也有成本。查询需要的变量顺序改变时,既有 Trie 未必能直接复用,不能为所有属性排列都无代价地提前建立结构。
Hash Trie 如何减少结构维护
Hash Trie 将节点实现成哈希结构,通过哈希值寻找子节点或记录,再在最终匹配时处理哈希冲突。这样可以统一不同类型的查找逻辑,但哈希相等仍不能直接证明原始键相等。
Singleton Pruning 对只有一个后继的路径省去不必要节点,直接指向后续记录。Lazy Child Expansion 则先建立根结构,只有探测真正访问到某个分支时才展开其子节点。
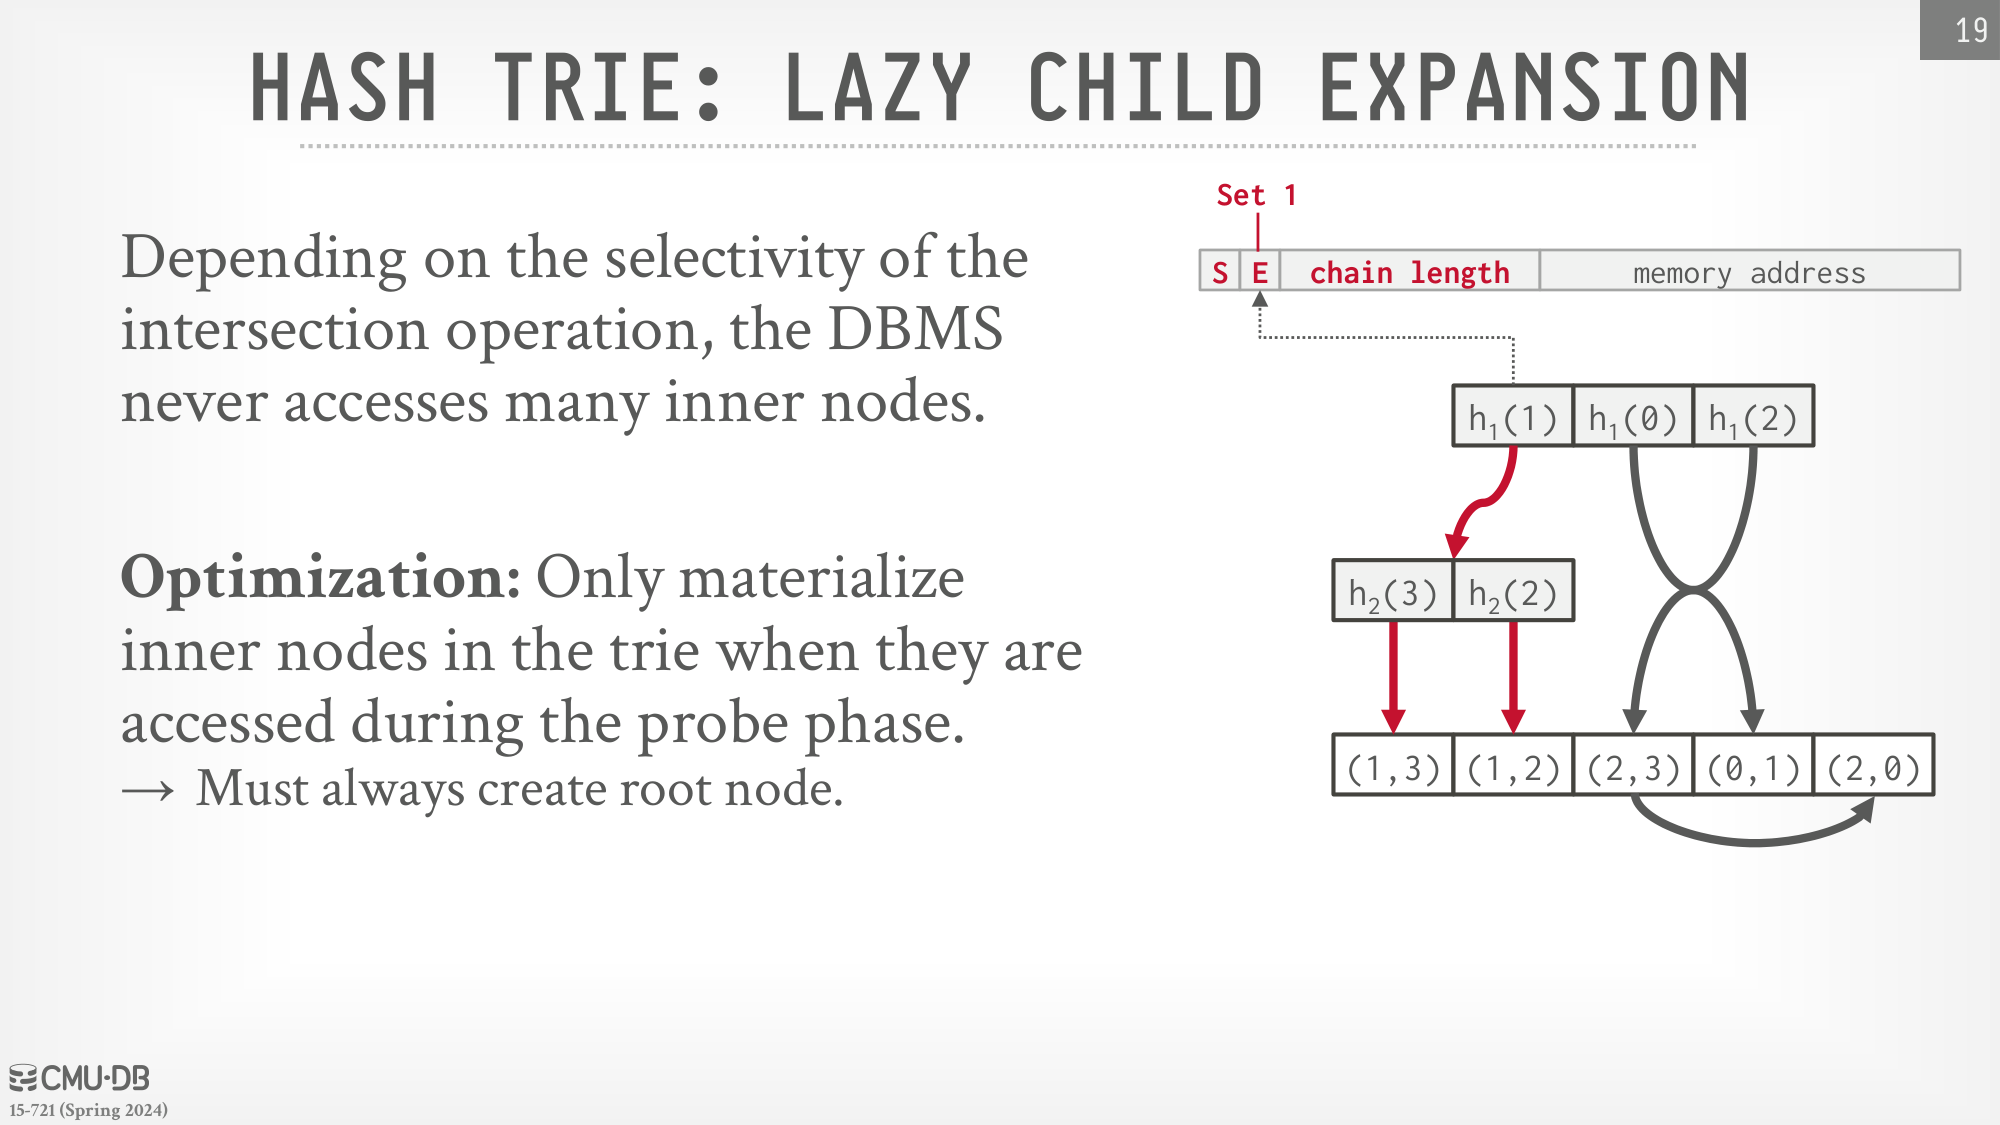
如果前缀求交已经排除了大量分支,就可以避免为这些分支建完所有层。课件还介绍利用指针中可用位保存标记和链长度的实现技巧;这种方式依赖目标机器的地址与指针约定,不能无条件移植。
二元连接与多路连接需要共同选择
当二元连接能快速缩小输入时,它可能比维护多路结构更划算。课程中的集成方案通过优化器选择适合的连接方式,而不是把所有连接统一替换成 WCOJ。
Factorization 从另一方向减少结果规模:重复记录只保存一份,并附带出现次数。后续算子必须理解这种表示,在聚合和输出时正确处理重复次数,否则会改变 SQL 的多重集语义。
课程补充:怎样定位性能热点
本讲课件末尾还包含数据库性能分析。随机暂停程序并观察调用栈,可以粗略判断时间花在哪里;采样次数增加后,统计更有代表性。Valgrind 的 Callgrind 通过插桩收集调用信息,Linux perf 则可以使用硬件计数器采样。
1 | perf record -e cycles:u -c 2000 ./relwithdebinfo/slot_iterator_benchmark |
课件用 Amdahl 定律说明局部优化的上限:若某函数原来占总时间 60%,把它加速两倍,整体加速比为 1 / (0.6 / 2 + 0.4),约为 1.43 倍。判断某个连接算法的优化价值,也需要先确认它在完整负载中占多少时间。