
课程视频
批处理怎样利用 SIMD
向量化执行先把多条记录放到同一批次,SIMD(Single Instruction, Multiple Data)进一步让一条指令对多个数据执行相同操作。批次是执行器的接口粒度,SIMD 寄存器则是 CPU 的计算粒度,两者大小不必相同。
Vertical Vectorization 在不同 Lane 中处理不同输入,适合逐元素比较与算术;Horizontal Vectorization 在同一向量的元素之间做归约等计算。课程希望尽量让 Lane 执行有用工作,并让数据在寄存器中停留足够久,减少来回搬运。
自动向量化、提示与 Intrinsics
编译器可以把合适的循环自动向量化,但需要证明迭代之间没有不允许的依赖。数组指针可能别名时,看似简单的加法循环也未必满足这个条件。
开发者可以通过 restrict 等信息表达真实的非别名约束,或者使用编译器提示。提示是一份需要成立的承诺,错误地忽略依赖可能改变程序结果。显式 Intrinsics 提供更细的控制,也增加硬件适配与维护成本。
课件的实验比较了自动、提示和手工实现,说明编译器并不总能自动生成最佳代码。实际实现可以先保留清楚的循环,在确认热点后再补充提示或手工向量化,而不是假定所有函数都需要重写。
从基本指令组合数据库操作
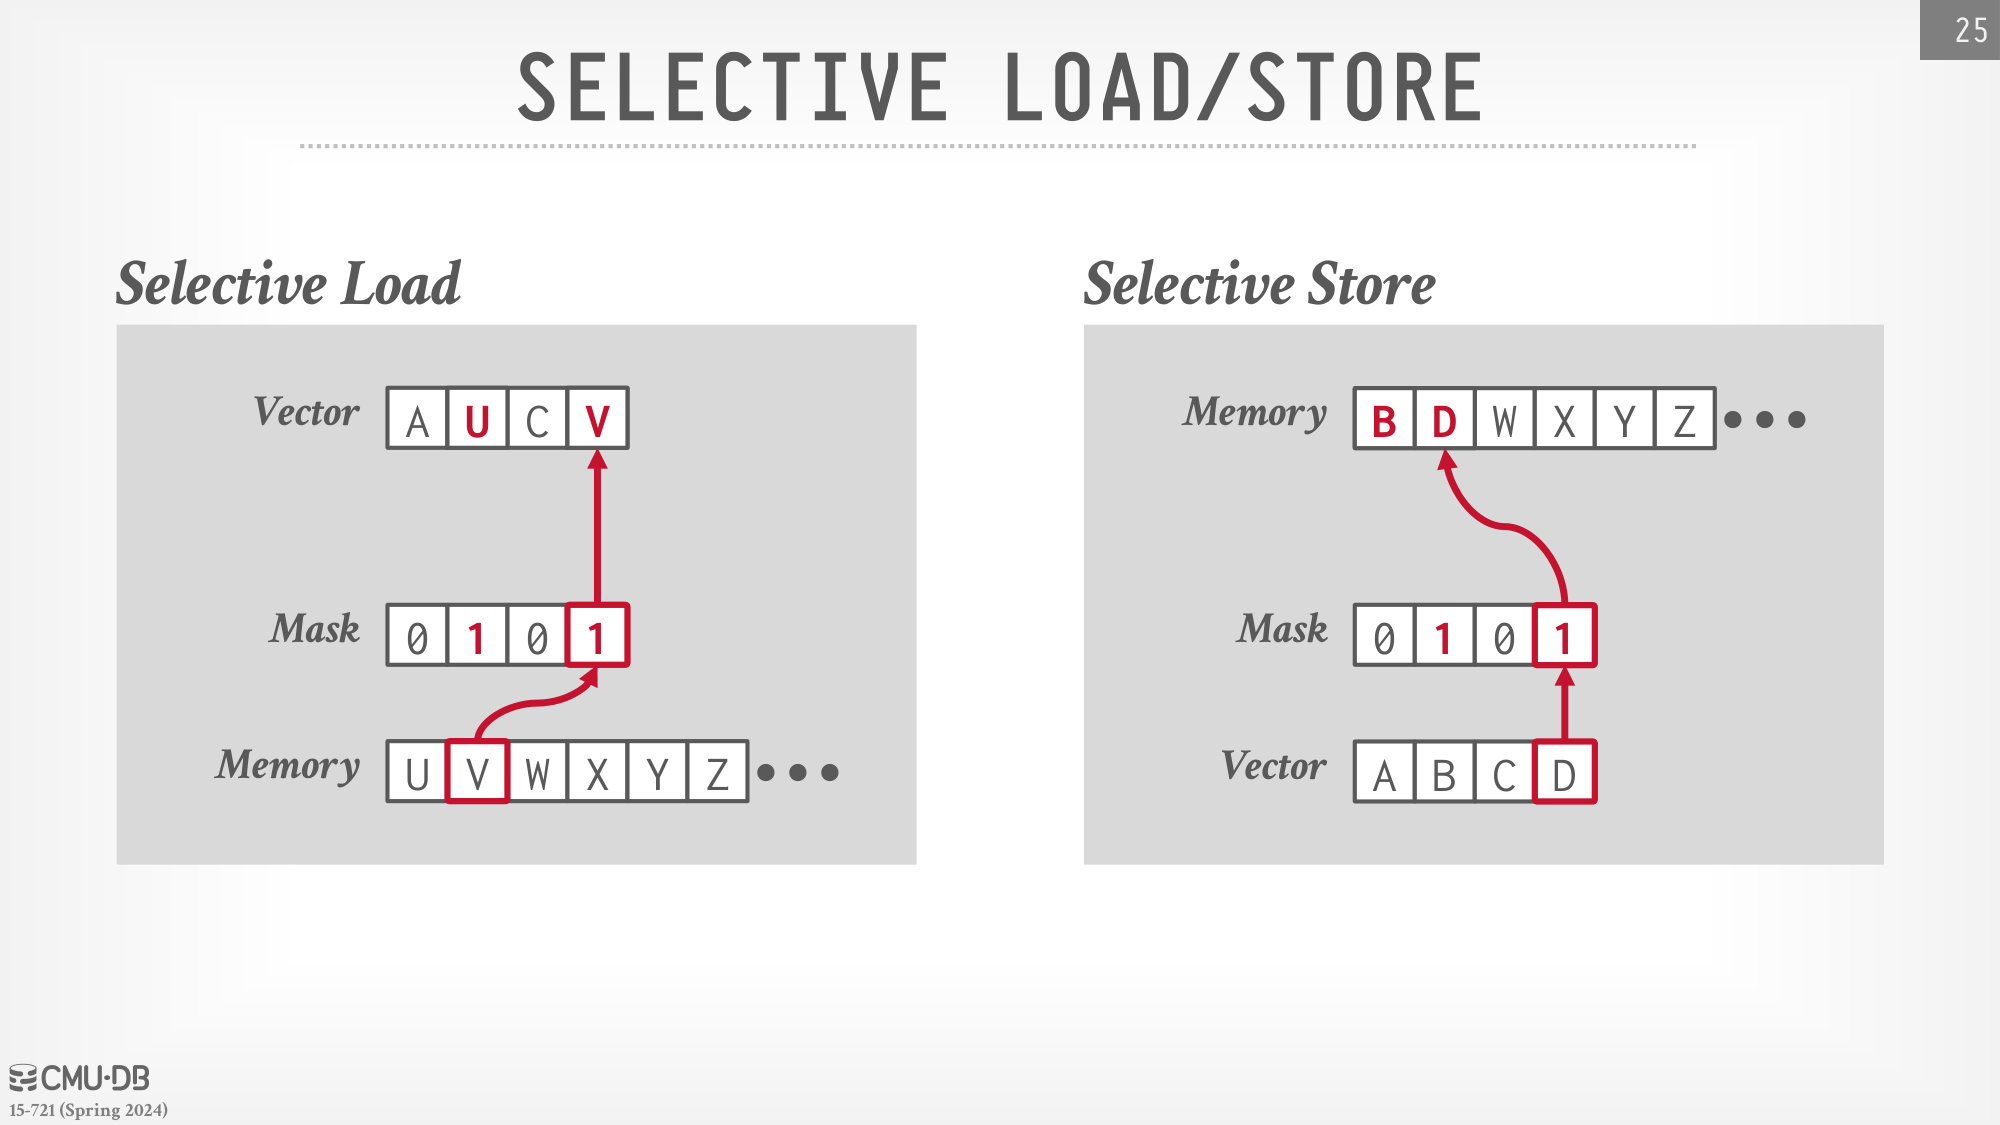
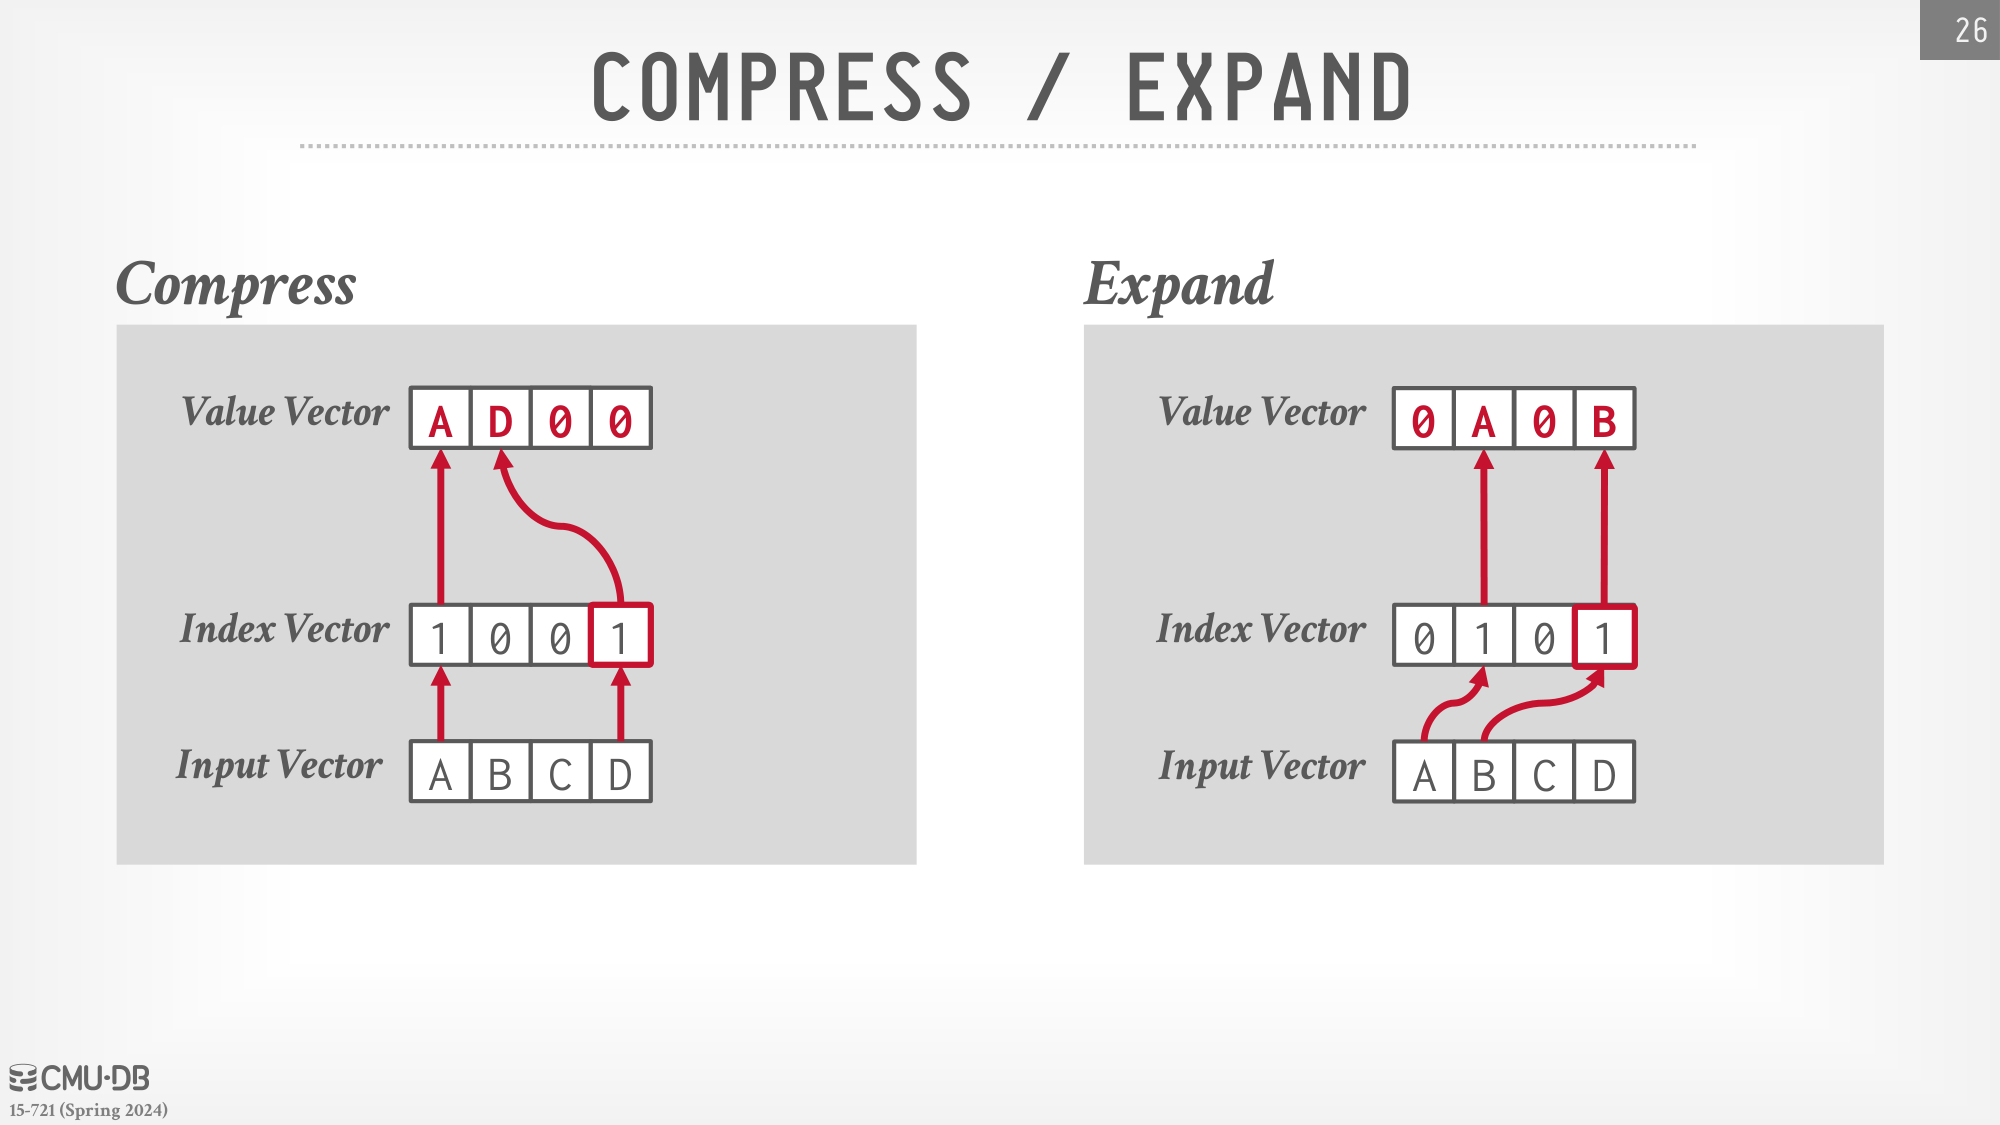
Masking 用位掩码决定哪些 Lane 执行计算;Permute 按索引在寄存器内部重排元素;Selective Load/Store 只加载或保存被选中的位置。Compress 把有效元素压紧,Expand 按掩码把连续元素放回指定位置。
Gather/Scatter 根据位置向量访问不连续的内存地址。它们让向量算法能够处理哈希表等结构,但访问不连续内存的延迟仍然存在,不会因为一条向量指令就变成连续读取。
选择扫描之后,怎样让 Lane 继续工作
选择扫描先加载一组键,执行比较,生成掩码,再保存满足条件的结果。经过多个谓词后,有效元素越来越少,继续让剩余阶段在空 Lane 上运行,会浪费向量资源。
Relaxed Operator Fusion(ROF)在流水线中设置有限的阶段边界,把结果先放到缓存中的缓冲区,积累到足够数量后再送入下一阶段。它保留局部融合,同时给向量压紧与软件预取留出空间。
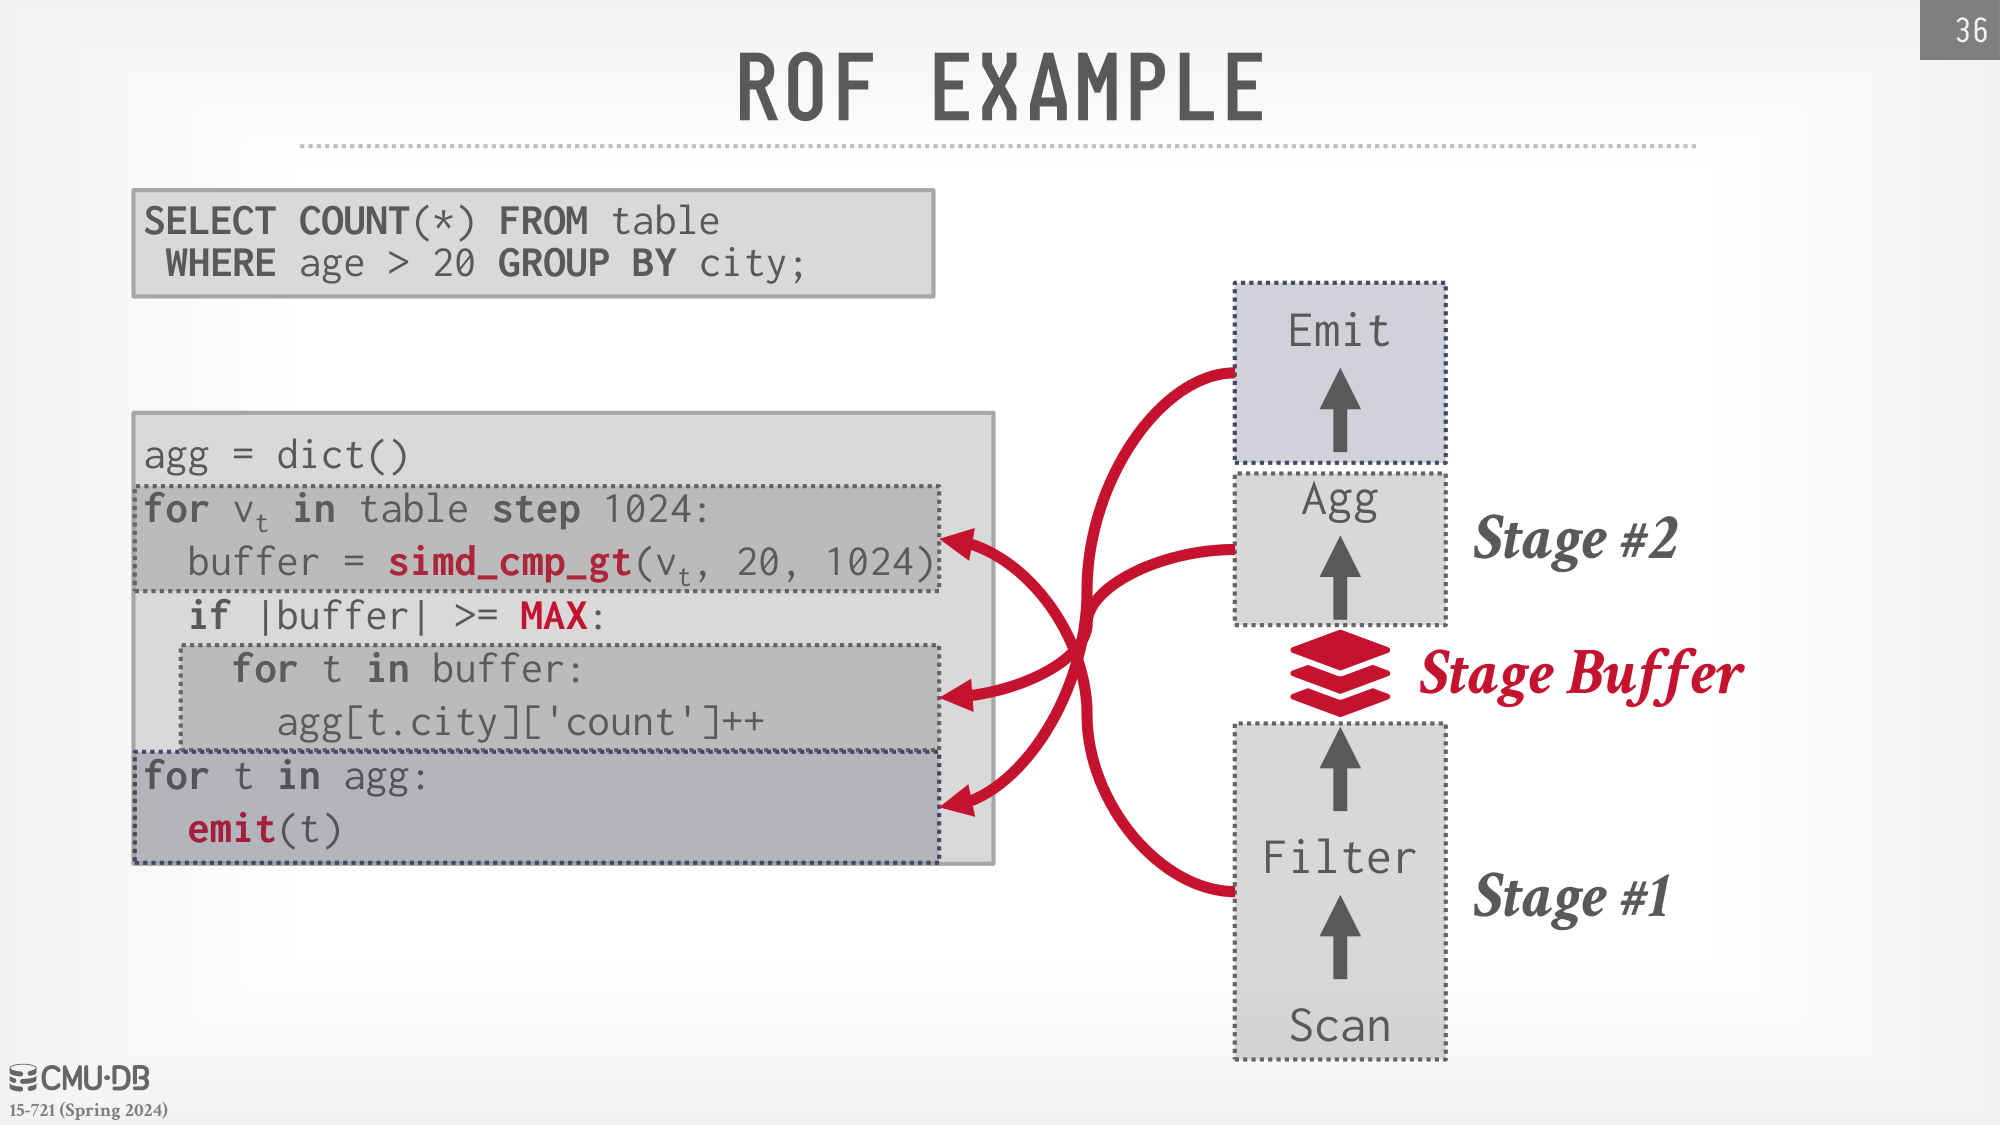
软件预取可以在当前批次计算时提前请求下一批数据。ROF 让预取点与阶段边界配合,增加请求发出与实际消费之间的距离。
另一类 Vector Refill 算法使用额外寄存器保存未满向量,再从后续输入补入元素。Buffered 方式在运算符内部积累;Partial 方式保留部分结果后回到前一个运算符继续取值。它们需要精细的状态维护,收益必须覆盖这种额外开销。
哈希探测与直方图
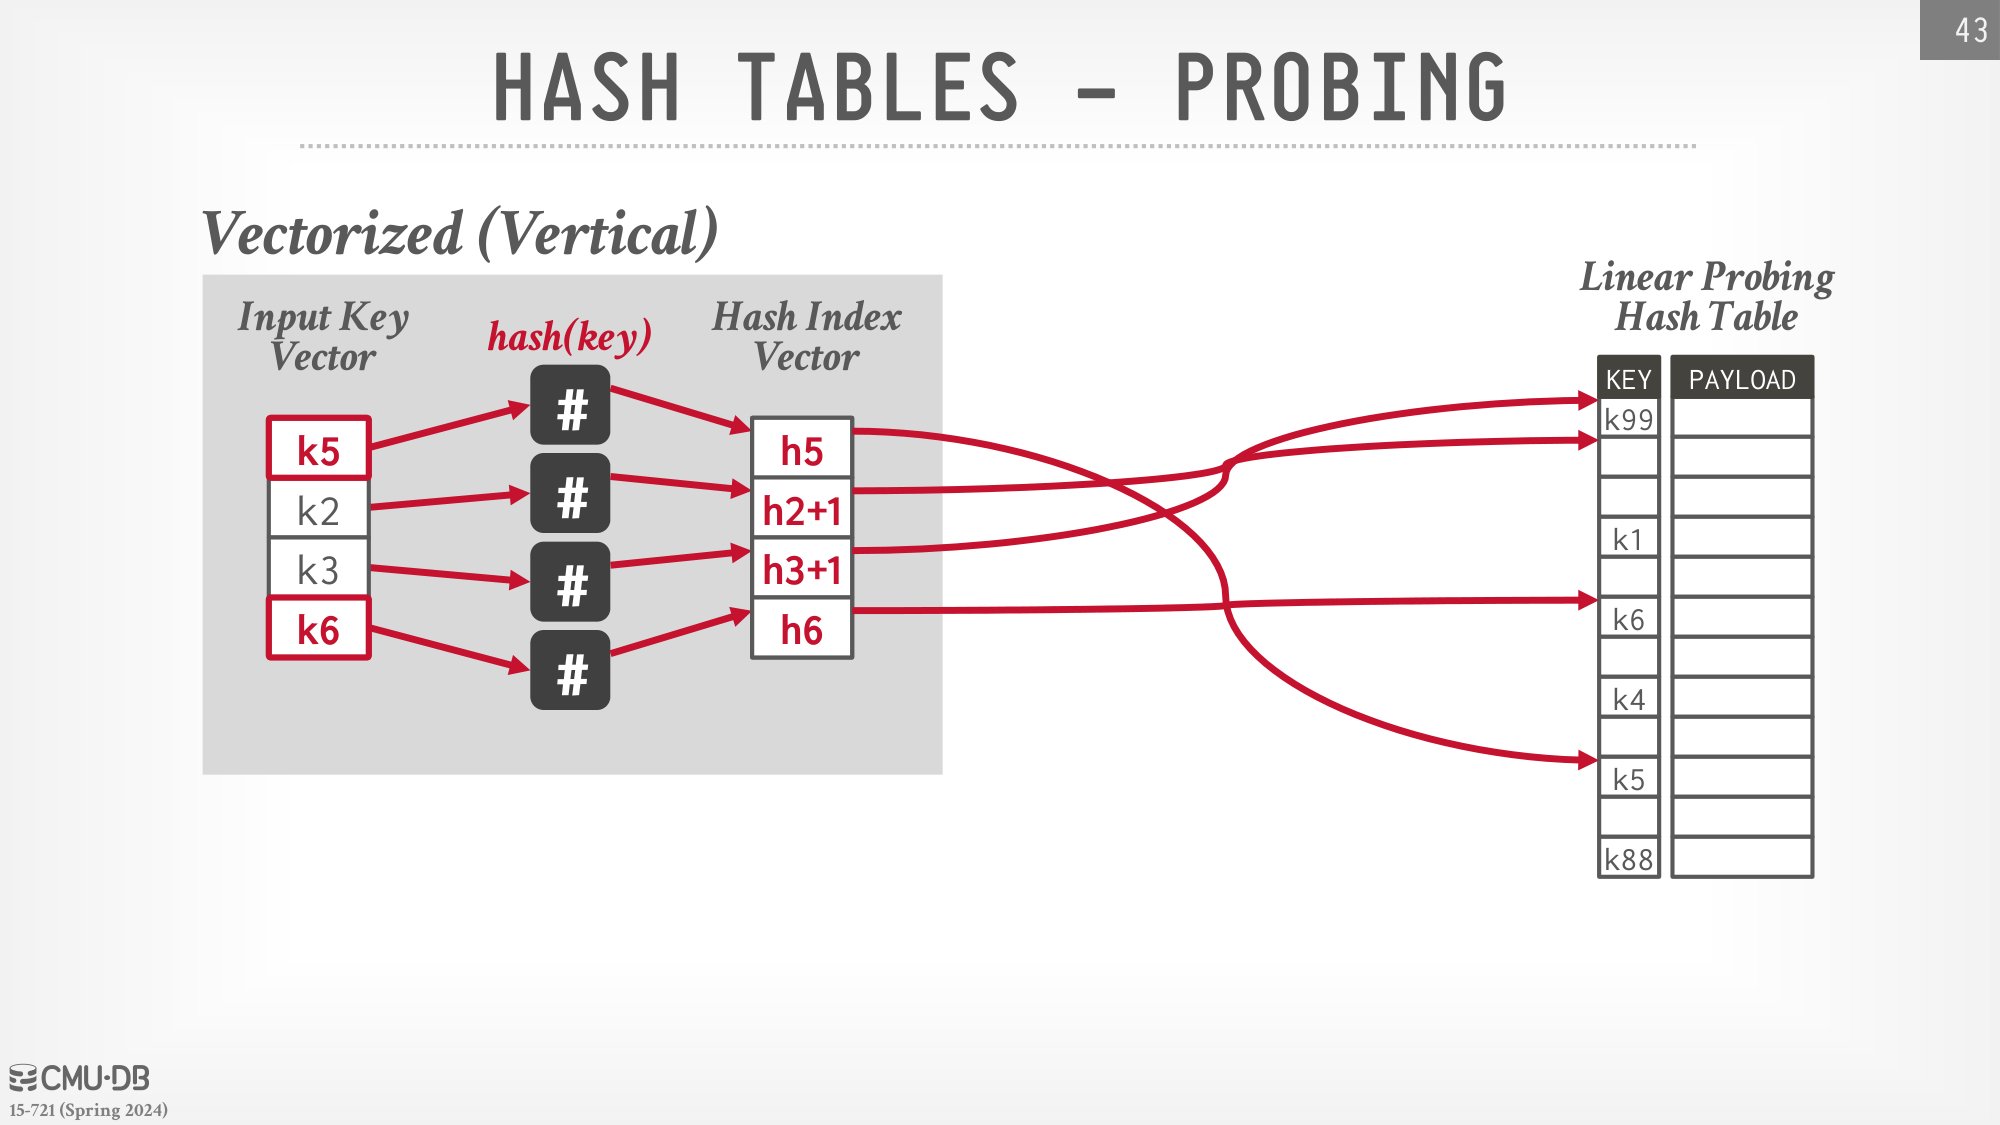
水平哈希探测把同一个键与一个桶中的多个槽位同时比较;垂直探测则让不同 Lane 负责不同键,通过 Gather 取出对应槽位。匹配完成的 Lane 可以换入新的键,其他 Lane 继续处理冲突。
当哈希表超出缓存后,随机访问可能成为主要瓶颈,向量化不一定继续保持相同收益。构建直方图时还要处理写冲突:多个 Lane 可能同时更新同一个计数器,直接 Gather、加一再 Scatter 会丢失更新。课件使用复制的局部计数结构,让 Lane 分别累积,最后再合并。
更宽的指令为什么不一定更快
课程提醒,AVX-512 的不同功能属于不同扩展集合,需要检查处理器实际支持的指令。部分处理器在特定宽向量负载下还会降低频率。
因此应比较完整查询的耗时,而不只比较某个向量循环。算子加速之后,物化、缓存未命中或未向量化的部分可能限制整体收益。课件中的硬件与实验结果属于对应论文和课程版本,不能直接当作所有机器上的性能承诺。