课程视频
计算、存储与云服务分开管理
课程采用 Snowflake 的系统论文与后续存算分离论文分析其设计。Data Storage 将持久化文件放到云对象存储;Virtual Warehouse 提供执行计算的 Worker;Cloud Services 负责协调、调度和目录等服务。
Worker 有自己的内存和本地磁盘缓存,多个 Warehouse 可以在共享持久化数据上提供不同的计算资源。扩展计算无需按同样比例扩展持久化存储,但远端读取的延迟与请求成本仍需要缓存和访问裁剪来缓解。
推送式执行与本地缓存
课程所述执行器采用 Push-Based 向量化与预编译 Primitive,Worker 之间直接传递中间数据,部分序列化与反序列化路径使用代码生成。它与上一讲 Dremel 的独立 Shuffle 层具有不同的阶段耦合方式。
文件分配结合一致性哈希,让访问同一文件的任务尽量复用相同节点缓存。节点增加后,映射只调整必要部分,减少缓存整体失效。缓存亲和与负载均衡之间仍有冲突,系统不能只把任务固定在数据较热的节点。
工作窃取与 Flexible Compute
一个 Worker 处理完自己的文件后,可以请求接手同伴尚未扫描的文件。课件中的请求方从持久化存储取数据,避免让繁忙同伴同时承担额外数据发送。
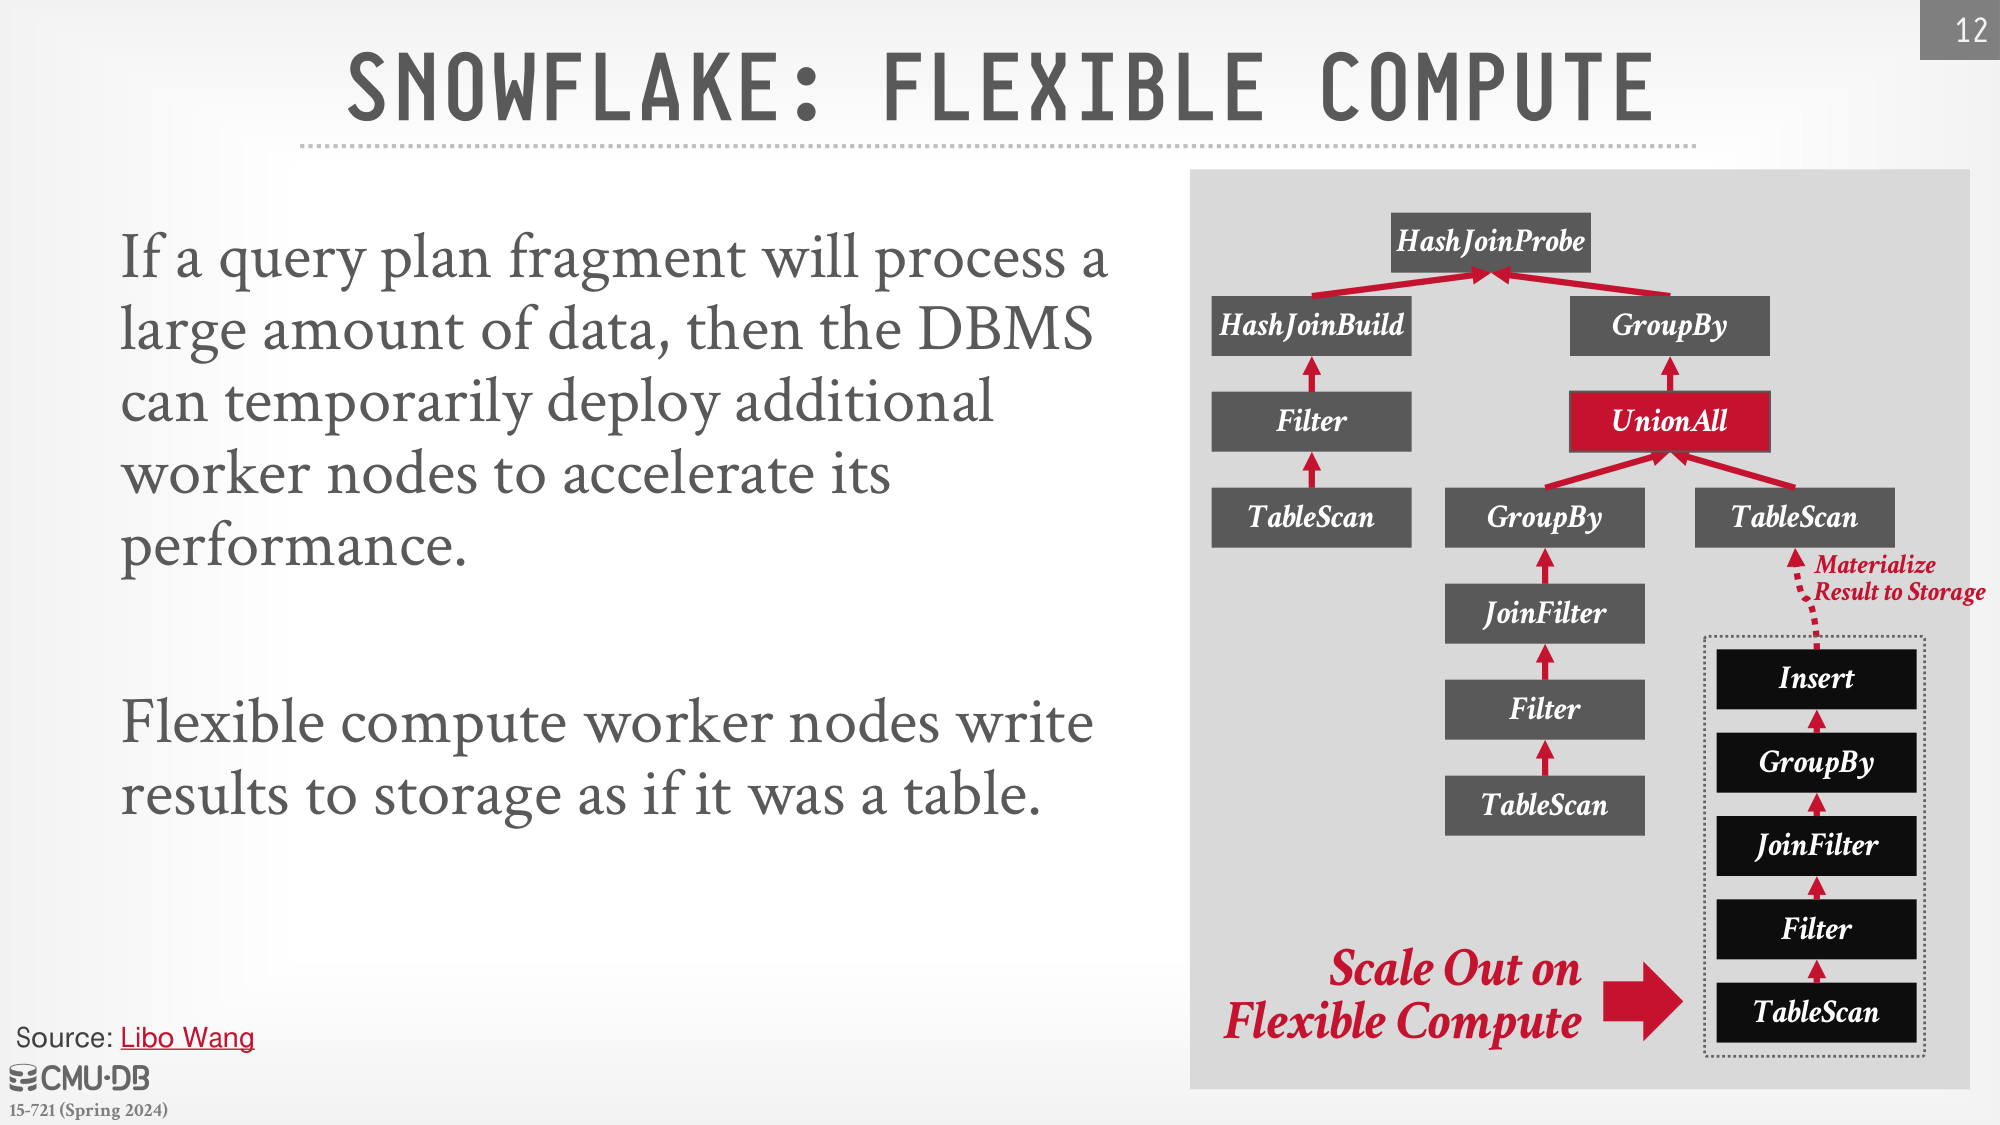
Flexible Compute 则为较大的计划片段配置额外计算节点,并通过物化结果把该片段接回原计划。它改变计算容量;工作窃取主要重新平衡已有 Worker 的任务。两者的收益都要扣除启动、数据获取和结果交接成本。
Micro-Partition 与半结构化数据
Snowflake 将内部表拆成不可变的 Micro-Partition,文件内部采用分组列式布局。元数据记录行数、压缩体积、列范围和空值等信息,帮助在读取前跳过不需要的数据。
对象存储支持范围请求,执行器可以先读元数据,再只获取需要的列块。后台聚簇与文件重组尝试让访问模式更匹配数据布局,缓存层则复用已经获取的数据。
对于半结构化字段,系统可以推断常见类型并提取成列,减少读取时重复解析;同时保留原始数据,以维护无法按推断形式处理的情况。模式推断是优化输入表示,不应丢弃原值的语义。
统计裁剪与运行时聚合
优化器在查询开始前利用目录中的分区统计判断哪些文件可以跳过,运行中还可以根据观察调整局部执行策略。
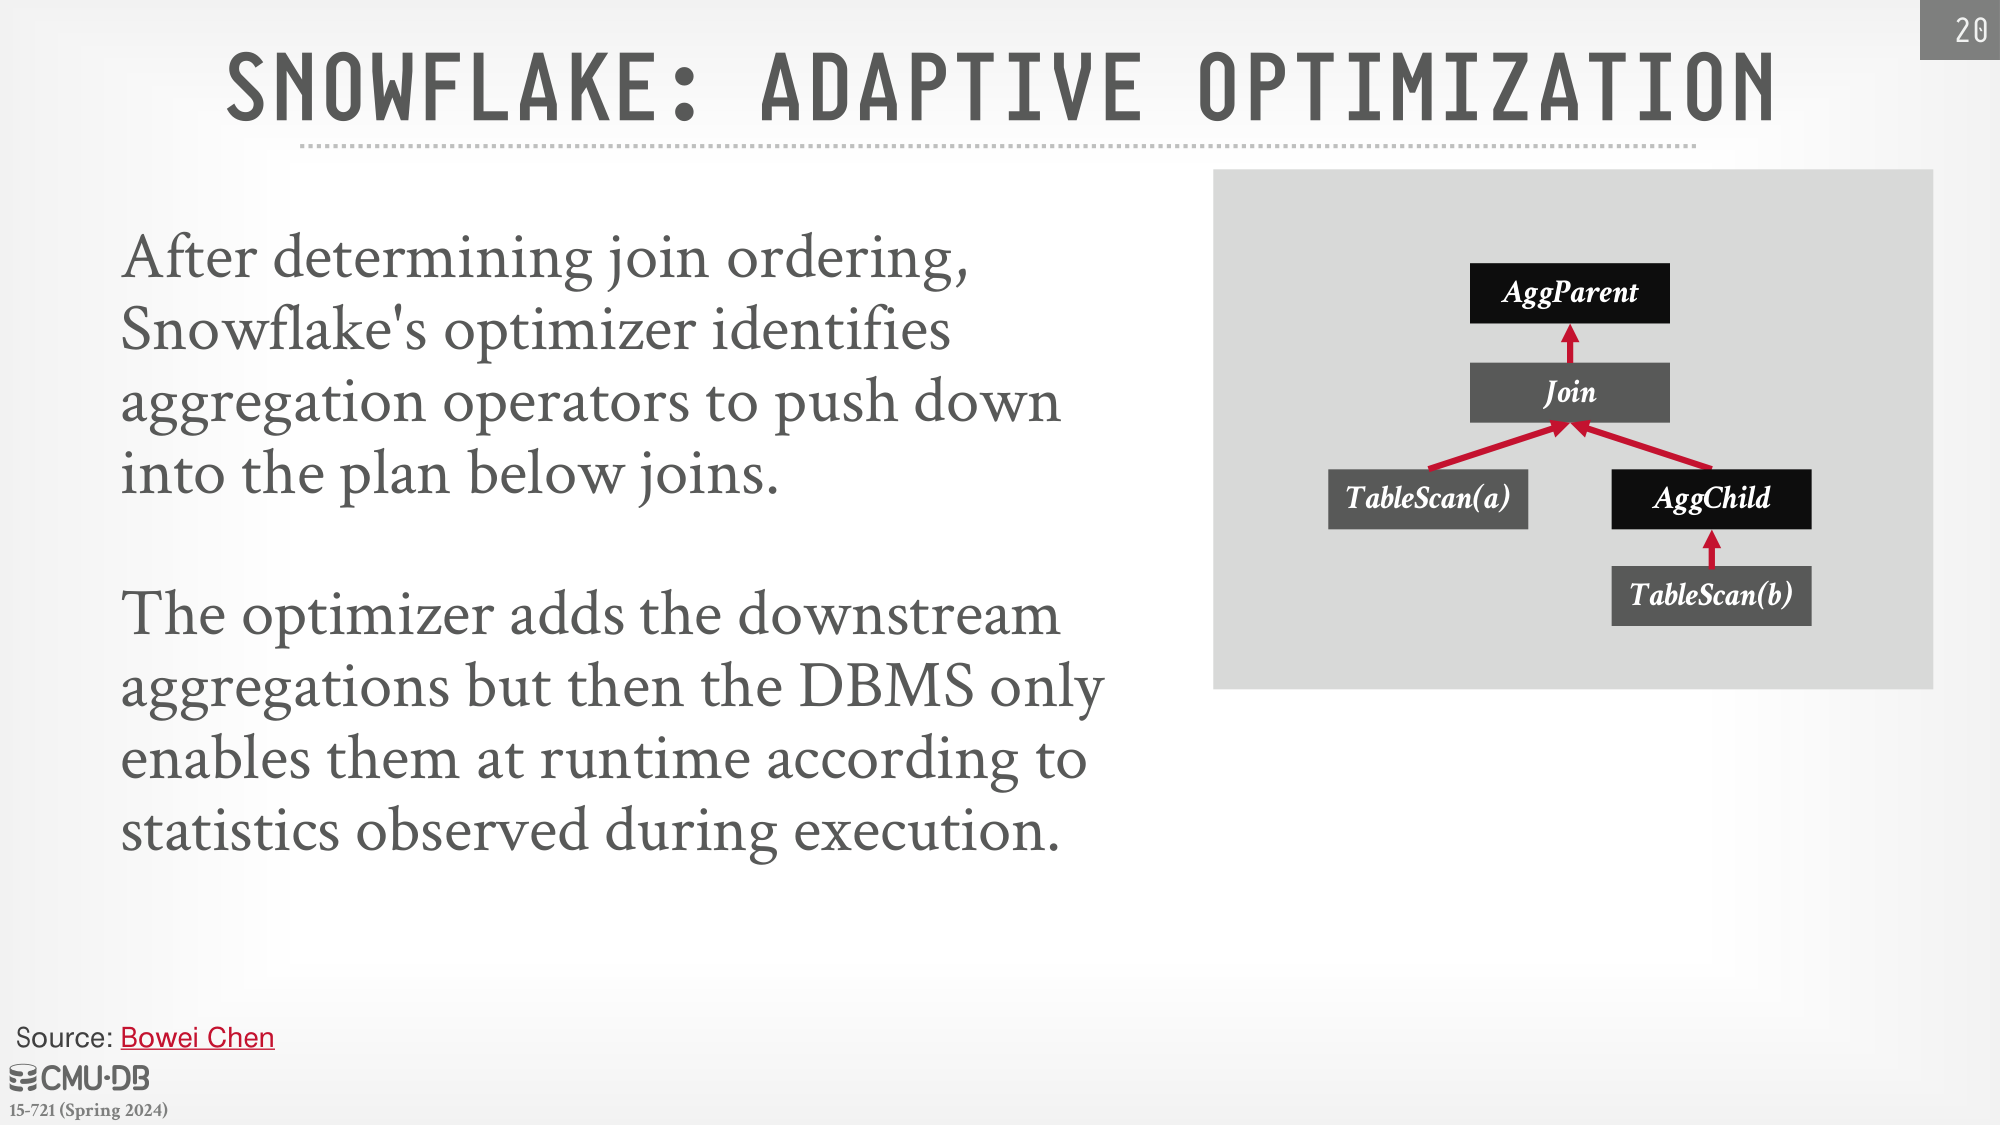
课件的例子在计划中预留下游局部聚合,实际执行时再决定是否启用。提前聚合只有在能够减少数据量、且维护状态的成本划算时才有收益;输入大但不同分组也很多时,未必能明显压缩结果。
从内部表到其他数据入口
外部文件可能缺少内部表同步维护的统计,这使访问裁剪和估计更加困难。课程还介绍 Hybrid Table 的行式更新与列式分析协作,以及 FoundationDB 对目录事务的作用。
这些内容应放在 2024 年课件的版本中理解。Snowflake 的内部设计并未全部公开,系统笔记可以记录论文解释的机制,也需要保留公开材料本身的不确定范围。