课程视频
从专用设备走向云服务
Yellowbrick 最初面向特定硬件配置提供分析型数据库设备,之后转向使用 Kubernetes 的云服务。课程采用 CIDR 2024 系统论文,重点观察一个数据库愿意为硬件资源控制实现到什么程度。
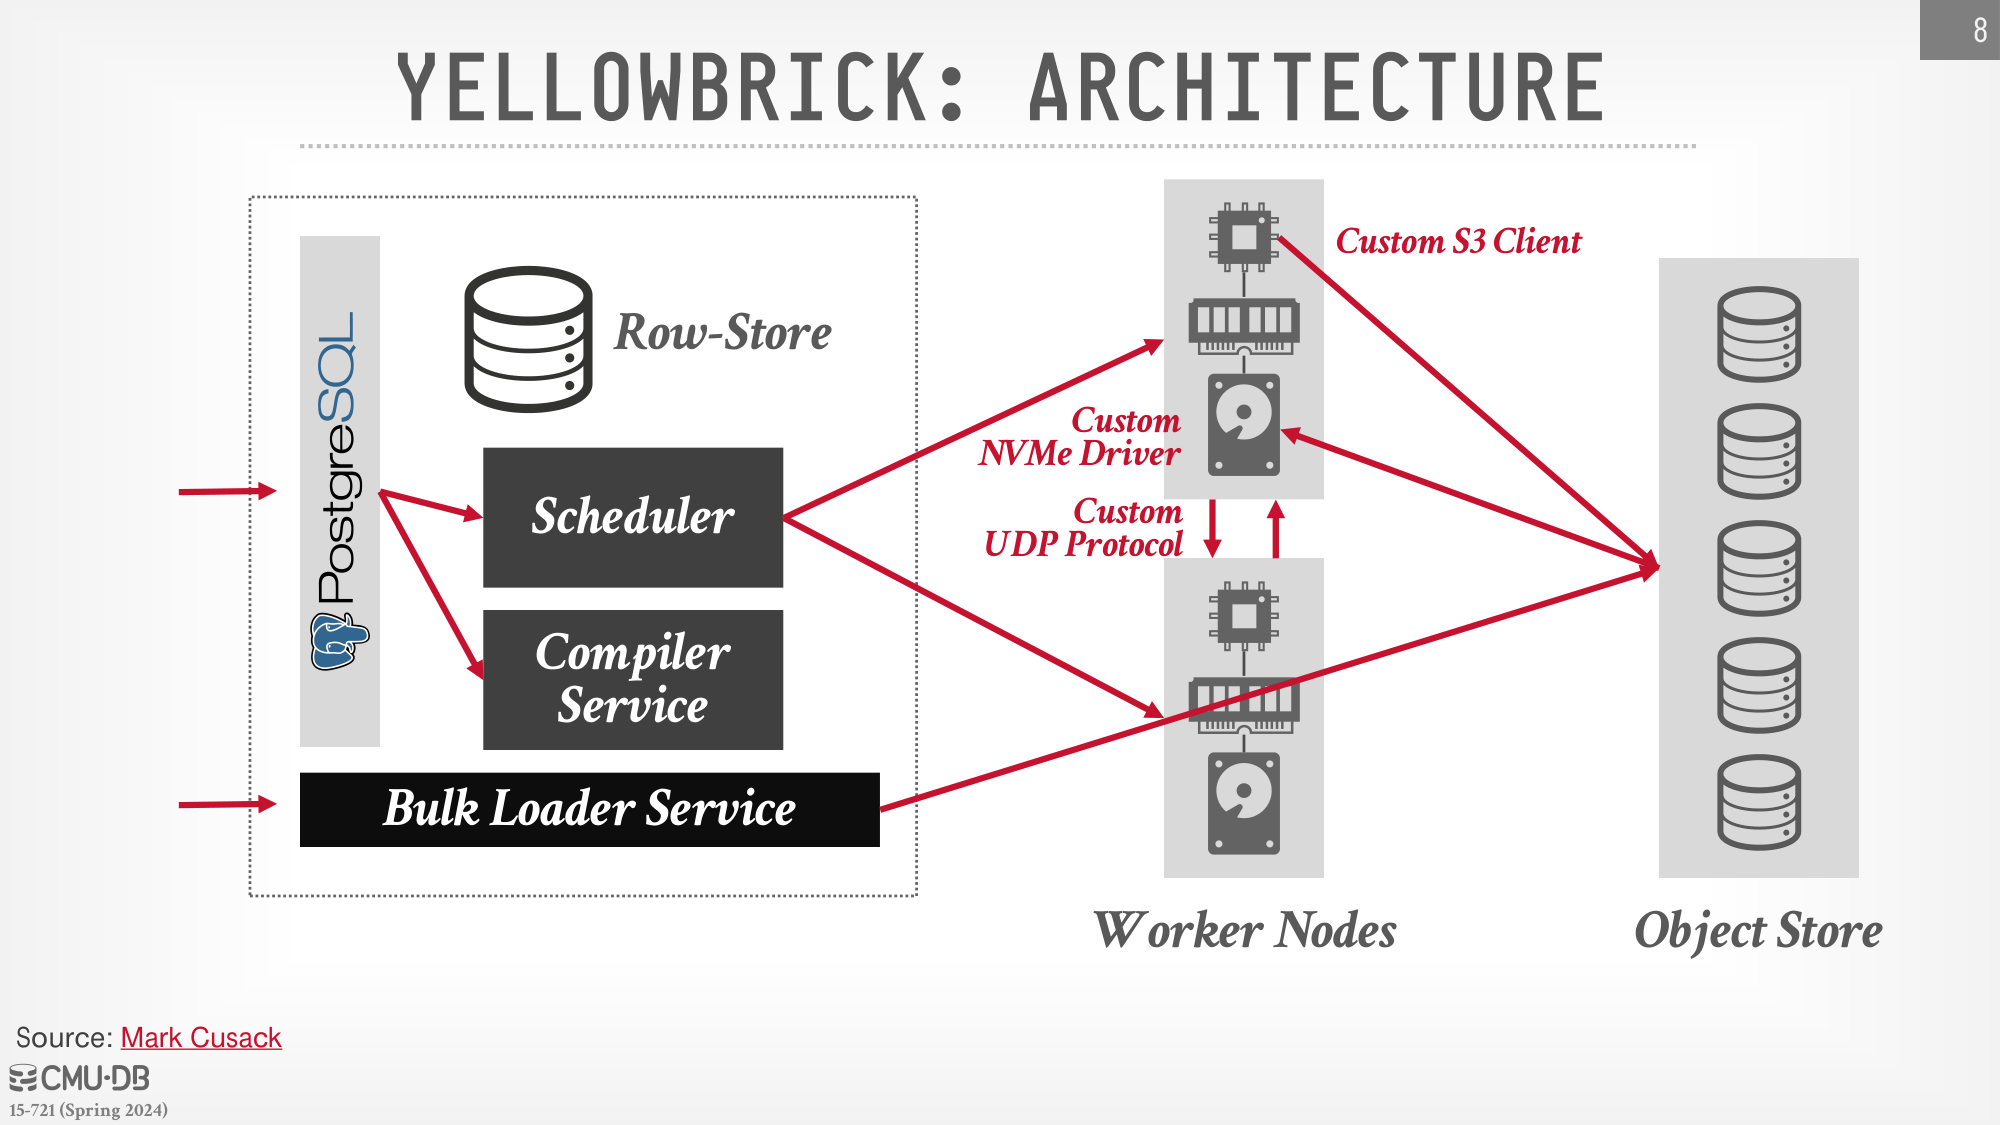
前端复用并修改 PostgreSQL 的网络、解析与目录能力,Worker 承担主要查询执行;编译、批量导入等工作由独立服务处理。课程中的云端部署将服务放进 Kubernetes,Worker 节点尽量独占其硬件资源。
查询片段编译与缓存
执行器使用 Push-Based 向量化,并支持行式和列式数据。Transpose 运算符负责在两种表示之间转换,片段内部尽量在缓存中的数据上完成更多工作。
查询计划拆成独立片段后生成 C++ 代码,由编译服务转换成机器码。不同片段可以并行编译,再通过动态链接组合;缓存还需要跟踪引擎版本与依赖,避免复用不相容代码。
优化器在 PostgreSQL 框架上增加连接排序、Zone Map 裁剪等能力,统计来自导入、行存转列存以及 ANALYZE。哈希连接也可以向扫描路径提供 Bloom Filter,减少后续处理。
行存、列存与文件分配
前端维护行式数据,后台把更新组织成对象存储中的列式文件,批量导入可以直接写入列式存储。需要同时管理前端增量与列式文件的可见性,避免查询遗漏尚未转列的数据。
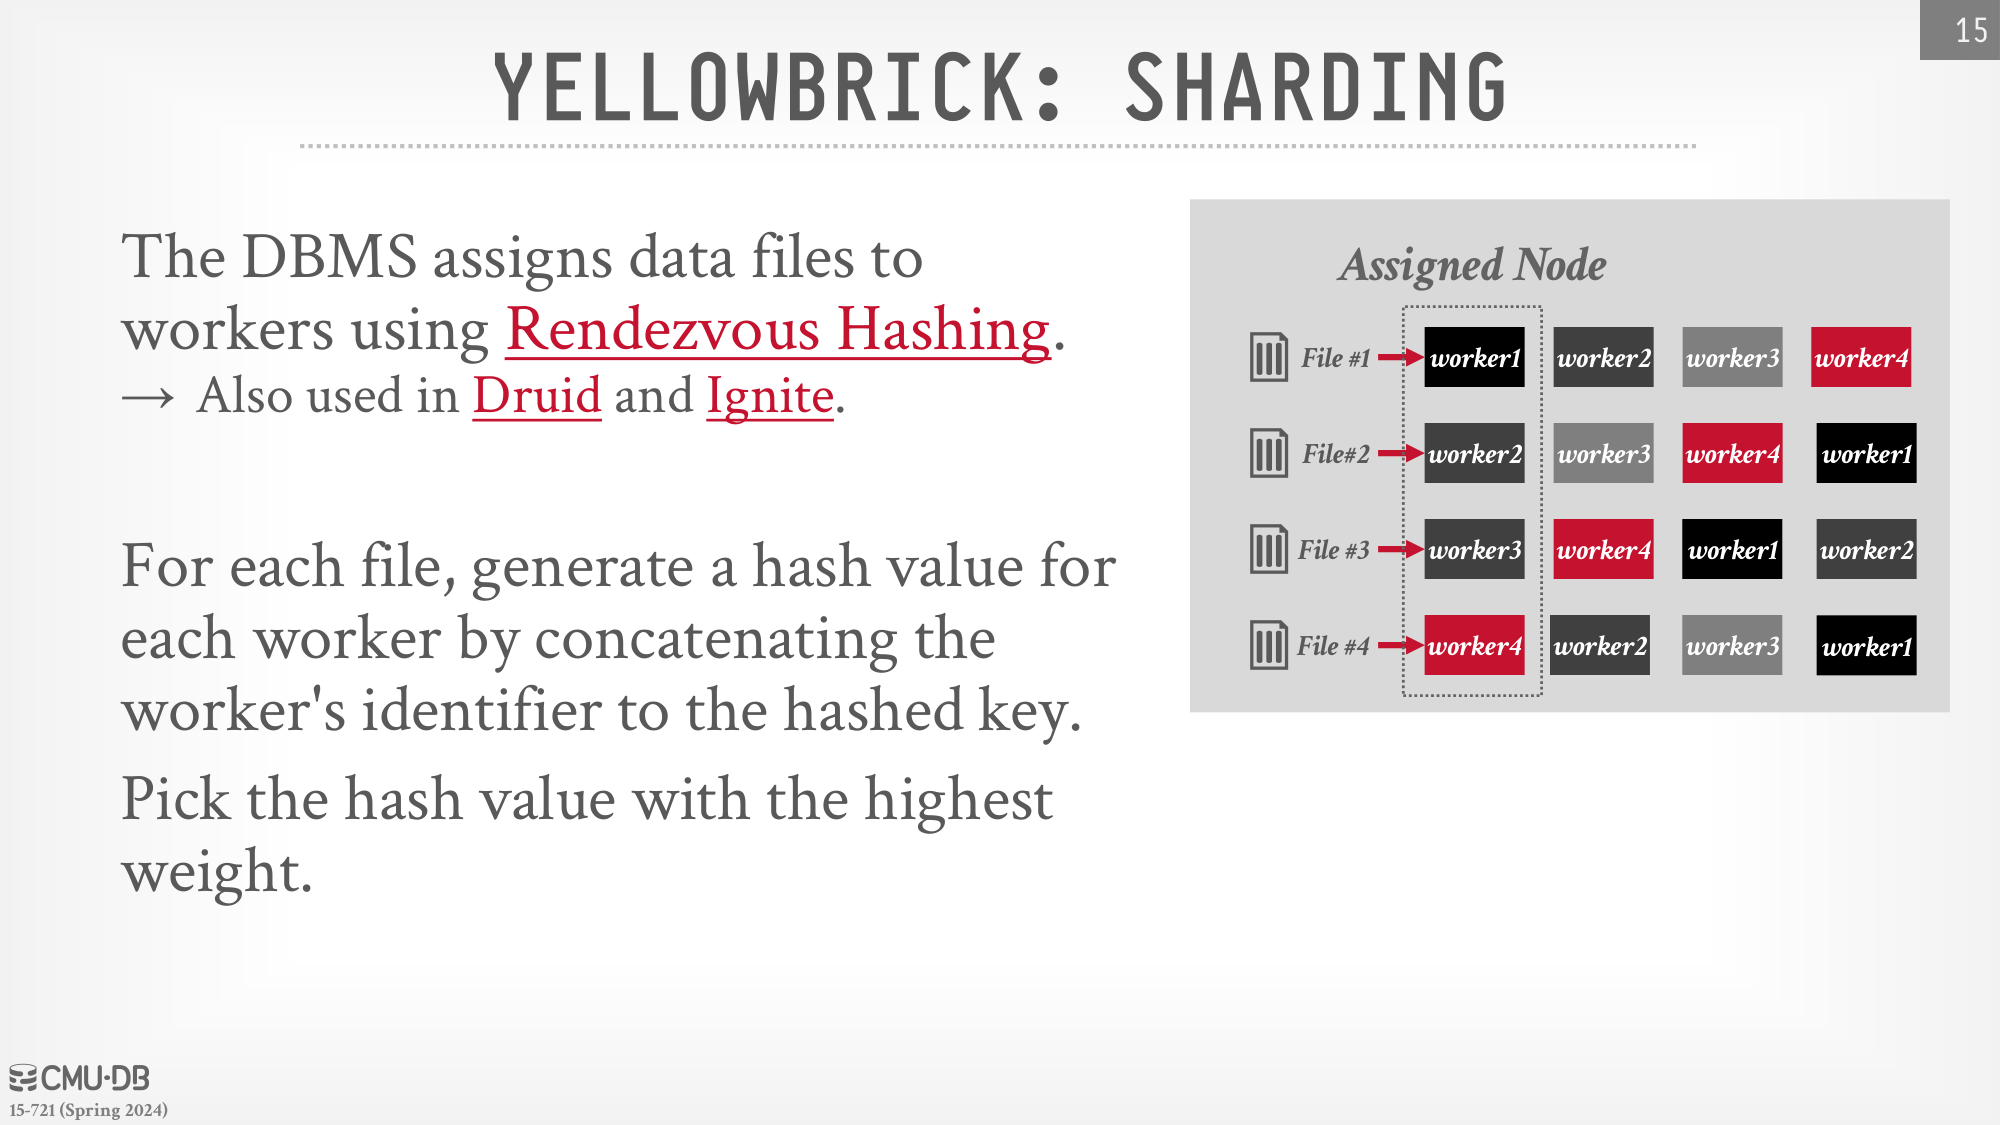
文件通过 Rendezvous Hashing 分配给 Worker。对每个文件和候选 Worker 组合计算权重,最高者成为首选,其余构成后续顺序。增加节点后,只调整由新节点获得更高权重的文件归属,帮助维持本地缓存的连续性。
这个映射解决的是文件放置与任务亲和,不改变 SQL 中记录的逻辑分区语义。实际读取还要结合当前节点状态与可用副本。
数据库为什么自己管理内存
Yellowbrick 使用 NUMA 感知的分配器,启动时获取并锁定需要的内存,结合大页、按查询组织分配和专用缓存减少通用分配路径的开销。
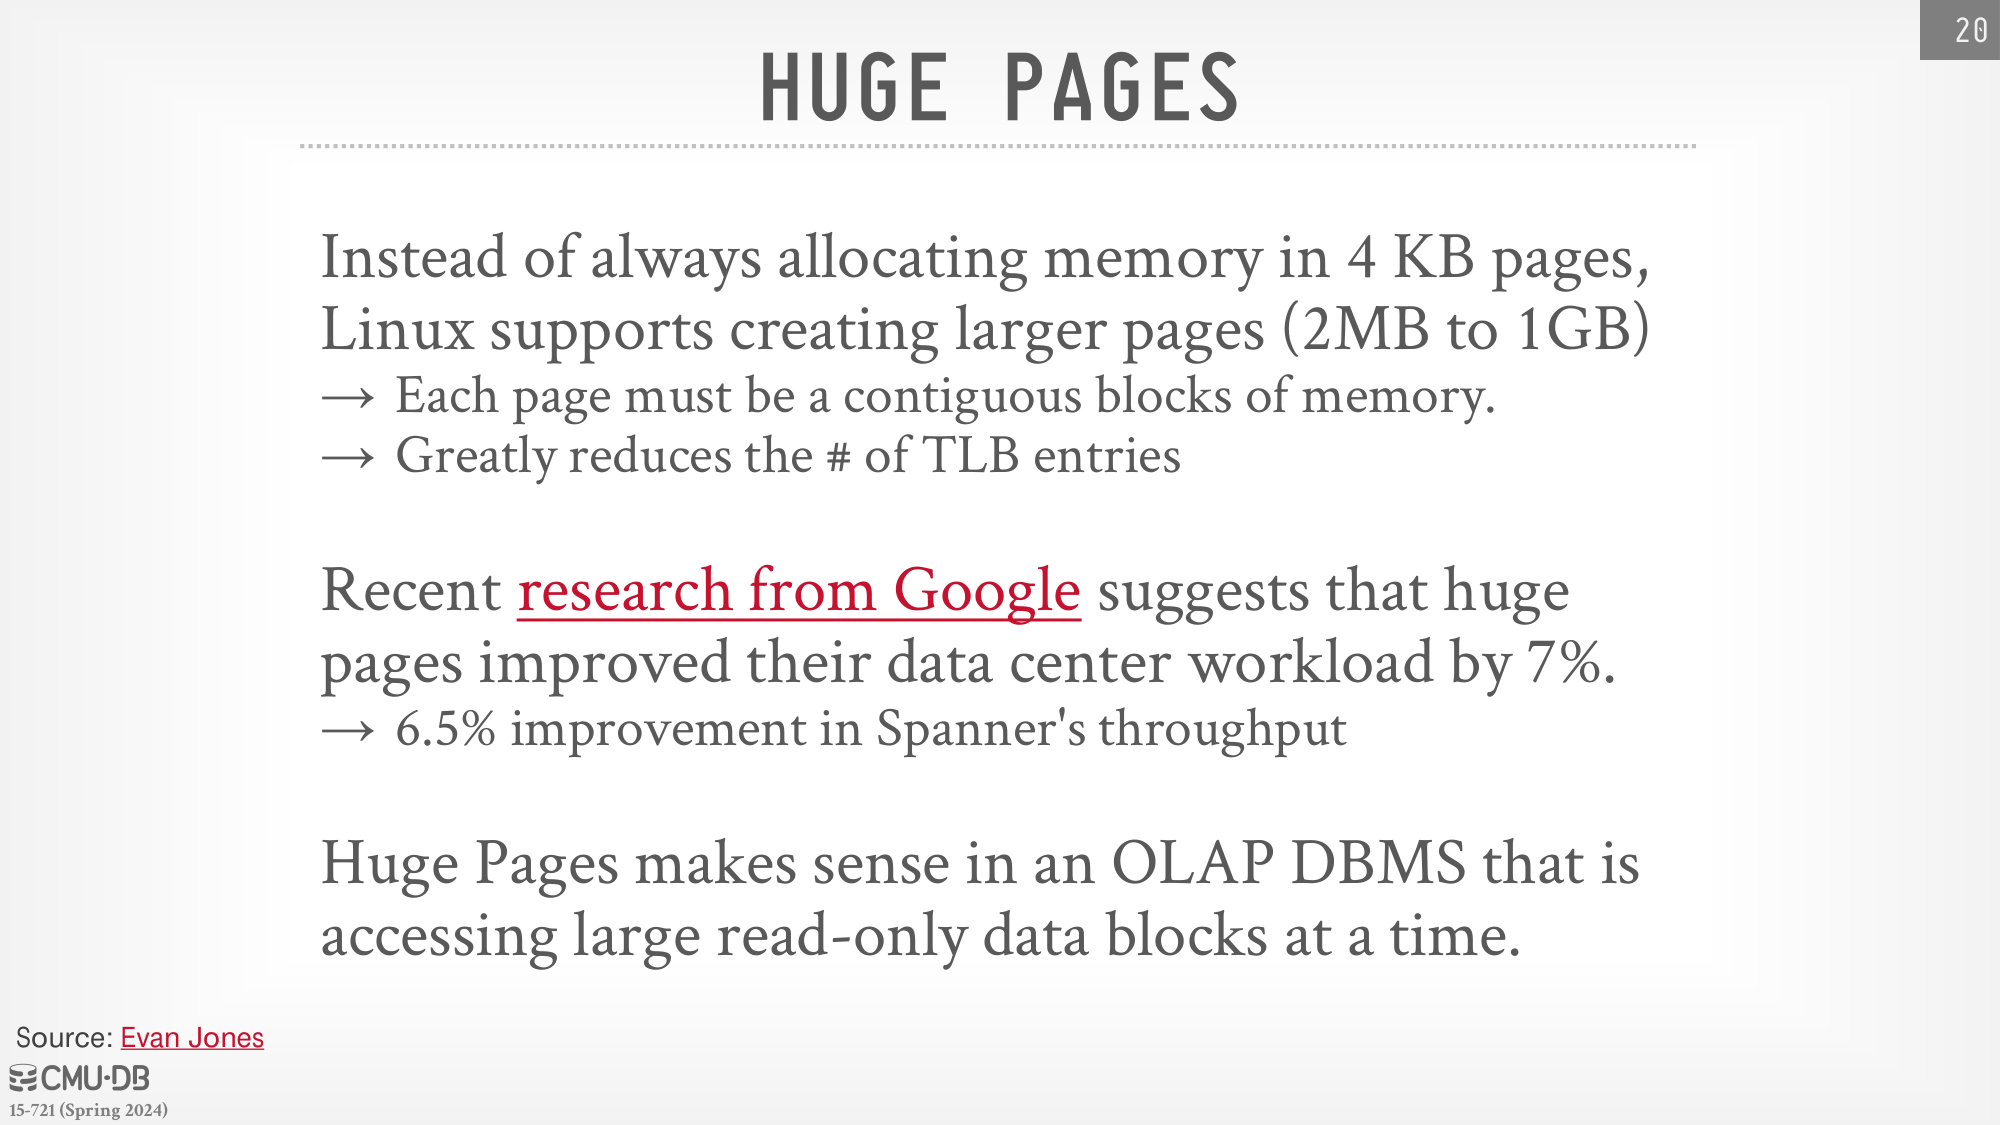
大页让同样容量的内存需要更少的页表和 TLB 项,但也要求更大的连续物理范围。透明大页的后台整理可能带来延迟,因此专门配置大页与依赖系统自动处理具有不同取舍。
缓存替换借鉴分段 LRU:新进入的页面先进入较冷部分,再次访问后才提升到较热部分,降低一次性扫描污染热点缓存的风险。
自定义调度与网络路径
课件中的 Worker 使用协作式线程调度,定期与集群调度器同步,让核心协同处理相近任务,以提高共享缓存中数据的利用率。具体并发组织服务于该系统的执行目标,不是通用数据库的唯一方式。
底层还实现用户态 NVMe/NIC 访问和基于 DPDK 的内部可靠 UDP 通信。每个核心维护收发队列,通过轮询与固定通信伙伴减少调度和数据复制。
这些优化体现了减少通用系统路径的工程投入,也增加驱动、硬件和故障处理的维护责任。课程最后把注意力带回查询计划:低层路径再快,若连接顺序产生大量无用工作,整体查询仍然可能很慢。